阶跃星辰近期推出了预览版模型 Step 5 Preview。从官方公布的参数来看,这是一个采用 MoE 架构、总参数量 600B 的多模态模型,支持 100 万上下文窗口与原生视觉识别能力;API 定价为输入每百万 Token 1 美元、输出每百万 Token 2.7 美元。
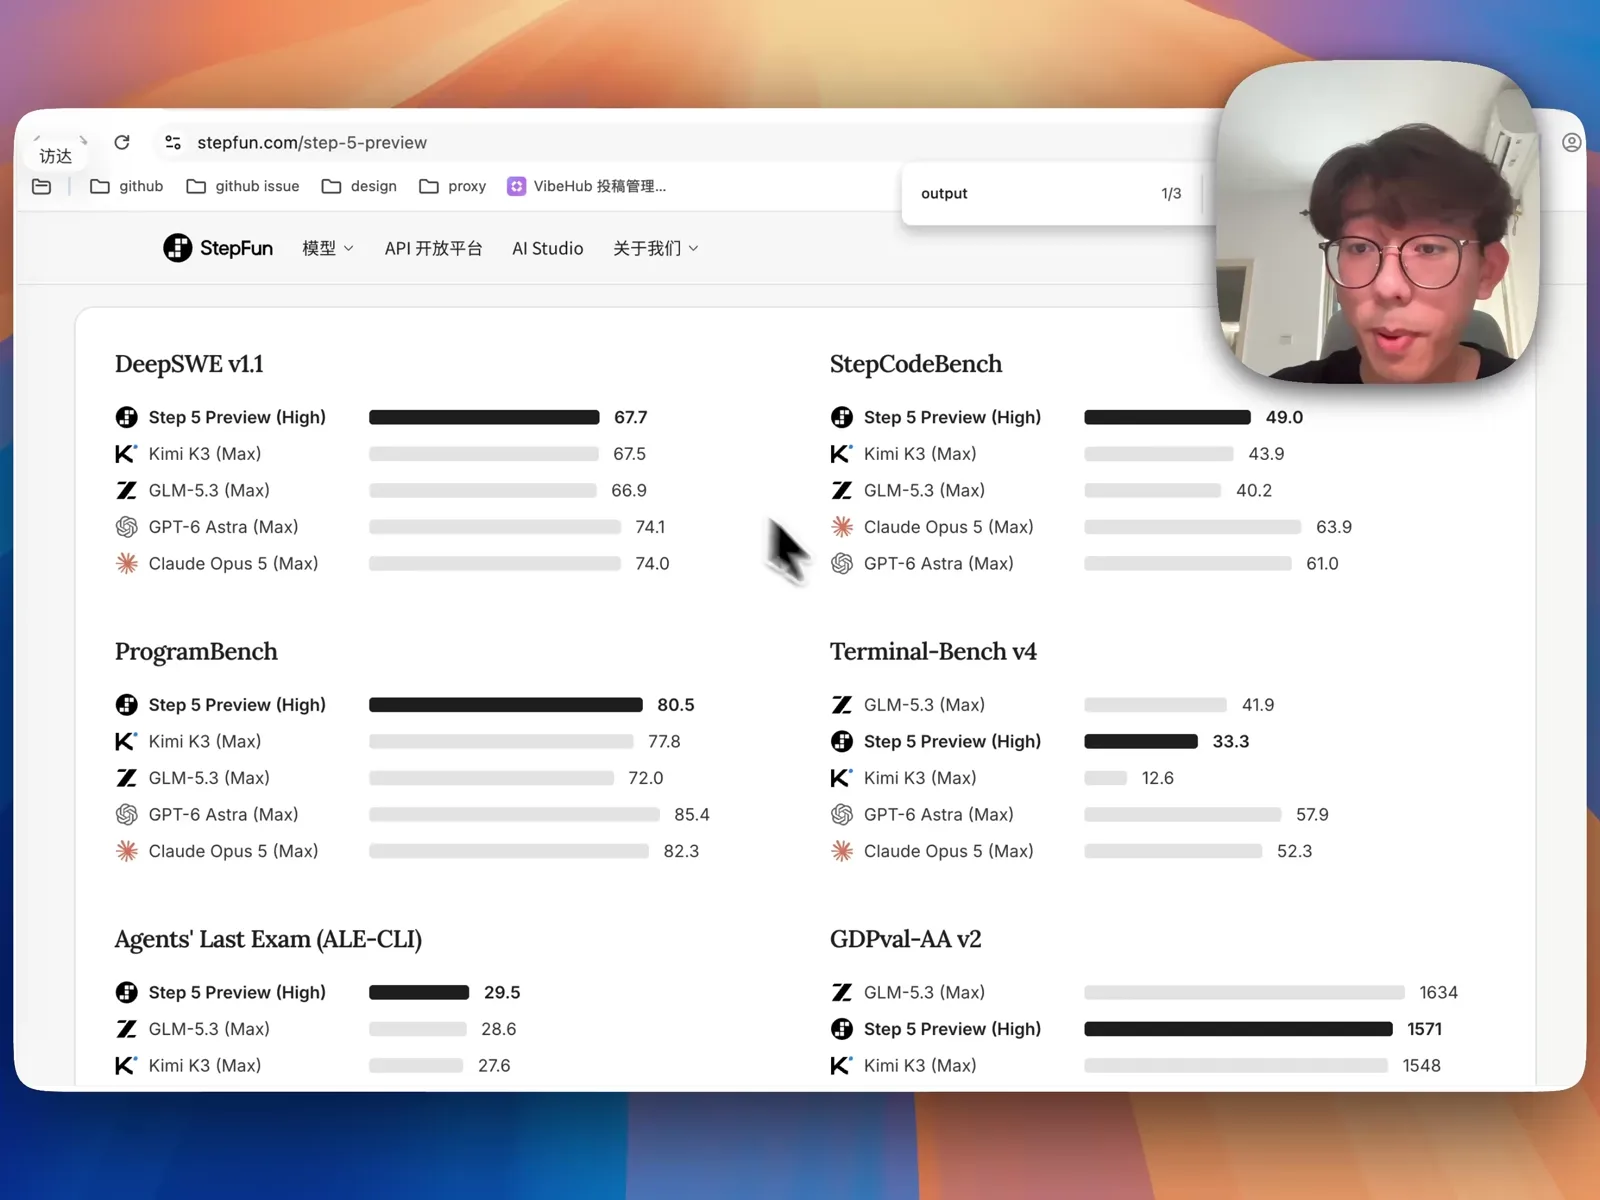
在官方基准测试中,Step 5 Preview 的综合得分与 Kimi K3、GLM-5.3 处于同一梯队。为了验证它在日常编码与 Agent 工作流中的真实成色,我把它接入 OpenCode,重点测试了三类场景:调用复杂 Skill 还原 UI 设计稿、仅凭简短提示词直出网页与小游戏,以及在真实项目 VibeHub 中按工程规范批量开发新内容。
调用 draw-ui 还原复杂设计稿:多模态视觉自检是亮点
第一项测试是在 OpenCode 中调用我之前编写的 draw-ui Skill。这个工作流会先让外部生图模型生成完整的网页长图设计稿,再由编码模型观察设计稿、提取局部图片素材,并用代码把页面还原出来,对模型的多模态观察力与长流程工具调用要求较高。
我先测试了一个黑白极简风格的黑胶唱片销售网站。Step 5 Preview 还原出的整体排版结构与原设计稿高度一致,唯一的小瑕疵在于首屏右侧的黑胶唱片图案:设计稿里带有细腻的唱片纹理,更理想的做法是截取右侧局部做一次图生图把素材抠出来,但模型直接用纯代码绘制了一个几何图形(推测是因为整张长图尺寸较大,局部纹理细节未被充分识别)。除个别标题字重略有差异外,版式还原相当扎实。
接着我换了一个视觉复杂度高得多的「毛球乐园」宠物主题网站。原设计稿包含大量异形插画、圆角卡片和带描边的贴纸感标题,还原难度明显上升:
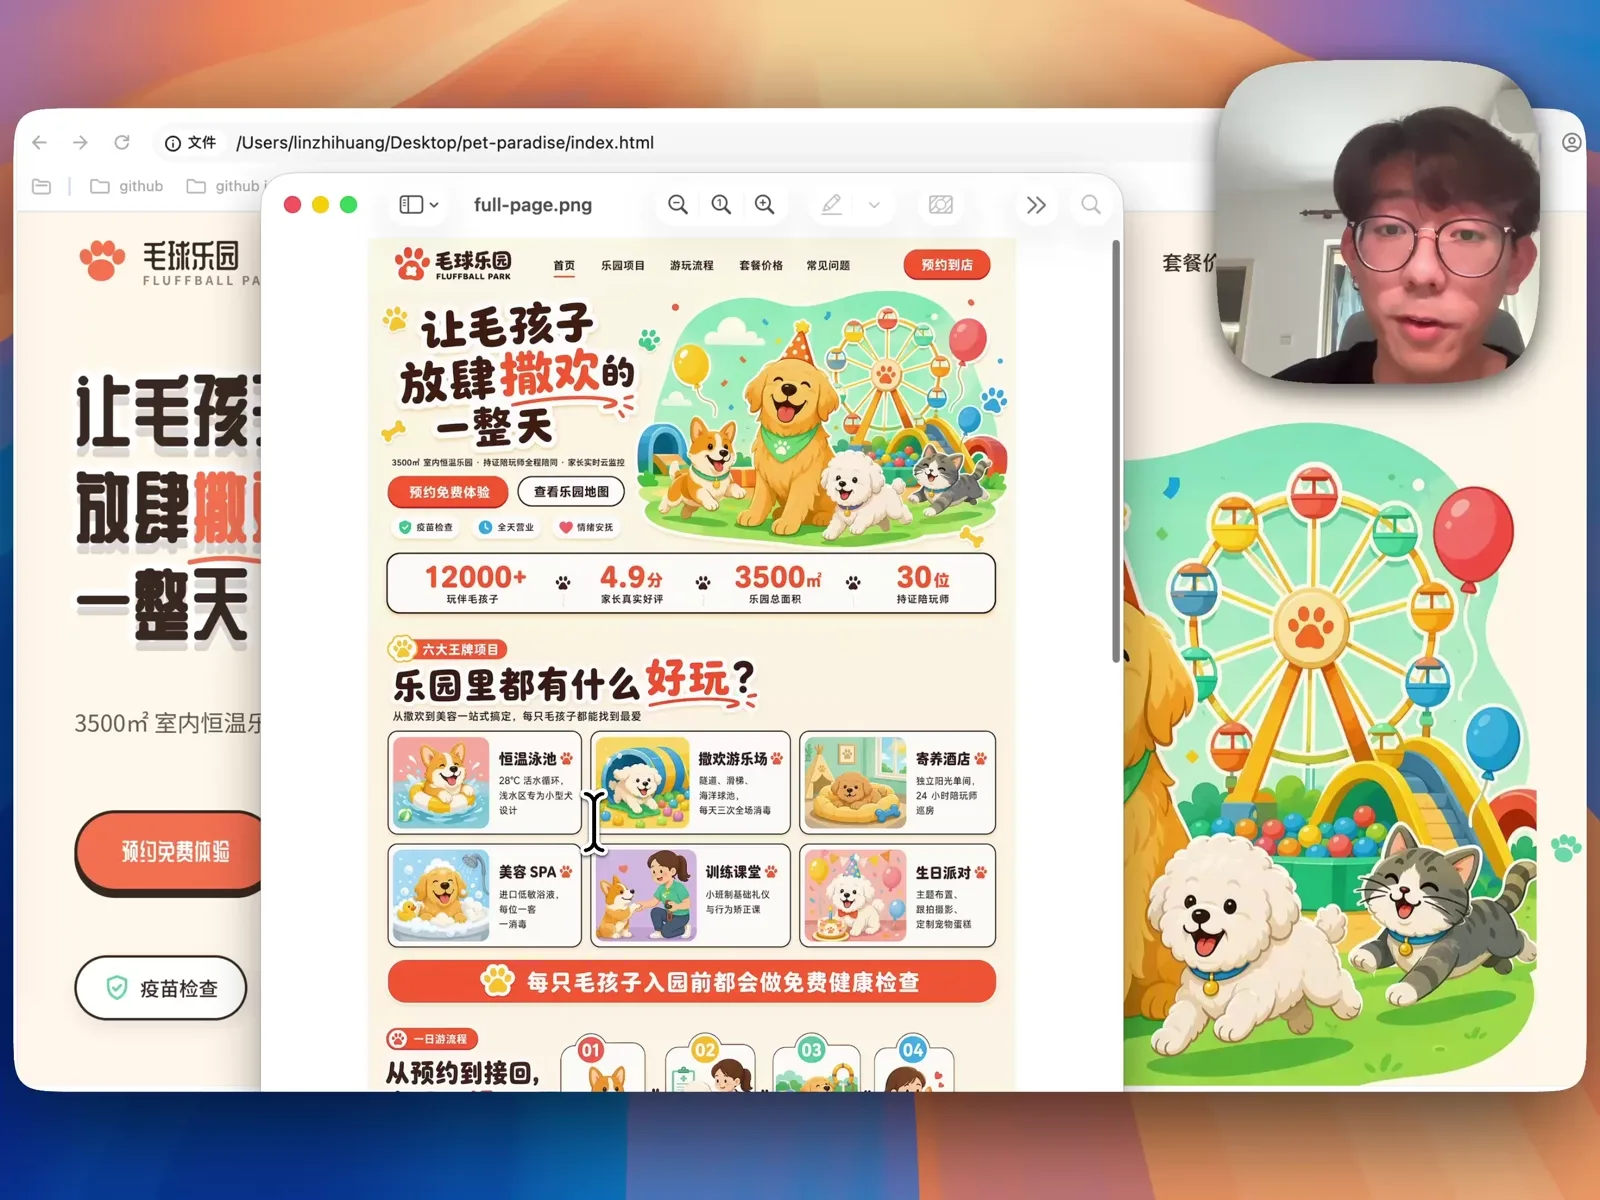
面对这张复杂长图,Step 5 Preview 的处理表现出了几个亮点:
- 主动模拟贴纸字体效果:观察到原图标题带有卡通贴纸质感后,模型选用圆角字体,并通过叠加白色外描边与投影模拟出了相近的视觉效果。
- 局部图生图提取素材:无论是首屏的主视觉插画,还是下方多张功能卡片里的配图,模型都准确调用了局部图生图流程把素材单独提取并嵌入到了网页中。虽然下方卡片的圆角弧度和内边距比例与原稿还有一点偏差,但底部价格模块的配色与整体结构在单轮生成中就已经拿捏到位。
- 写完代码后主动调用浏览器视觉自检:在测试过程中,
Step 5 Preview的生成速度(TPS)稳定在 60 到 70 左右,属于主流平均水准。更让人惊喜的是它的工程习惯——写完前端代码后,它没有直接结束任务,而是利用自身的多模态视觉能力,主动通过浏览器自动化工具打开本地页面,逐屏滚动截图检查元素对齐与渲染效果,确认无误后才交付结果。
原生前端生成:简约规整的后台界面与带粒子音效的打砖块游戏
测完带设计稿参考的还原工作流后,我回到模型原生的前端生成能力,只给简短的一两句提示词,看它单轮直出页面的审美与完成度。
我连续测试了杂志风落地页、B2B 企业官网以及一套名为「应答」的客服工单管理后台。生成的杂志风页面主动加上了 SVG 几何装饰,排版清爽;而客服管理后台则呈现出干净克制的现代 SaaS 风格,左侧导航、顶部数据概览卡片、工单列表筛选区与状态标签一次性生成完毕,没有出现任何布局错乱或容器溢出:
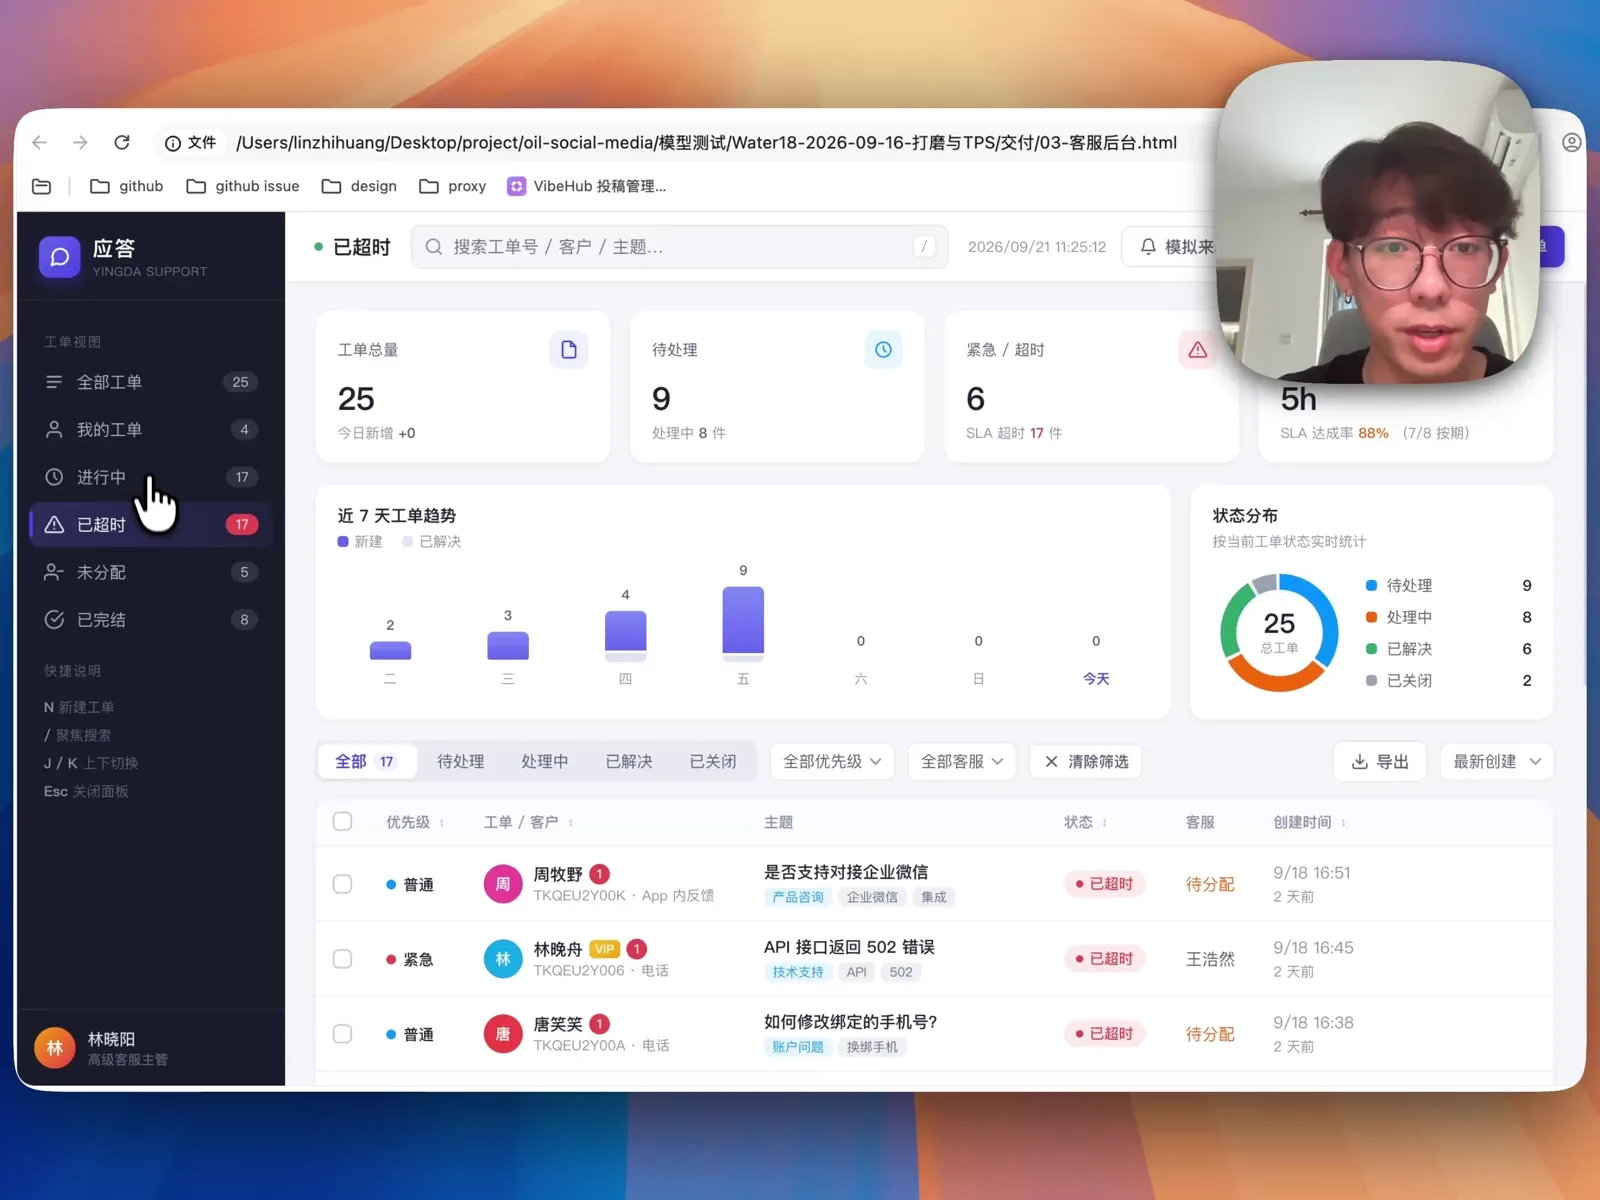
整体来看,Step 5 Preview 直出 UI 的风格偏简约规整,没有浓重的「AI 紫渐变」模板味。虽然距离目前最顶尖的前端设计模型还有一定差距,但放在同类编码模型里已经达到中上水准。
随后我又用一句话提示词,让它写一个「新粗野主义复古风格的打砖块游戏」:
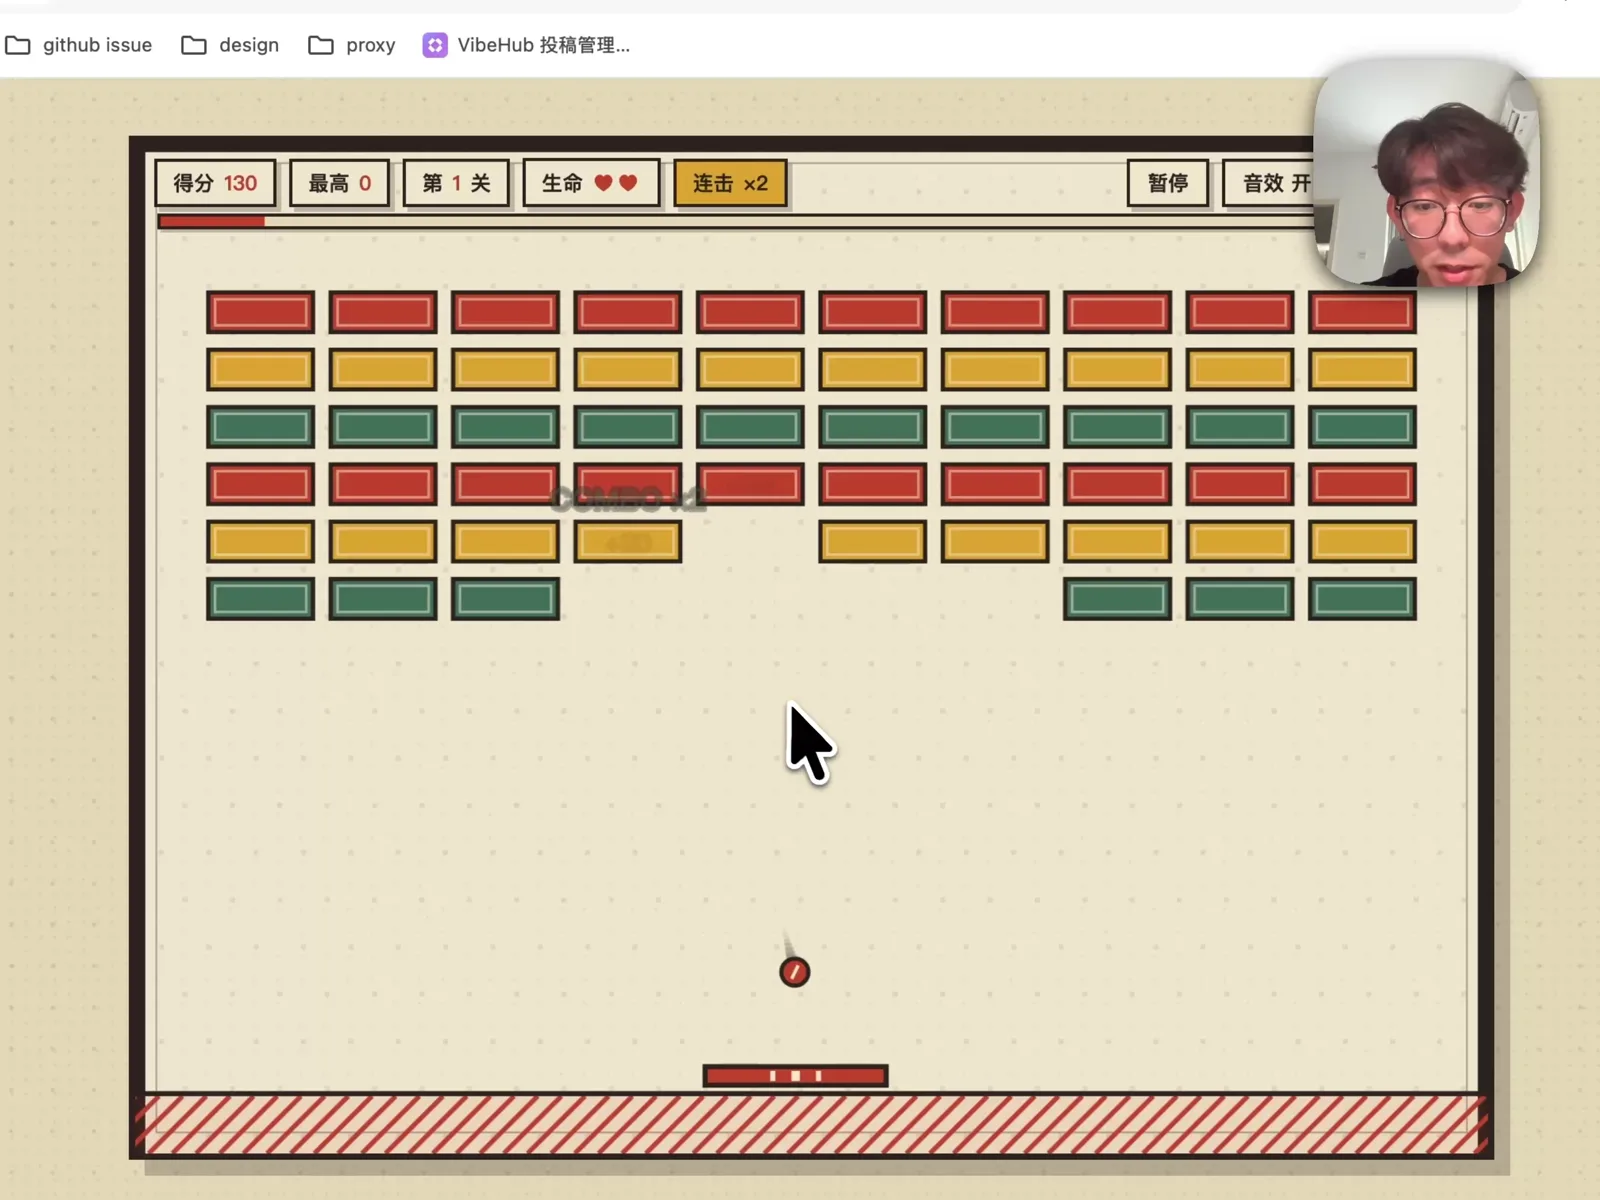
生成的游戏不仅物理碰撞、生命值与关卡逻辑运转正常,模型还在没有额外提示的情况下,主动加上了砖块击碎时的粒子飞散动效、连击(Combo)计分反馈以及右上角的复古合成器音效开关,交互细节相当完整。
真实工程实战:在 VibeHub 中规划并批量补充 32 个技术词条
前端页面和小游戏更多考验单文件生成能力,为了测试它在真实多文件仓库中的表现,我把 Step 5 Preview 放进了 VibeHub(配套仓库 vibe-hub-skill)项目中。这是一个面向 Vibe Coding 新手的交互式设计与工程术语图鉴网站,项目内部有一套严格的词条添加规范。
我给它的任务分两步:先阅读仓库里的工程规范与现有词条目录,分析目前还缺少哪些核心概念并给出一份补充方案;待我确认后,再批量把这些词条的完整详情页写出来。
在第一步规划阶段,Step 5 Preview 展现出了很好的产品语感。之前我让 Codex 构思新词条时,它经常会列出一堆偏底层或偏离新手实际开发场景的生僻概念;而 Step 5 Preview 梳理出的 32 个待补充词条(涵盖前后端基础、API 通信、常见状态码与部署概念)非常贴合 Vibe Coding 初学者的真实痛点。
确认方案后,我让它一次性把这 32 个词条全部落盘实现。每个词条不仅需要通俗易懂的解释文案,还要配套编写可交互的 HTML 视觉图解(例如在「HTTP 状态码」词条中直接用代码绘制出 404 Not Found 与 500 Server Error 的迷你网页对比演示):
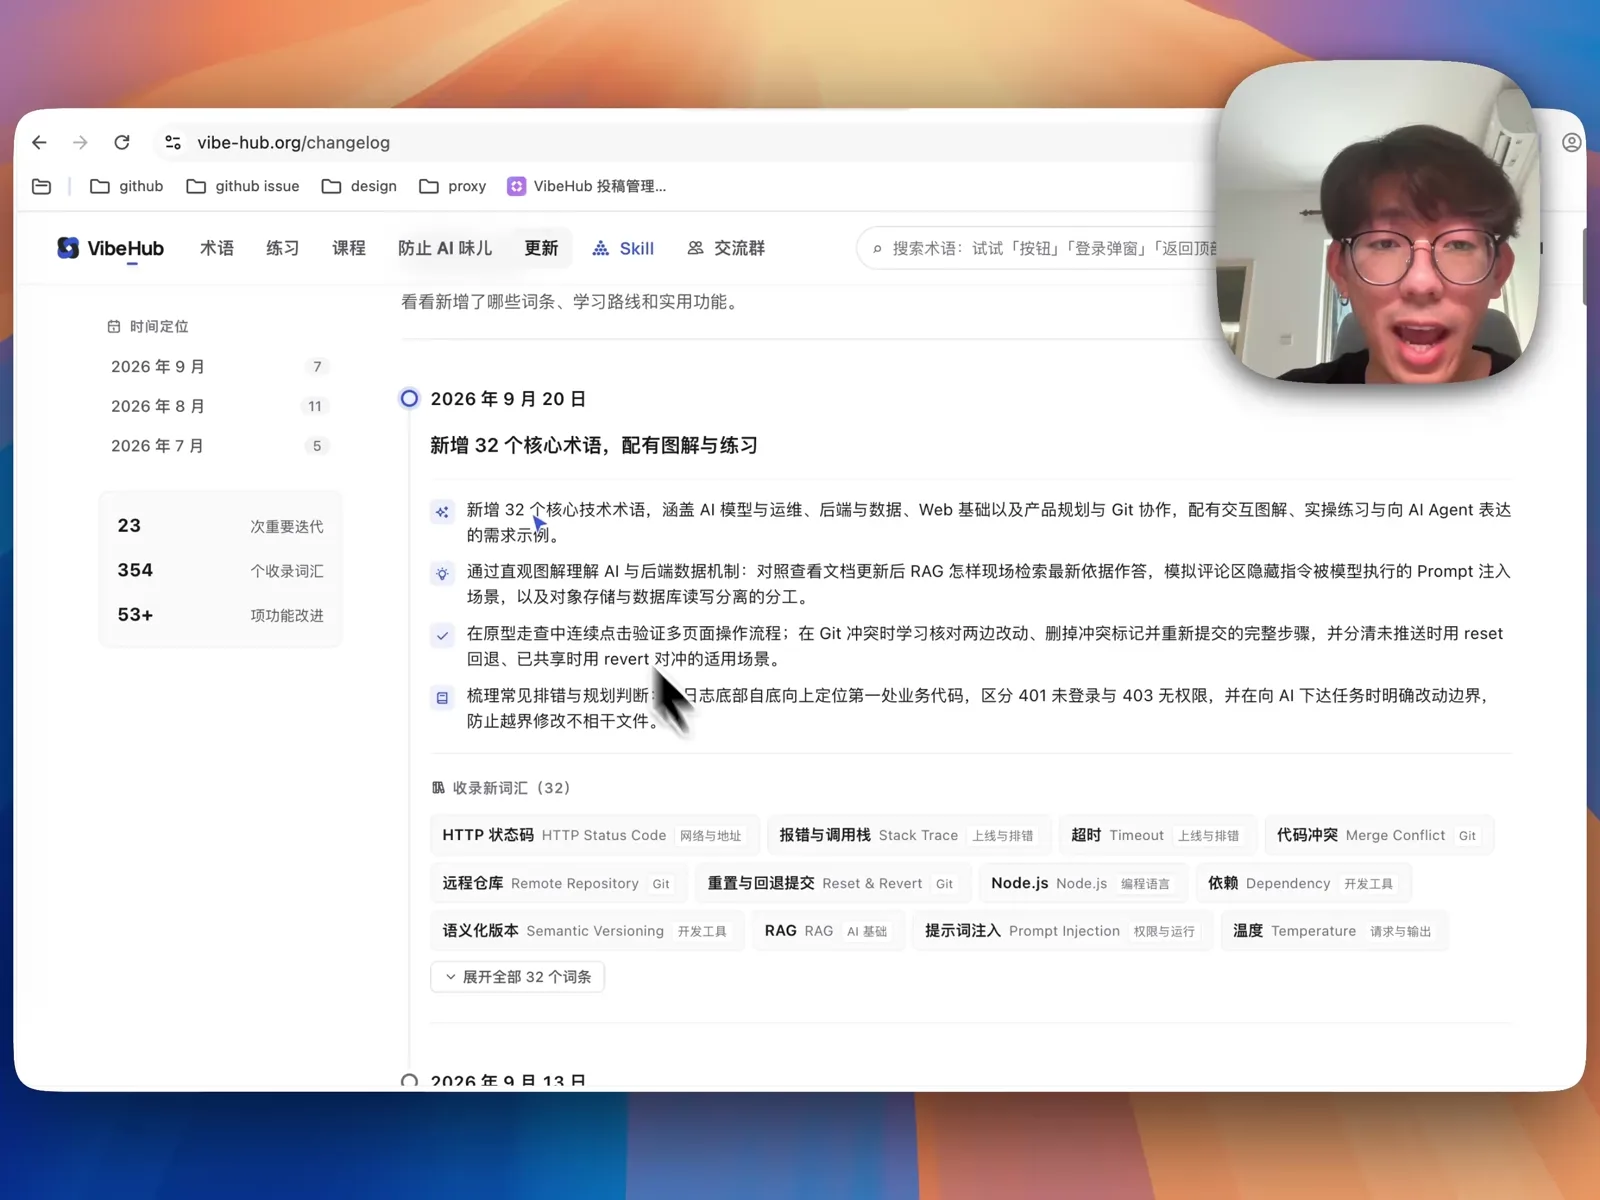
第一版生成的 32 篇文案稍微带有一点书面 AI 腔,我让它统一润色校正了一轮后,可读性明显提升;配套的 HTML 图解虽然没有使用复杂的自定义 SVG 插画,但结构清晰、表意准确。最让我意外的是,在连续写完 32 个词条文件后,它没有遗忘项目规范里的收尾要求,主动在更新日志(Changelog)页面补上了一段面向用户视角、偏业务取向的更新说明。
总结:像一个带视觉识别能力的 GPT-5.3
几轮实测下来,Step 5 Preview 给我的整体体感很像一个「自带多模态视觉识别能力的 GPT-5.3」:
- 工程可用性扎实:无论是阅读长文档规范、规划贴合业务场景的方案,还是连续修改几十个文件并遵守收尾约定,它的指令遵循与长程稳定性都表现可靠,综合体感优于
DeepSeek 4.1 Flash和GPT-5.3 Flash。 - 多模态闭环加分:原生的视觉能力不仅让它能看懂设计稿,还能配合浏览器工具在写完代码后主动看图自检,减少了人工来回截图反馈的次数。
- 性价比突出:结合每秒 60–70 Token 的生成速度,以及输入 1 美元、输出 2.7 美元每百万 Token 的定价,它非常适合作为日常 Agent 编码与前端还原工作流中的主力性价比模型。