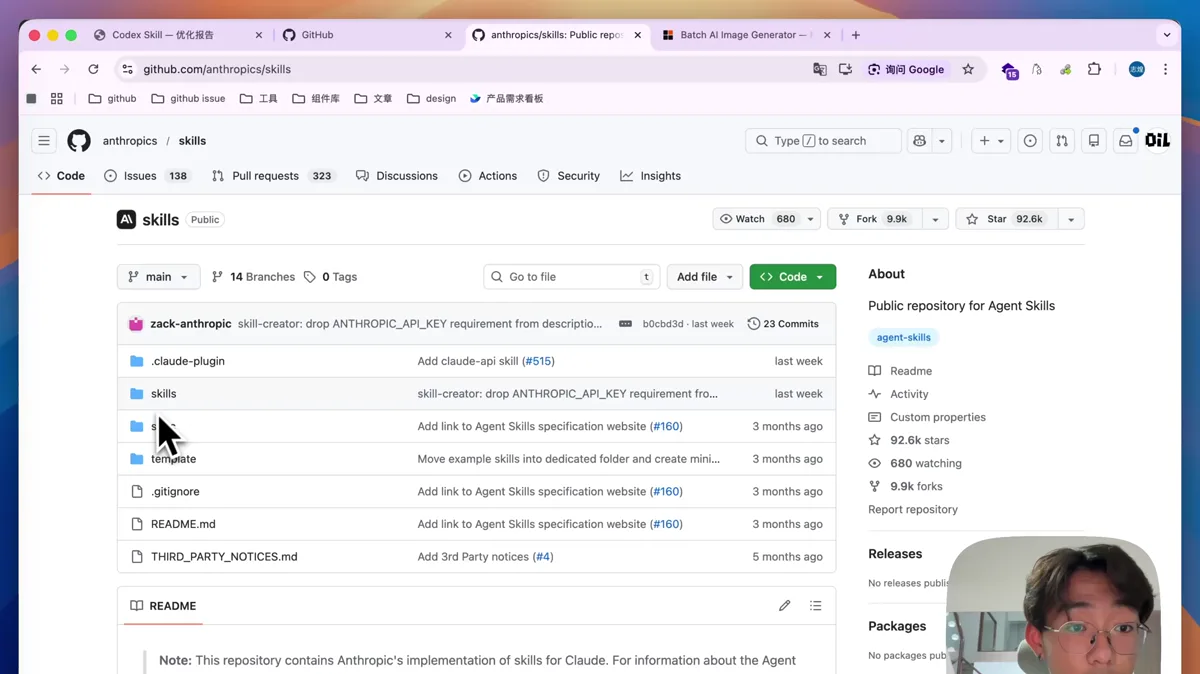
最近 Anthropic 的 skills 仓库有一次更新,里面的 skill-creator 这个 Skill 变了。在 GitHub 上打开 anthropics/skills 仓库,进入 skills 目录就能找到它。
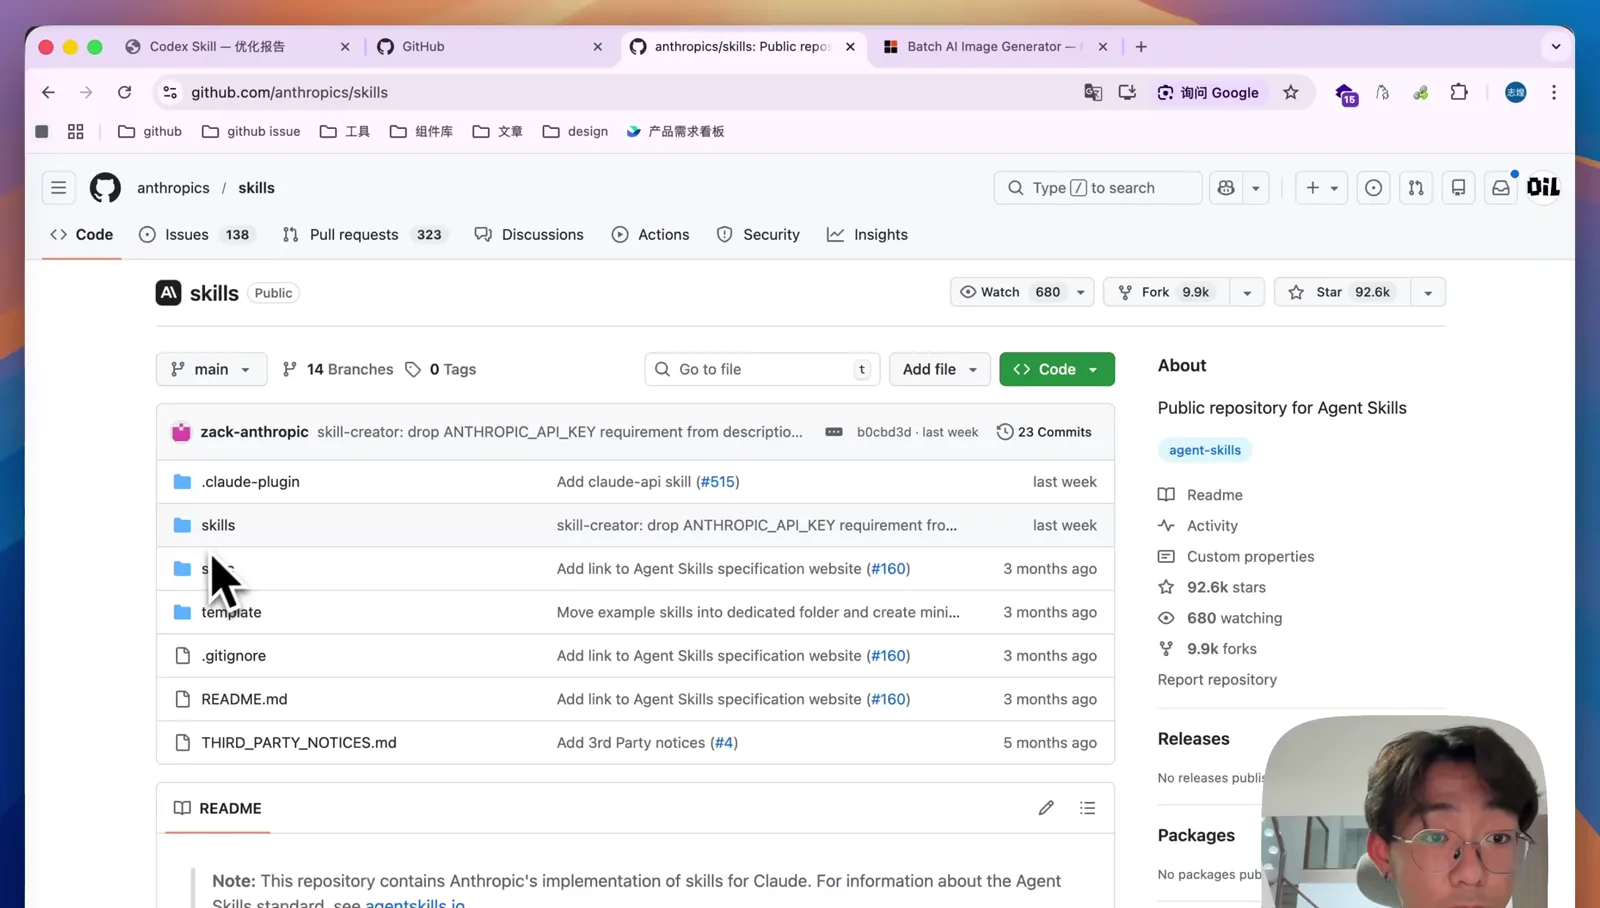
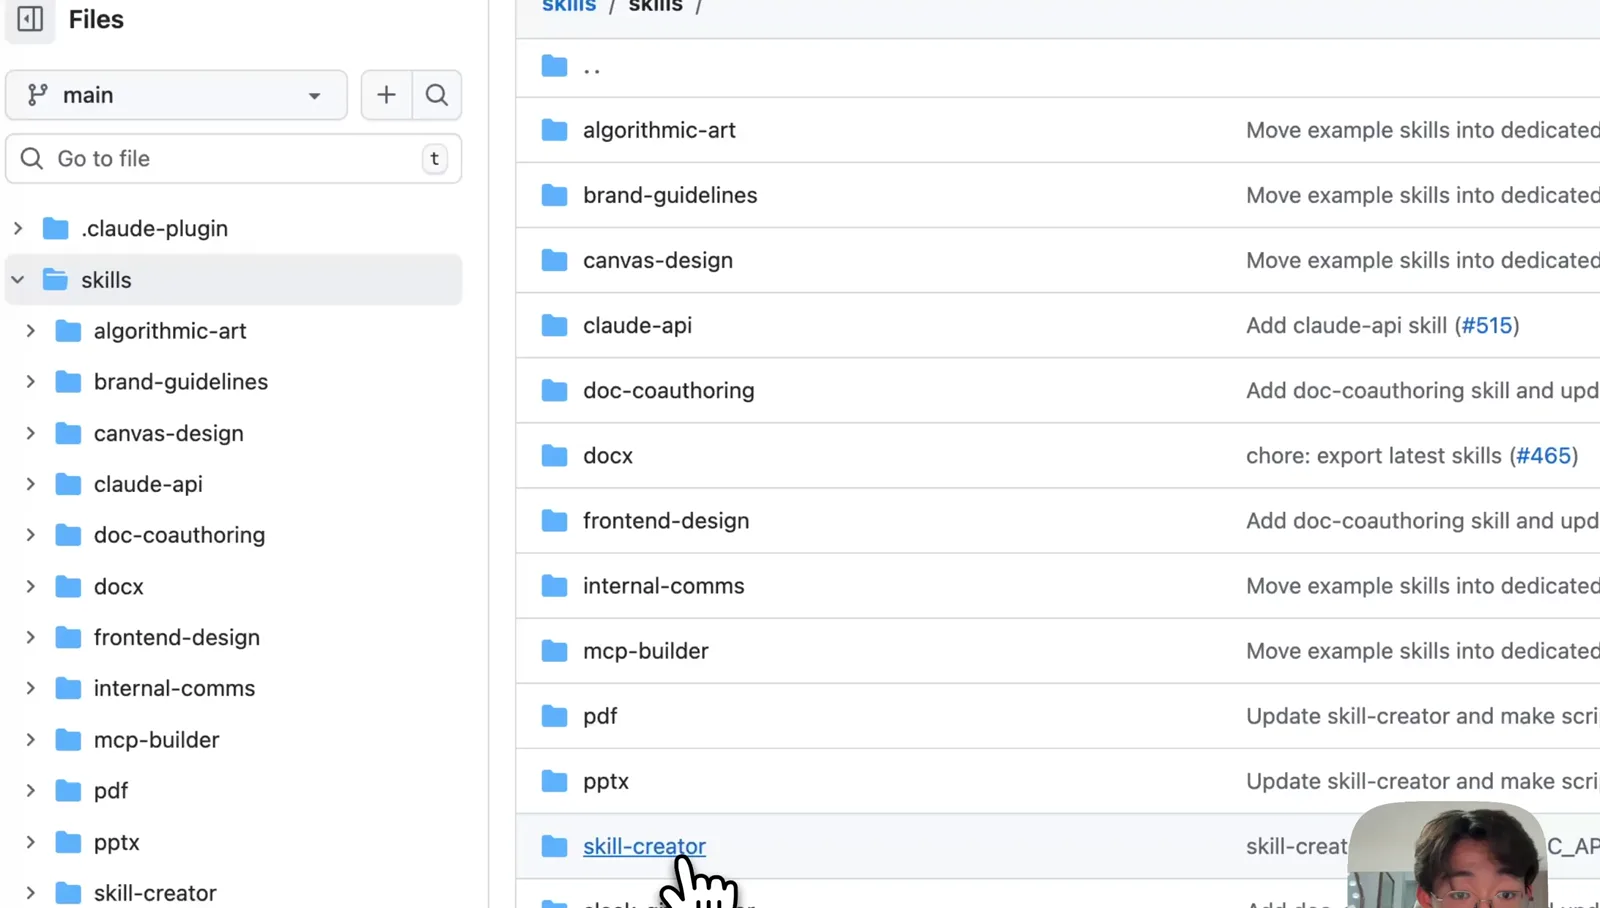
skill-creator 是用来帮助我们创建其他 Skill 的。这次更新之后,它的 SKILL.md 里加入了 Anthropic 对 Skill 的最新理解,我们可以用它来 review 以前创建的 Skill,检查写得合不合理。
更新 skill-creator 的方式
这里有一个问题:直接执行 npx skills update skill-creator 检查不到这次更新。具体原因我不太清楚,不知道它是根据 commit 还是 release 来判断的。
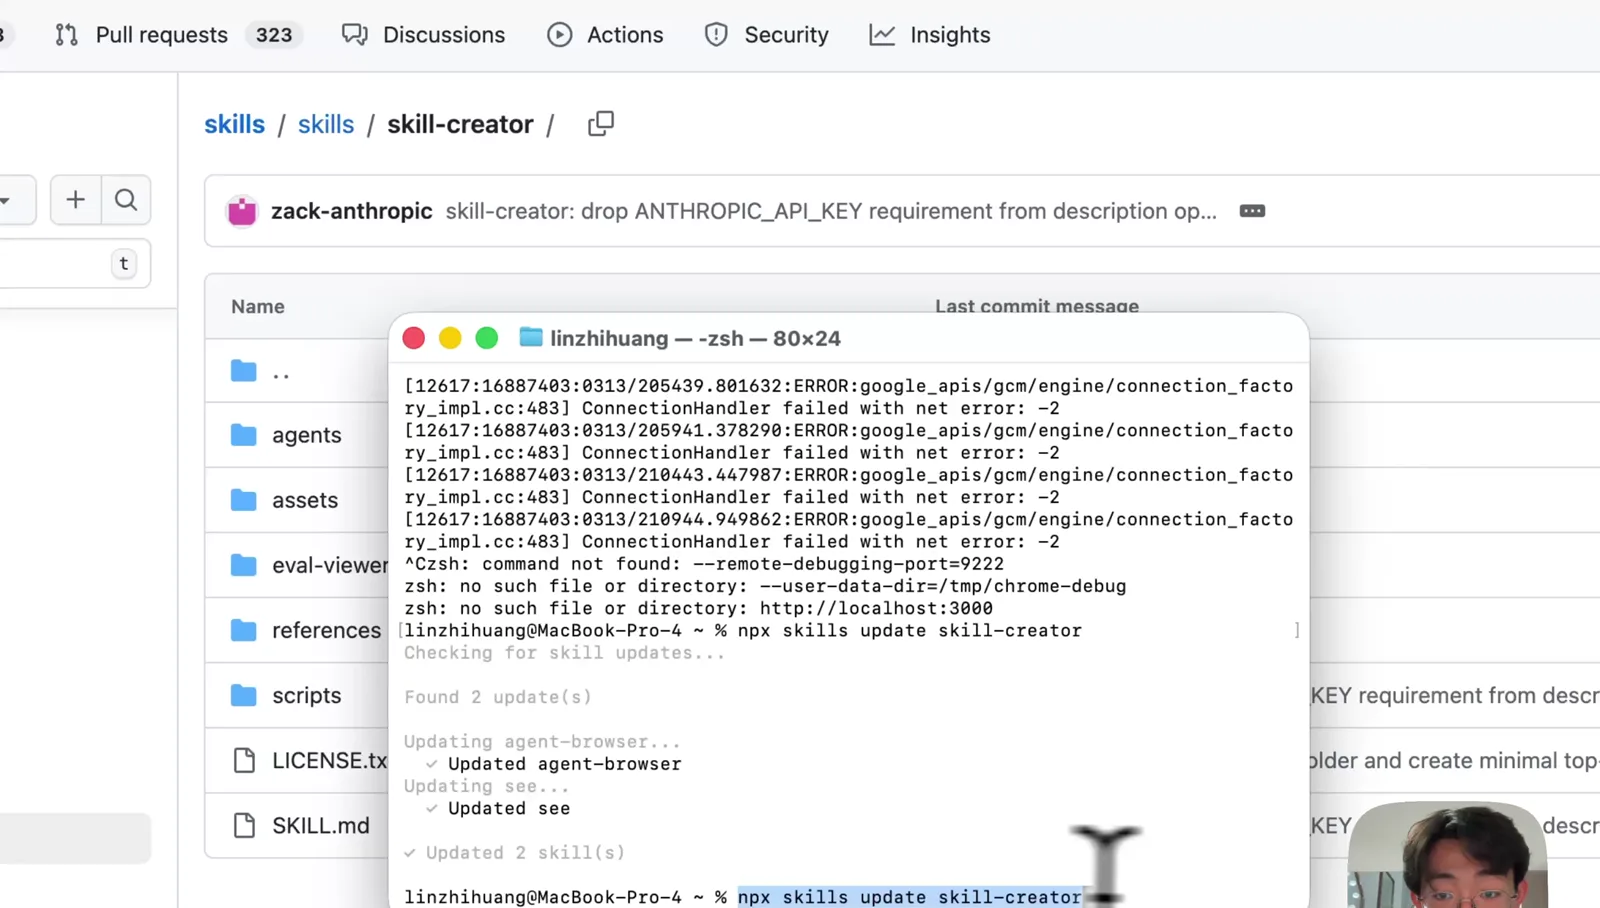
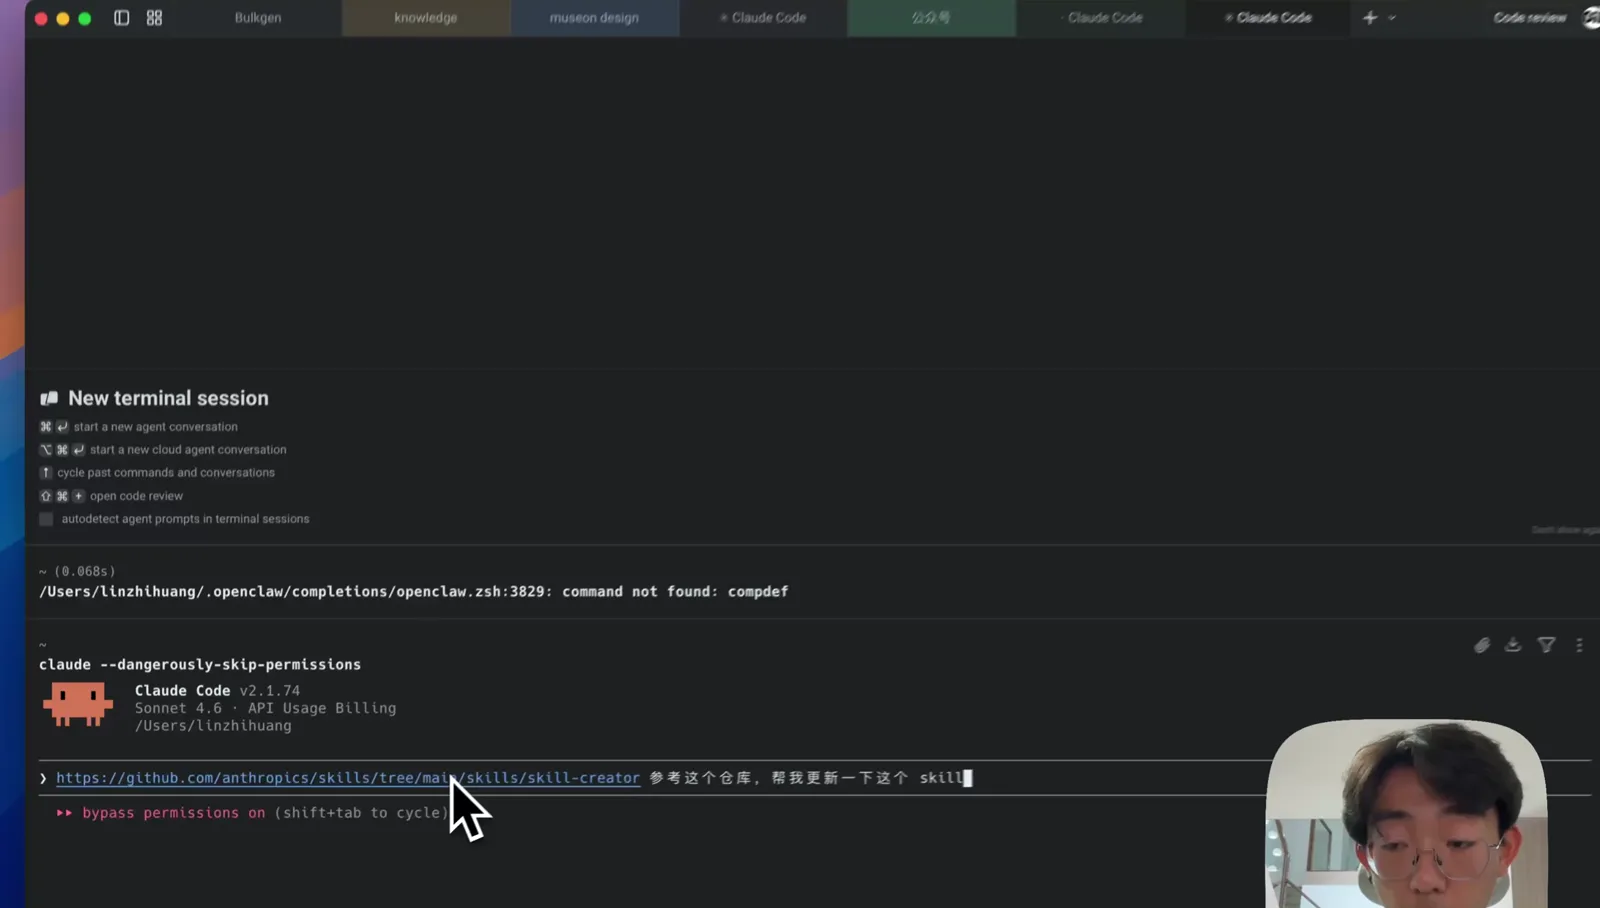
我的解决办法是复制 skill-creator 的仓库链接,打开 Claude Code,把链接粘贴给它,让它参考这个仓库把这个 Skill 的功能更新一下。这样说了之后,Claude Code 会把代码拉下来覆盖本地的 Skill,只有这样才算真正更新完成。
更新之后,除了 SKILL.md 有了最新的洞察和理解,还增加了 Skill 性能评估的功能。我们可以启动多个子 Agent,一个带 Skill、一个不带,对比它们产出代码的差异。比如有一个 UI/UX 优化的 Skill,把它配到一个子 Agent 上,另一个不配,让它们一起生成页面,对比效果。评估过程中,skill-creator 还提供了一个可以交互的网站,我们可以自己人工 review,再加上机器打分,用两种方式判断 Skill 的质量,得到一个更数据化的对比。
优化我的 Codex Skill
我之前发布过一个 Codex Skill,可以在 Claude Code 里面调用 Codex,让两个 Agent 一起协作。skill-creator 更新之后,我把这个 Codex Skill 也优化了一波。
不过因为 Codex Skill 是一个外接能力,skill-creator 里的评估机制对它意义不大,所以我主要是参考最新的 SKILL.md 优化描述,再基于自己使用过程中遇到的报错修改调用 Codex 的脚本。下面是我这次的更新记录。
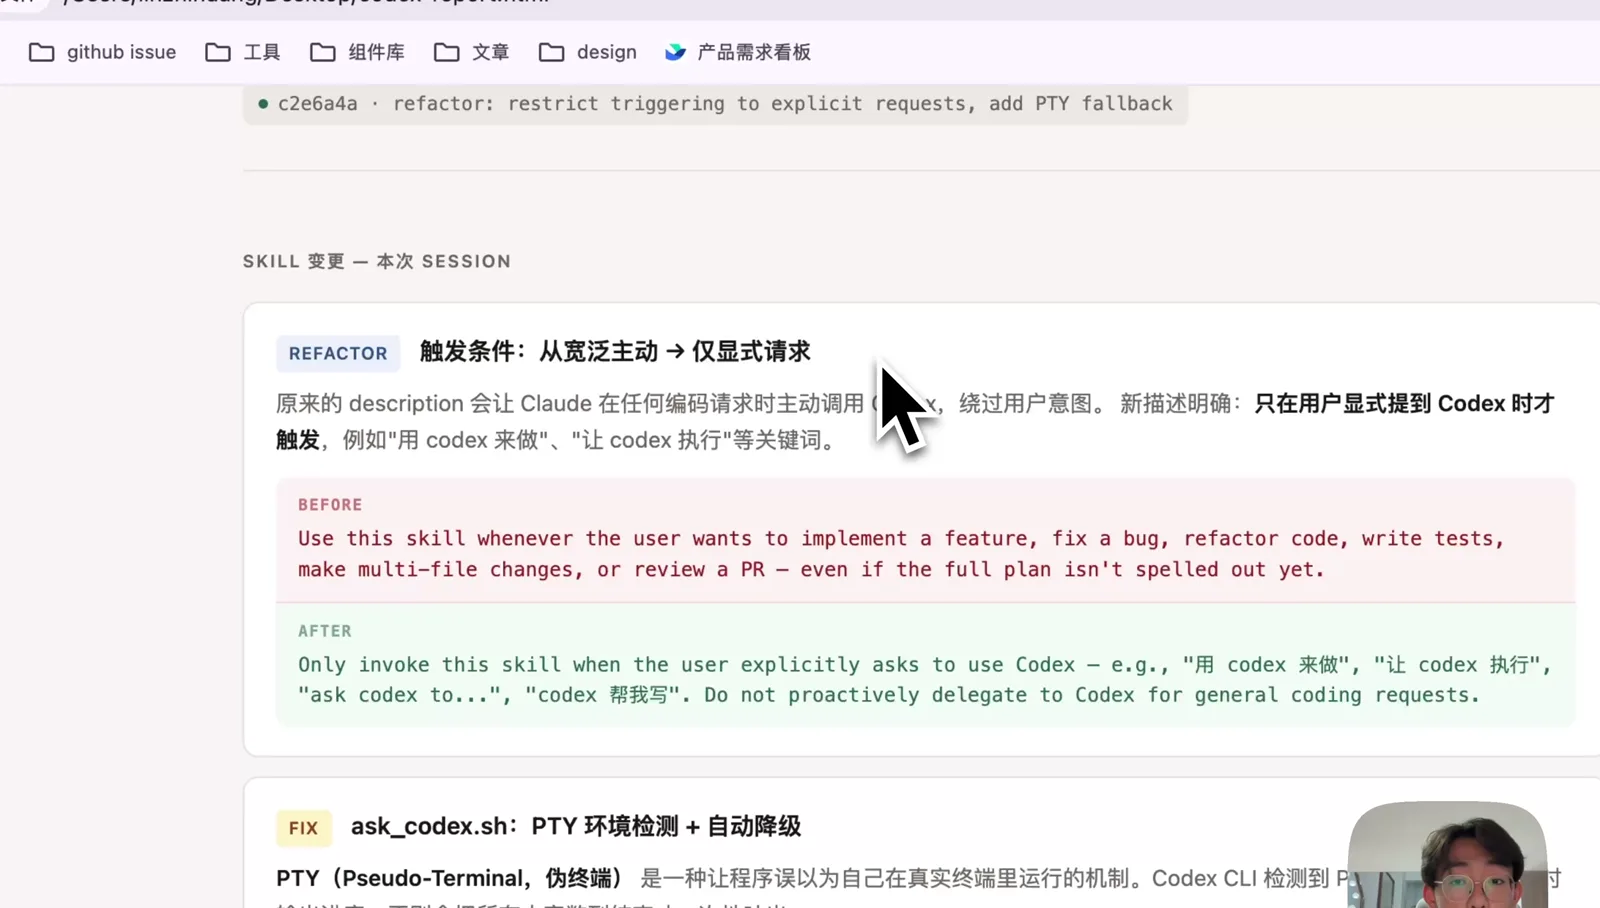
第一个调整是触发条件。最开始的描述会让 Claude Code 觉得只要需要写代码或者做 bugfix,就可以让 Codex 一起执行。现在改成了显式请求:只有主动提到需要 Codex,比如「用 codex 来做」「让 codex 执行」,它才会去调用。这样修改的原因是,如果用的是 Claude 的 Opus 模型,它自己处理没问题;但如果用一些国产模型,或者上下文已经比较长,有时一个很简单的任务它也会让 Codex 来做,其实它自己去修改会更简单。
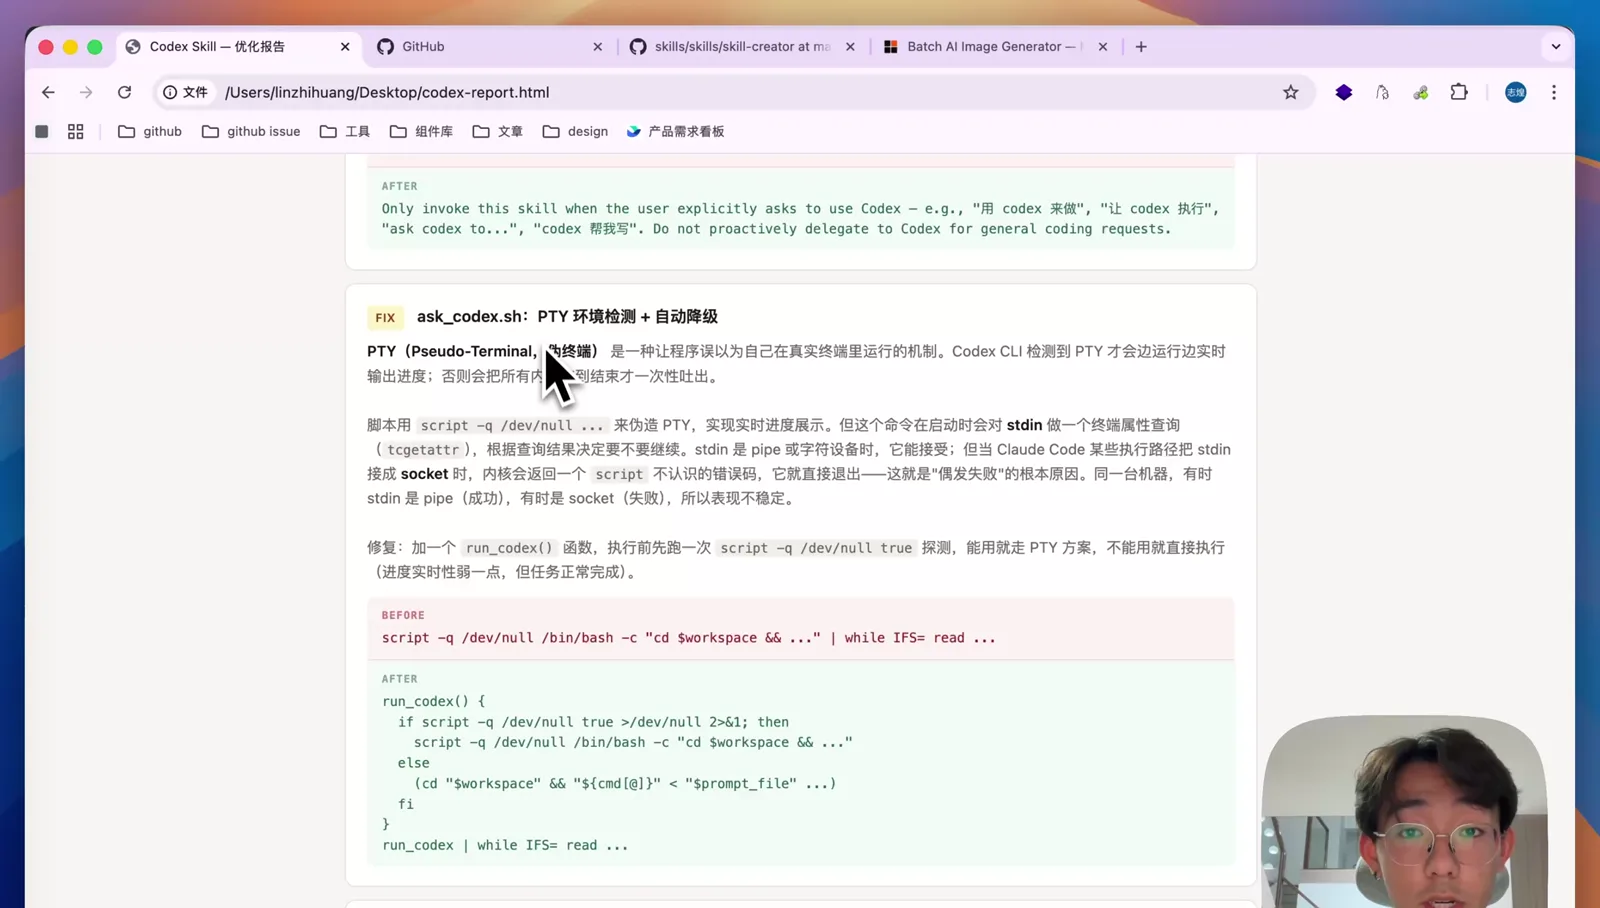
第二个是 PTY 环境检测的问题。PTY 是伪终端,我在实际使用过程中经常遇到相关的问题,这涉及到 Claude Code 本身在终端执行命令上的一些设计,具体的技术原因我不是很清楚,但我给脚本做了一个兼容:检测到 PTY 不可用时自动降级,减少终端执行命令时的失败。
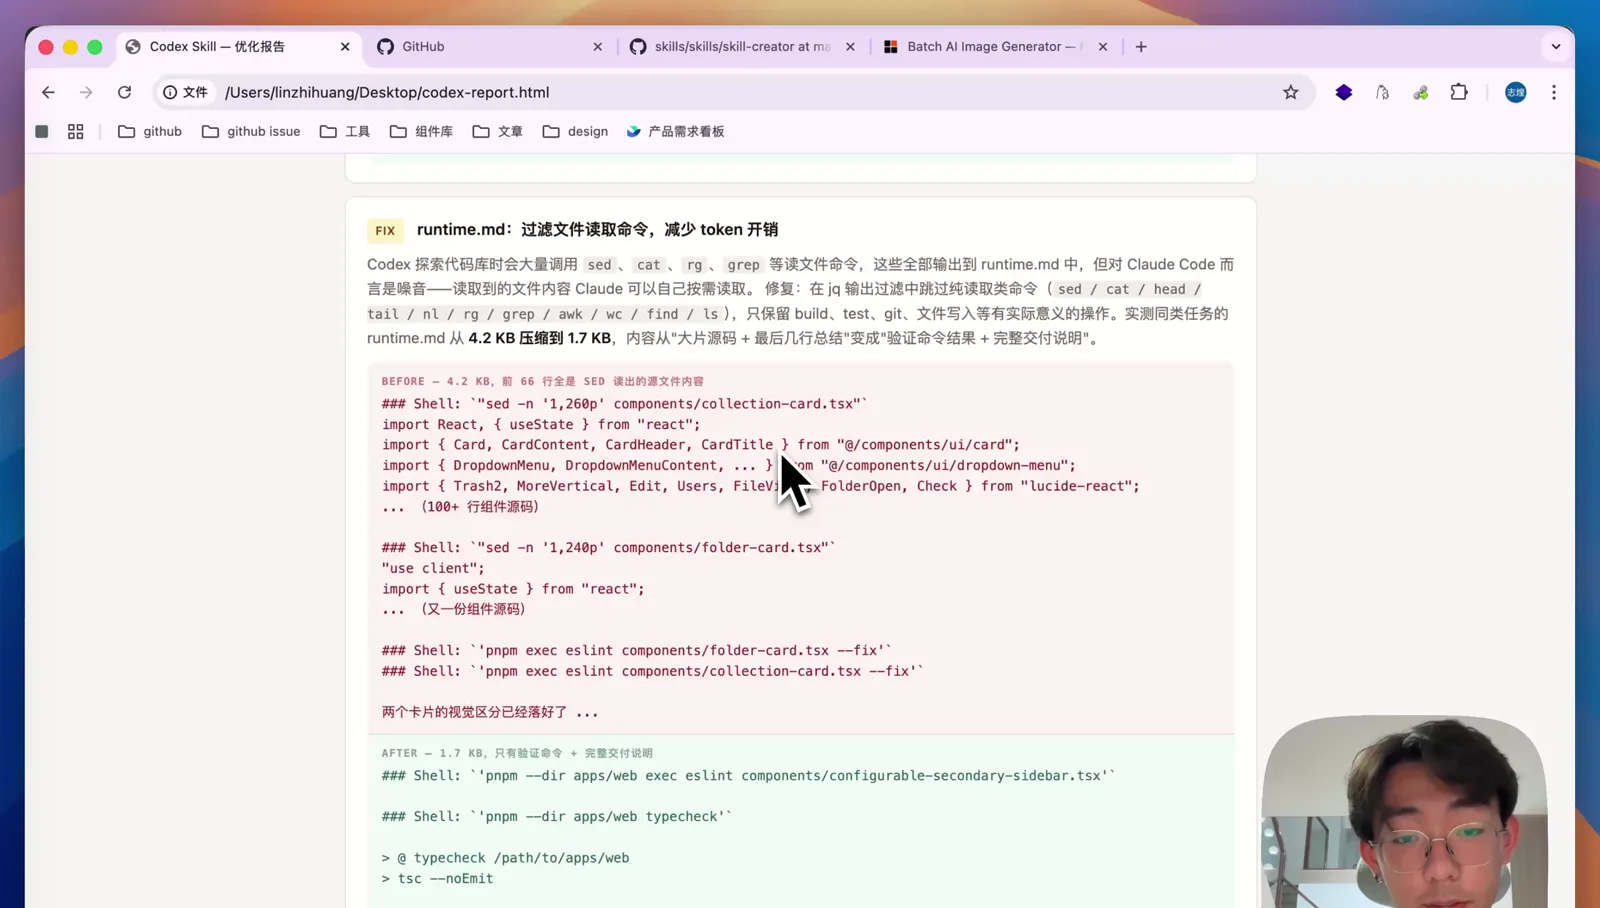
第三个是很重要的一个更新。Claude Code 调用 Codex 之后,Codex 执行过程中会把所有记录输出到一个 Markdown 文件里。之前 Codex 探索代码库时会大量调用查看代码的命令,这些命令会把读到的代码也写进这个 Markdown。这部分探索内容对 Claude Code 帮助不大,是我之前的一个疏忽。这次我把读取文件的命令全部过滤掉了,最终保留的都是比较重要的信息,比如执行了哪些类型检查、最终的结论是什么。我自己实际使用过,这个过滤不会影响 Claude Code 对 Codex 执行结果的判断,而它读取的上下文会少很多,大概少三分之二到四分之三。
第四个是优化 SKILL.md 里原本的一些规则,这是 skill-creator 的新描述帮我检查到的。一方面是删除了一些冗余的描述;另一方面,原来的规则里用了 Only、Never、Always 这类强制语气,但没有解释为什么要这么做,现在按照 skill-creator 里「解释为什么这么做」的原则重写了这些描述。
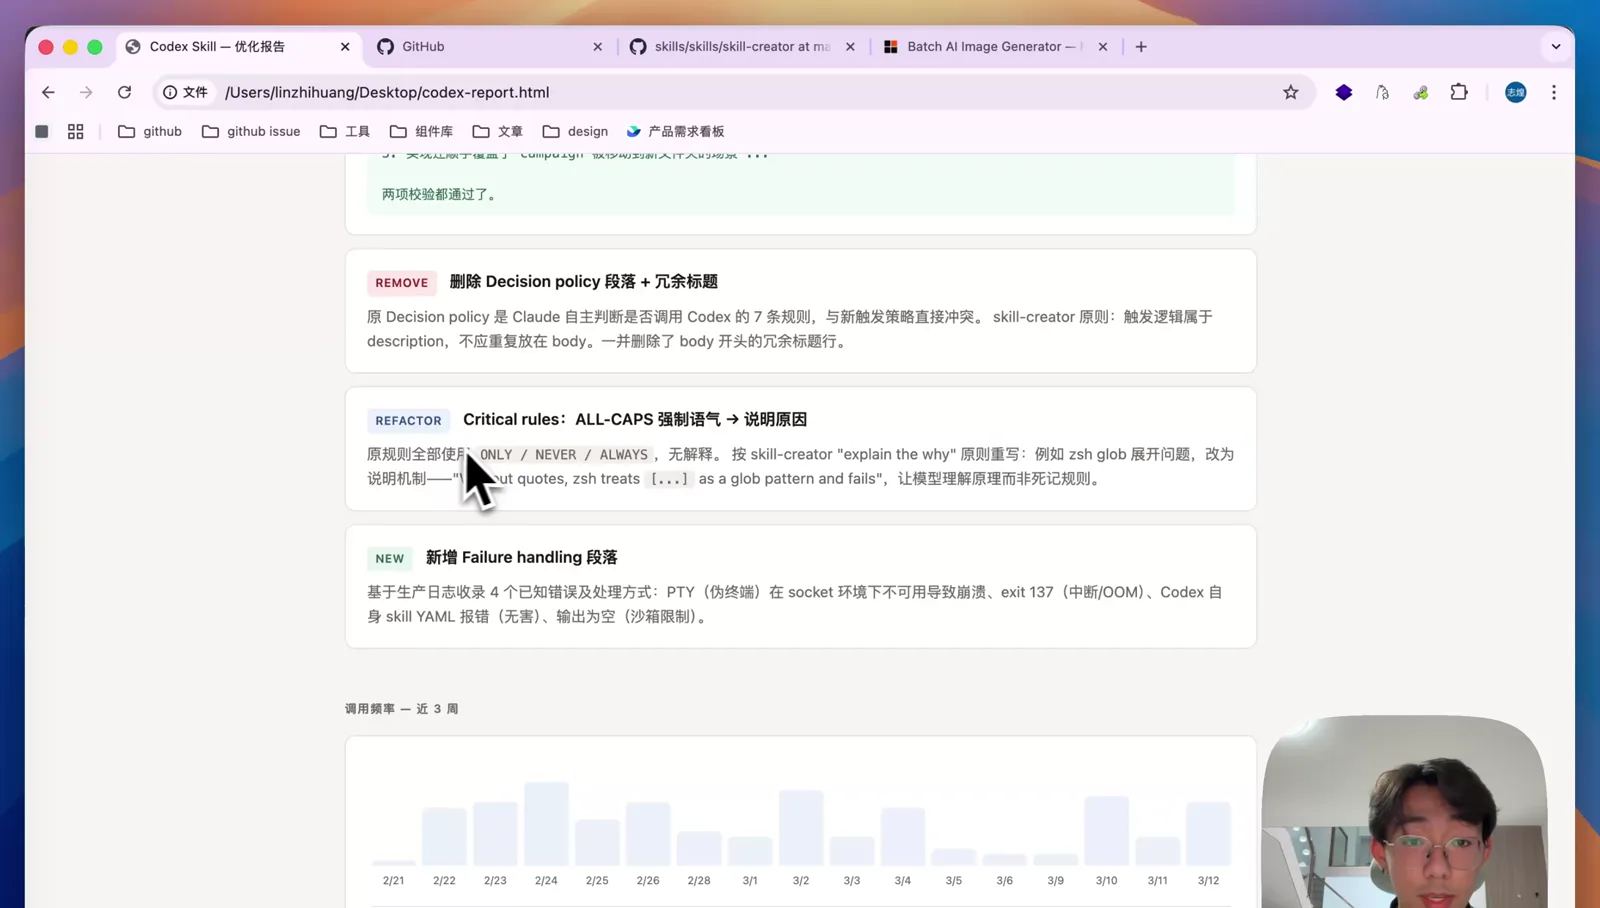
最后一个是错误处理。我自己的处理方式是这样的:每隔几天,我会让 Claude Code 扫一遍以前所有的对话信息,复盘之前调用 Codex 在哪些情况下失败了,把这些失败的原因写回 SKILL.md,避免下次调用的时候又报错。
最近的使用方式
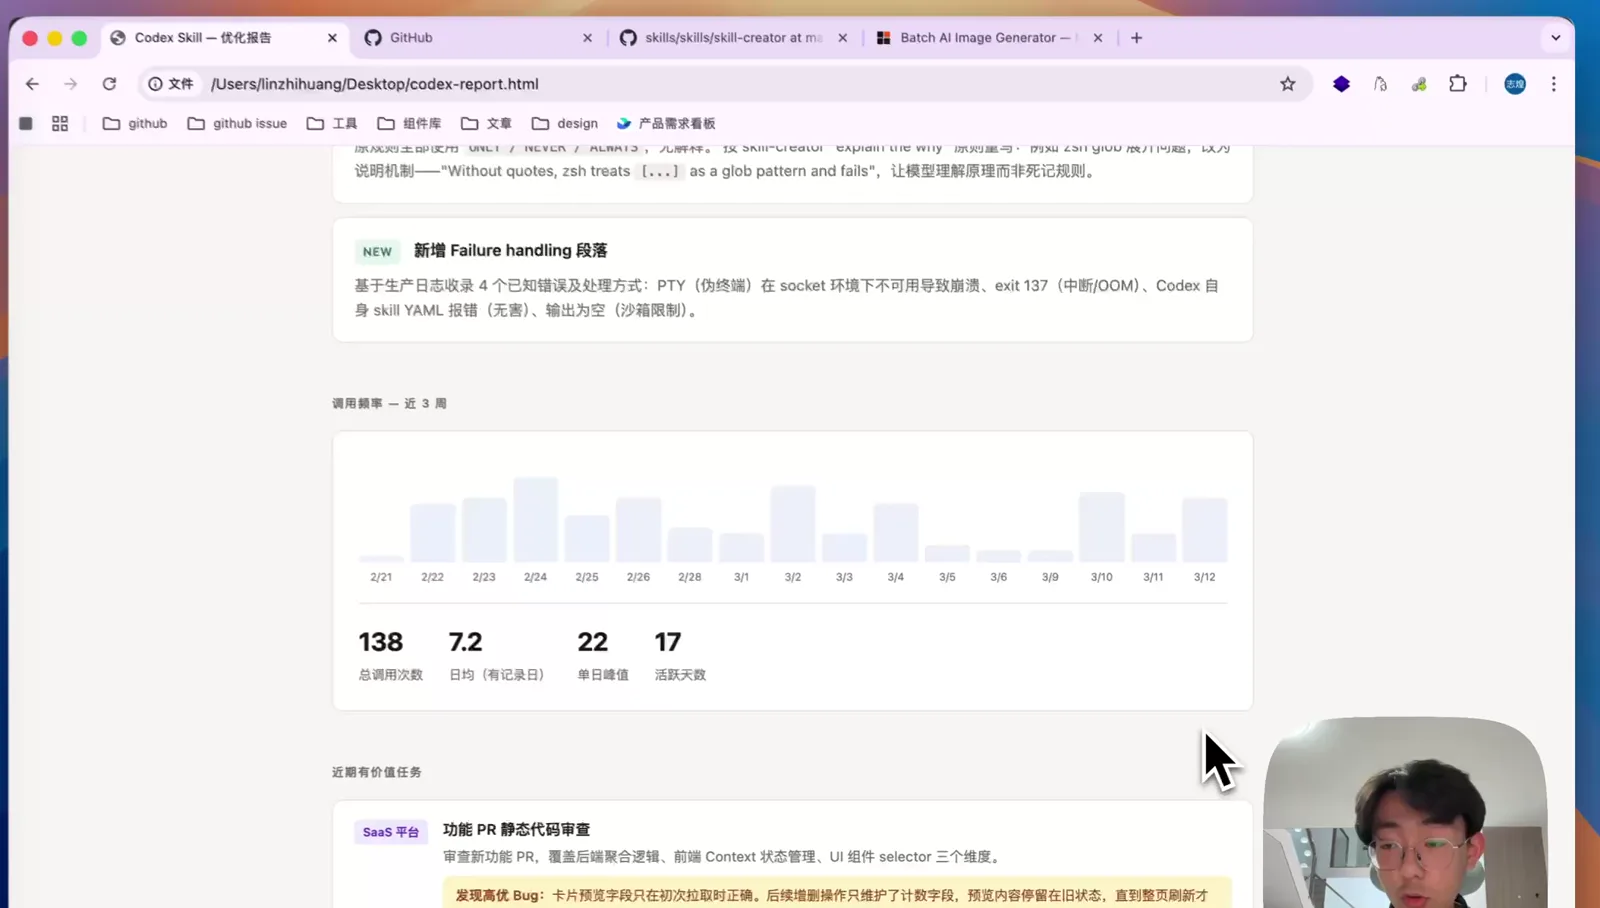
最近我调用 Codex 非常频繁,近三周总共调用了 138 次。两个 Agent 一起协作可以大大减少 Claude Code 的开销,而且 Codex 执行任务时的上下文不会插到 Claude Code 的对话里,我可以让 Claude Code 一直保持在一个比较聪明的状态。
还有一点是让 Claude Code 并行调用多个 Codex 执行任务。比如让 Codex review 代码的时候,它里面其实没有对话上下文,对错误的判断会比 Claude Code 做得更仔细。最近开发过程中,Codex 经常帮我 review 出很多 Claude Code 自己没有发现的问题。
我最近上线了一个网站,开发时有意使用了 Codex 并行执行。这个网站的设计稿是用 Gemini 生成的,如果让 Claude Code 去像素级复刻,会消耗很多 Token。我的做法是让 Claude Code 调用 Codex,把任务拆成多个并行的 Codex:一个做首屏,一个做定价模块,一个做 CTA 底部栏,每个 Codex 从设计稿里把自己负责的模块复刻成 React 代码,最后再让一个 Codex 把这些组件组合成一个完整的页面。
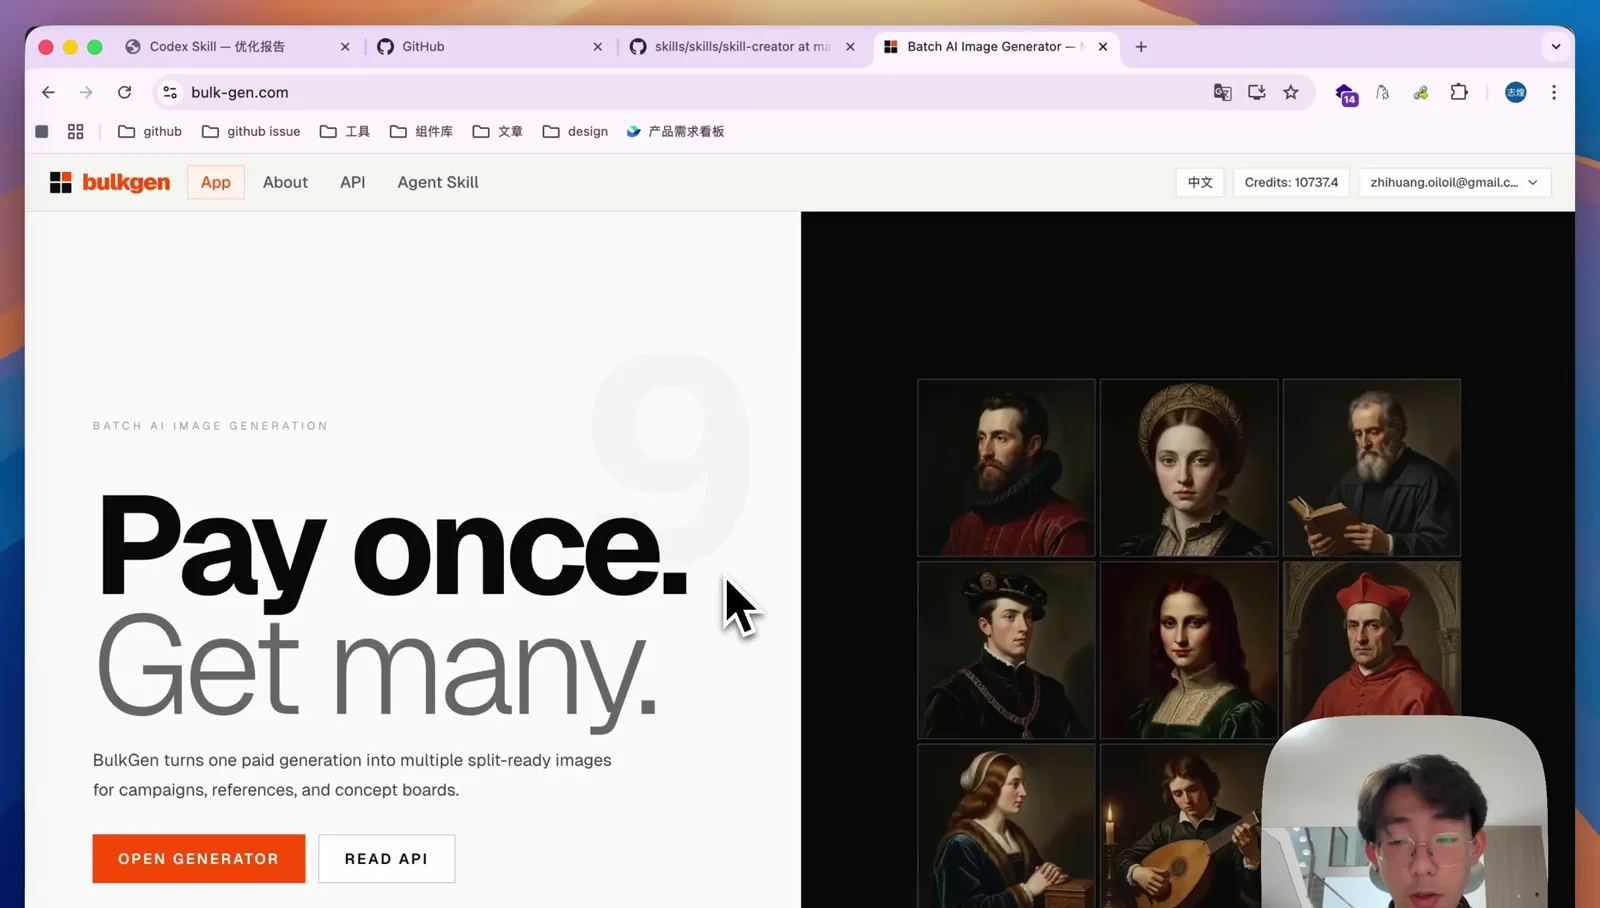
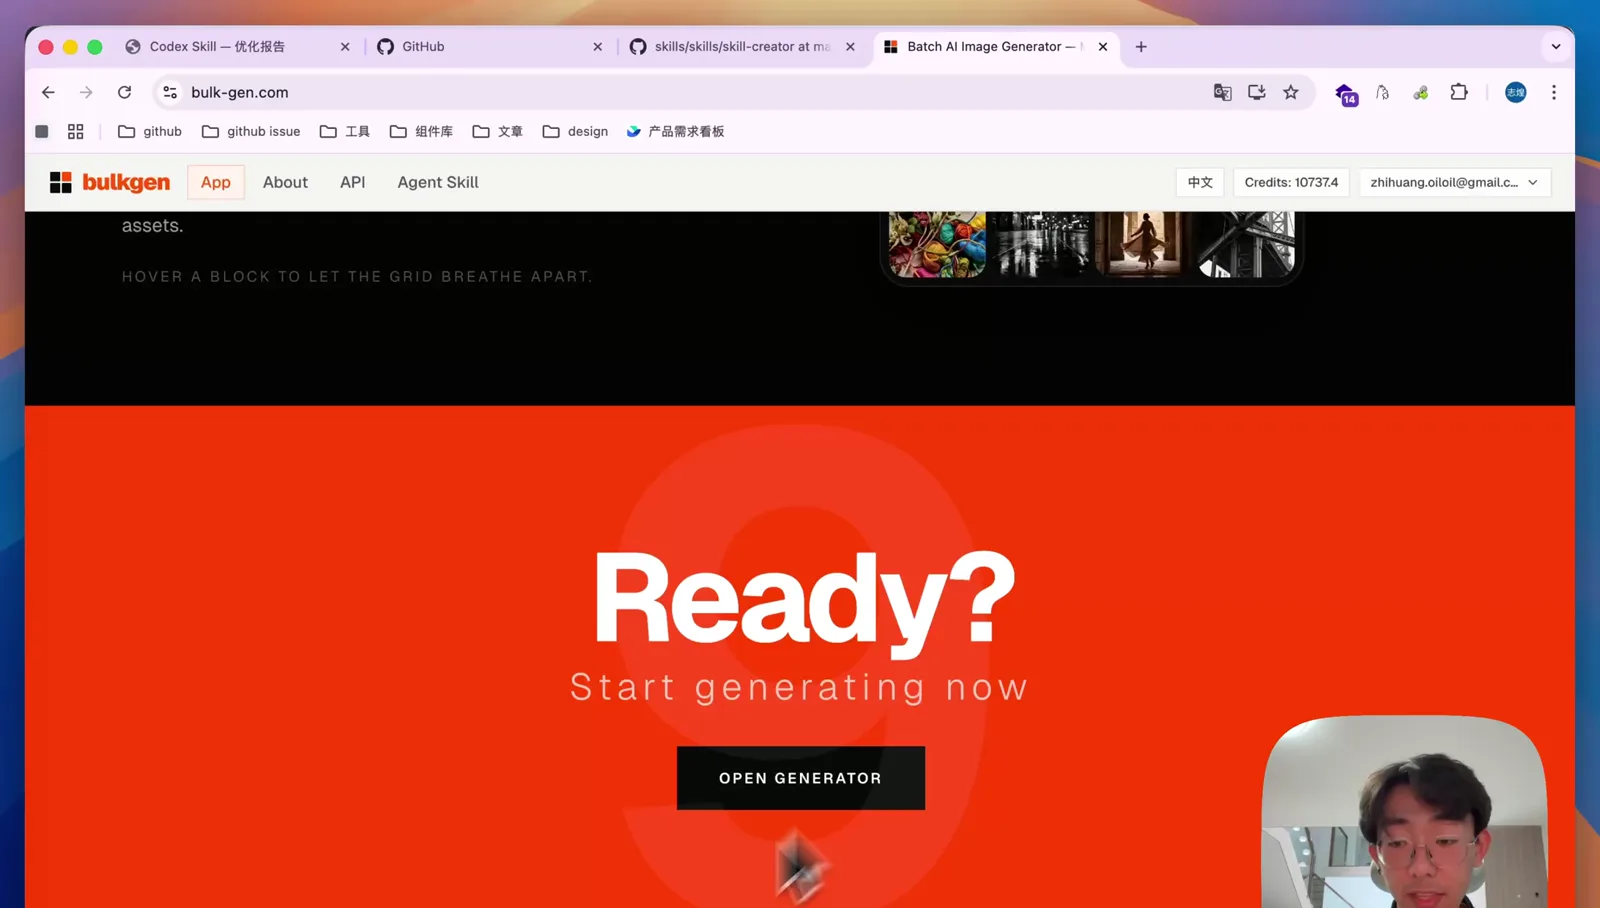
这样 Claude Code 全程只需要读最终组合出来的页面,判断效果没问题就好了。不仅实现的速度更快,还减少了很多 Token 开销,因为 Codex 本身比较便宜,并行执行也更快。