在今年的云栖大会上,阿里披露 Qwen4 正在训练中,后续的 Qwen4.5 与 Qwen5 参数规模预计达到 5T 到 10T,同时还集中发布了一批图像、视频、音频和世界模型。在这些新模型里,我第一时间在阿里云百炼上实测了全新的音频生成模型 Qwen-Audio-3.1-TTS-Next。
过去做产品或游戏开发时,音频生成往往被拆成两套完全独立的工具:生成完整歌曲找 Suno 这类音乐模型,生成角色台词找 TTS 语音合成模型。但像脚步声、挥剑声、开关门声、环境底噪这类细碎的音效,一直缺少顺手的生成方案;角色配音也大多只能从预设音色库里挑一个接近的声音,很难根据每个角色的年龄、性格和地域背景临时捏出贴合的声线。
Qwen-Audio-3.1-TTS-Next 把人声、音效、环境声和背景音乐收进了同一个模型里,既能按提示词单独生成某一种声音,也能在一段音频里同时合成带环境音的人声对白。
狼人杀游戏的配乐与音效测试
我之前做过一款网页端 AI 狼人杀游戏 WOLFCHA(wolf-cha.com),正好拿它来测试游戏场景下的配乐和音效生成。
在夜晚阶段,我给模型传入提示词,要求生成一段略带紧迫感、但不过分吓人的背景音乐,以低沉的弦乐与小提琴为主;到了白天阶段,则切换成平静温和的村庄日常氛围,加入木吉他、曼陀林和清晨的鸟叫声。模型直接输出了符合情绪节奏的两段纯音乐,不需要再去外部曲库里翻找素材。
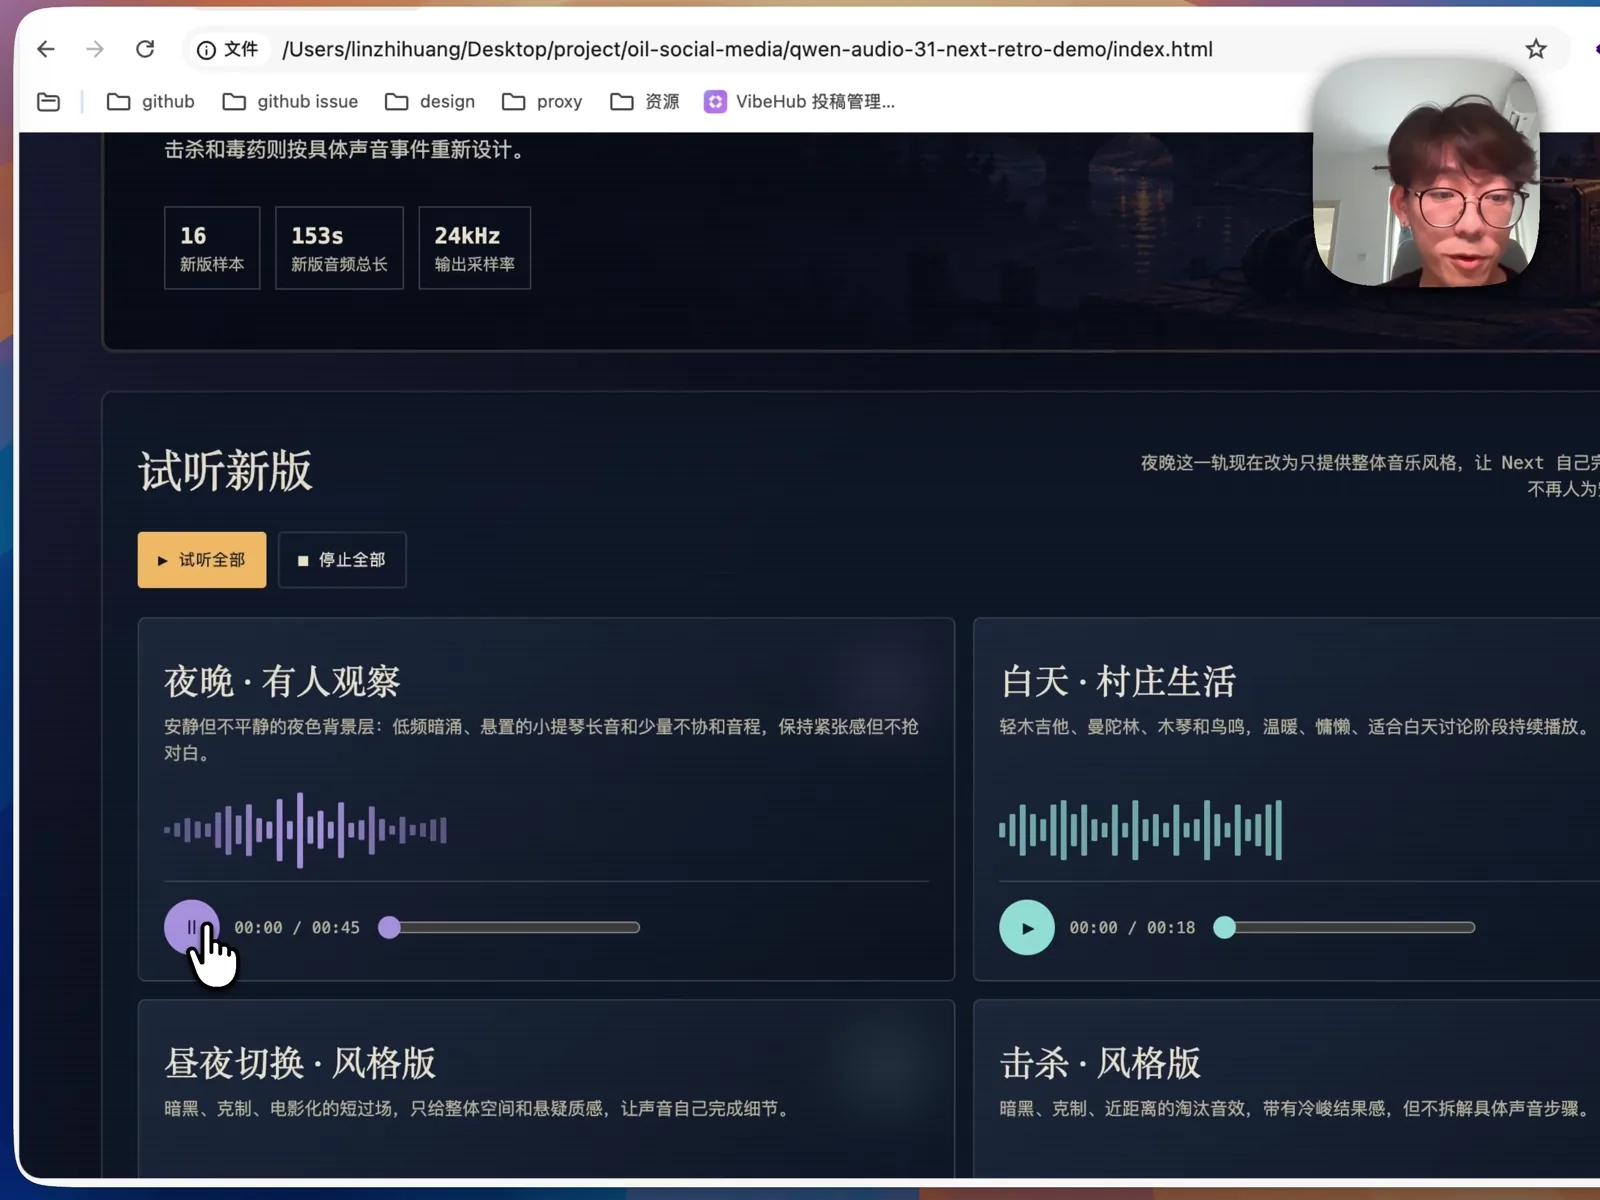
除了背景音乐,游戏里的关键动作也需要短促清晰的音效反馈。我接着测试了三类常见音效:
- 昼夜切换音效:要求做出类似电影转场的空间感,生成的音频带有明显的氛围过渡。
- 狼人击杀音效:直接生成锋利短促的出手声,贴合夜晚结算时的紧张感。
- 女巫毒药音效:在提示词里描述冒泡与药水散开的质感,也能一次生成到位。
以往要凑齐这几类声音,得在多个音效素材站里反复筛选裁剪;现在用同一个模型就能把背景音乐和动作音效全部补齐。
多方言角色配音与音色一致性控制
在这款狼人杀游戏里,系统会为每一局的 AI 玩家随机生成姓名、年龄、性别和性格背景。以前的 TTS 接口只能让角色绑定固定音色,而 Qwen-Audio-3.1-TTS-Next 支持直接在提示词里指定方言和说话语气。
我在测试页里给五位不同性格的玩家分别设定了口音和台词:
- 沈砚(冷静分析):指定广东话口音,生成“我唔急住投票,先睇下边个人嘅发言前后唔一致”,咬字和语调都很地道。
- 程野(强势推进):指定东北口音,生成“我先把话撂这儿,七号这轮的逻辑我不认,大家别跟着起哄”,重音和干脆的语气直接立住了角色性格。
- 苏槐(情绪识别):指定上海话口音,生成“侬先别急,我听下来,大家其实都在害怕同一件事”,语速舒缓自然。
不过,只靠文字提示词生成人声会遇到一个问题:即使两段话使用完全相同的音色描述,模型每次随机生成的声线还是会有细微偏差。放在单句测试里听不出来,但如果用来做贯穿整局游戏的系统旁白,玩家就会发现法官的声音一直在变。
为了解决这个问题,可以利用 Qwen-Audio-3.1-TTS-Next 支持“文本 + 音频”双输入的能力。先挑出一段干净、没有背景杂音的旁白音频作为参考音频传给模型,再让它依次生成“第 1 夜,天黑请闭眼”“天亮了,昨晚是平安夜,现在开始自由发言”“发言结束,开始投票,7 号玩家出局”等不同阶段的台词。
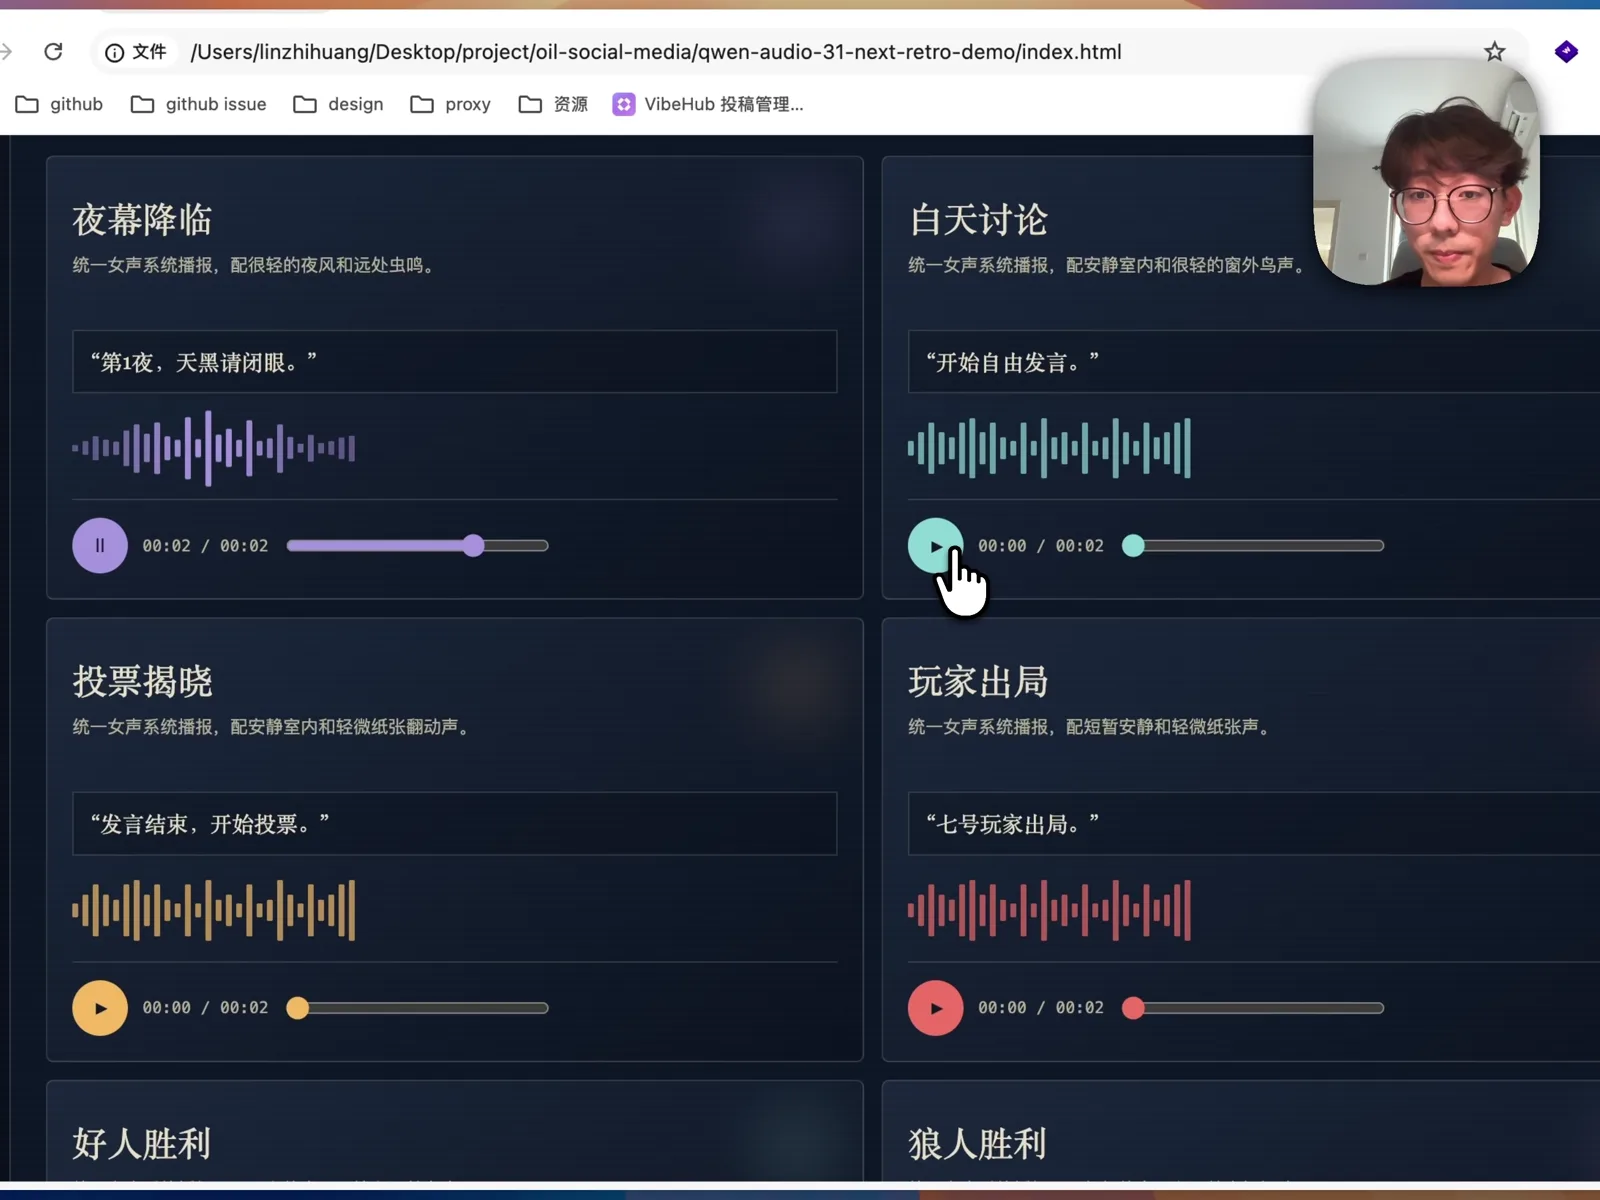
实测下来,加上参考音频之后,四段不同阶段的旁白完全保持了同一个女声声线,同时还能在提示词里要求叠加上轻微的夜晚或村庄环境底噪,听感比干瘪的纯人声自然得多。
生成延迟边界与实时语音方案的选择
Qwen-Audio-3.1-TTS-Next 的表现力很强,但它的生成耗时通常在 10 秒到 1 分钟之间(取决于目标音频长度)。如果用来提前生成游戏的固定音效、背景音乐、固定旁白,或者在每局游戏开局加载时预生成几句角色口头禅,这个耗时完全可以接受;但如果放到 AI 玩家的实时轮流发言环节,让用户等十几秒才听到语音就会严重拖慢节奏。
针对实时对话场景,阿里云百炼上的另一个模型 Qwen3-TTS Instruct Flash Realtime(qwen3-tts-instruct-flash-realtime)更合适。它采用流式长连接方案,同样支持用自然语言提示词控制语气和风格,但从提交文字到收到第一个音频包只需要约 0.5 到 0.69 秒。
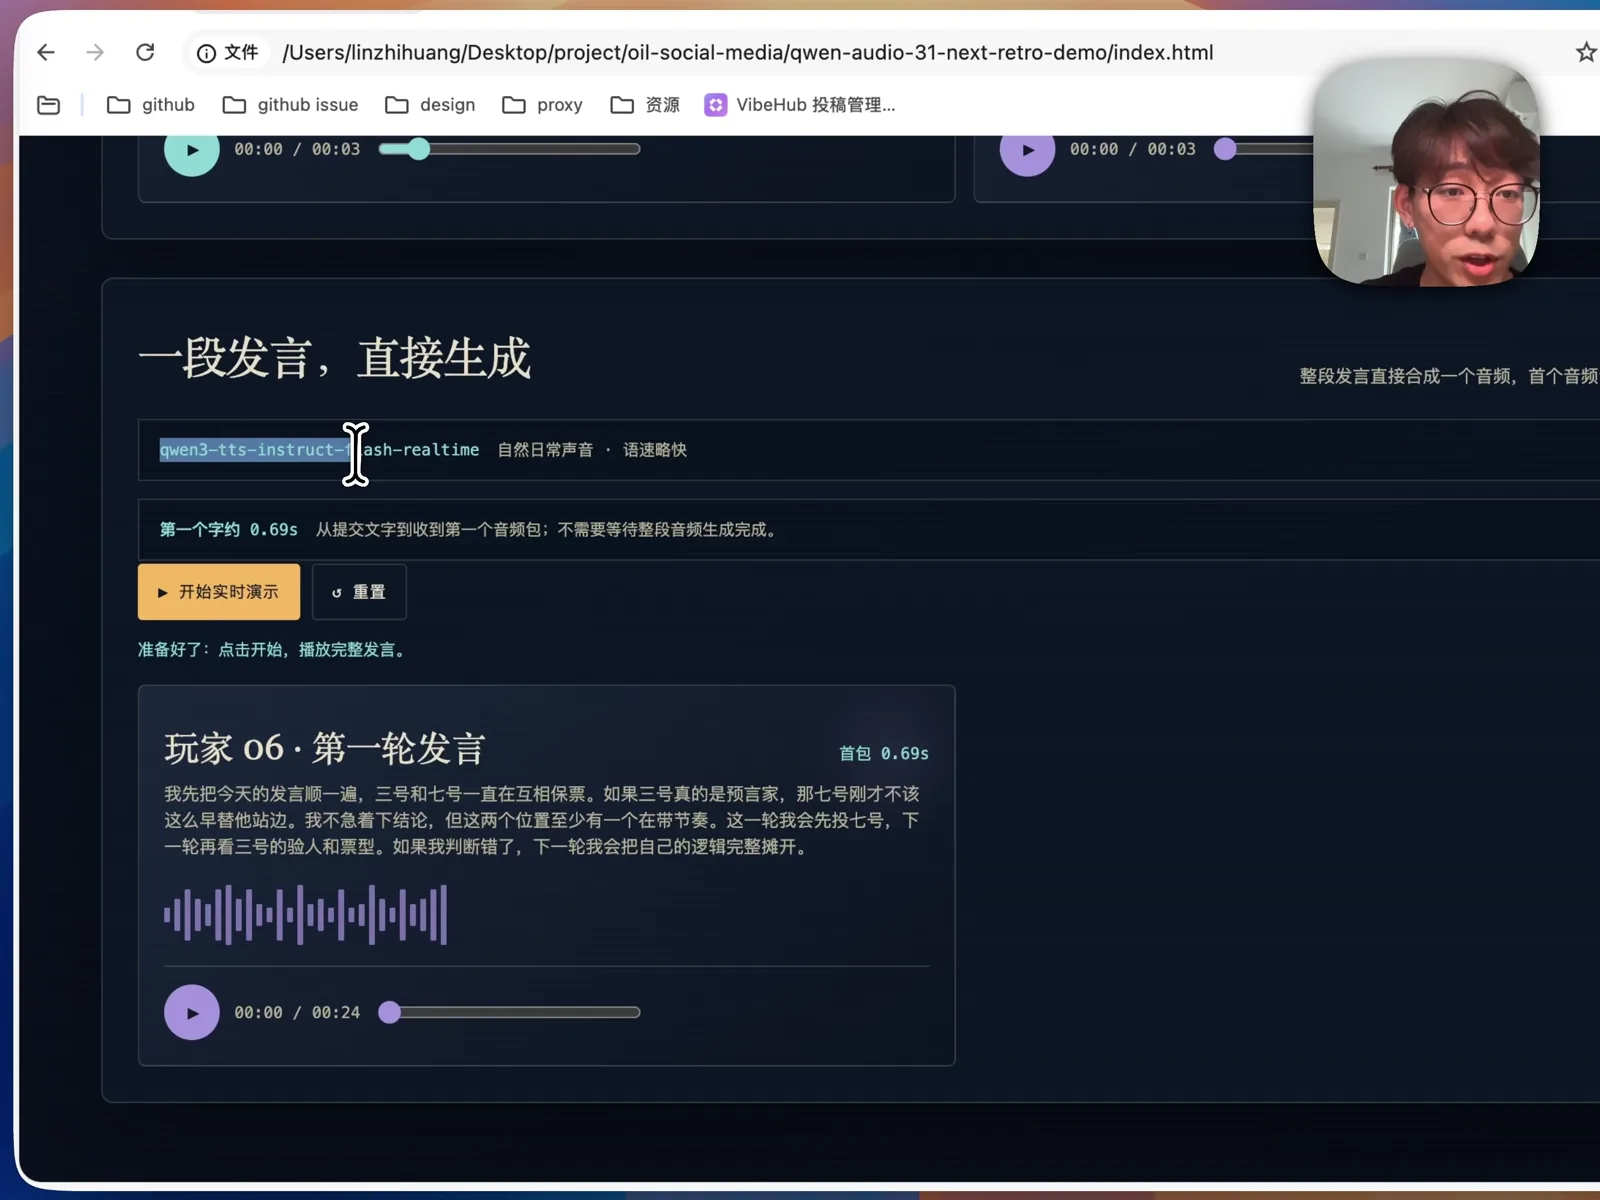
在实际项目里,可以把这两个模型配合起来用:用 Qwen-Audio-3.1-TTS-Next 生成高质量的环境配乐、动作音效和带参考声线的固定旁白,再用 Qwen3-TTS Instruct Flash Realtime 承接游戏过程中的实时动态发言。
让编码 Agent 自动听音调优的两个技巧
在用 AI Agent 开发带音频功能的应用时,还有两个能大幅省事的配置技巧。
第一是直接安装阿里云百炼的命令行工具(CLI)。很多编码 Agent 在对接新发布的音频或全模态模型时,并不清楚最新的模型 ID 和调用参数,手动查文档贴代码很繁琐。装好百炼 CLI 后,Agent 可以直接通过命令行调用平台上的各类语音和音效模型,还能顺带查看生成时长与调用耗费。
第二是给编码 Agent 配一个能“听声音”的裁判模型。主流的编码模型大多只支持文本和图片输入,生成完一段音频后,它自己并不知道声音对不对、台词有没有吞字、背景音是不是盖过了人声。这时可以让 Agent 通过百炼 CLI 调用全模态模型 Qwen3.8-Omni-Flash。
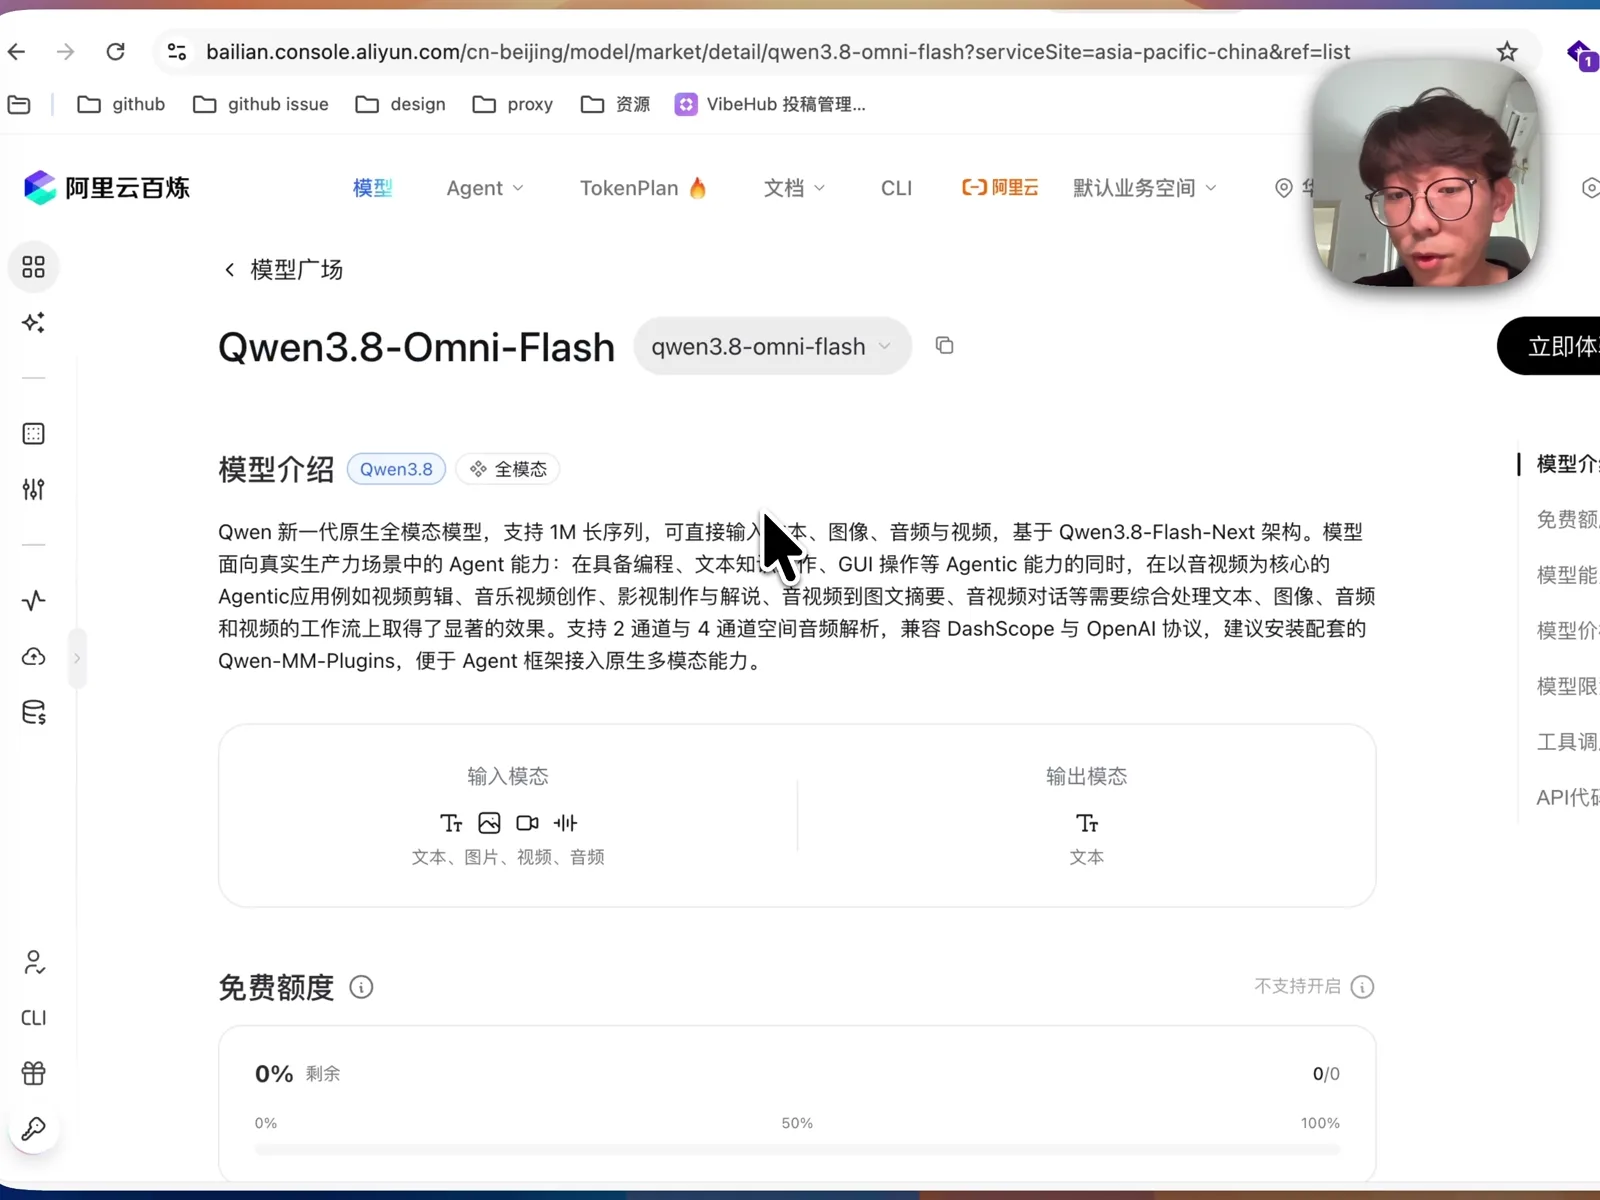
Qwen3.8-Omni-Flash 支持同时传入文本、图片、视频和音频。当 Agent 用 Qwen-Audio-3.1-TTS-Next 生成完音效或配音后,直接把音频文件丢给 Qwen3.8-Omni-Flash 做听感检查;如果返回结果指出语气不对或杂音太大,Agent 就能自动修改提示词重新生成,不再需要人守在电脑前一段段点开试听。