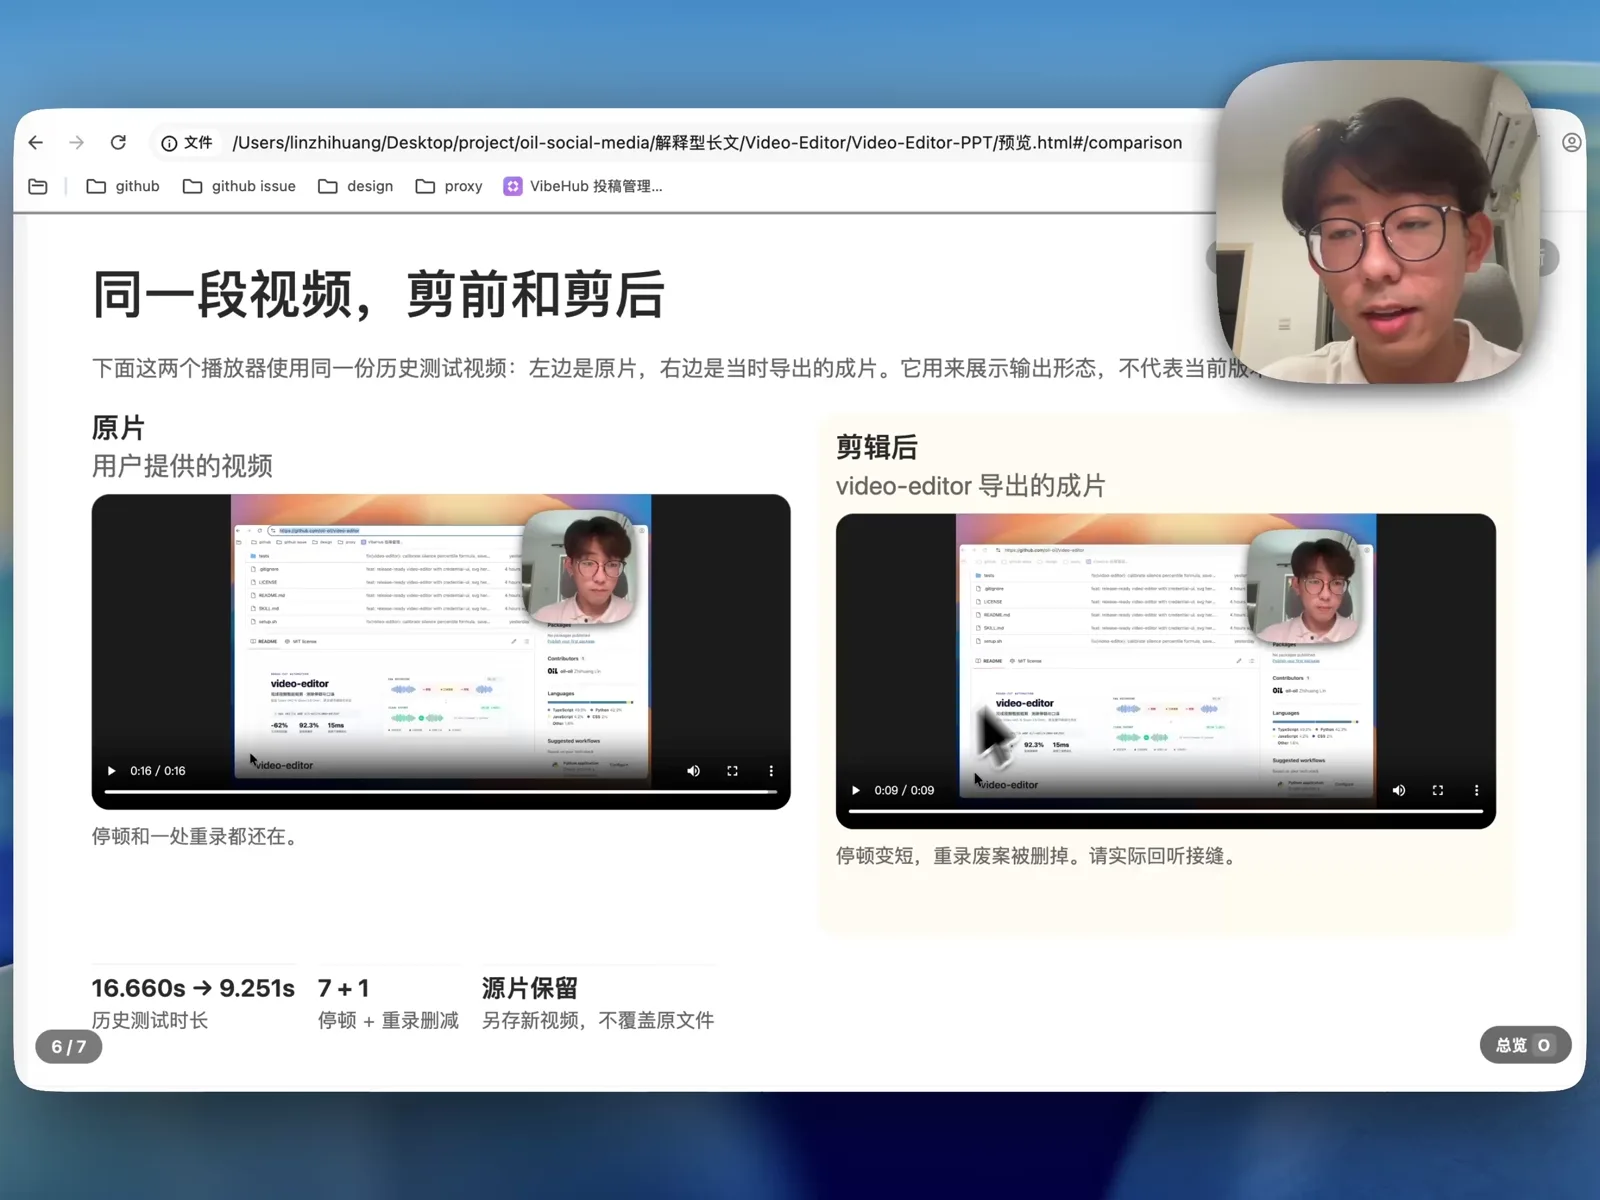
我录了一段 16 秒的测试口播:开头故意磕磕巴巴地重复说了两遍「哈喽大家好」,中间介绍 Skill 名称时也停顿重念了一次。把这段原始视频交给新写的 video-editor 处理后,它自动切掉了中间的 7 处长停顿和 1 处重录废案,导出了一个 9 秒的成片,原片则完整保留。
我已经用 AI 剪辑过很多期日常视频,之前也开源过 screen-studio-editor。这次之所以单独开源 video-editor,主要想解决两个之前一直存在的限制。
第一个限制是软件绑定。之前的 screen-studio-editor 直接读写录制软件 Screen Studio 的原始工程文件,如果你平时不用 Screen Studio 录屏,那套工具就没法直接用。而这次的 video-editor 直接处理现成的视频文件(如 MP4),不再与任何特定的录制或剪辑软件绑定。
第二个限制是重说片段的漏剪问题。在往期视频里,偶尔会出现我一句话说错重来时,AI 没有把前一遍废案剪干净的情况。这两天我重新调整了剪辑策略,并把往期自己手动精剪过的 5 个视频工程(总时长 53 分 21 秒)找出来作为对照组,用新的 AI 剪辑策略重新跑了一遍,对比两者的剪切时间点。
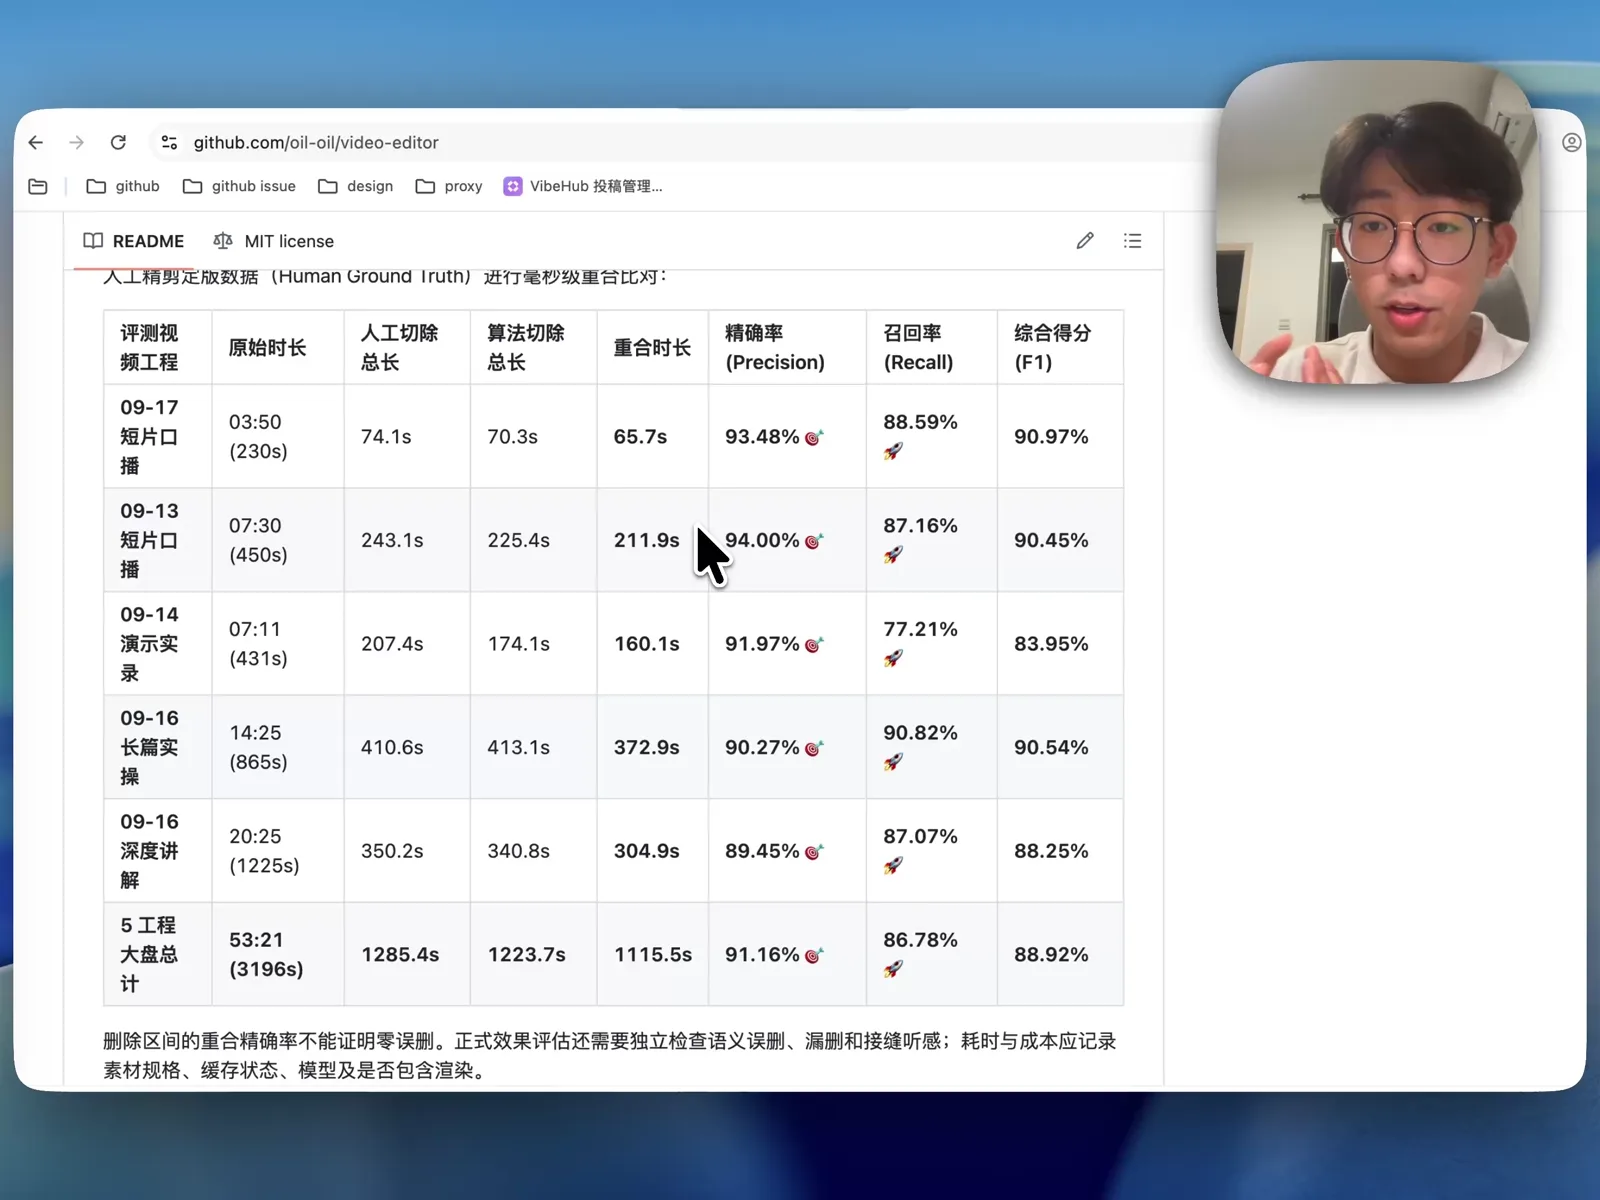
从实测对比来看,新策略切掉的片段与我手动精剪的重合精确率(Precision)稳定在 90% 以上,5 个工程汇总后的精确率达到了 91.16%。
五步流水线:把音频与字幕变成剪辑计划
因为 video-editor 专门针对口播视频设计,它的核心任务很明确,主要处理三类片段:
- 过长的空白停顿:把说话换气或思考时的长空白压短。
- 口误与重说废案:比如一句话说到一半卡壳,停顿后重头再完整说一遍,需要识别出前一半是废案并删掉。
- 语气水词的动态取舍:遇到「嗯」「那个」等水词时不能一刀切。如果某个水词夹在句子中间一闪而过、前后没有任何气口,强行剪掉反而会让声音听起来很破碎,必须结合上下文和前后停顿动态决定是否保留。
为了兼顾静音切除的精度和重说识别的语义理解,整个 Skill 把剪辑拆成了五个步骤:
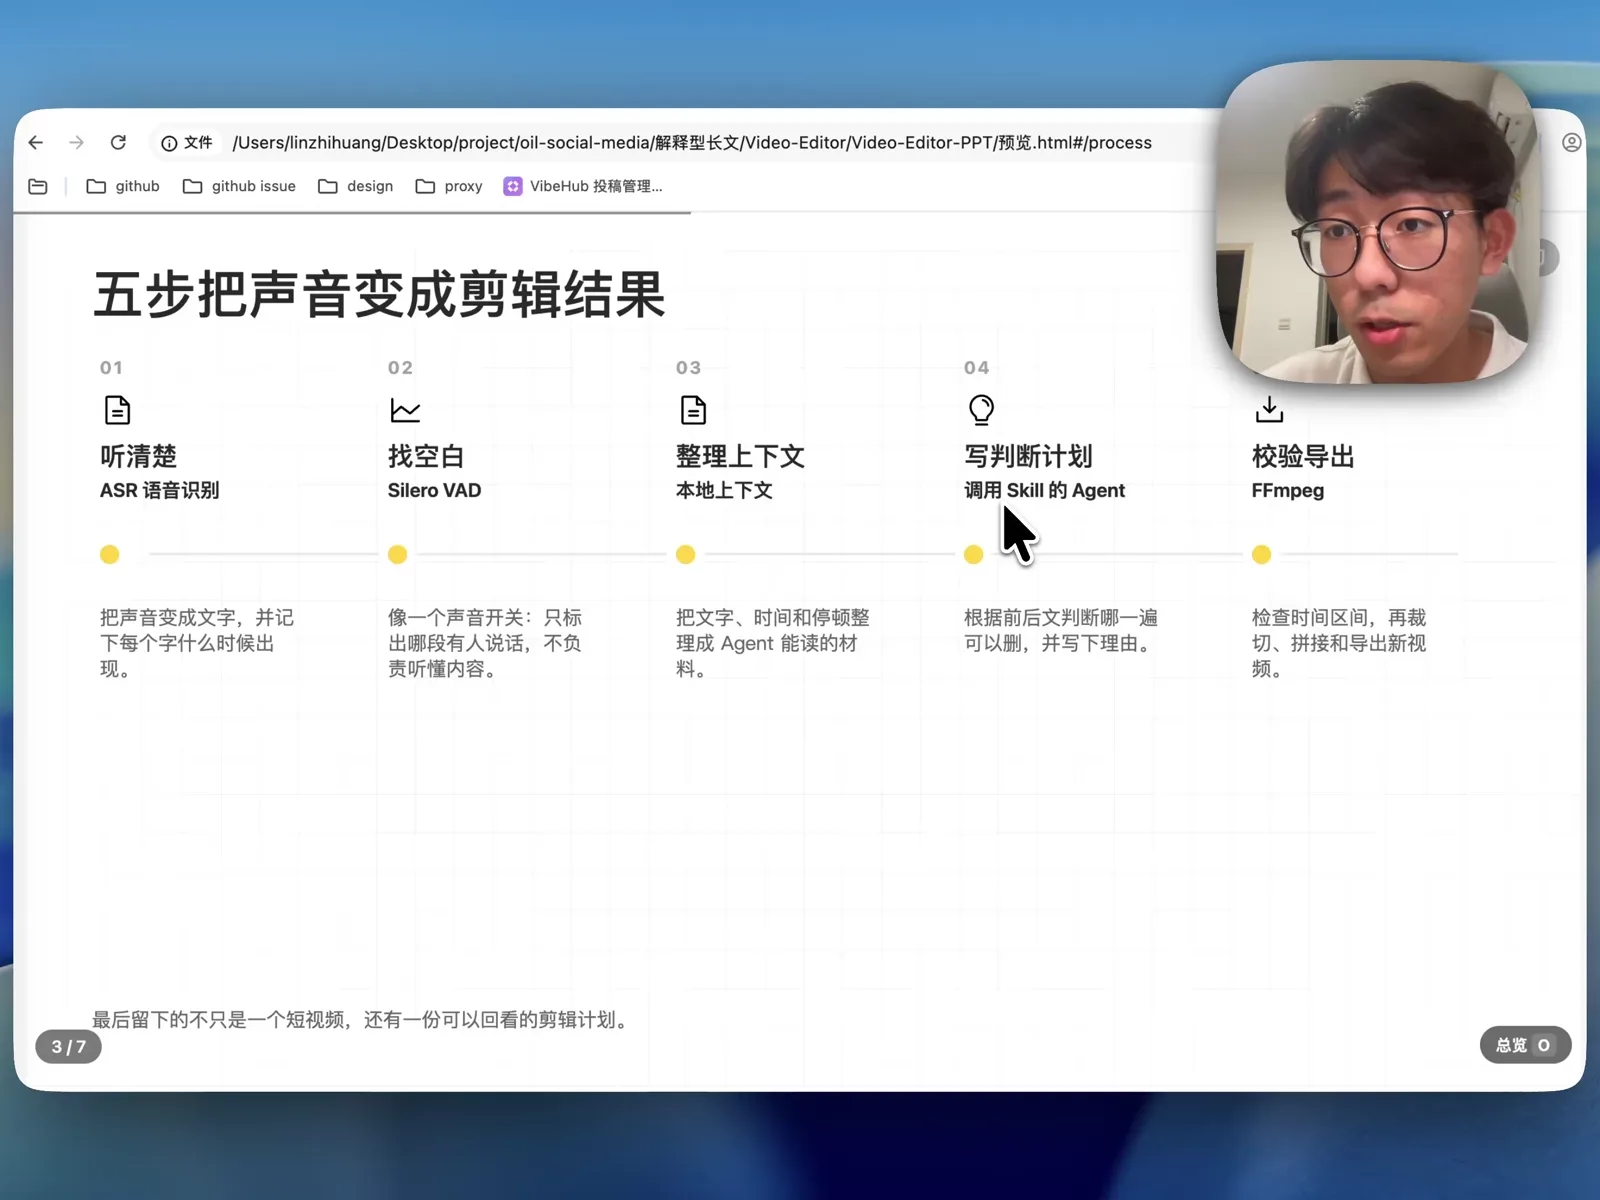
第一步是调用百炼的 ASR 语音识别模型,把视频里的音轨转成文字,并记录下每个字出现的精确时间戳。第二步调用 Silero VAD 模型,专门扫描音频里的语音活动区间,把没人说话的空白位置找出来。
前两步的大段静音其实靠程序就能直接定位,但涉及到「一句话连说两三遍,到底删哪留哪」,机械规则就无能为力了,必须依赖大模型理解字幕语义。因此第三步由本地脚本把文字、逐字时间戳和停顿时长组装成上下文,第四步交给当前执行任务的 Agent 读取这套材料并写出剪辑判断计划,最后第五步通过 FFmpeg 校验时间区间并裁切合成新视频。
保留自然气口与无需抽帧的 Agent 规划
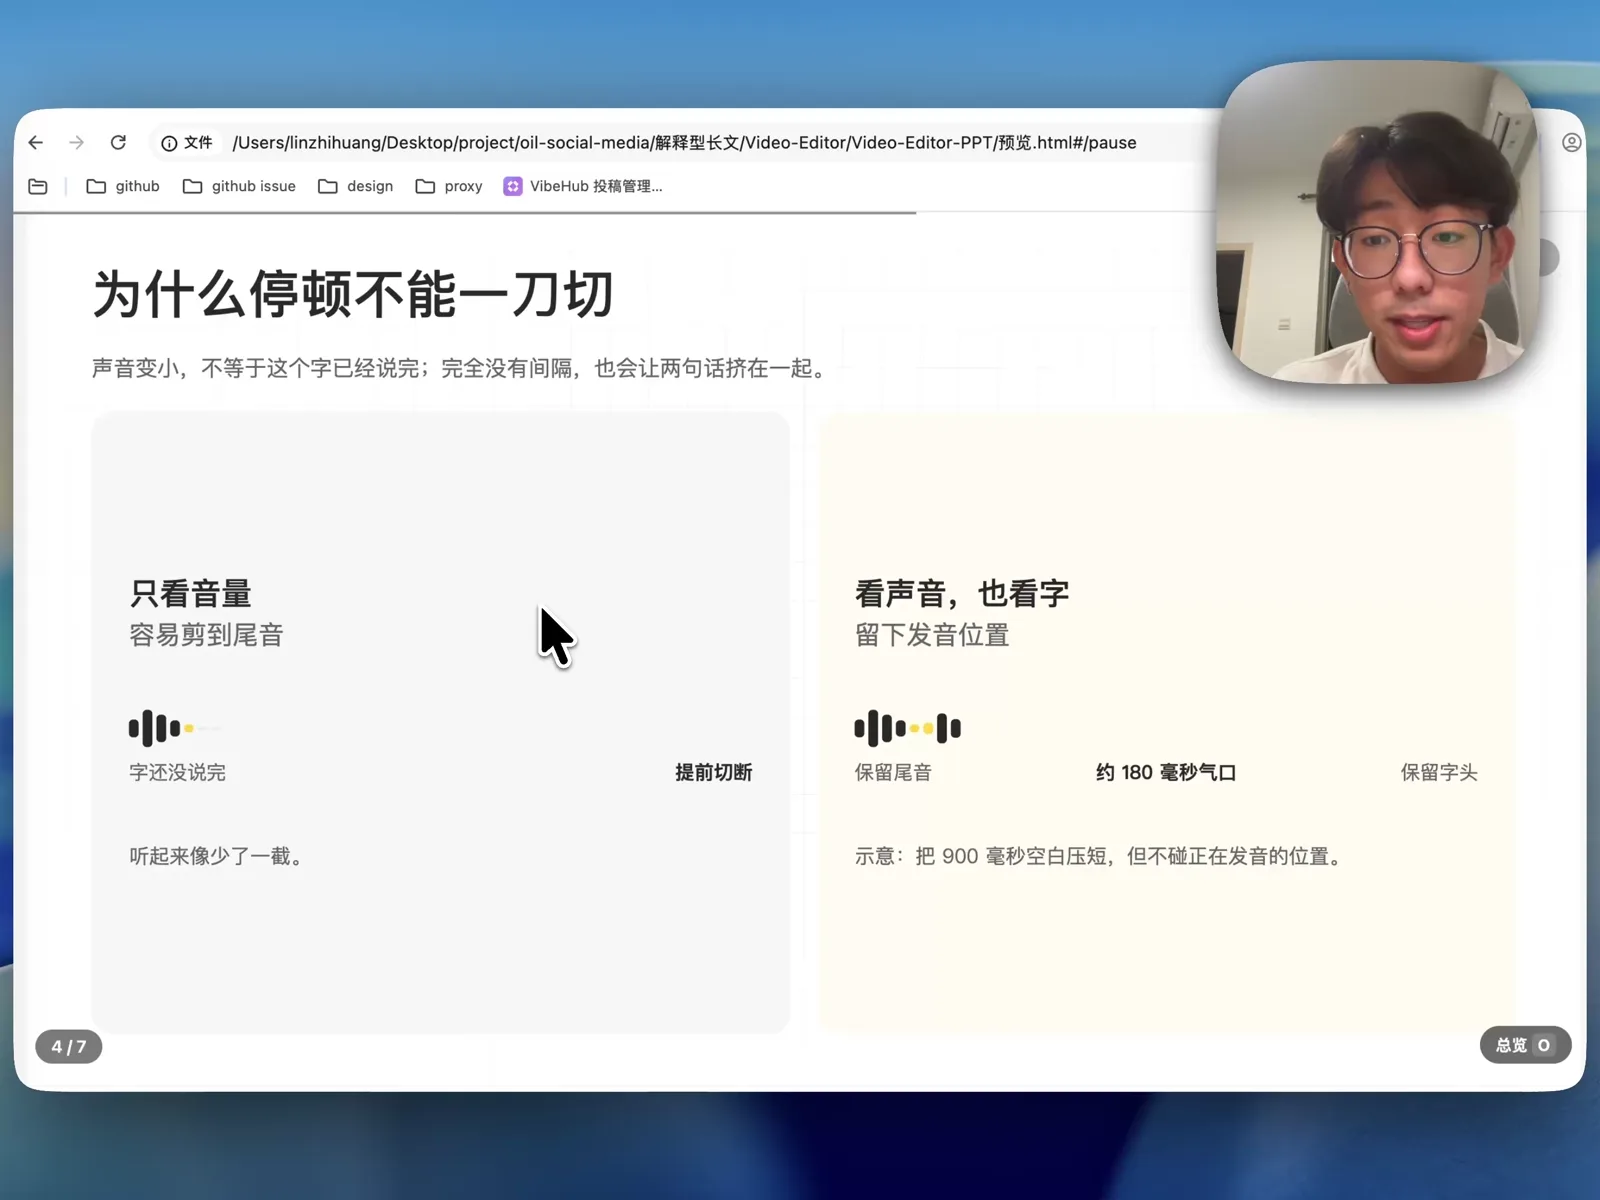
在切空白停顿的时候,如果单纯看音量分贝一刀切,很容易剪坏声音。因为人在把一个字说完的时候,尾音的波形是逐步递减的;如果音量一变小就立刻下刀,听起来就像字还没说完就被吞掉了一截。反过来,如果把两句话之间的空白切得一干二净,前后两句话完全挤在一起,听感也会非常局促。
所以在处理停顿时,video-editor 会把音频波形数值与字幕的字级边界结合起来判断:当检测到字幕尾部波形递减时,完整保留尾音和下一个字的字头,并在两段话之间留出约 180 毫秒的气口(例如把原本 900 毫秒的空白压短,但不触碰正在发音的位置),让剪完的口播听起来依然自然连贯。
到了 Agent 做语义判断的环节,整个过程完全不需要对视频做耗时的画面抽帧,大模型只需要读取前面程序整理好的纯文本结构化材料。
输入给 Agent 的材料包含四部分:转录文字、每个字对应的字级时间、两句话之间空了多久的停顿标记,以及 Skill 里写好的判断规则(核心原则是「宁可漏删,也不要误删完整的有效解释」)。
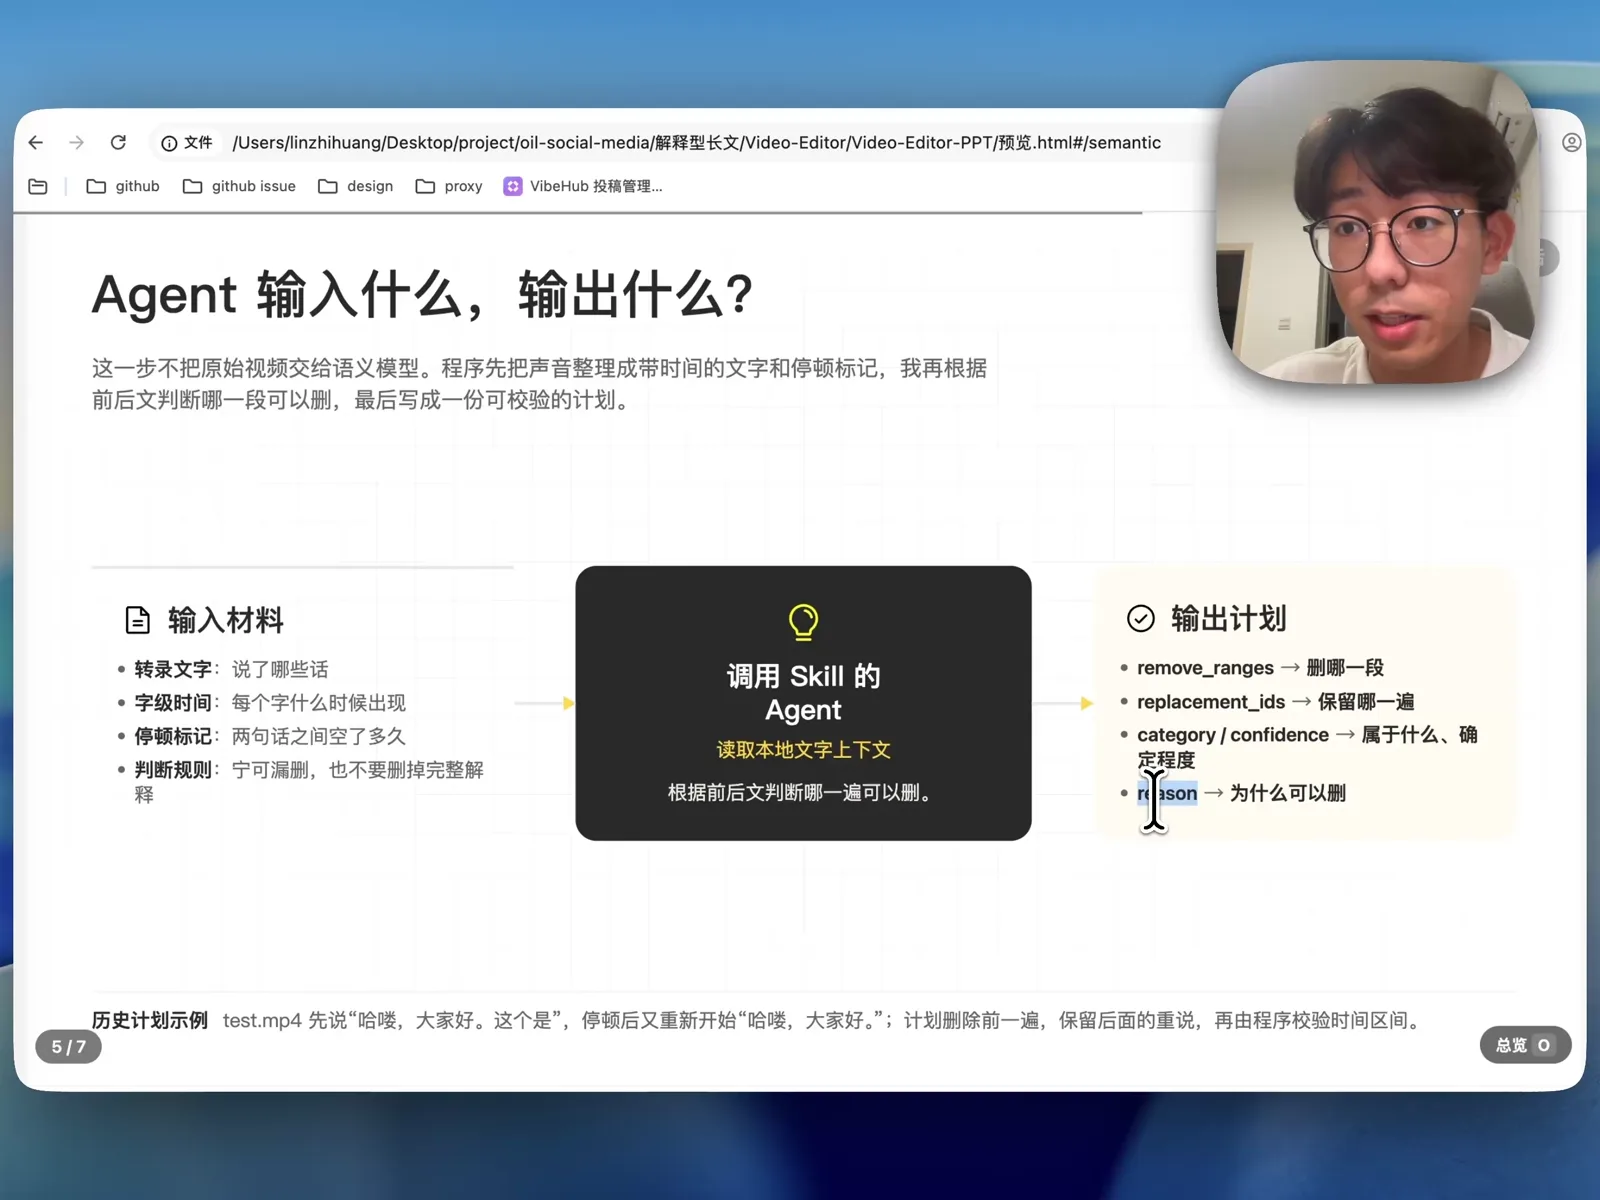
基于这些材料,Agent 会输出一份结构化的 JSON 剪辑计划,明确标出:
remove_ranges:具体要删掉哪一段时间区间;replacement_ids:重说时保留哪一遍;category与confidence:属于哪类问题以及判断的确定程度(只有高置信度的片段才会真正执行剪切);reason:为什么要删掉这一段。
我特意要求 Agent 在输出剪辑计划时必须写明删除原因(reason),是为了让这个 Skill 更容易持续迭代。如果剪完某期视频后,我发现某个地方剪得不理想,不需要去盲猜模型当时怎么想的,直接翻看计划文件里的删除理由,就能针对性地修改 Skill 里的判断规则。
适用场景与当前边界
虽然把口播粗剪的准确率提到了 90% 以上,但 AI 自动剪辑依然有明确的适用边界。
目前的 video-editor 最适合像我平时录制的这类以口播讲解为主的视频——实际上介绍这个 Skill 的这期视频本身,就是直接用它剪出来的。在这类视频里,叙事完全跟着人声走,没有声音的地方通常就是需要剪掉的停顿。
但如果你的视频画面节奏很复杂,比如中间有一大段没有人说话、专门用来展示产品动效或环境音效的空镜,直接套用这套以语音为主线的策略就会把有效画面当成空白切掉。遇到这类视频,还需要结合画面信息对规则做进一步扩展。如果你平时也有剪辑口播视频的需求,可以直接在开源仓库 oil-oil/video-editor 中获取并安装使用。