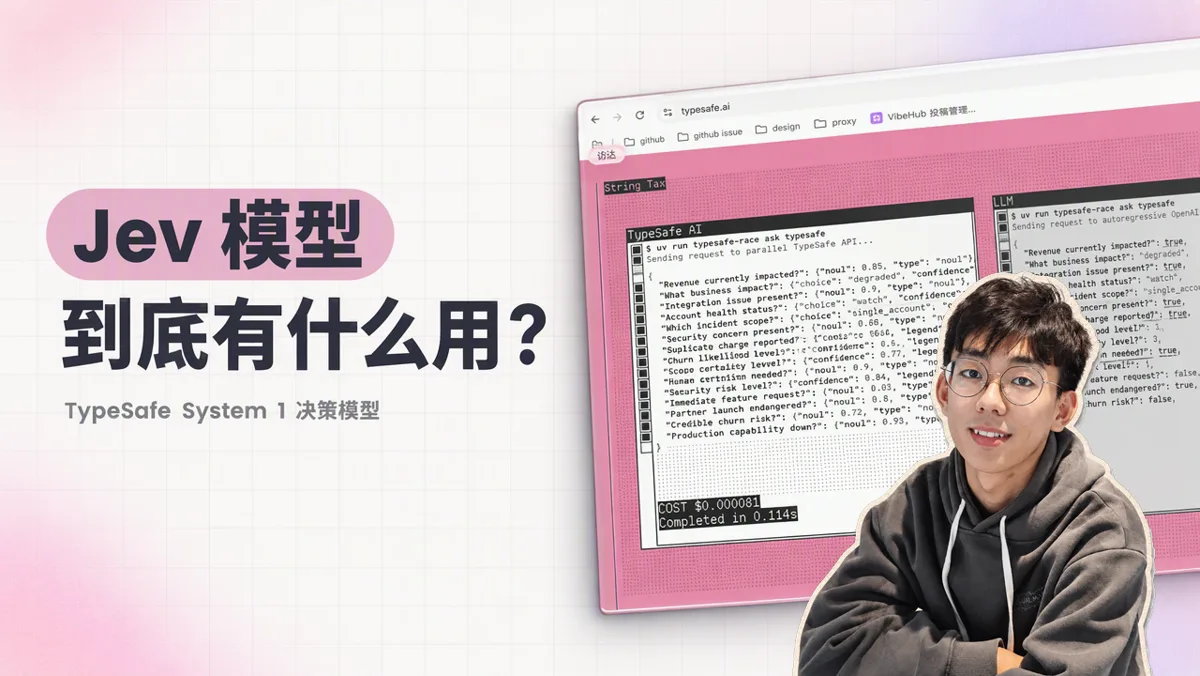
最近由前 OpenAI 研究员创立的 TypeSafe 团队推出了一款名叫 Jev 的新模型。我最初在内测阶段就去排了它的 Waitlist,这两天正式开放后第一时间拿到了调用权限。
Jev 之所以引起广泛讨论,是因为它的工作方式和我们平时用的大模型完全不同:它不能直接回答开放式问题,也不会写代码或生成长文解释。如果把传统的 ChatGPT 或 Claude 比作能写论述题的模型,那么 Jev 就是一个只能做「选择题」的模型。
既然放弃了自由生成文本的能力,它换来了什么?答案是快得惊人的响应速度和极低的调用成本。
在 TypeSafe 官网的基准展示中,Jev 的处理速度达到了 Claude Sonnet 5 的 193.6 倍。传统大语言模型在返回结果时,必须一个 Token 接一个 Token 地往外流式输出;而当你把一大批需要判断的问题同时塞给 Jev 时,它几乎在一瞬间就能把所有结构化决策结果一次性返回。
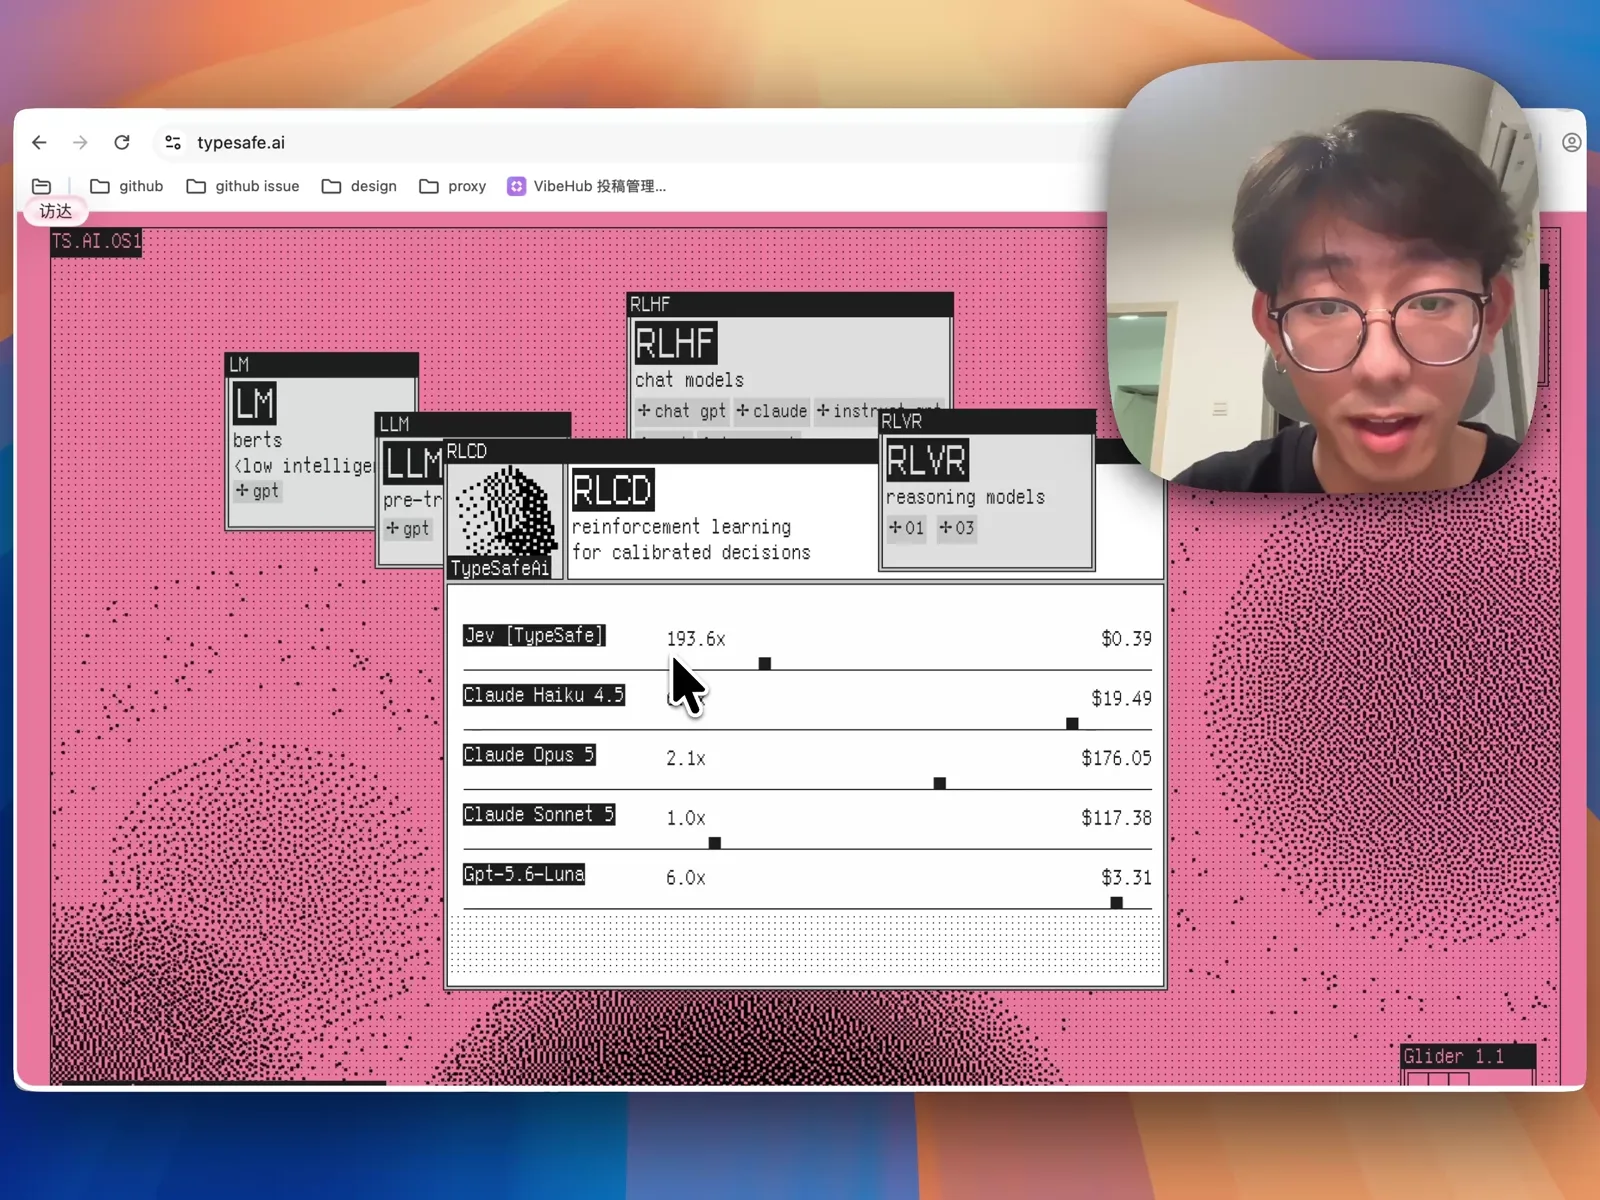
在计费方式上,Jev 只对输入 Token 收费,输出 Token 完全免费。它的输入价格是 10 亿(1 Billion)Token 42 美元,折合每百万输入 Token 只要 0.042 美元。
System One 定位与三种固定输出结构
在 TypeSafe 的官方文档里,他们把需要深度推理、拆解规划任务的常规大模型称为「System Two」模型,而把 Jev 这类专门帮软件快速做出结构化判断的模型称为「System One」模型。
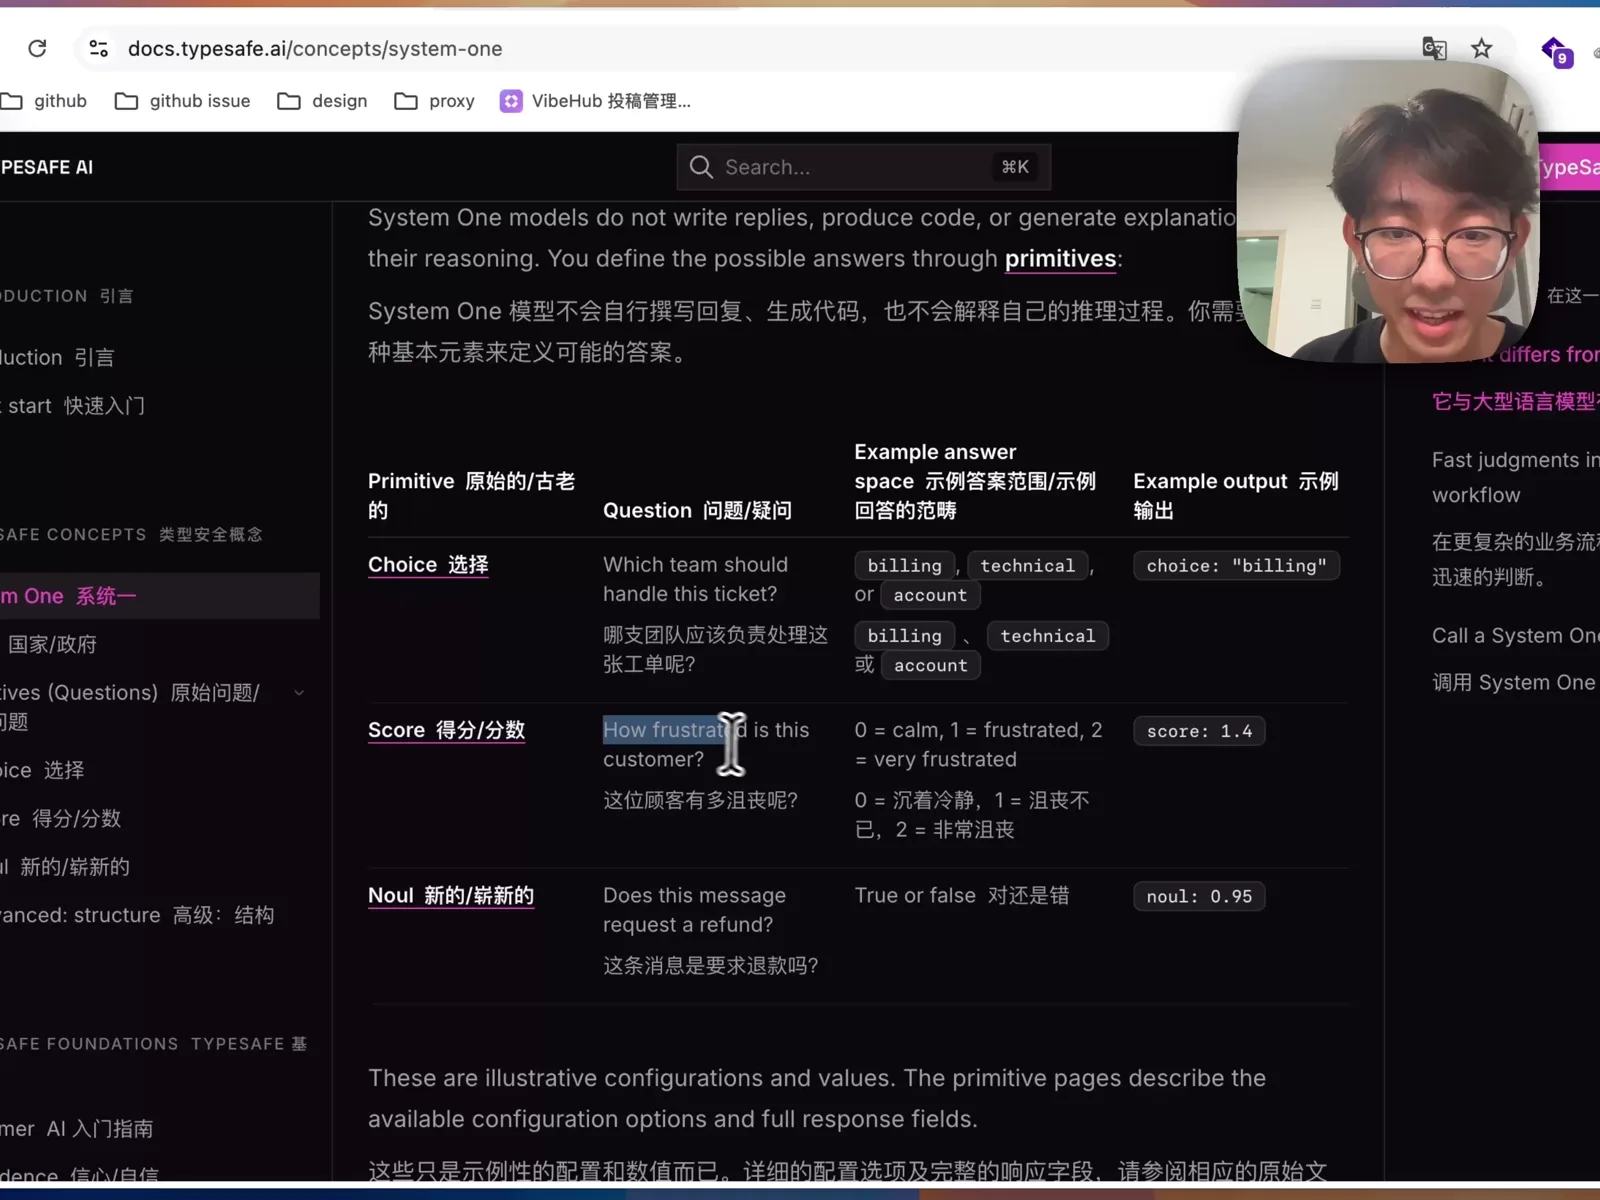
因此,Jev 并不是用来替代主模型的,它没法独立完成复杂的开发任务,而是作为一个高速决策组件,嵌入在现有的软件或大模型工作流里配合使用。它的输出格式被严格固定在三种基础原语(Primitives)中:
- Choice(多选一):给模型提供一组明确定义的候选项(例如 10 个分类标签或工单处理部门)和判断标准,它直接返回最匹配的一项(如
choice: "billing")。 - Score(量表打分):比如判断「这位顾客在对话中有多沮丧」,提前给定
0 = 平静,1 = 沮丧,2 = 非常沮丧的评分表,模型会根据上下文输出一个具体的连续分值(如score: 1.4)。 - Noul(真假概率判断):对某个陈述做出是非判断,并直接给出置信概率(如
noul: 0.95代表有 95% 的把握为真)。
它的接入方式也很贴合现在的 Agent 工作流。在控制台拿到 API Key 后,页面上直接提供了一段 Agent Prompt。把这段提示词复制给本地的编程 Agent 执行,环境里就会配置好对应的 /typesafe Skill,Agent 读完内置的官方文档后,直接贴入 API Key 就能开始写调用代码。
我用 Jev 做的实时跟读与纠偏提词器
围绕「超高速、低成本做选择题」这个特性,社区里很快冒出了一批很巧妙的用法。
比如浏览器自动化项目 browser-use 推出了 jev-ultrafast:以前让 Agent 在网页上点击按钮,需要等主力大模型慢慢分析页面元素;现在把页面上的一大批候选元素直接丢给 Jev,让它从列表里瞬间挑出目标元素,大幅缩短了浏览器操作的回合耗时。另一个例子是上下文压缩:传统的 /compact 是把全量历史对话丢给大模型总结重写,等待时间很长;而利用 Jev,可以把历史消息分批丢过去,让它对每一条消息做「保留」或「剔除」的二选一判断,把没用的过程废话快速筛掉,只留下关键上下文。
我自己也基于 Jev 写了一个日常录视频能用上的小工具:一个支持跳读和实时纠偏的智能提词器。
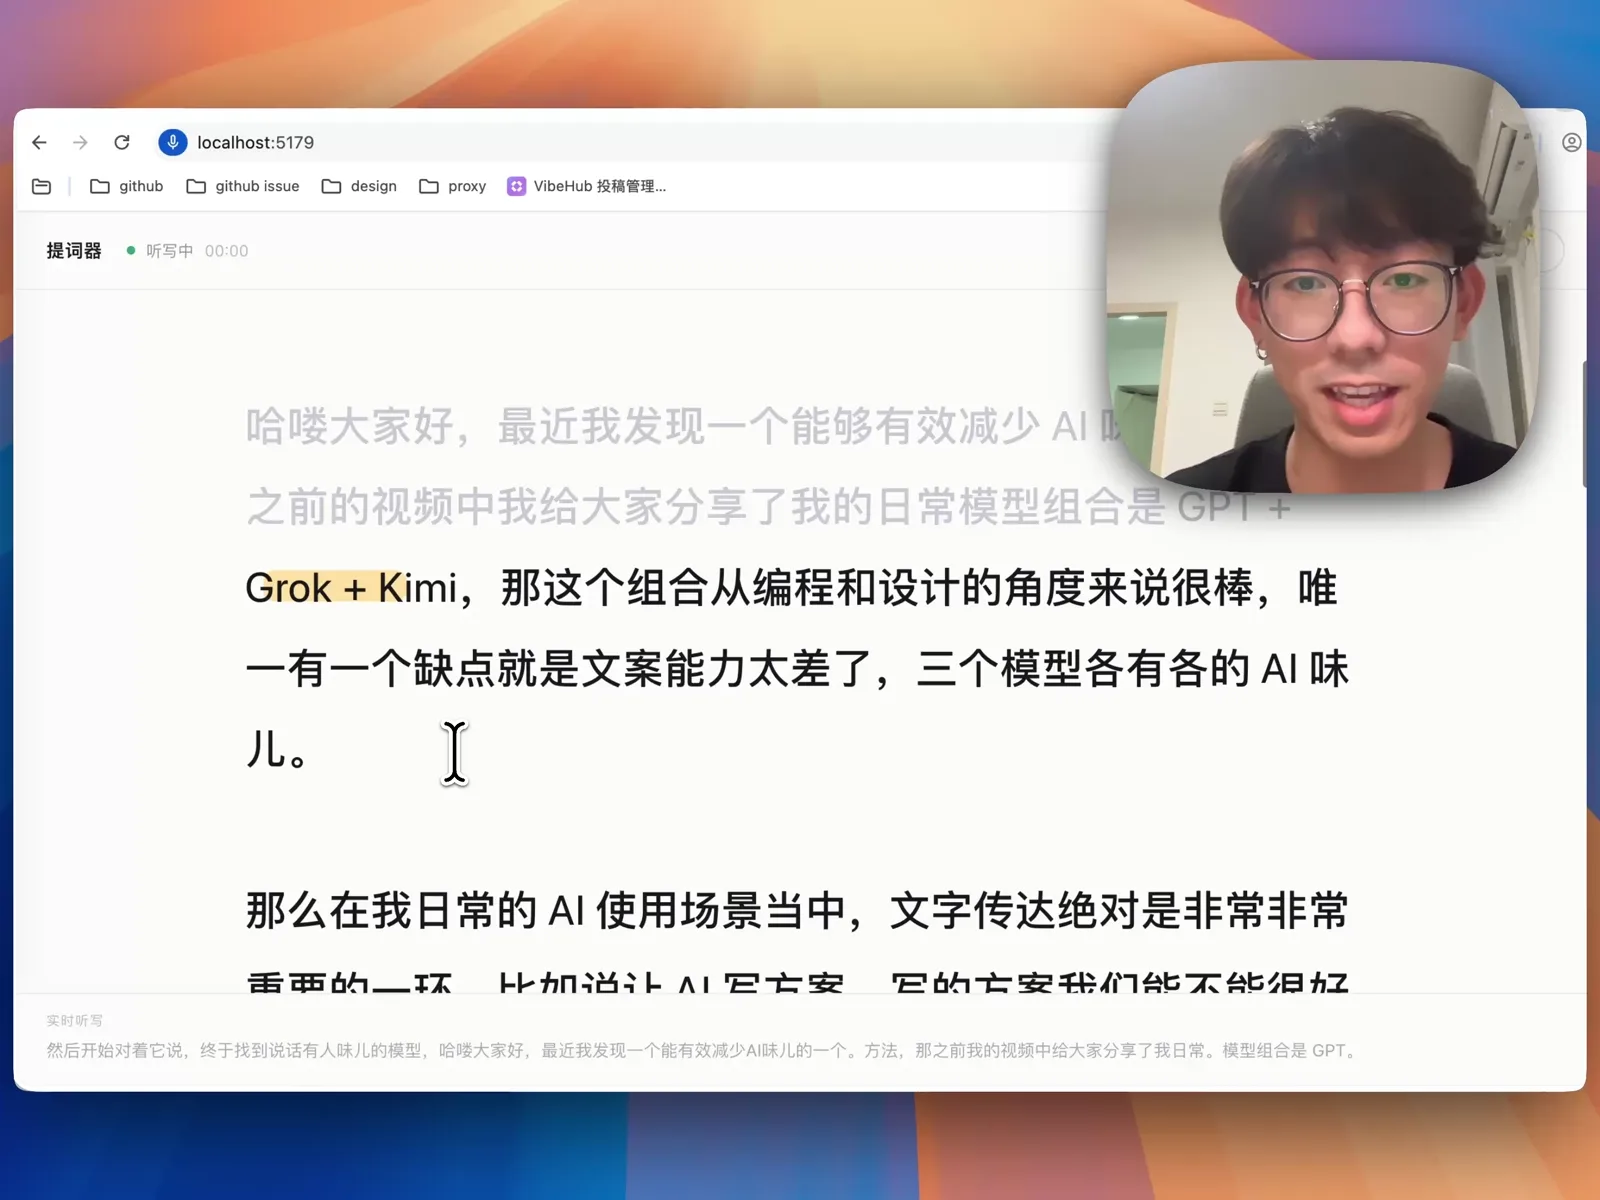
平时用传统提词器录口播,要么得严格顺着字句逐字念,要么得设一个固定的滚动速度,人必须迁就机器。接入 Jev 之后,我把实时语音转文字(ASR)模型和 Jev 串联了起来:
当我载入一篇长文稿开始录制时,提词器会实时听写我说出的话,并由 Jev 动态比对当前语音和整篇文稿,在「正常跟读」「脱稿纠偏」「跨段跳转」等几个预设状态之间做实时判断。
实测录制时,哪怕我念完第一段后直接跳到文章下半部分的某句话继续念,提词器也能瞬间定位并跳转到对应段落接着往后走;如果我中途说错了词,或者临时脱稿多聊了几句,Jev 判断当前语音偏离了原文,提词器就会自动停在原处等待,直到我重新说回文稿里的句子,它再无缝接上进度。因为整篇稿件加上实时语音转写的文本量很大,如果用普通大语言模型高频轮询判断,不仅 Token 消耗高,响应延迟也会明显慢半拍;而 Jev 的极低延迟刚好能撑起这种丝滑的实时跟读体验。
能力边界、端侧开源模型 Laya 与 Agent 路由设想
在实际使用 Jev 这类 System One 模型时,有两个边界需要先想清楚。
第一,做选择快,不代表选得一定对。Jev 本质上是一个参数量较小的轻量模型,擅长的是语义匹配、状态分类和直观判断。如果你拿一道需要多步推演的复杂数学题,附上 A、B、C、D 四个选项让它选,它并没有足够的推理深度去算出正确答案。
第二,当模型推理快到毫秒级时,网络延迟反而成了最大瓶颈。Jev 是 TypeSafe 提供的云端闭源服务,每次调用依然要走一遍网络请求。如果你的场景对实时性要求极高,云端往返的网络耗时可能比模型本身的计算耗时还要长。
针对这个问题,社区最近也推出了一个同样定位为 System One 的开源替代模型 Laya。它支持直接部署在本地端侧设备上,在本地完成毫秒级的结构化分类与路由决策,彻底省去了云端传输延时。
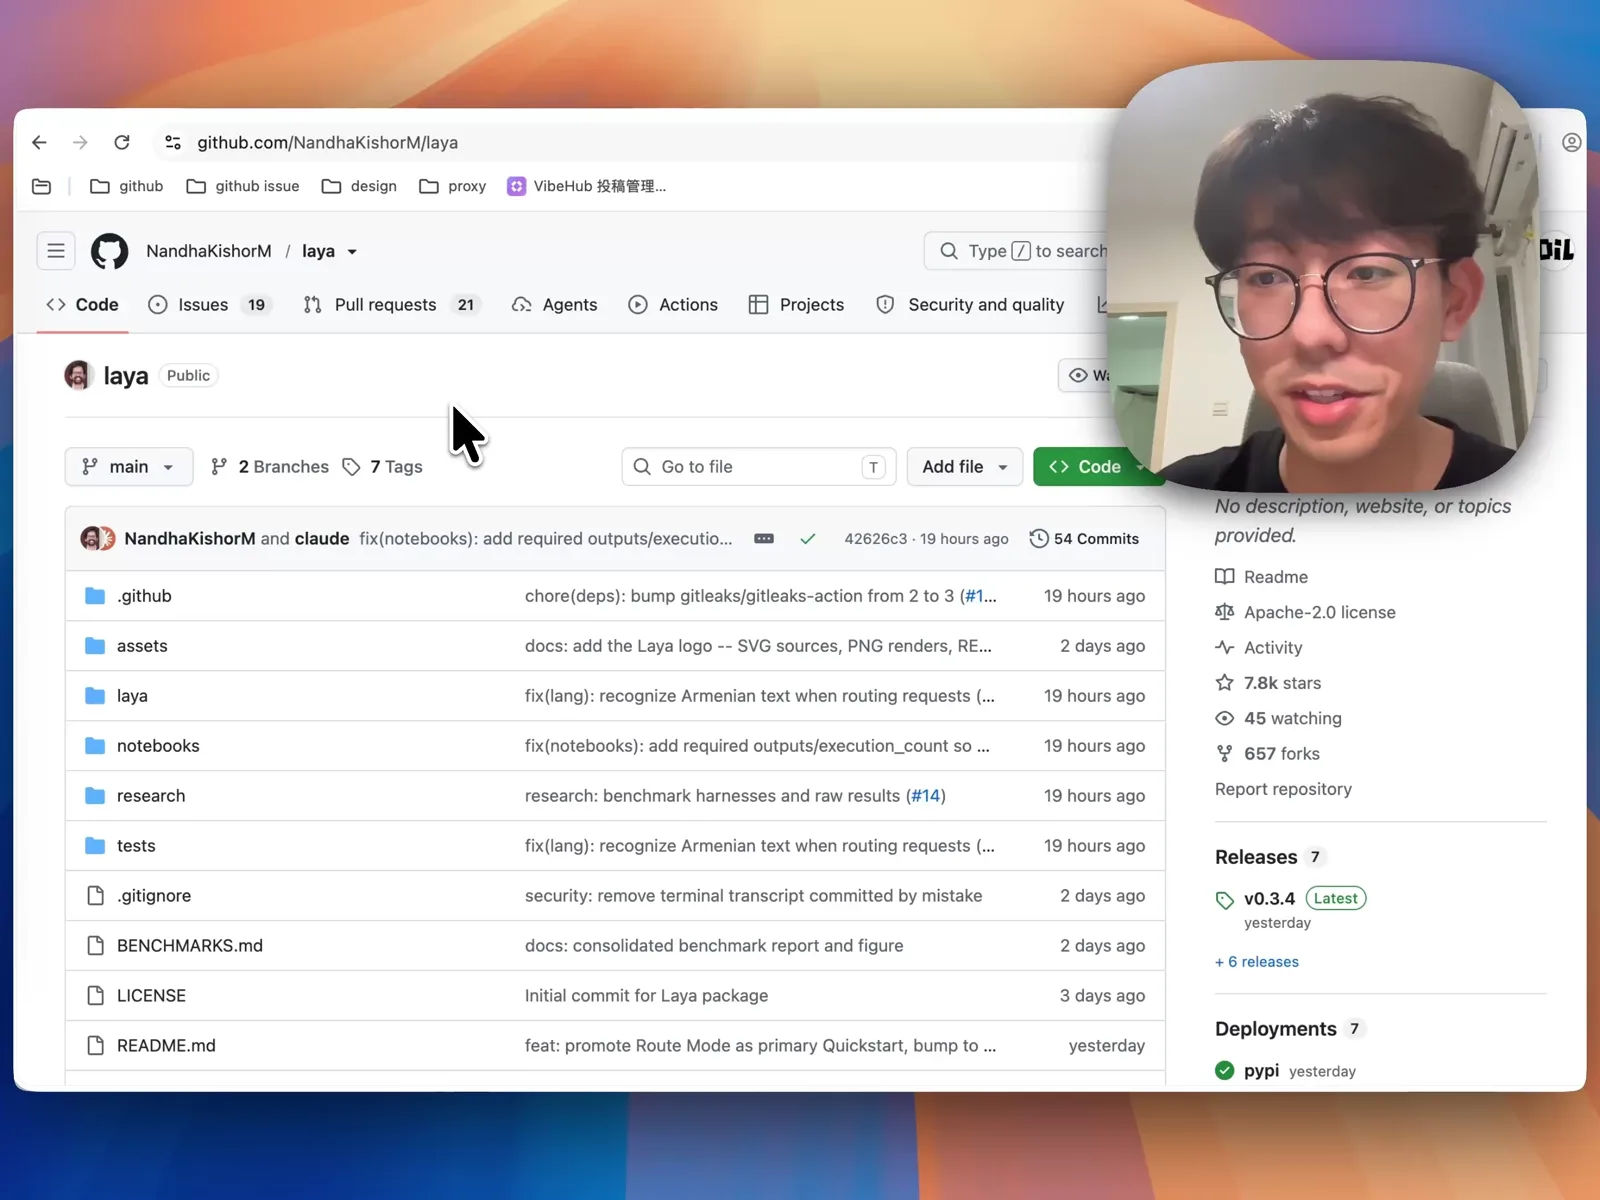
顺着这个思路往后看,我认为 Jev 或端侧的 Laya 非常适合放进 Agent Harness 底层,用来做 Skill 的渐进式加载与前置路由。
现在我们在本地给 Agent 装了几十个 Skill 之后,每次发消息时,往往需要靠主 Agent 的基座模型去阅读描述并判断该触发哪个 Skill。如果把这一步前置交给 System One 模型:用户发出指令后,先由 Jev 或本地的 Laya 在毫秒内从几十个候选 Skill 里选出匹配的项,再只把那个具体 Skill 的 SKILL.md 规范文档加载进主 Agent 的上下文中。这样既能省去主模型筛选工具的等待时间,又能避免大量无关的 Skill 描述占用主 Agent 的上下文窗口。