随着 GPT-6 系列三个模型上线,我把之前开源的 Codex 子 Agent 编排工具 codex-team-mode 更新到了最新版本。
在 Codex 里直接让主 Agent 派发子 Agent 时,如果你没有提前在本地配好子 Agent 的角色文件,系统默认会直接复用主 Agent 当前使用的模型。比如主窗口开着开销很高的 GPT-5.6 Sol 甚至高推理挡位,派出去查文件的子 Agent 也会跟着消耗高价模型额度,原本想靠拆分子任务省钱、省上下文的目标就落空了。
在 GPT-5.6 时期,我在 codex-team-mode 里预设了四类子 Agent 角色:探索者(GPT-5.6 Luna Medium)、简单实现者(GPT-5.6 Luna High)、复杂实现者(GPT-5.6 Terra High)和审查者(GPT-5.6 Sol High)。这次结合 GPT-6 三个模型的价格变化和实际表现,我对整套角色分工和工作流做了一次重构。
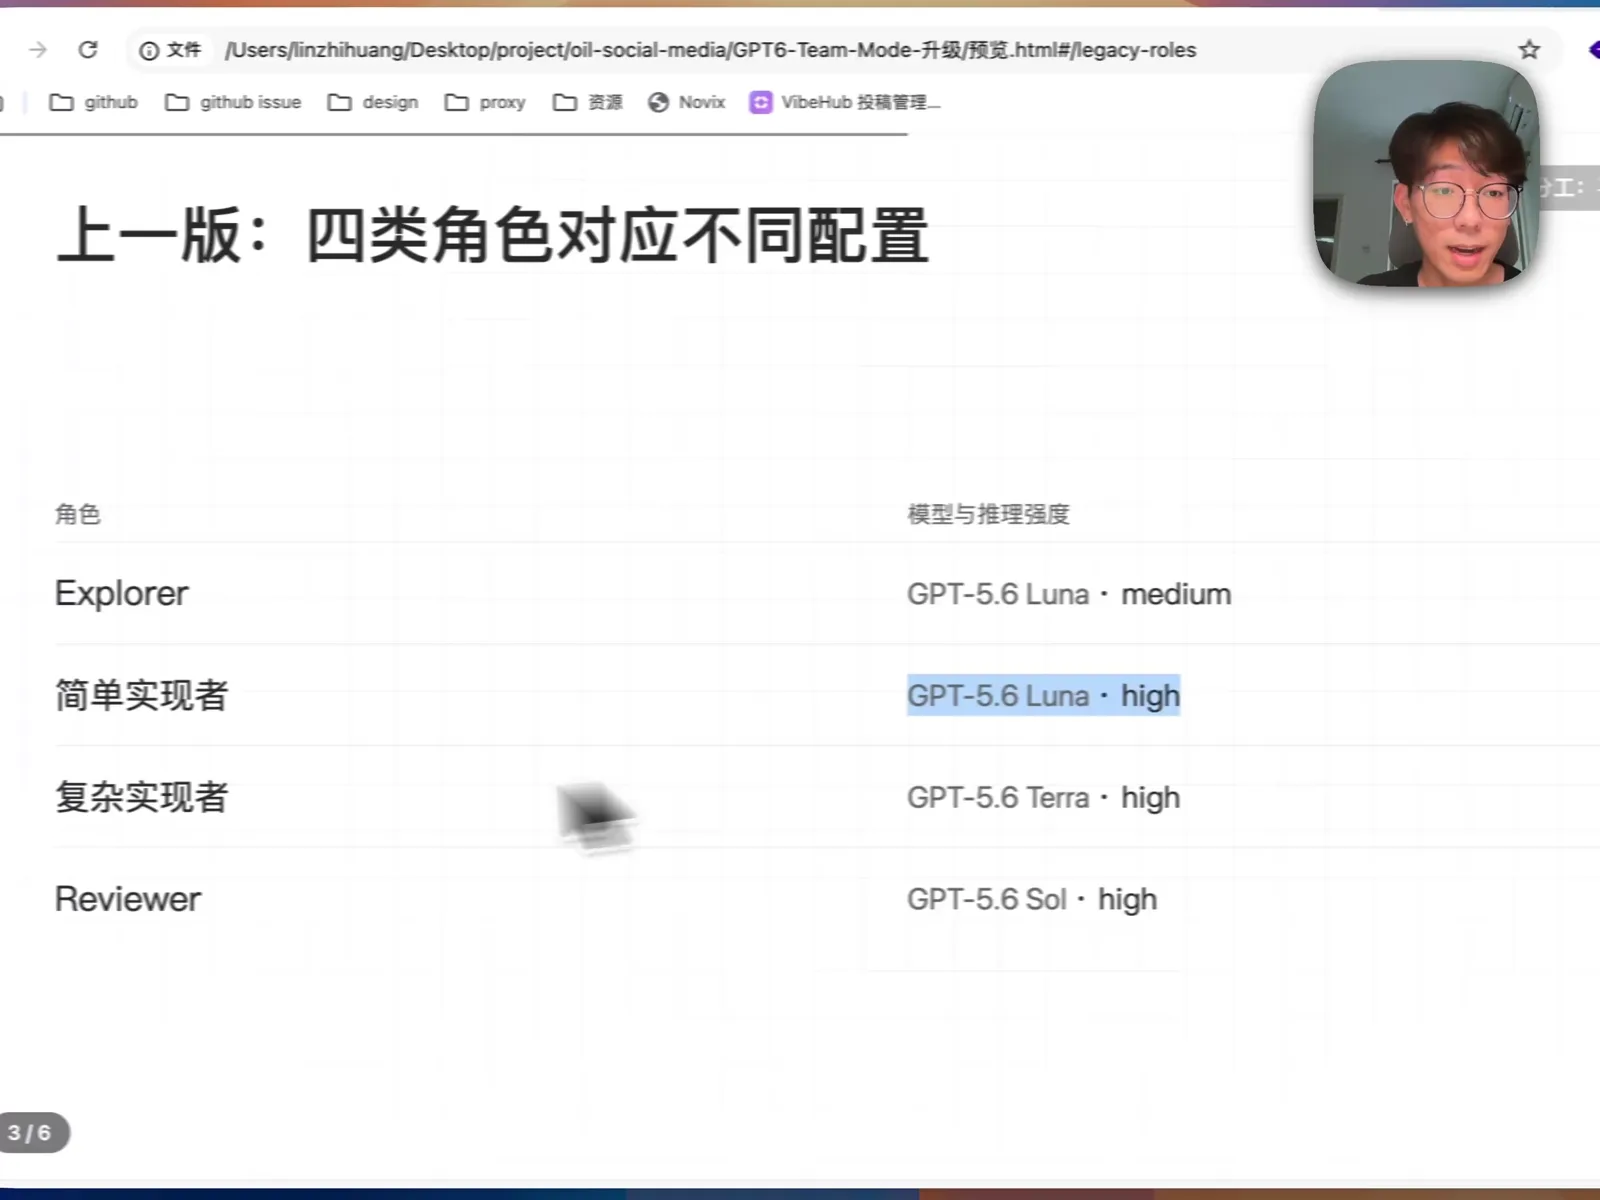
针对 GPT-6 调整的四类子 Agent 角色
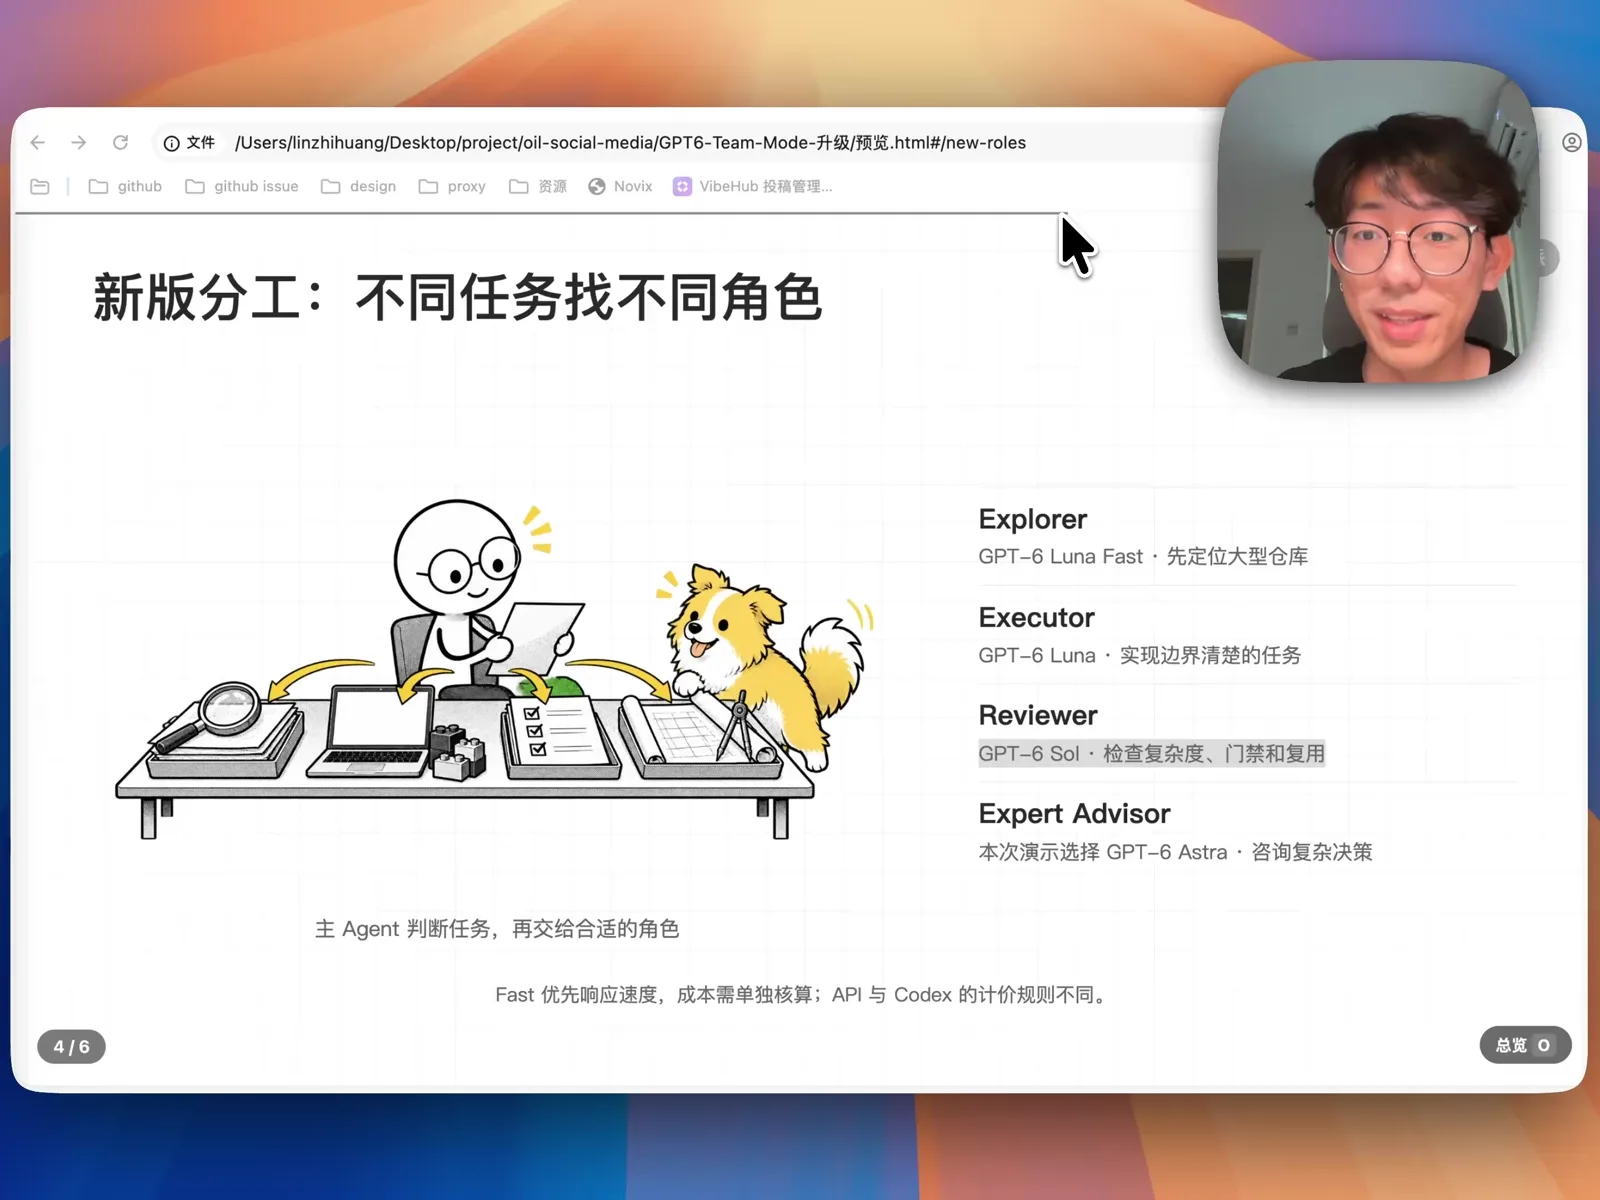
新版 codex-team-mode 依然保留四个子 Agent 角色,但底层的模型映射和职责边界做了重新划分:
- 探索者(Explorer):升级为
GPT-6 Luna,并默认开启Fast模式。GPT-6 Luna的价格比上一代GPT-5.6 Luna便宜了 60%,即使常驻开启Fast模式,额度消耗也几乎可以忽略不计,适合在大型仓库里快速定位目标文件和代码实现。 - 执行者(Executor):把原来的简单实现者和复杂实现者合并成了单一的执行者角色,统一使用
GPT-6 Luna(High推理强度),负责边界清晰的具体代码改动。 - 审查者(Reviewer):使用
GPT-6 Sol,专门负责在代码写完后做实现质量检查。 - 专家顾问(Expert Advisor):新增角色,使用最贵的
GPT-6 Astra,专门处理复杂架构设计和久攻不下的疑难问题。
这里有两个实际用下来总结的细节。
第一,为什么敢把日常执行交给 GPT-6 Luna?在单独作为主 Agent 使用时,GPT-6 Luna 的表现其实不如上一代 GPT-5.6 Luna 稳定,特别是当项目里已经有较多规范文档时,你不明确点出文件名,它经常想不起来去读对应的 Skill 或规则。但当它作为子 Agent 运行时,主 Agent(GPT-6 Sol)在派发任务前已经把要读哪几份规范、要改哪几个文件交代得清清楚楚,正好避开了它自主召回弱的短板,又能享受到极低的调用成本。
第二,为什么把 GPT-6 Astra 放进专家顾问子角色?GPT-6 Astra 价格昂贵,如果全程挂在主窗口写日常业务,额度很快就会见底。更划算的做法是用 GPT-6 Sol 作为日常主 Agent,当某个问题连续改了几轮还没修好,或者需要在写代码前先定一套复杂方案时,再由主 Agent 唤起 GPT-6 Astra 顾问来出主意。这种用法和 Claude 官方提供的 Advisor 接口思路一致——让中等开销的模型负责日常推进,遇到硬骨头再去请教高阶模型。
同时,这套审查者(Reviewer)提示词也针对 GPT 系列模型的常见毛病做了专门约束。GPT 写代码时很喜欢一层接一层地加防守逻辑和门禁检查,把简单逻辑越写越绕,或者放着现成的开源库不用自己造轮子。新版提示词重点要求审查者盯住过度复杂化、组件拆分不合理和重复造轮子的问题,并精简了内置的汇报模板——之前模板写得太细,GPT 就会为了填满表格去死抠边角料,改短之后不仅输出清爽,还能直接拿去审 PPT 或调研报告。
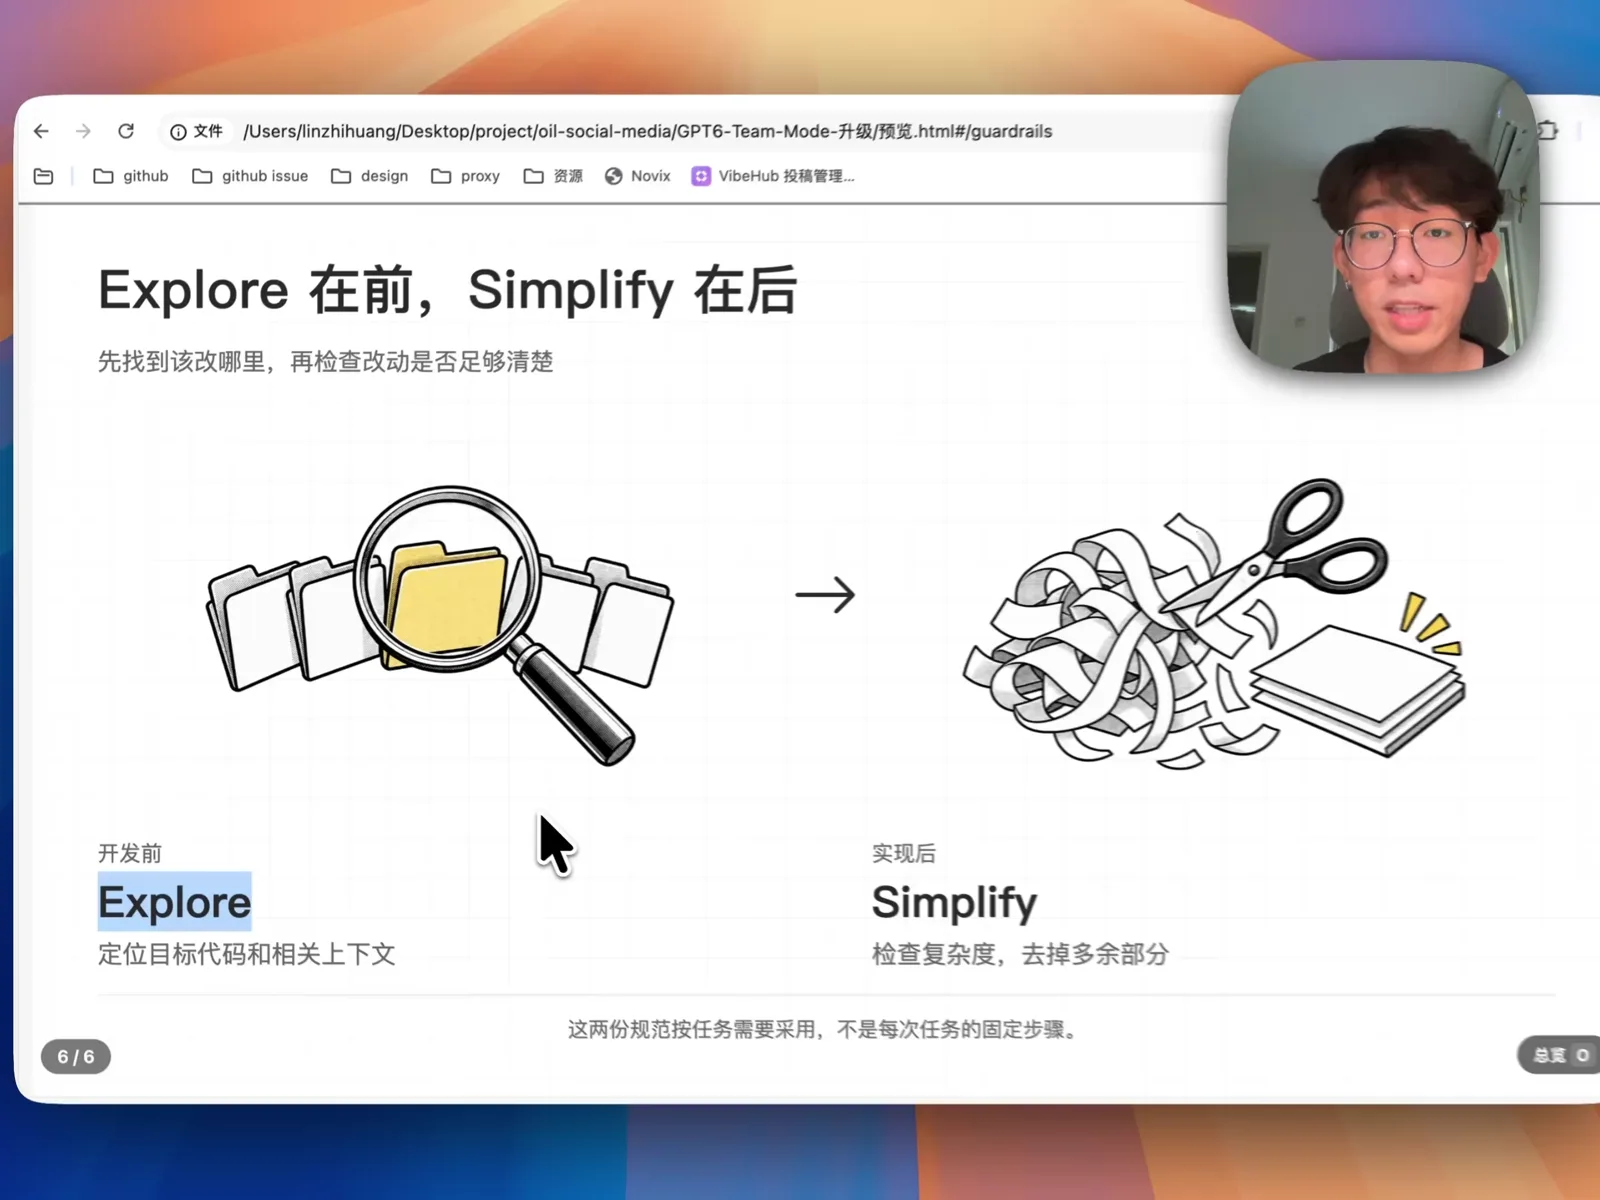
引入 Explore 与 Simplify 两套协作规范
除了调整角色模型,这次更新还参考 Claude 内置的工作流思路,在 Skill 里集成了 Explore 和 Simplify 两份协作规范文档。
- 开发前
Explore:遇到跨目录或多仓库的复杂任务时,主 Agent 先派探索者子 Agent 把相关代码路径摸清楚,只把关键文件位置和结构摘要带回主上下文,避免主窗口一上来就被十几份源码塞满。 - 完成后
Simplify:代码改完、准备提交之前,自动拉起审查子 Agent 检查一遍实现质量和代码复用情况,把多余的分支判断和冗余代码砍掉,确认干净后再交付。
开启这个 Skill 之后,并不是每发一句话都会机械地派一堆子 Agent 出去。遇到顺手就能改完的小需求,主 Agent 会直接自己动手;只有当任务涉及多模块排查或长链路改造时,才会按需调度子角色。
触发方式与 30 天模型额度消耗实测
在 Codex 里使用这套工作流有两种方式:如果某个复杂项目或包含多个子仓库的工作区本来就很适合拆分子任务,Agent 会自动进入小队模式;如果当前任务比较简单但你希望强制启用,可以直接在输入框里发送 /tmode 手动开启。触发成功后,回复开头会打印一行 👾 已开启小队模式,方便直观确认当前状态。
为了看清不同模型的真实开销,我还在仓库里内置了一个本地统计脚本 usage_by_model.py,可以直接扫描本机过去 30 天的 Codex 会话日志并汇总额度占比。
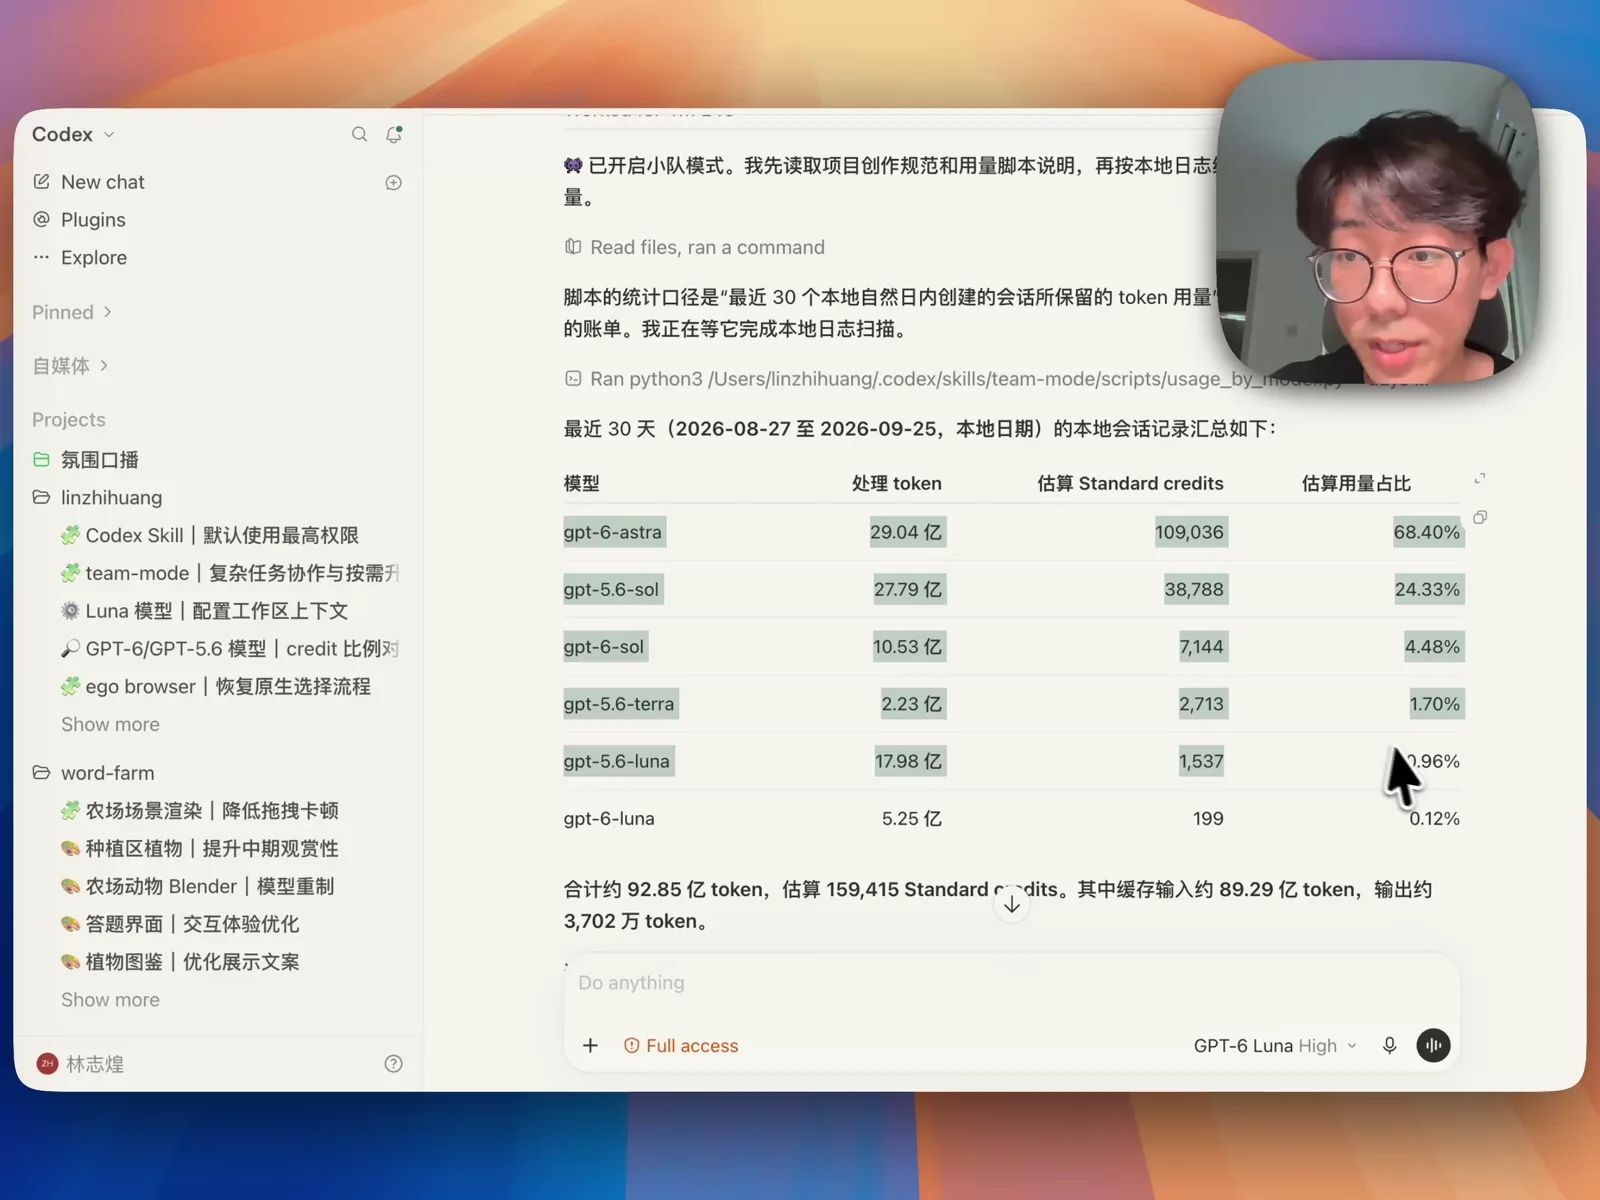
以我电脑上过去 30 天的真实记录为例,总共消耗了约 928.5 亿(92.85B)Token、折合 159,415 点标准额度:
gpt-6-astra消耗了 29.04B Token,却占掉了 68.40% 的总额度(109,036 点)。gpt-5.6-sol消耗了 27.79B Token,占 24.33% 的额度(38,788 点)。- 相比之下,
gpt-5.6-luna用了 17.98B Token,只占总开销的 0.96%;而升级后的gpt-6-luna用了 5.25B Token,只占总开销的 0.12%。
从这组数据能直观看到,把文件检索和常规代码改动分流给 Luna 级别的子 Agent,几乎不怎么花钱,却能替主窗口省下大量高价模型的上下文开销。
顺带升级:用 GPT-6 Luna 自动整理会话标题
除了小队模式,我还把另一个配套小工具 oil-codex-title 默认调用的模型也升级到了 GPT-6 Luna(开启 Fast 模式)。
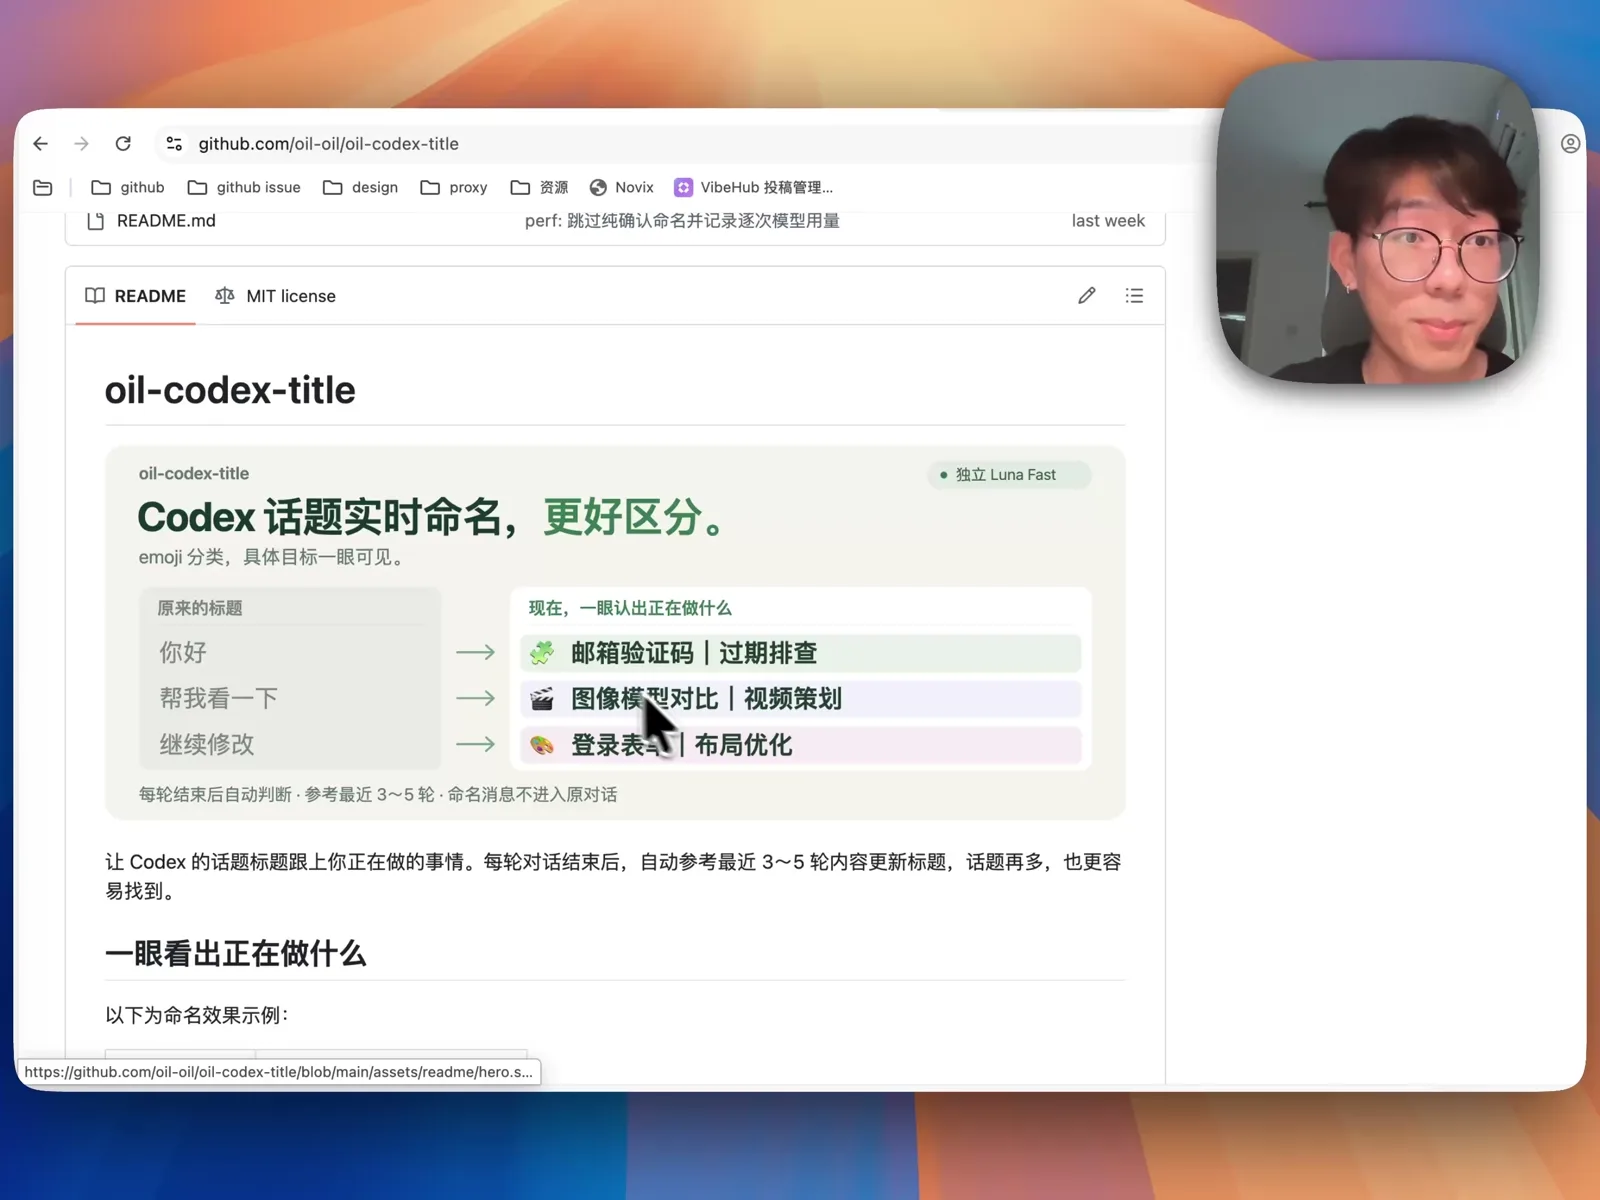
平时在 Codex 里同时开十几个线程干活,侧边栏的默认会话名经常都是零散的第一句提问,回头找起来非常费劲。装上 oil-codex-title 后,它会在后台自动读取你和 Codex 的第一轮对话,提炼出清晰的主题并加上对应的分类图标(比如 🛠️ 首页 Skill 卡片|添加 SkillPay 徽章、🎨 落地页|三种风格设计),让你在侧边栏一眼就能找到对应的工作线程,而每次命名的模型开销几乎为零。