OpenAI 最新发布了 GPT-6 Sol 与 GPT-6 Luna 两款模型。在此之前,我已经重度使用过一段时间的顶配模型 GPT-6 Astra。如果不考虑复杂的计算机桌面自动化与 3D 建模场景,GPT-6 Astra 在日常编码体感上相比上一代 GPT-5.6 Sol 提升不算特别悬殊;反倒是这次 GPT-6 Sol 和 GPT-6 Luna 的定价调整,直接改变了我在 Codex 里的主力模型分配策略。
1 : 20 : 100 的额度跨度:比上一代再砍一半
翻看 OpenAI Codex 当前的 Standard credit 费率表,按「输入 / 缓存输入 / 输出」每百万 Token 计算,两代模型的费率变化非常明显:
GPT-6 Luna相比GPT-5.6 Luna:费率从5 / 0.5 / 30降至2.5 / 0.25 / 12.5,输入与缓存输入直接便宜了 50%,输出便宜了约 58%。GPT-6 Sol相比GPT-5.6 Sol:费率从100 / 10 / 500降至50 / 5 / 250,整体价格砍半。- GPT-6 三档模型内部比例:
GPT-6 Luna(2.5 / 0.25 / 12.5)、GPT-6 Sol(50 / 5 / 250)与GPT-6 Astra(250 / 25 / 1,250)的额度消耗比例拉大到了1 : 20 : 100。
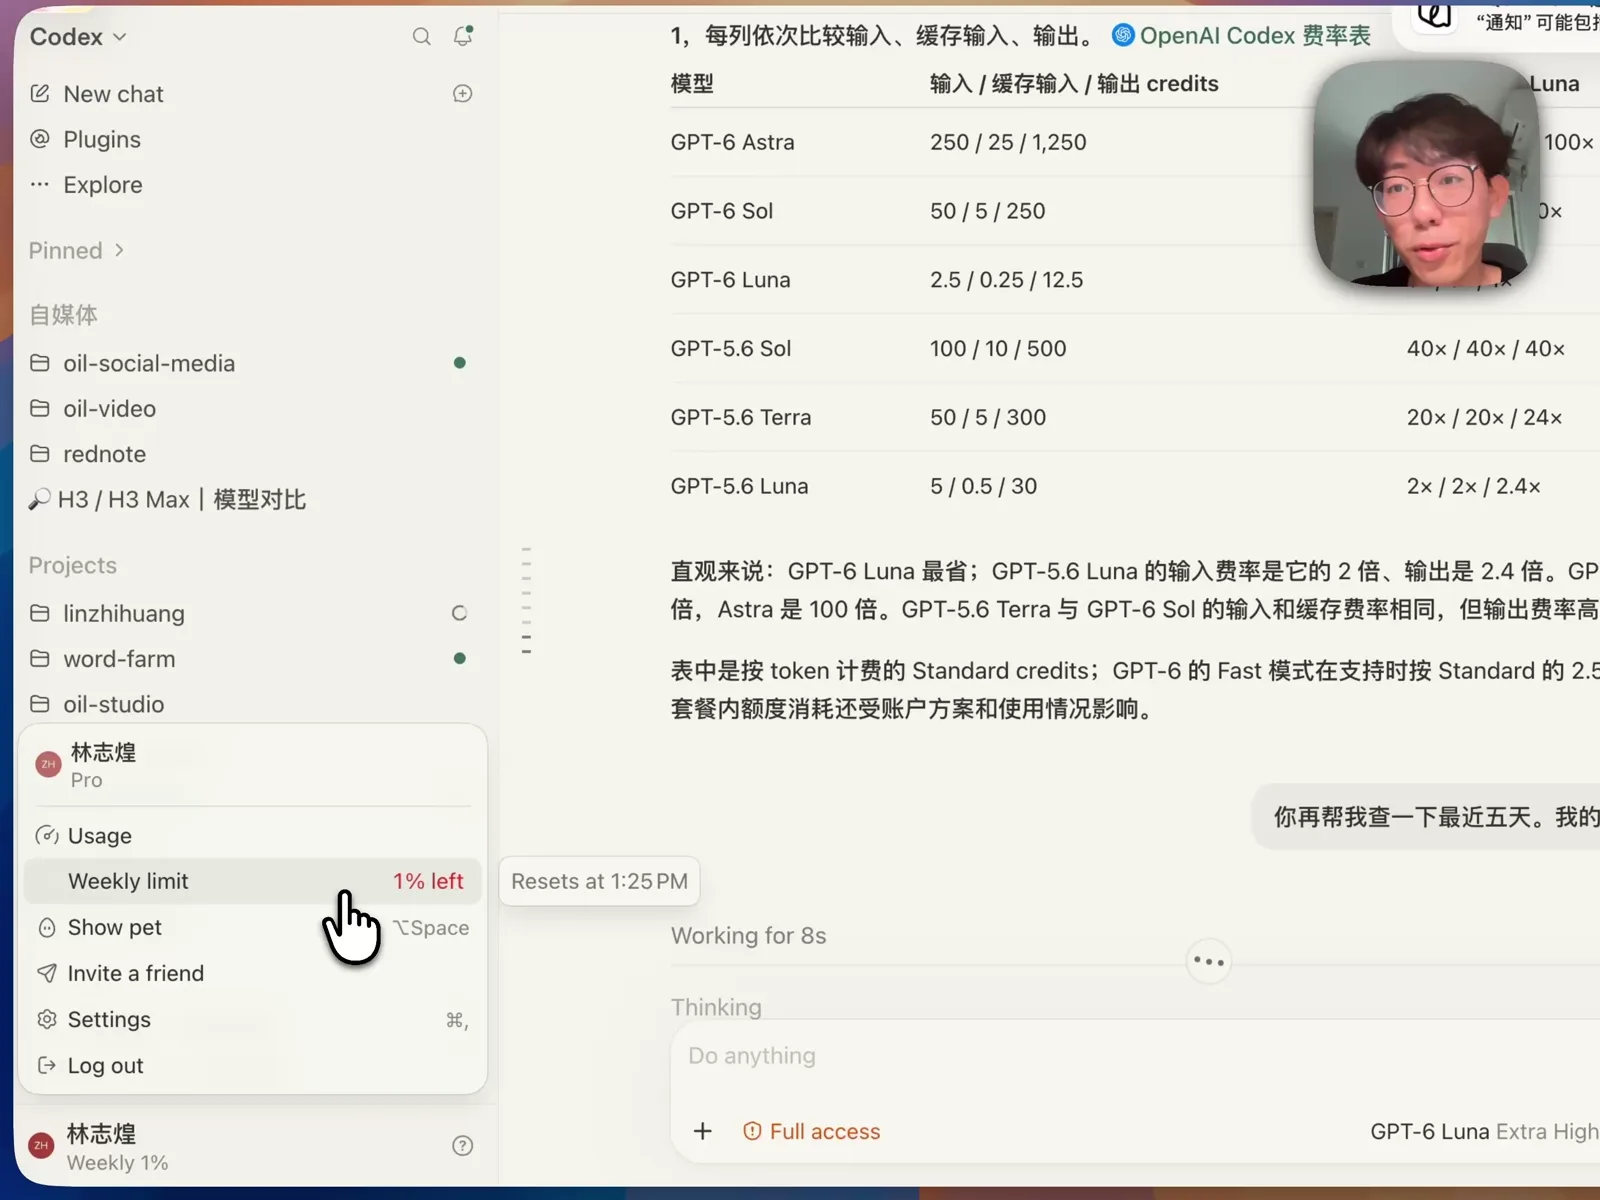
1 : 20 : 100 意味着什么?如果同样一笔订阅额度只够你高强度调用 GPT-6 Astra 1 天,换成 GPT-6 Luna 则可以同等强度连续使用 100 天。
额度仅剩 4% 时的被动切换:5.27 亿 Token 只扣 3% 额度
我之所以对这次降价体会极深,是因为前几天高强度使用 GPT-6 Astra 时遇到了严重的额度危机。即使连续用了两三张额度重置卡,依然不够烧;到三四天前,我账户左下角的周额度(Weekly limit)就只剩下最后 4%。
为了不中断手头的工作,我把 Codex 里的所有日常任务全部切到了 GPT-5.6 Luna,并在 GPT-6 Luna 发布当天第一时间切换过去。我原本做好了「为省 Token 牺牲一部分产出质量」的心理准备,顺便想摸清 Luna 档位模型的真实能力边界。
结果连续高强度用了四五天后,我让 Codex 统计了一下本地会话日志的真实开销:
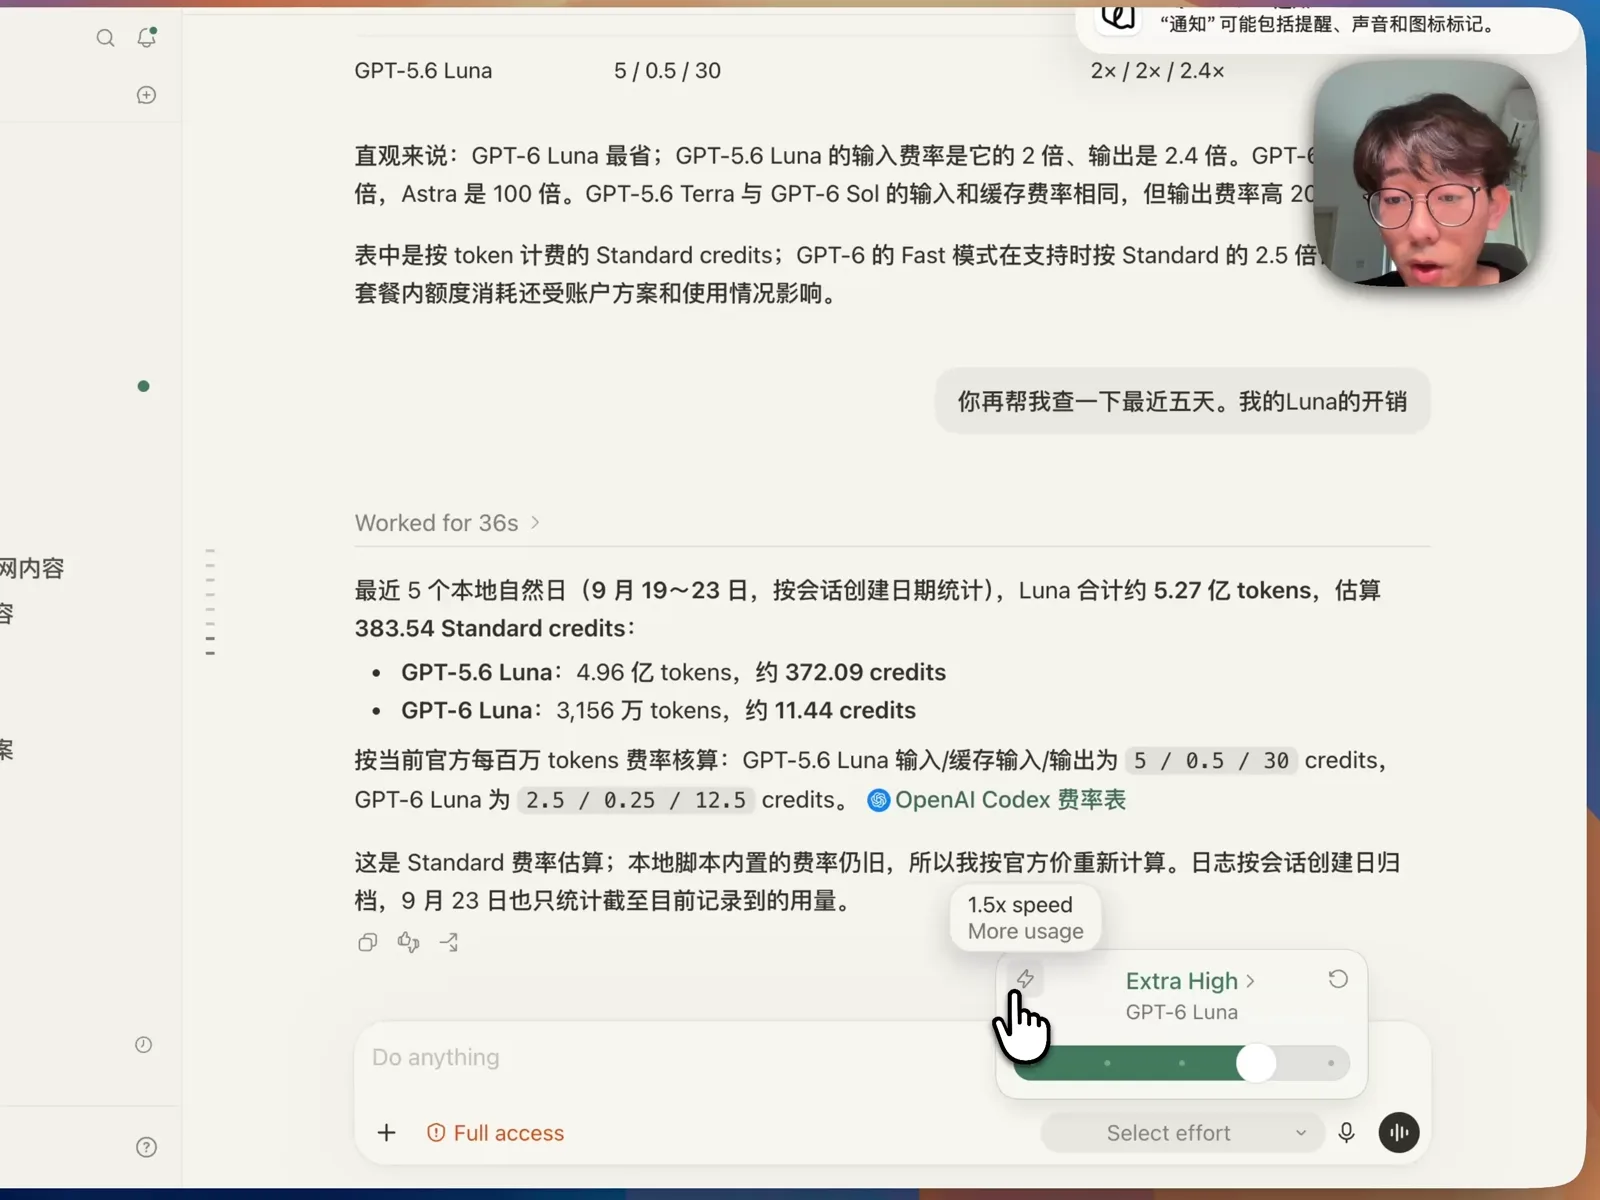
在 9 月 19 日至 23 日这 5 个本地自然日里,GPT-5.6 Luna(4.96 亿 Token)加上新切过来的 GPT-6 Luna(3,156 万 Token)合计消耗了约 5.27 亿 Token,折算下来仅约 383.54 Standard credits。对应到账户面板上,这三四天高强度干活只扣掉了 3% 的周额度(从 4% 降到 1%)。
真实干活表现:能顶替 95% 的 Sol 日常工作,仅长上下文模糊召回略弱
更让我意外的是实际产出质量。在这四天里,我平时用 GPT-5.6 Sol 处理的几乎所有日常工作,全都交给了 Luna 完成:
- 内容生产流水线:制作 HTML 演示文稿(PPT)、口播视频粗剪、烧录字幕、生成多尺寸封面以及多平台自动化发布。
- 工程开发与复杂 Skill 维护:迭代维护本地复杂的 Agent Skill、开发常规的前后端项目。
- 浏览器自动化与技术调研:不仅能流畅驱动浏览器自动化脚本,甚至直接调用 Computer Use 执行桌面级自动化操作也很顺手。比如前两天做
Jev模型与TypeSafe渐进式加载方案调研时,从拉取文档、编写本地测试脚本到输出评估结论,全程都由 Luna 独立跑通。
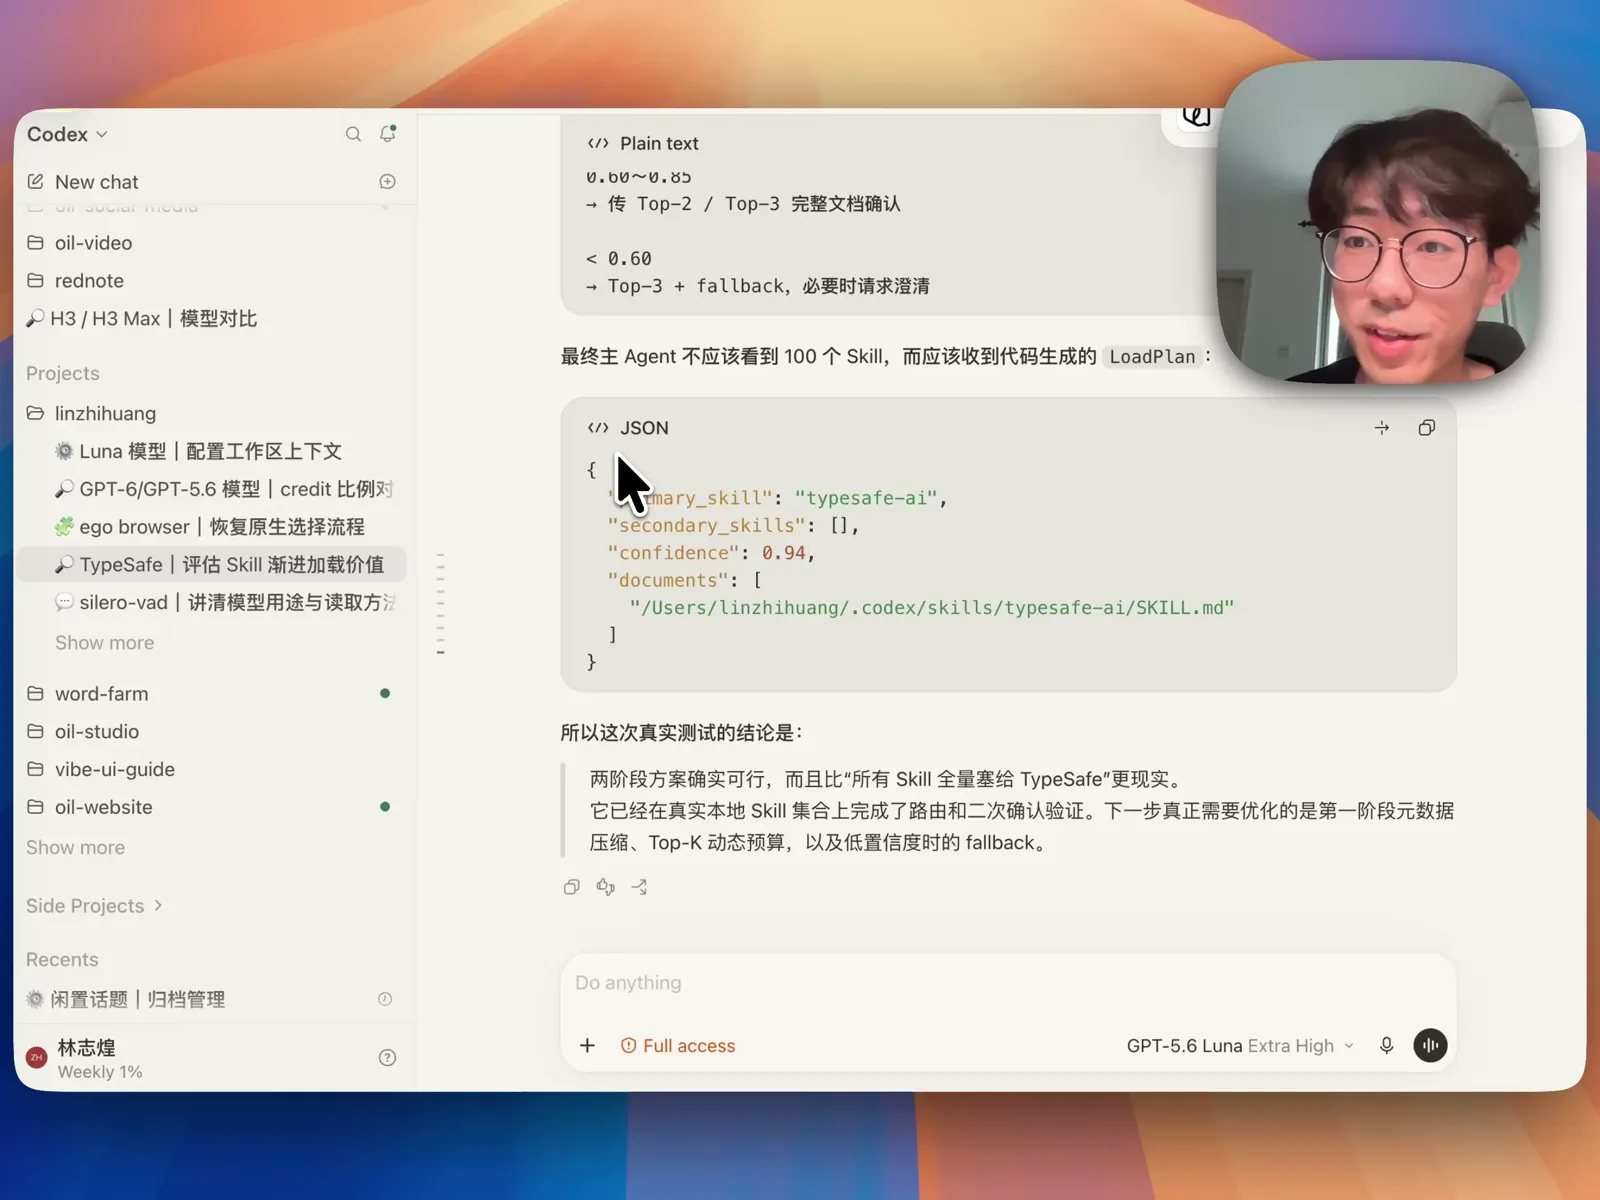
在绝大部分任务里,我几乎感知不到当前干活的是一个轻量化档位的模型。唯一能让我明显察觉「它是 Luna 而不是 Sol 或 Astra」的场景,出现在超长上下文叠加含糊指令的时候:
当单次会话已经累积了很长的历史上下文,而我又只随手敲了一句简短含糊的指令(例如没点明具体工具名,只说「帮我做一下封面」),GPT-5.6 Sol 或 GPT-6 Astra 依然能精准从上下文中召回并触发对应的封面 Skill;而 Luna 在长上下文末端的指令遵循与隐式召回能力会有所下降,有时会漏掉既有的 Skill,转而自己写脚本想办法去完成任务。只要在指令里稍微点明要调用的 Skill 名称,这个问题就能规避。
为什么以前觉得 Luna 不好用:主从 Agent 的角色错配
这次连续几天的正向体验,也让我复盘了为什么早先我对 GPT-5.6 Luna 的印象比较一般。
根本原因在于:我之前把 Luna 配置成了 Codex 里的子 Agent(Subagent),由 GPT-6 Astra 或 GPT-5.6 Sol 作为主 Agent 去调度它。
在长期使用中我发现,GPT-6 Astra 和 GPT-5.6 Sol 虽然单兵写代码能力强、长程执行扎实,但性格非常容易「钻牛角尖」,在宏观业务梳理、任务拆解派发以及与人沟通的交流感上其实偏弱。如果缺少人的介入,让一个 GPT 主模型长时间自己去拆解需求并给子 Agent 派活,它派发出去的子任务指令往往越跑越碎、上下文交代不清。在这种混乱的调度下,哪怕把子 Agent 换成顶配的 GPT-6 Astra,产出的效果同样一团糟。
反过来,当我们把 GPT-6 Luna 直接作为主对话模型,由「人」来把控业务方向,每次用清晰直接的一两句话交代具体执行目标时,Luna 作为一个纯粹的执行者表现得非常稳健。如果工作流确实需要重度依赖多 Agent 拆解与编排,按我的实际经验,用 Claude 系列模型做顶层调度会比 GPT 合适得多。
两个提升体感与防超支的实战配置技巧
由于 GPT-6 Luna 的单价极低,我们可以用一些在昂贵模型上不敢随便开的激进配置,把日常工作体验拉满:
1. 常驻开启 Extra High 思考强度 + Fast 模式
用 GPT-6 Astra 时,为了保住周额度,很多时候不敢随便开最高思考档位或加速模式。但在 GPT-6 Luna 上,你可以全程挂着 Extra High 思考强度,并常驻点亮闪电图标开启 Fast 模式(1.5x speed)。高思考档位补齐了轻量模型的推理深度,而 Fast 模式让交互响应极快,综合干活体感甚至比畏手畏脚地省着用高价模型更舒服。
2. 在项目级 .codex/config.toml 中将上下文窗口调高至 80 万
Codex 默认的上下文窗口相对保守。对于明确只需要使用 GPT-6 Luna、不涉及极端复杂架构重构的常规项目,可以直接让 Codex 在当前项目根目录下创建一个局部的 .codex/config.toml,把上下文窗口上限调大到 800000(80 万 Token):
model = "gpt-6-luna"
model_context_window = 800000
model_auto_compact_token_limit = 640000
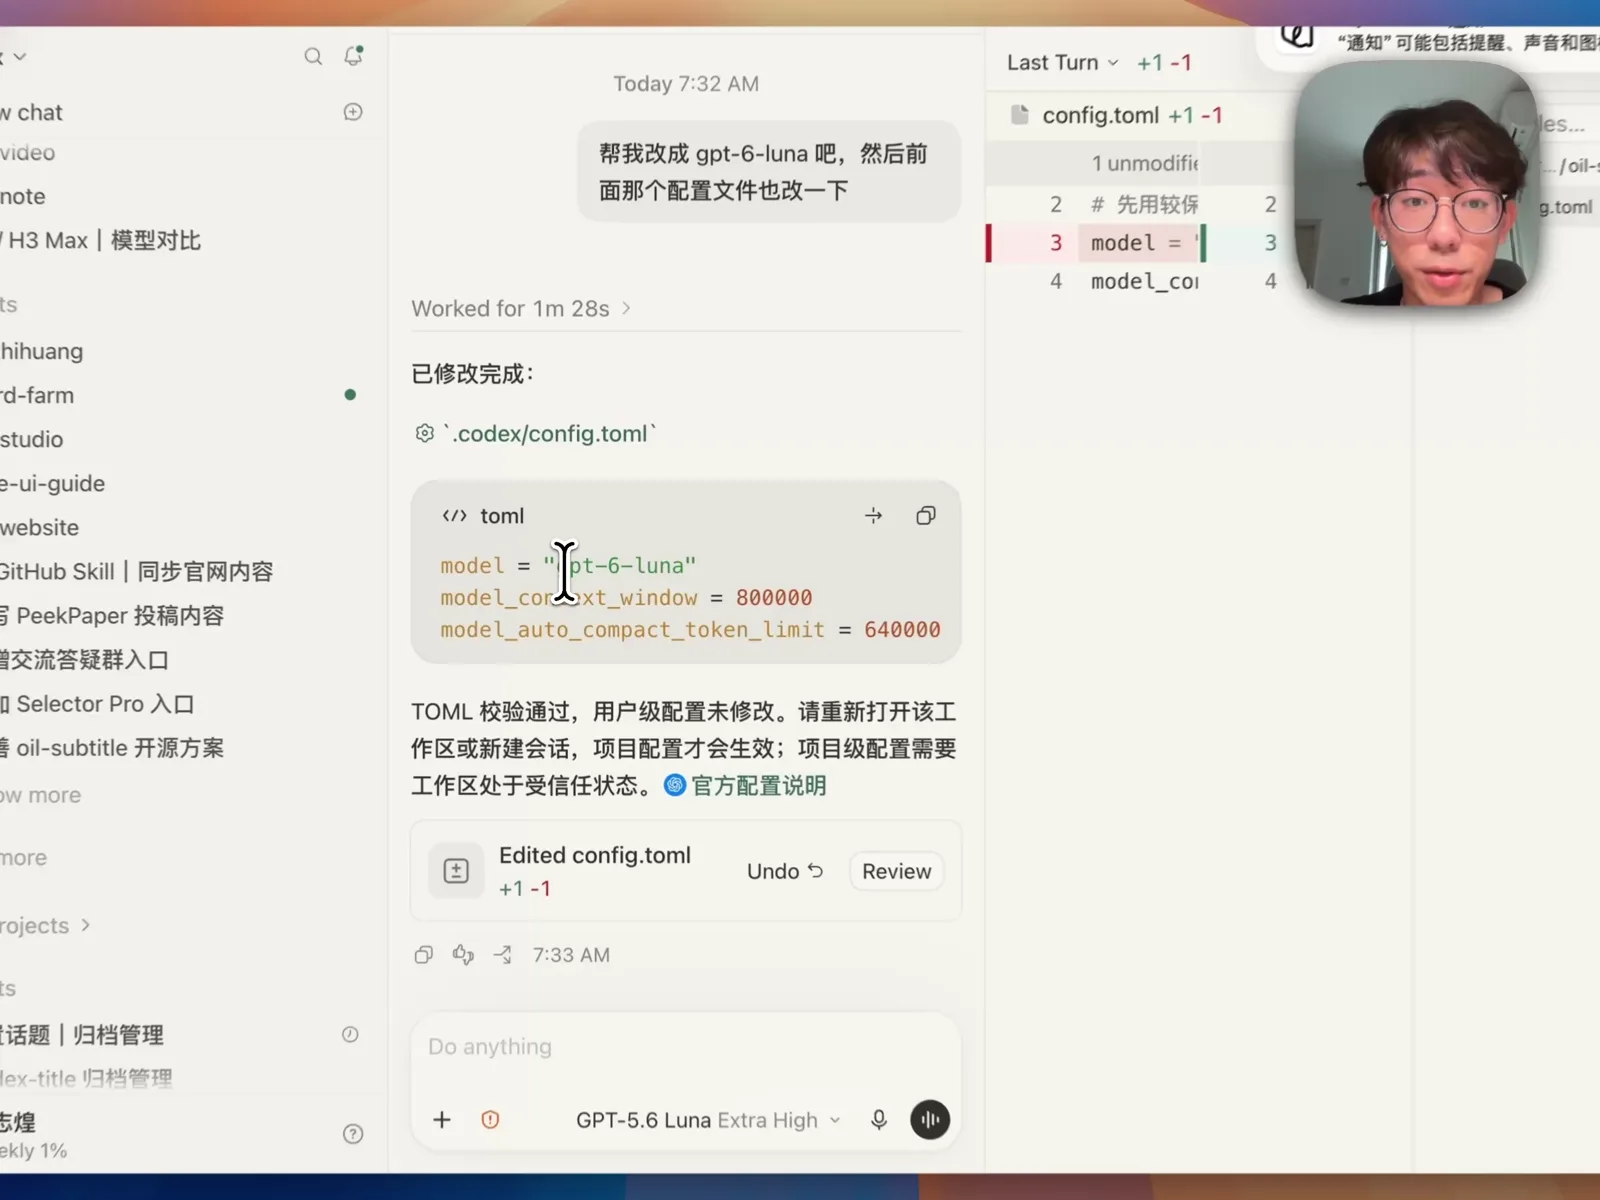
这里务必注意只做项目级(Project-level)配置,不要改全局(User-level)配置。如果全局把 model_context_window 抬高到 80 万,一旦你在某个重度项目里切回 GPT-6 Sol 或 GPT-6 Astra,庞大的未压缩上下文很容易在一天之内把你的全部周额度烧穿。按项目隔离配置并重启工作区会话,既能让 GPT-6 Luna 放开手脚吞吐长上下文,又能守住高价模型的额度安全线。
总结
按目前的费率测算,对于 200 美元每月的 Pro 订阅用户来说,GPT-6 Luna 几乎等同于无限量敞开使用;而这项改动真正利好幅度最大的其实是 20 美元每月的 GPT Plus 订阅用户——原本捉襟见肘的 Codex 周额度,在切换到 GPT-6 Luna 后也能支撑相当长周期的日常高频开发与自动化任务。