高强度连轴使用 GPT-6 系列(包括 GPT-6 Astra、GPT-6 Sol 与 GPT-6 Luna)和 Claude Opus 5.5 一段时间后,我的直观结论很明确:Claude Opus 5.5 在综合开发与创作体验上大幅领先 GPT-6 Astra,这也是今年以来 Claude 与 GPT 两家旗舰模型体感差距最大的一次。
先看 GPT-6 这一代的变化。最顶配的 GPT-6 Astra 相比上一代 GPT-5.6 Sol,主要提升集中在电脑桌面自动化操作和 3D 建模这类偏小众的能力上,但调用成本贵了一大截;而官方主打降价的 GPT-6 Sol(降价 50%)和 GPT-6 Luna(降价 60%),在指令遵循和 Skill 召回能力上反而出现了明显倒退。
拿我每天都要跑的固定工作流来说——做 PPT、生成封面、压制字幕、自动发布各平台视频——以前用 GPT-5.6 Luna 几乎不会出错。换到 GPT-6 之后,如果在任务里没把要读的规范文件路径点透,GPT-6 Sol 会漏读字幕 Skill 的关键规则、自己胡乱发明一套字幕样式;GPT-6 Luna 则出现过把英文项目名硬翻成中文,甚至把写日报的格式规范原封不动抄进日报正文里的低级失误。
更重要的是沟通成本。GPT 系列生成的中文长期带着一股生硬拗口的腔调,每个字都认识,连在一起却要反应半天。如果人不去强行介入把控方向,只给一个宽泛目标让它在 Codex 里自己迭代,它就会不断往代码里堆叠冗余的 if-else 分支、再给这些冗余分支写一堆无意义的测试和门禁规则。下面通过三个具体场景的实测,直接看两边的产出差异。
场景一:同一套 UI 设计 Skill 下的网页设计
我用自己写的同一套界面设计 Skill(oil-ui),分别让 Claude Opus 5.5 和 GPT-6 Astra 为一款 Mac 端会议录音转写软件设计产品落地页。
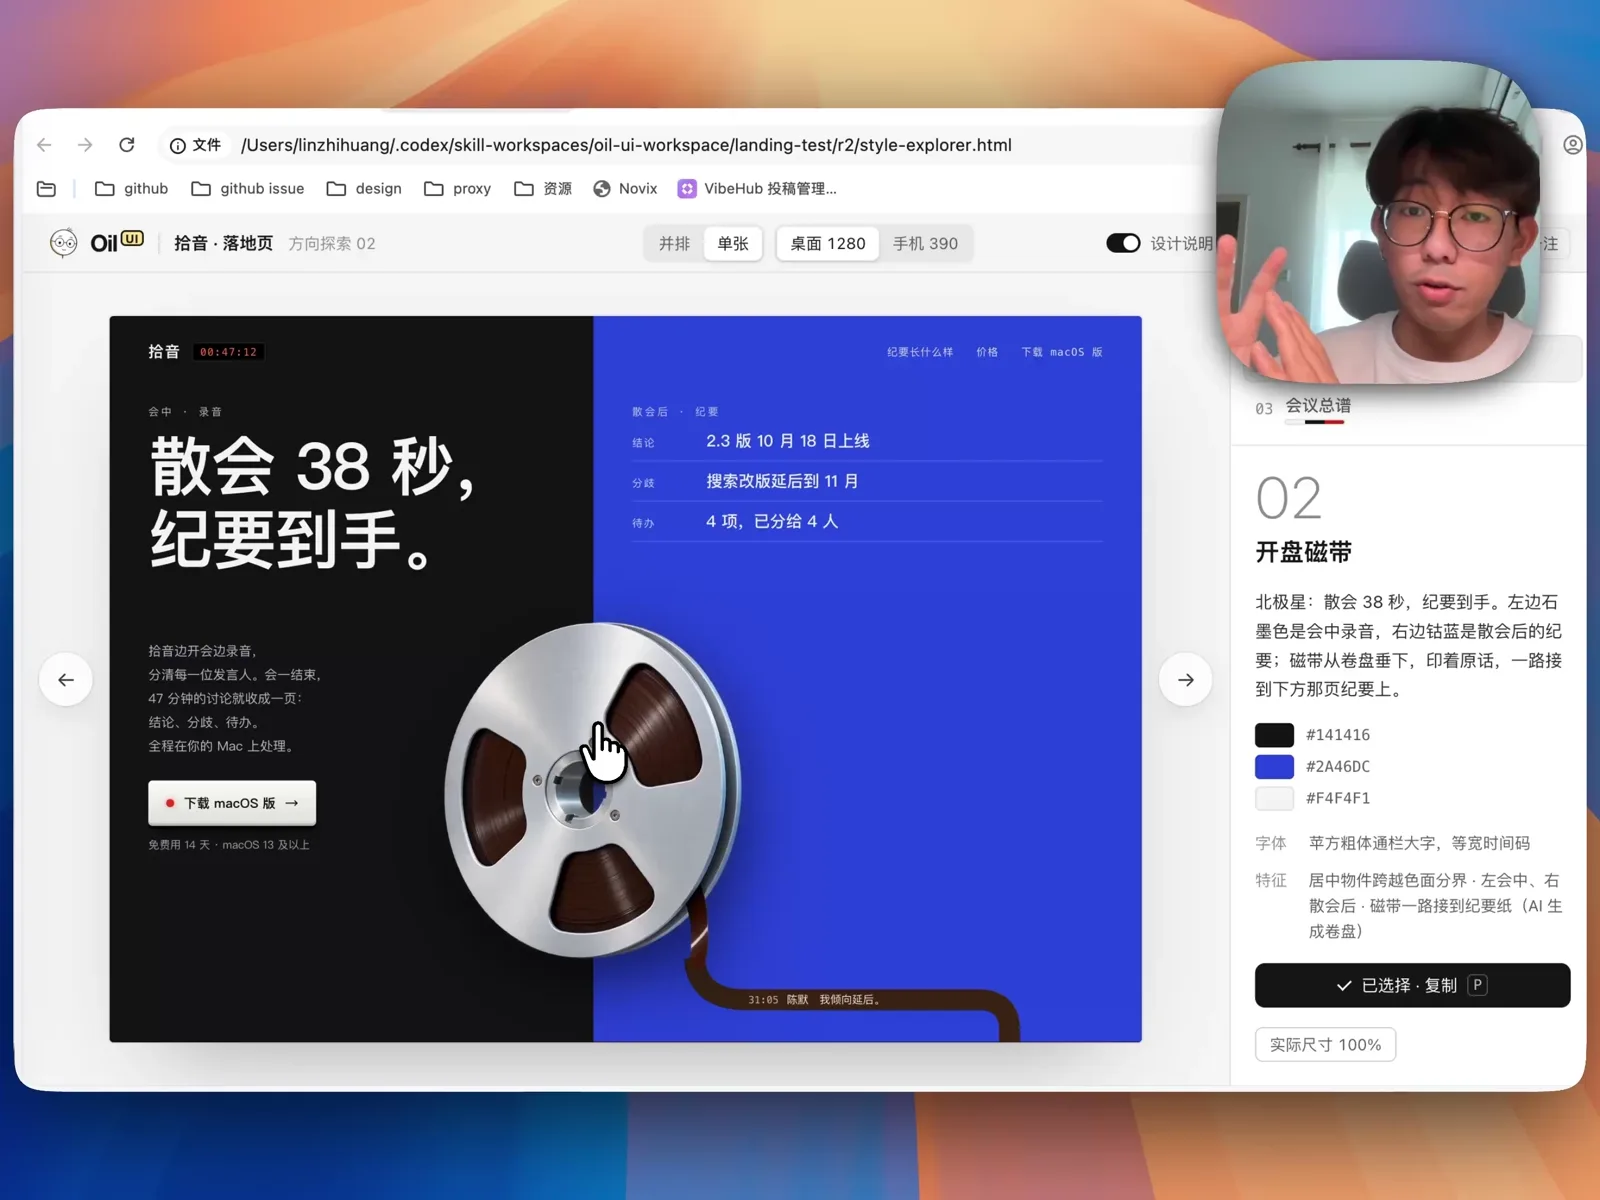
Claude Opus 5.5 准确理解了 Skill 里的生图与排版规范,先调用生图模型生成了带透明背景的视觉素材,再结合版式给出了三个差异明显的方向:第一个方向用立体办公楼层剖面呈现会议场景;第二个方向采用深浅双色左右拼接,让一盘开盘磁带自然横跨在两块背景交界处,视觉张力很足;第三个方向则是克制干净的平面极简风。
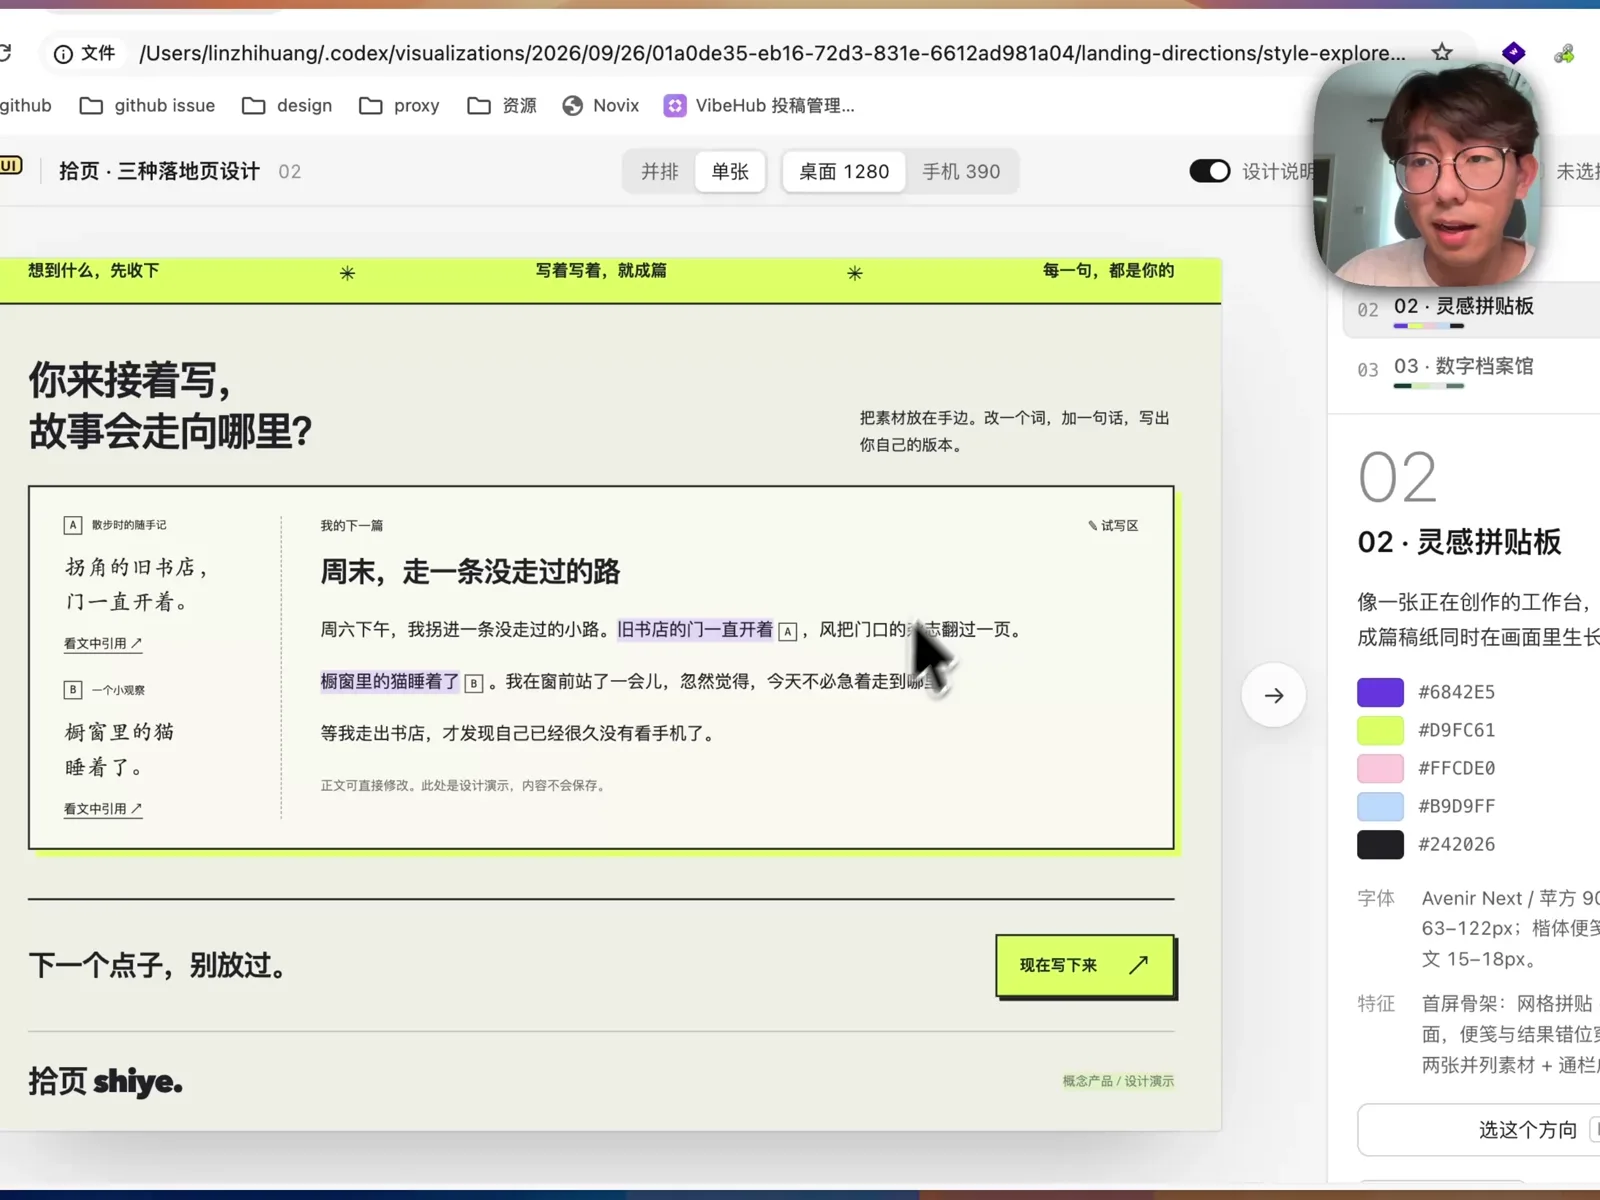
再看 GPT-6 Astra 的产出。单看第一眼的配色和骨架,它选的暖白底色配橙色强调色其实不错,留白和大标题也有气势。但只要细看页面元素,全是 GPT 改不掉的坏毛病:它特别喜欢在各个角落塞满细碎的英文小标签、方括号编号([A]、[B])和“示例”“草稿可直接编辑”之类的灰色说明条;哪怕 Skill 里已经明确禁止在界面上堆砌无意义的元数据标签,它还是把“概念产品 / 设计演示”直接印在了首屏按钮旁边。
场景二:程序化口播视频生成对比
第二个测试是我日常用来把口播稿转成动态画面的程序化视频框架 oil-video。
之前我用 GPT-6 Astra 配合这套框架做了一条介绍 GPT-6 Luna 定价的视频。哪怕经过多轮人工介入打磨,做出来的画面依然像是在放网页版 PPT——镜头切换基本就是一张张静态文字卡片配截图,如果关掉背景音乐和人声口播,画面本身非常干瘪。
随后我让 Claude Opus 5.5 重构了这套视频框架,并让它做了一条介绍自己在 WebDev 竞技场拿下第一名(1818 分,领先第二名 GPT-6 Astra 的 1792 分)的短片。
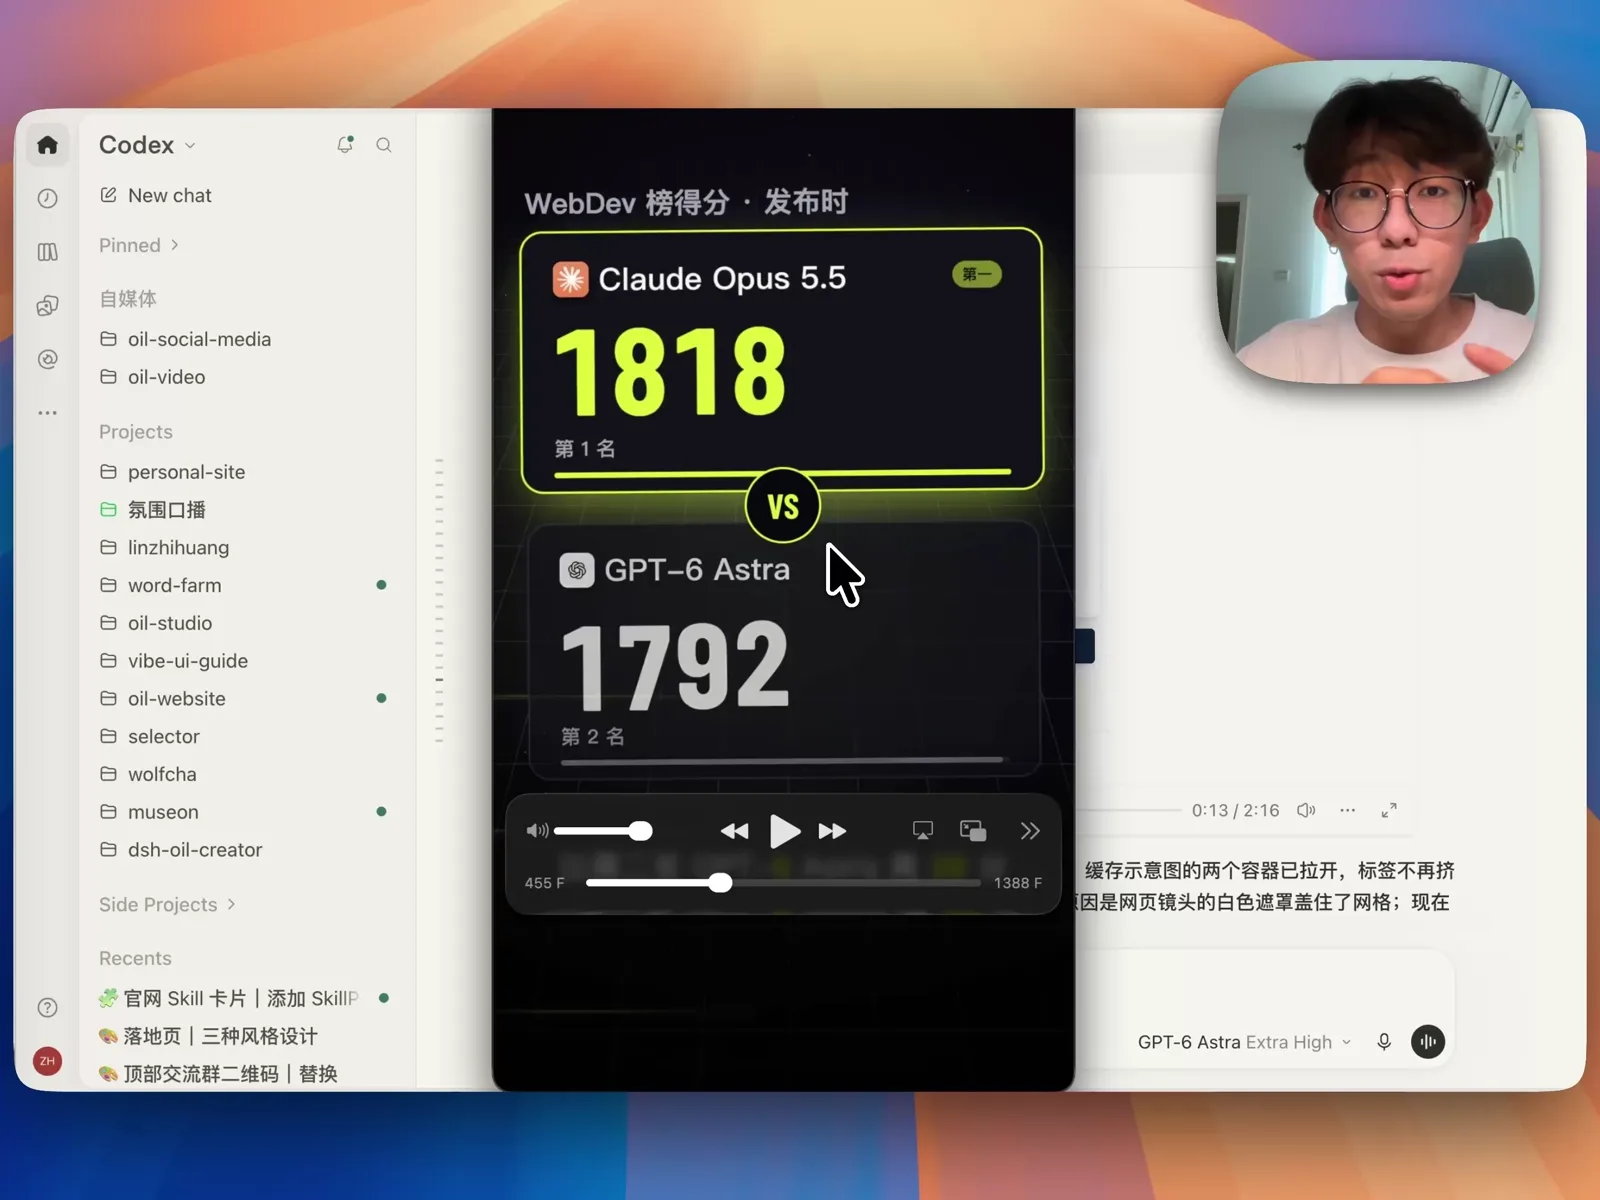
Claude Opus 5.5 做出来的成片完全摆脱了“网页幻灯片”的质感:字号针对手机竖屏阅读做了大胆放大,榜单局部会随着口播节奏自动高亮并平滑放大推近,镜头之间的转场和动效衔接都真正有了动态图形视频的味道。
场景三:对 1.4 万行复杂工程的架构诊断与重构
为什么同一个视频框架,在两个模型手里会有这么大差距?
这套 oil-video 框架是我之前在 Codex 里断断续续迭代出来的。随着修过的 Bug 越来越多,仓库里的脚本和规范文档越垒越厚,我自己都觉得流程过于臃肿。但我之前让 GPT-6 Astra 去排查精简时,它始终理不清头绪。
这次我把完全相同的诊断指令同时发给了 Claude Opus 5.5 和 Codex(开启 GPT-6 Astra 高推理挡位),让它们各自审查整个仓库并给出重构方案。两边的回复放在一起对比非常直观。
Claude Opus 5.5 用清晰直白的大白话,一下就戳中了仓库的四个病根:
- 规模失衡:
scripts/目录下攒了约 1.4 万行 Python 和 JS 脚本(含 29 个测试脚本)、10 个主命令、18 个维护命令和 20 份规范文档,而真正决定画面好看与否的news-kit视觉源码却只有 651 行。 - 精力花偏:项目进度文档里大段篇幅都在纠结高亮框偏了 2px、截图几何复测和字幕断句,没有一条在讨论怎么让镜头更抓人。
- 审看走形式:盲审、
record-viewing、pending_visual状态机设计得极细,但每部片子最后都写着“完整原速视听未完成”,真正该做的看片没人做,全在填表登记。 - 规则只增不减:
AGENTS.md要求每次修完问题都回头补规范,结果每出一个错就多加一道门禁,从来不删旧规则。
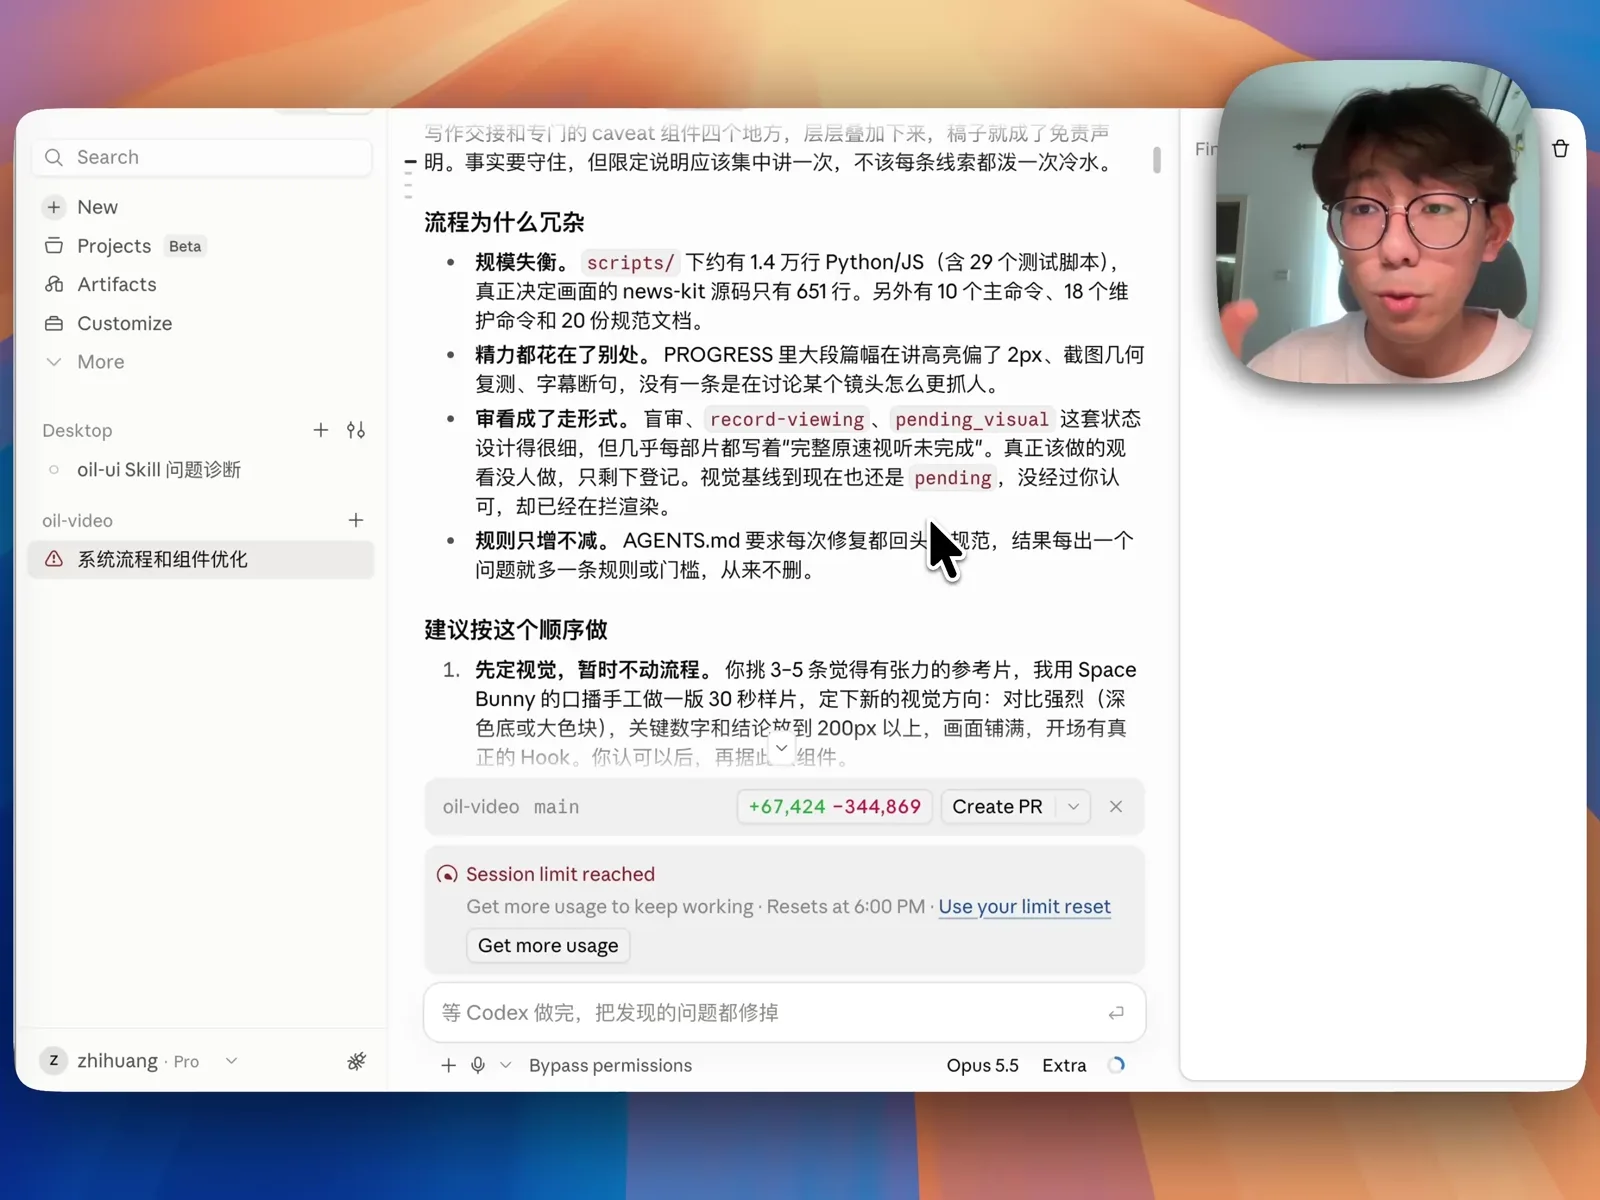
为了测试它在低门槛订阅下的表现,我专门用 20 美元/月的 Claude Pro 账号跑了这次重构。在一个 5 小时额度周期内,Claude Opus 5.5 不仅写出了上面这份一针见血的诊断,还直接动手删掉了 34 万行冗余文件与历史包袱(+67,424 / -344,869),顺带做出了前面那条高质量样片。
反观 Codex 给出的五条审查结论:“没有只输入主题的路径”“新工程无法直接走通宣称的主路径”“任意模型尚未实现 writing.model 可改模型名”“新视觉的规则相冲突”“现有检查没有覆盖上述断点”。
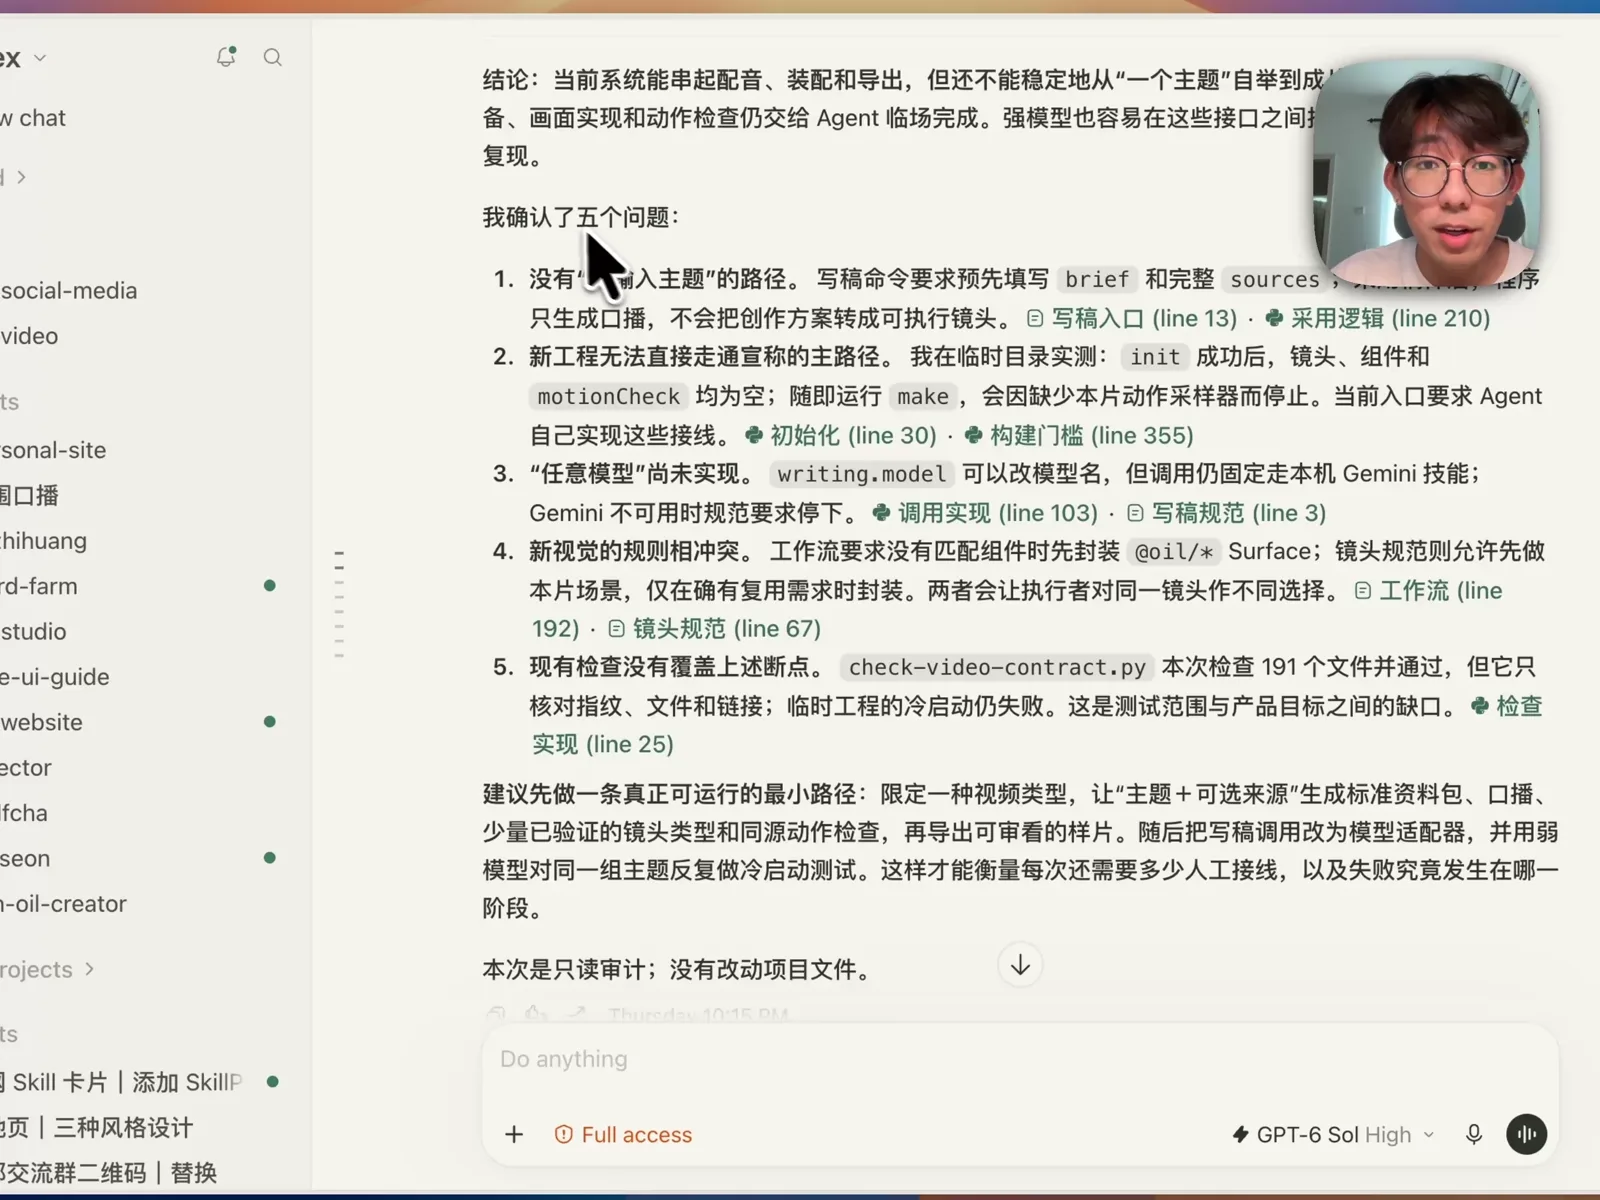
作为这个仓库的作者,我读完 Codex 这五条结论都得停下来反应半天它到底在说什么。它完全陷在了现有脚本的局部接口细节里,既看不出“1.4 万行门禁脚本对比 651 行视觉代码”的结构性失衡,也给不出能落地的减法方案。
模型演进体感与额度开销体验
回顾过去半年 Claude 系列的迭代,其实并不是一路顺风。Claude Opus 4.6 曾是我非常喜欢的一代,沟通自然、理解到位;但随后的 Opus 4.7、4.8 到 5.0,对话体感一度变得机械生硬。前段时间的 Fable 5 和 Fable 5.1 虽然在前端审美与代码执行力上很强,但日常文字沟通的顺畅度依然没能完全找回 Opus 4.6 的感觉。
直到这次的 Claude Opus 5.5,它把 Opus 4.6 那种“指哪打哪、说人话”的沟通质感完整找了回来,同时叠加上了目前最顶尖的前端审美和复杂工程重构能力。
在实际工程体验上,两边还有三点明显差异:
- 上下文窗口实感:
Claude Opus 5.5的 1M 上下文非常扎实,连续处理长链路重构不需要频繁压缩历史;而 Codex 往往聊不了几轮就开始触发上下文压缩,一旦压缩就会丢失前面的细节要求。 - 响应速度:
Claude Opus 5.5即使不开加速模式,日常输出速度也完全跟得上交互节奏。 - 价格与额度耐用度:
Claude Opus 5.5的 API 定价比上一代Opus 5下调了 40%;相比之下,如果在 Codex 里切到GPT-6 Astra高推理挡位,重度跑不了一天额度就会见底。
如果你日常需要处理复杂的界面设计、长文润色或者大型历史仓库的瘦身重构,目前 Claude Opus 5.5 是综合体验最省心的选择。