我把 GLM-5.3 接进自己的日常前端工作流里,用短提示词做 HTML 页面,用 Skill 编写网页动画,再让它参与浏览器扩展的实际开发。几次实测下来,最直观的感受是它在网页界面与视觉排版上的表现很突出。
在展开测试前,需要先区分两类信息。Z.ai 的 GLM-5.3 官方发布页 写明,这个版本使用和 GLM-5.2 相同的基座模型,改进主要来自后训练;页面还列出了 Z.ai 自己的评测结果。下面的网页、动画和浏览器扩展,则是我把模型接进实际工作流后观察到的结果,属于个人使用体验,不能直接当成官方能力清单。
先用短提示词做网页
我日常测试编程模型时,比较喜欢先给简短的提示词,让它直接生成一个具有设计感的 HTML 页面。这样更容易观察模型自身的视觉构思,以及它如何组合 CSS、动效与页面结构。
测试全程搭配 Z Code 使用。Z Code 是 Z.ai 面向编程场景提供的工具,我用它来调用 GLM-5.3、查看代码变动,并在浏览器中实时打开生成的页面。
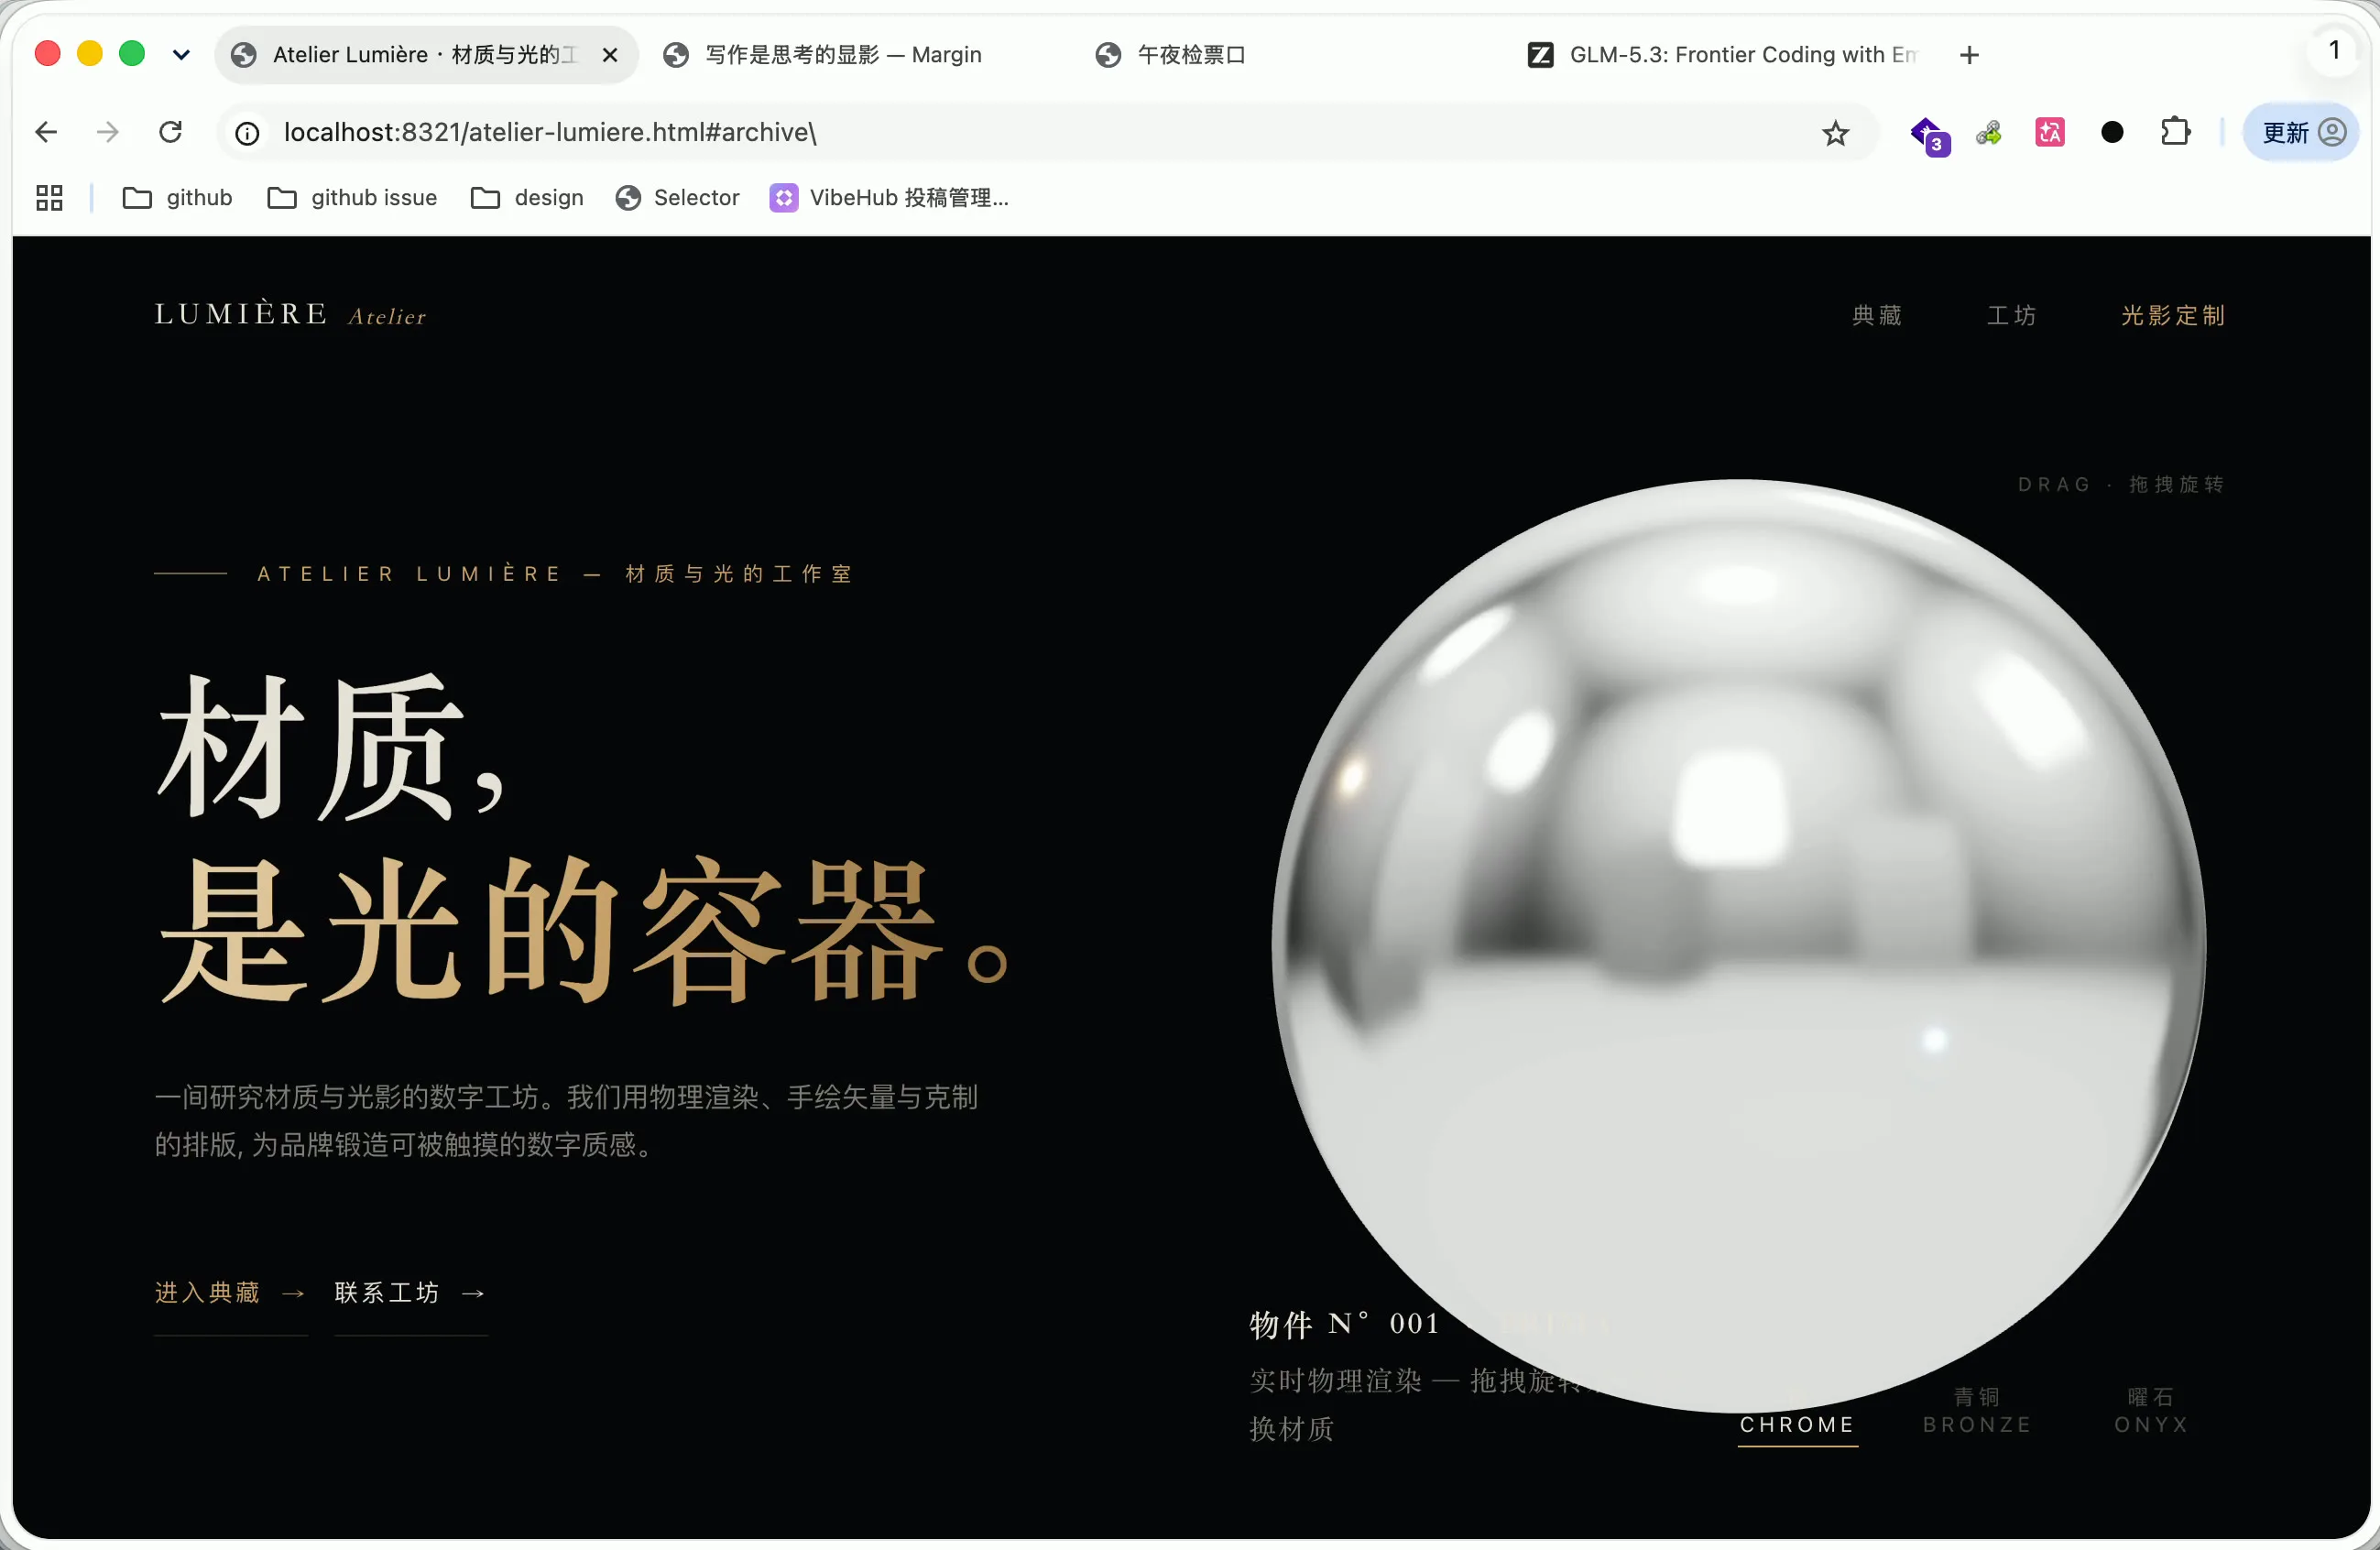
第一个页面的要求很简单:体现材质和光影。GLM-5.3 最终做成了一个支持切换不同材质的落地页,页面中带有类似 3D 的展示效果。它用 SVG 绘制材质质感,数字区域自主添加了滚动效果,整体排版也保持克制,没有堆叠过多冗余元素。
第二个页面是一个写作工作台。这个结果让我印象很深,提示词同样简短,但页面中的光标配色、界面层级和交互细节都处理得很到位,而且全部整合在一个 HTML 文件里。这种结果已经非常接近可以继续落地的产品草稿,不需要额外花费时间重新整理基础视觉。
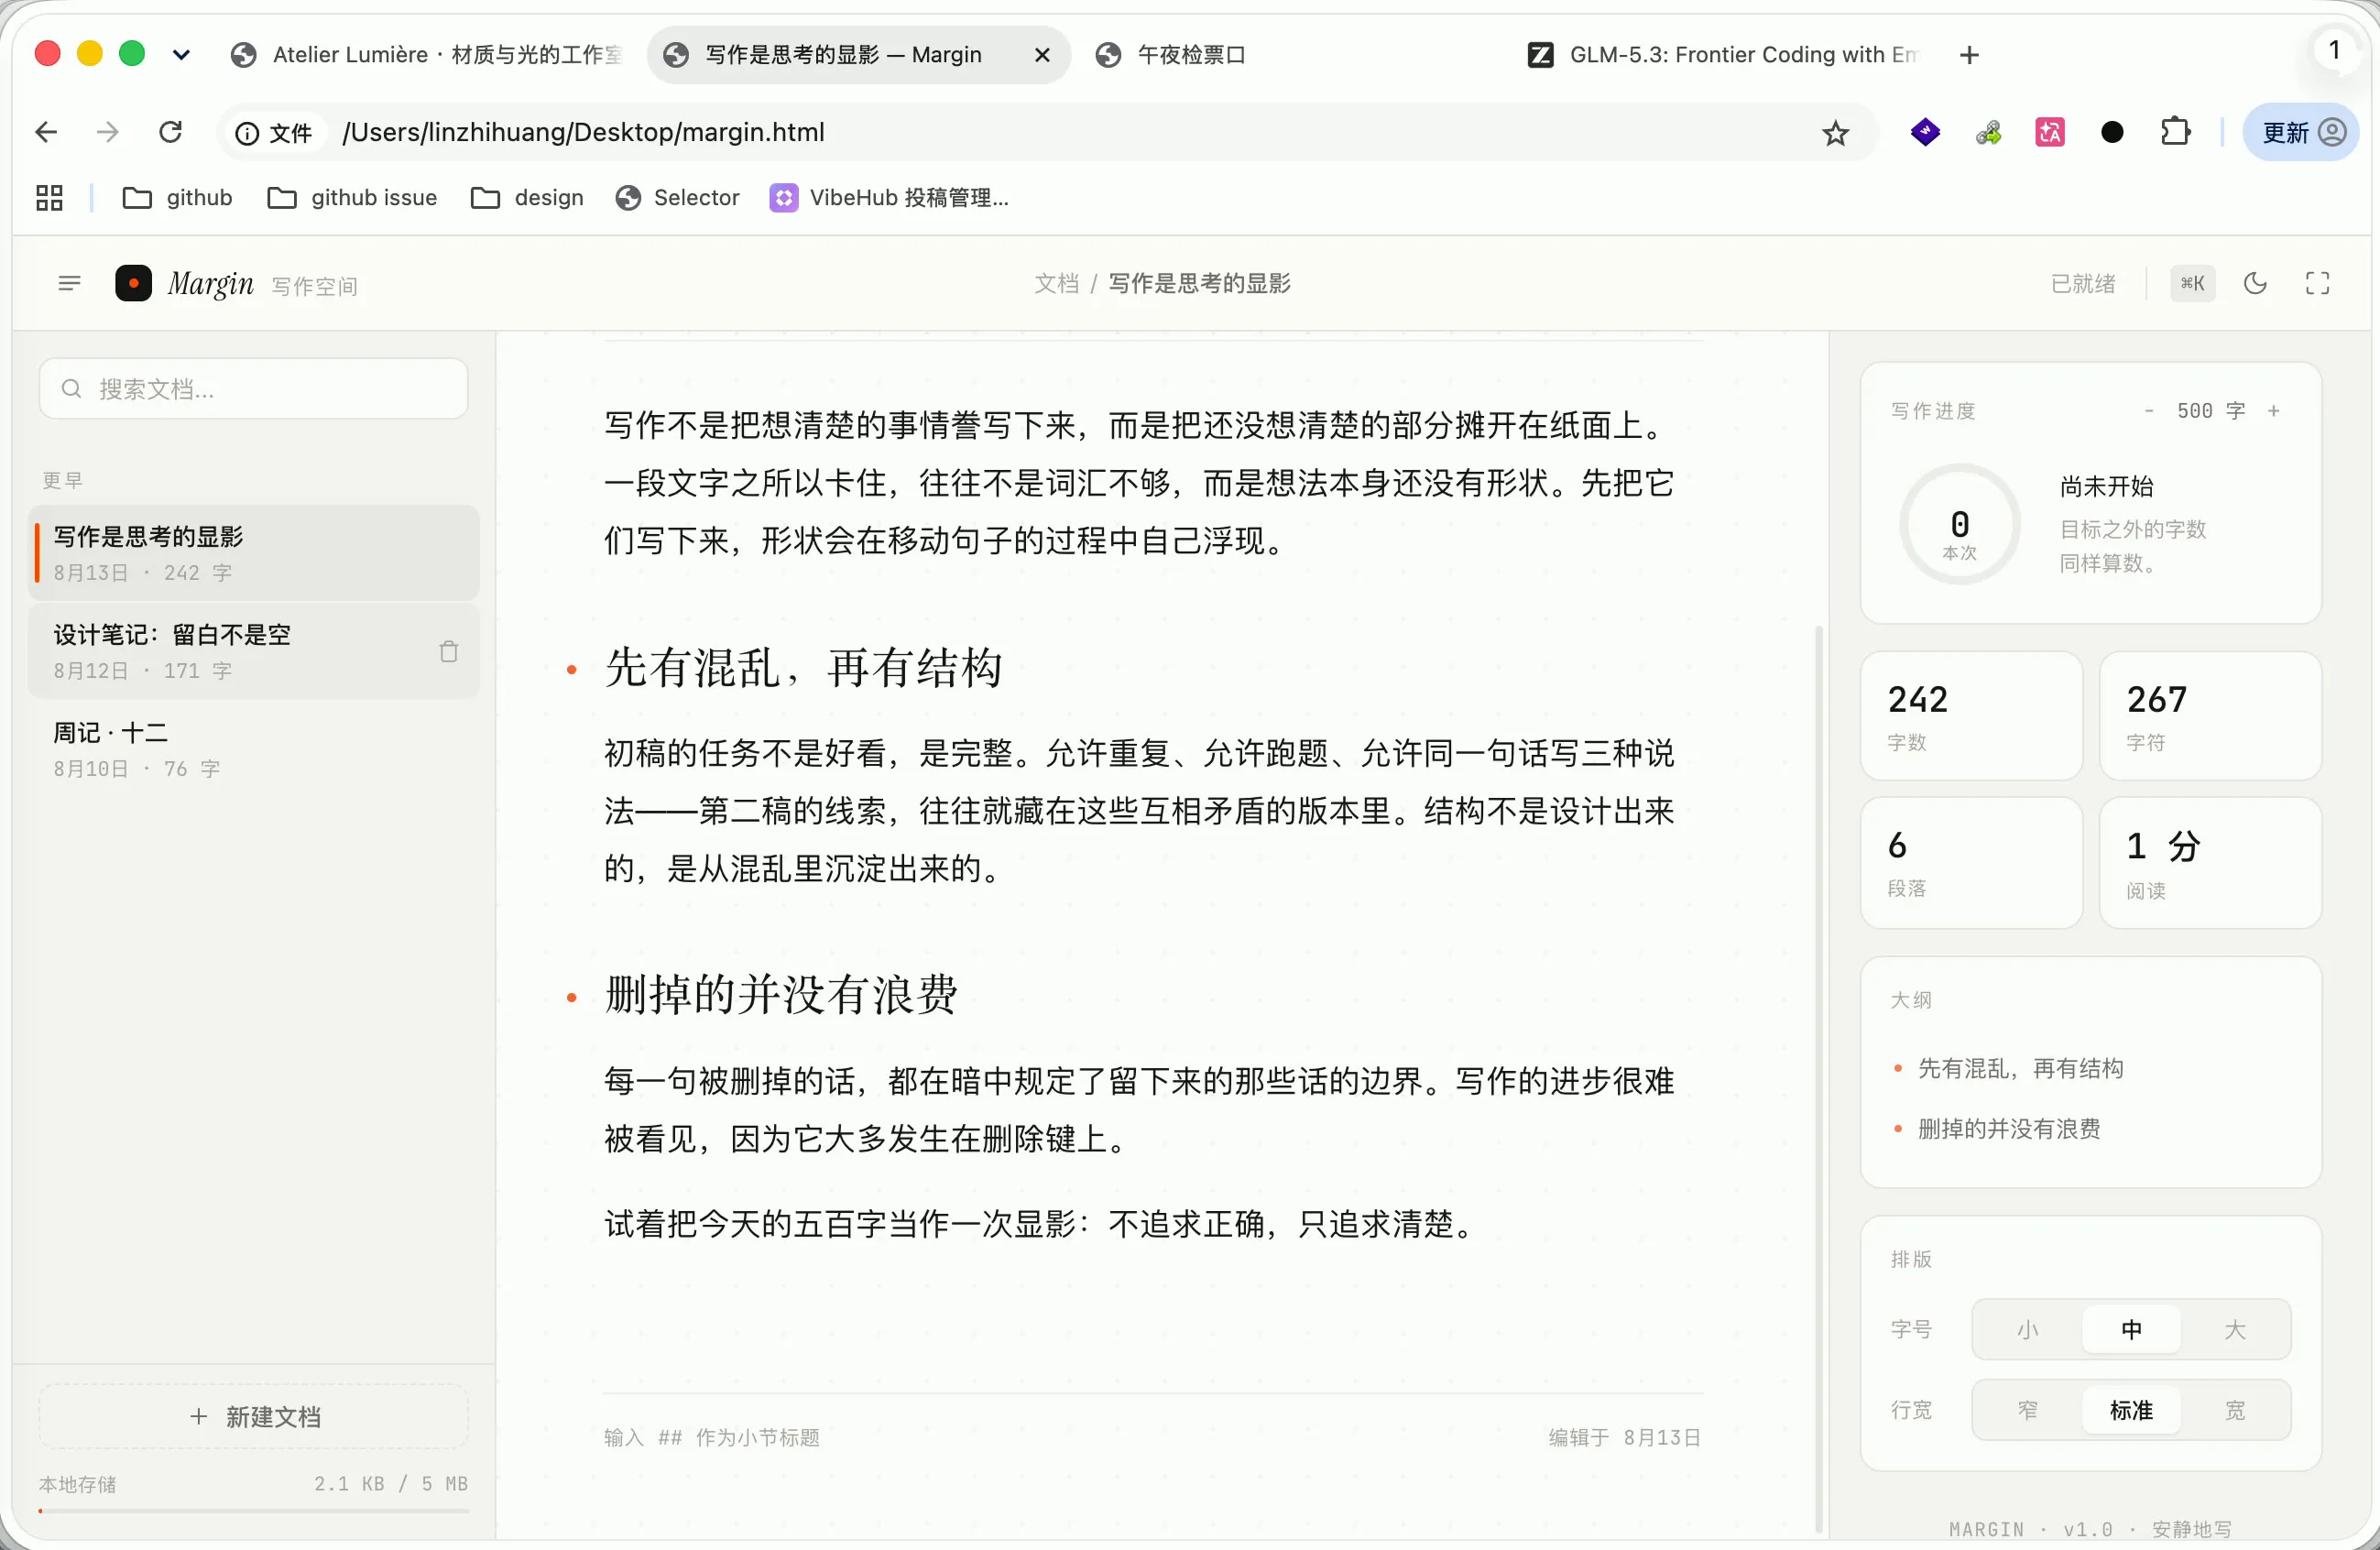
这里说的“设计能力”,指的是我在这些页面中实际看到的效果:材质、光影、排版、颜色与交互之间能保持整体协调。它不代表模型在所有前端任务中都有完全相同的表现,因此我还进行了更复杂的针对性测试。
让它沿着 Skill 做网页动画
第三个测试使用的是我写的 oil-motion Skill。它是一套指导 Agent 制作网页交互动画的工作流。我把它接入 GLM-5.3 后,让模型自主构思创意,并按照这套工作流完成一个可交互的网站动画。
最终实现的是一个售票员场景:鼠标光标是一张车票,售票员形象会跟随这张车票移动,手里还拿着检票钳,尝试对准鼠标上的车票检票。这个创意由 GLM-5.3 自主构思,我负责放进工作流里验证实际交互效果。
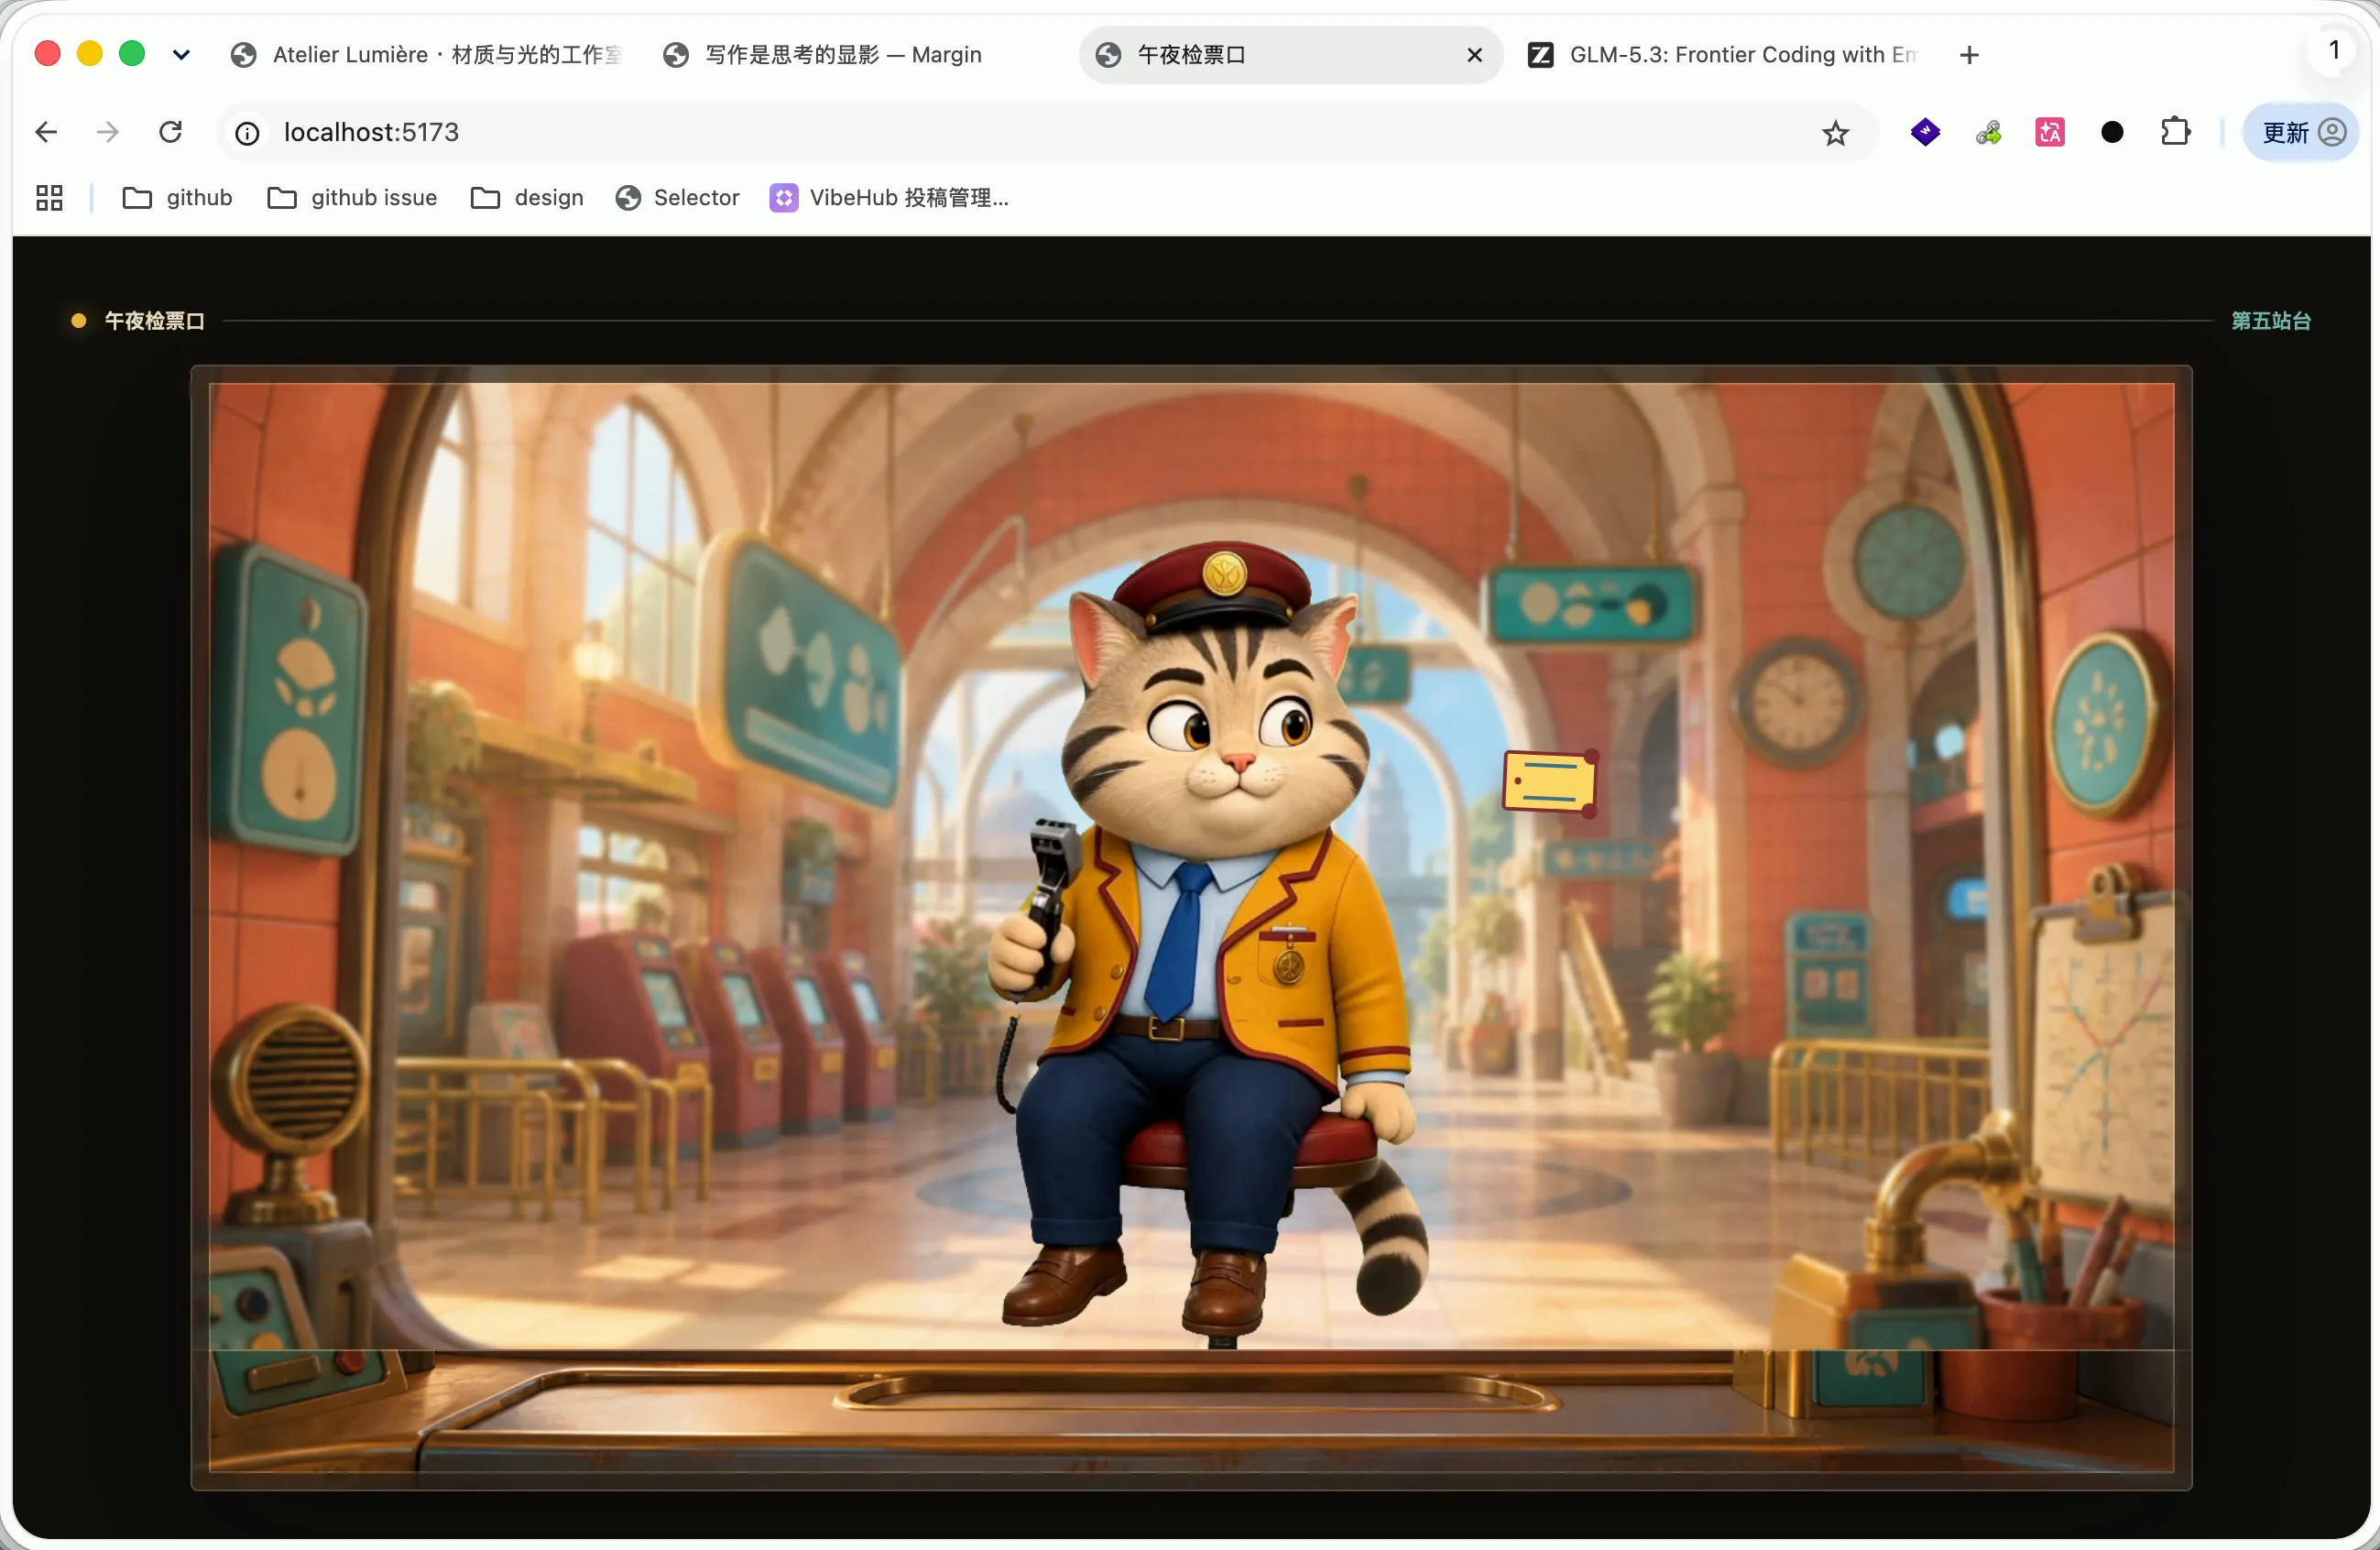
这个测试主要验证两点:模型能否在相对复杂的 Skill 规范约束下稳定执行,以及它是否具备足够的构思能力将基础交互演化为完整场景。从最终结果来看,动画的交互逻辑完全成立,鼠标向哪个方向移动,角色就朝对应方向跟随,画面也具备统一的视觉风格。
用真实项目测试浏览器扩展
前两个页面偏向单次生成,网页动画偏向创意验证。最后我把测试放回一个真实项目:Selector。
Selector 是我之前开发的网页元素选择工具,可以选中页面中的元素,复制其位置描述并粘贴到编程工具中,帮助模型快速定位需要修改的代码节点。这次我让 GLM-5.3 参与开发其 Pro 版本。
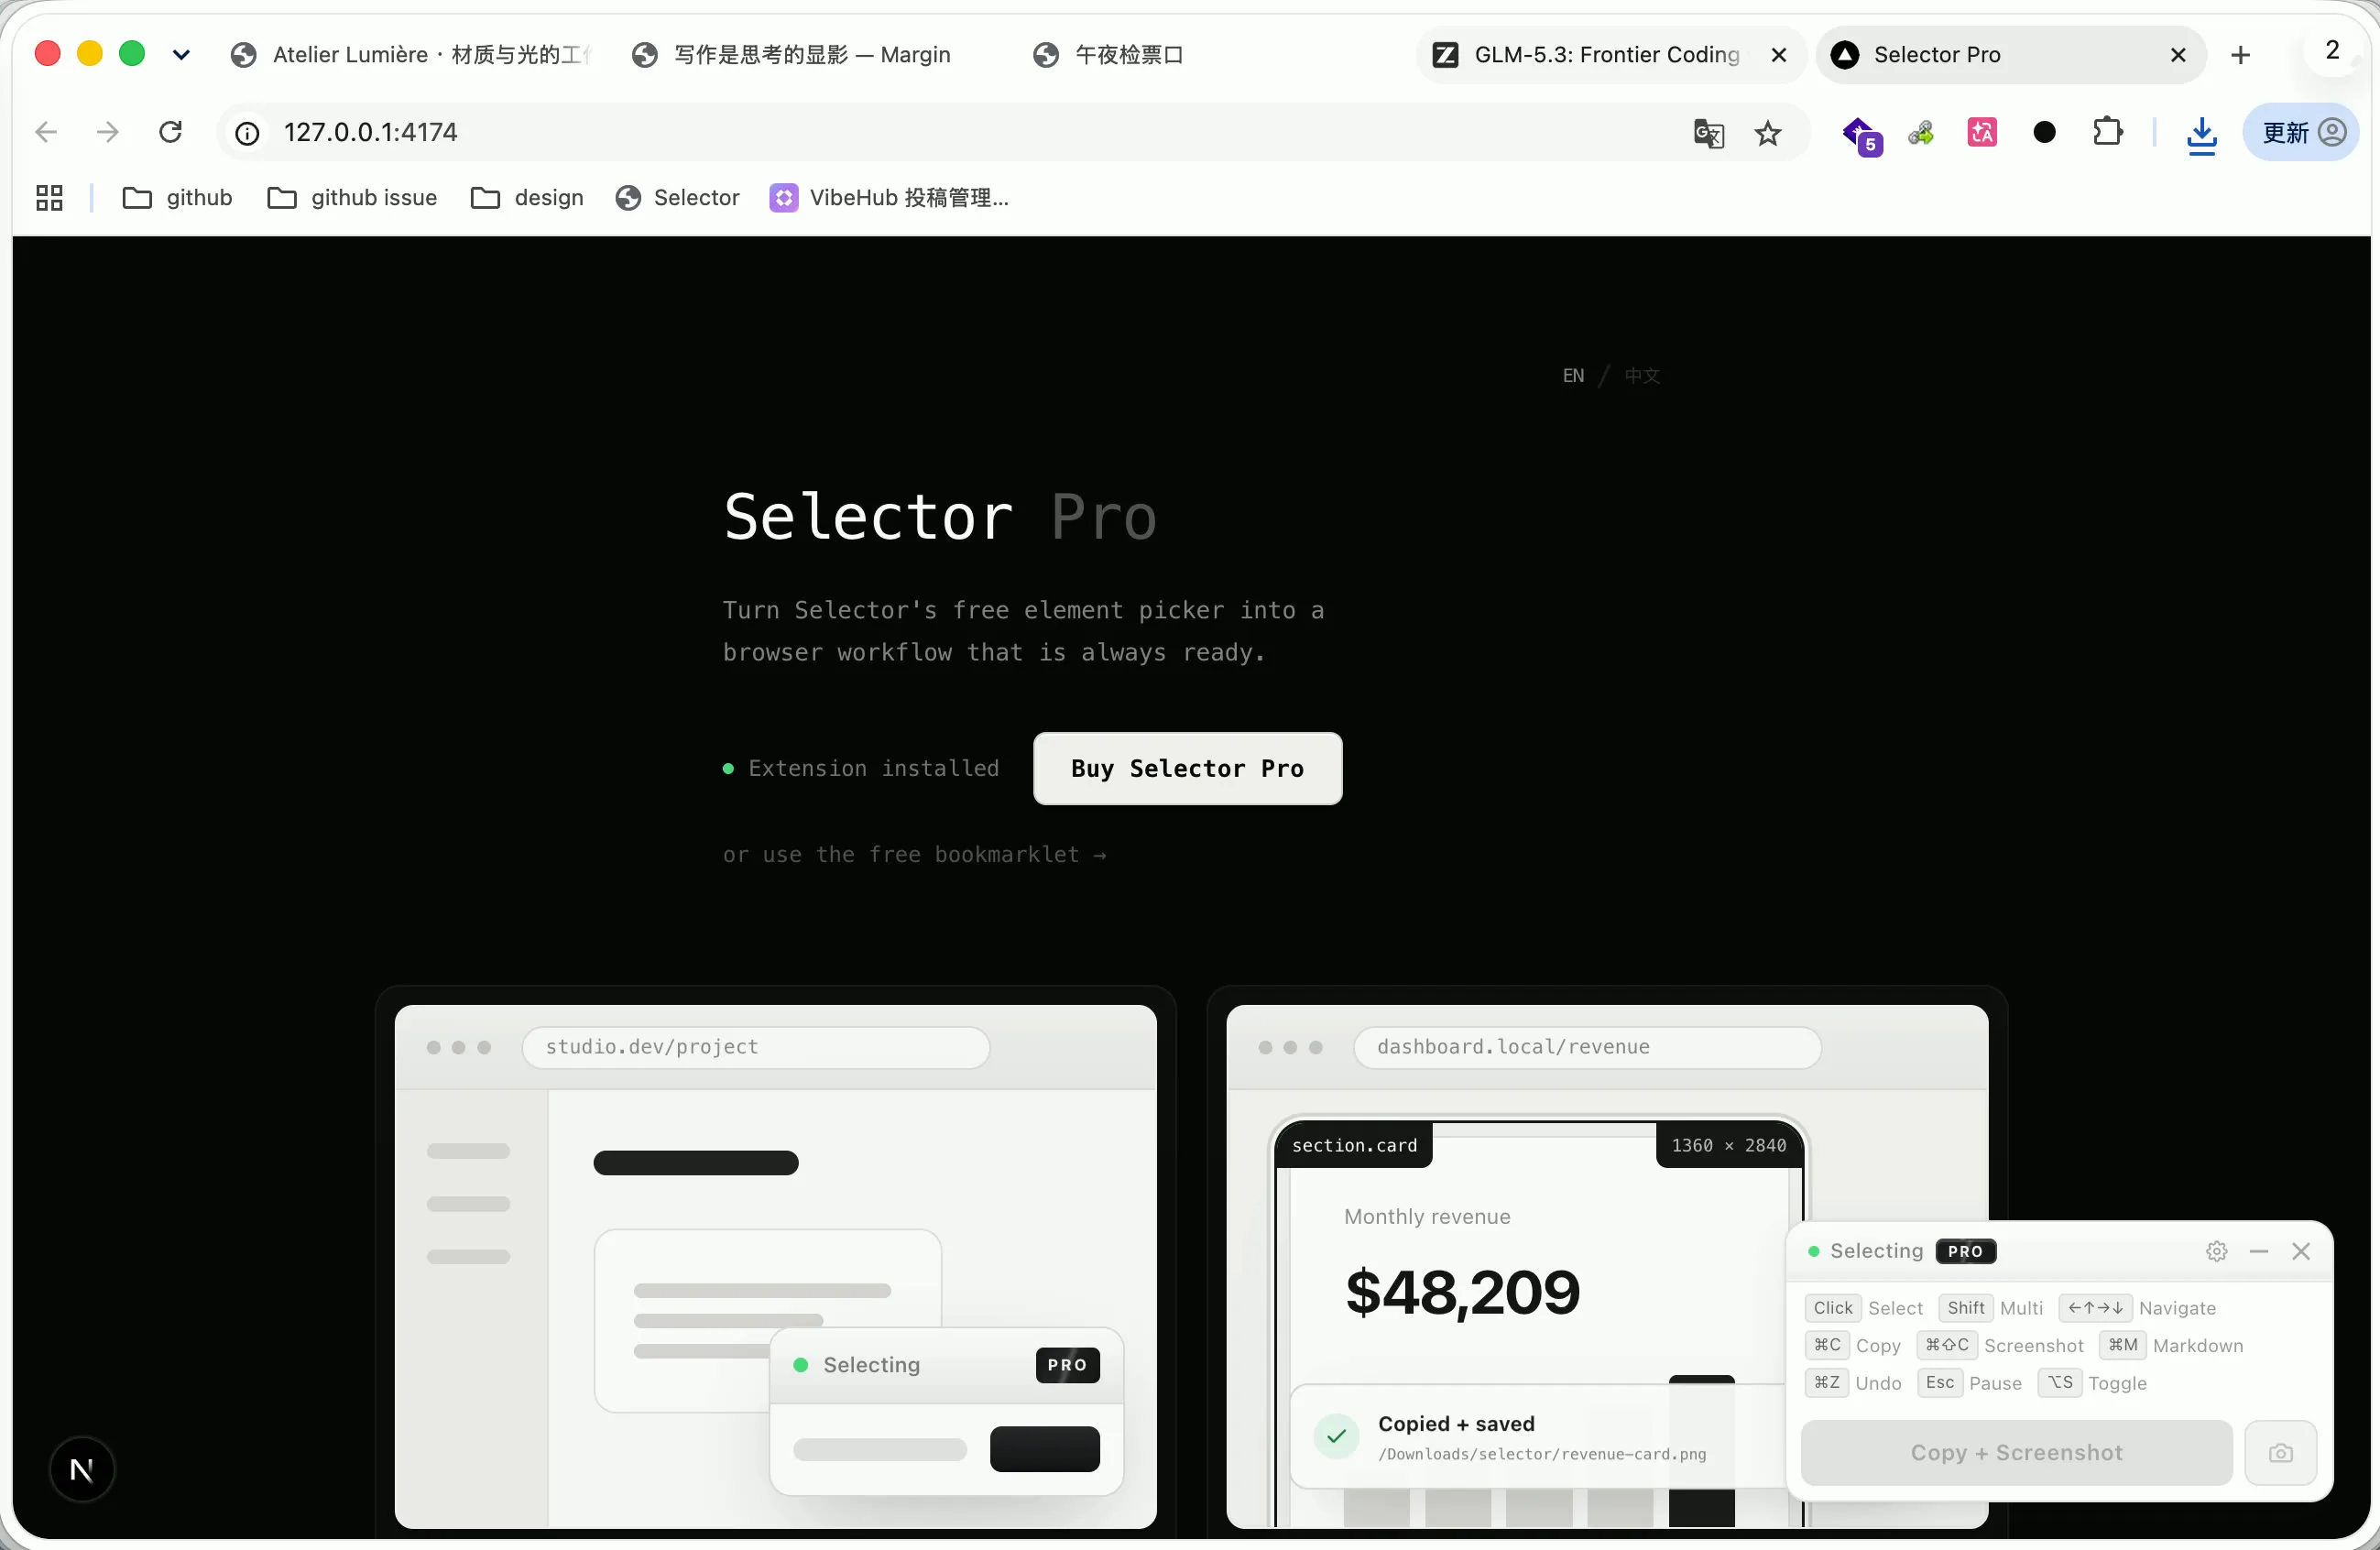
Pro 版本与原有的 Lite 书签版功能相近,但重构为了完整的浏览器扩展。在这次开发中,我先让它完成落地页,再把三个案例用代码写成演示图,并尽量延续原有的设计风格。
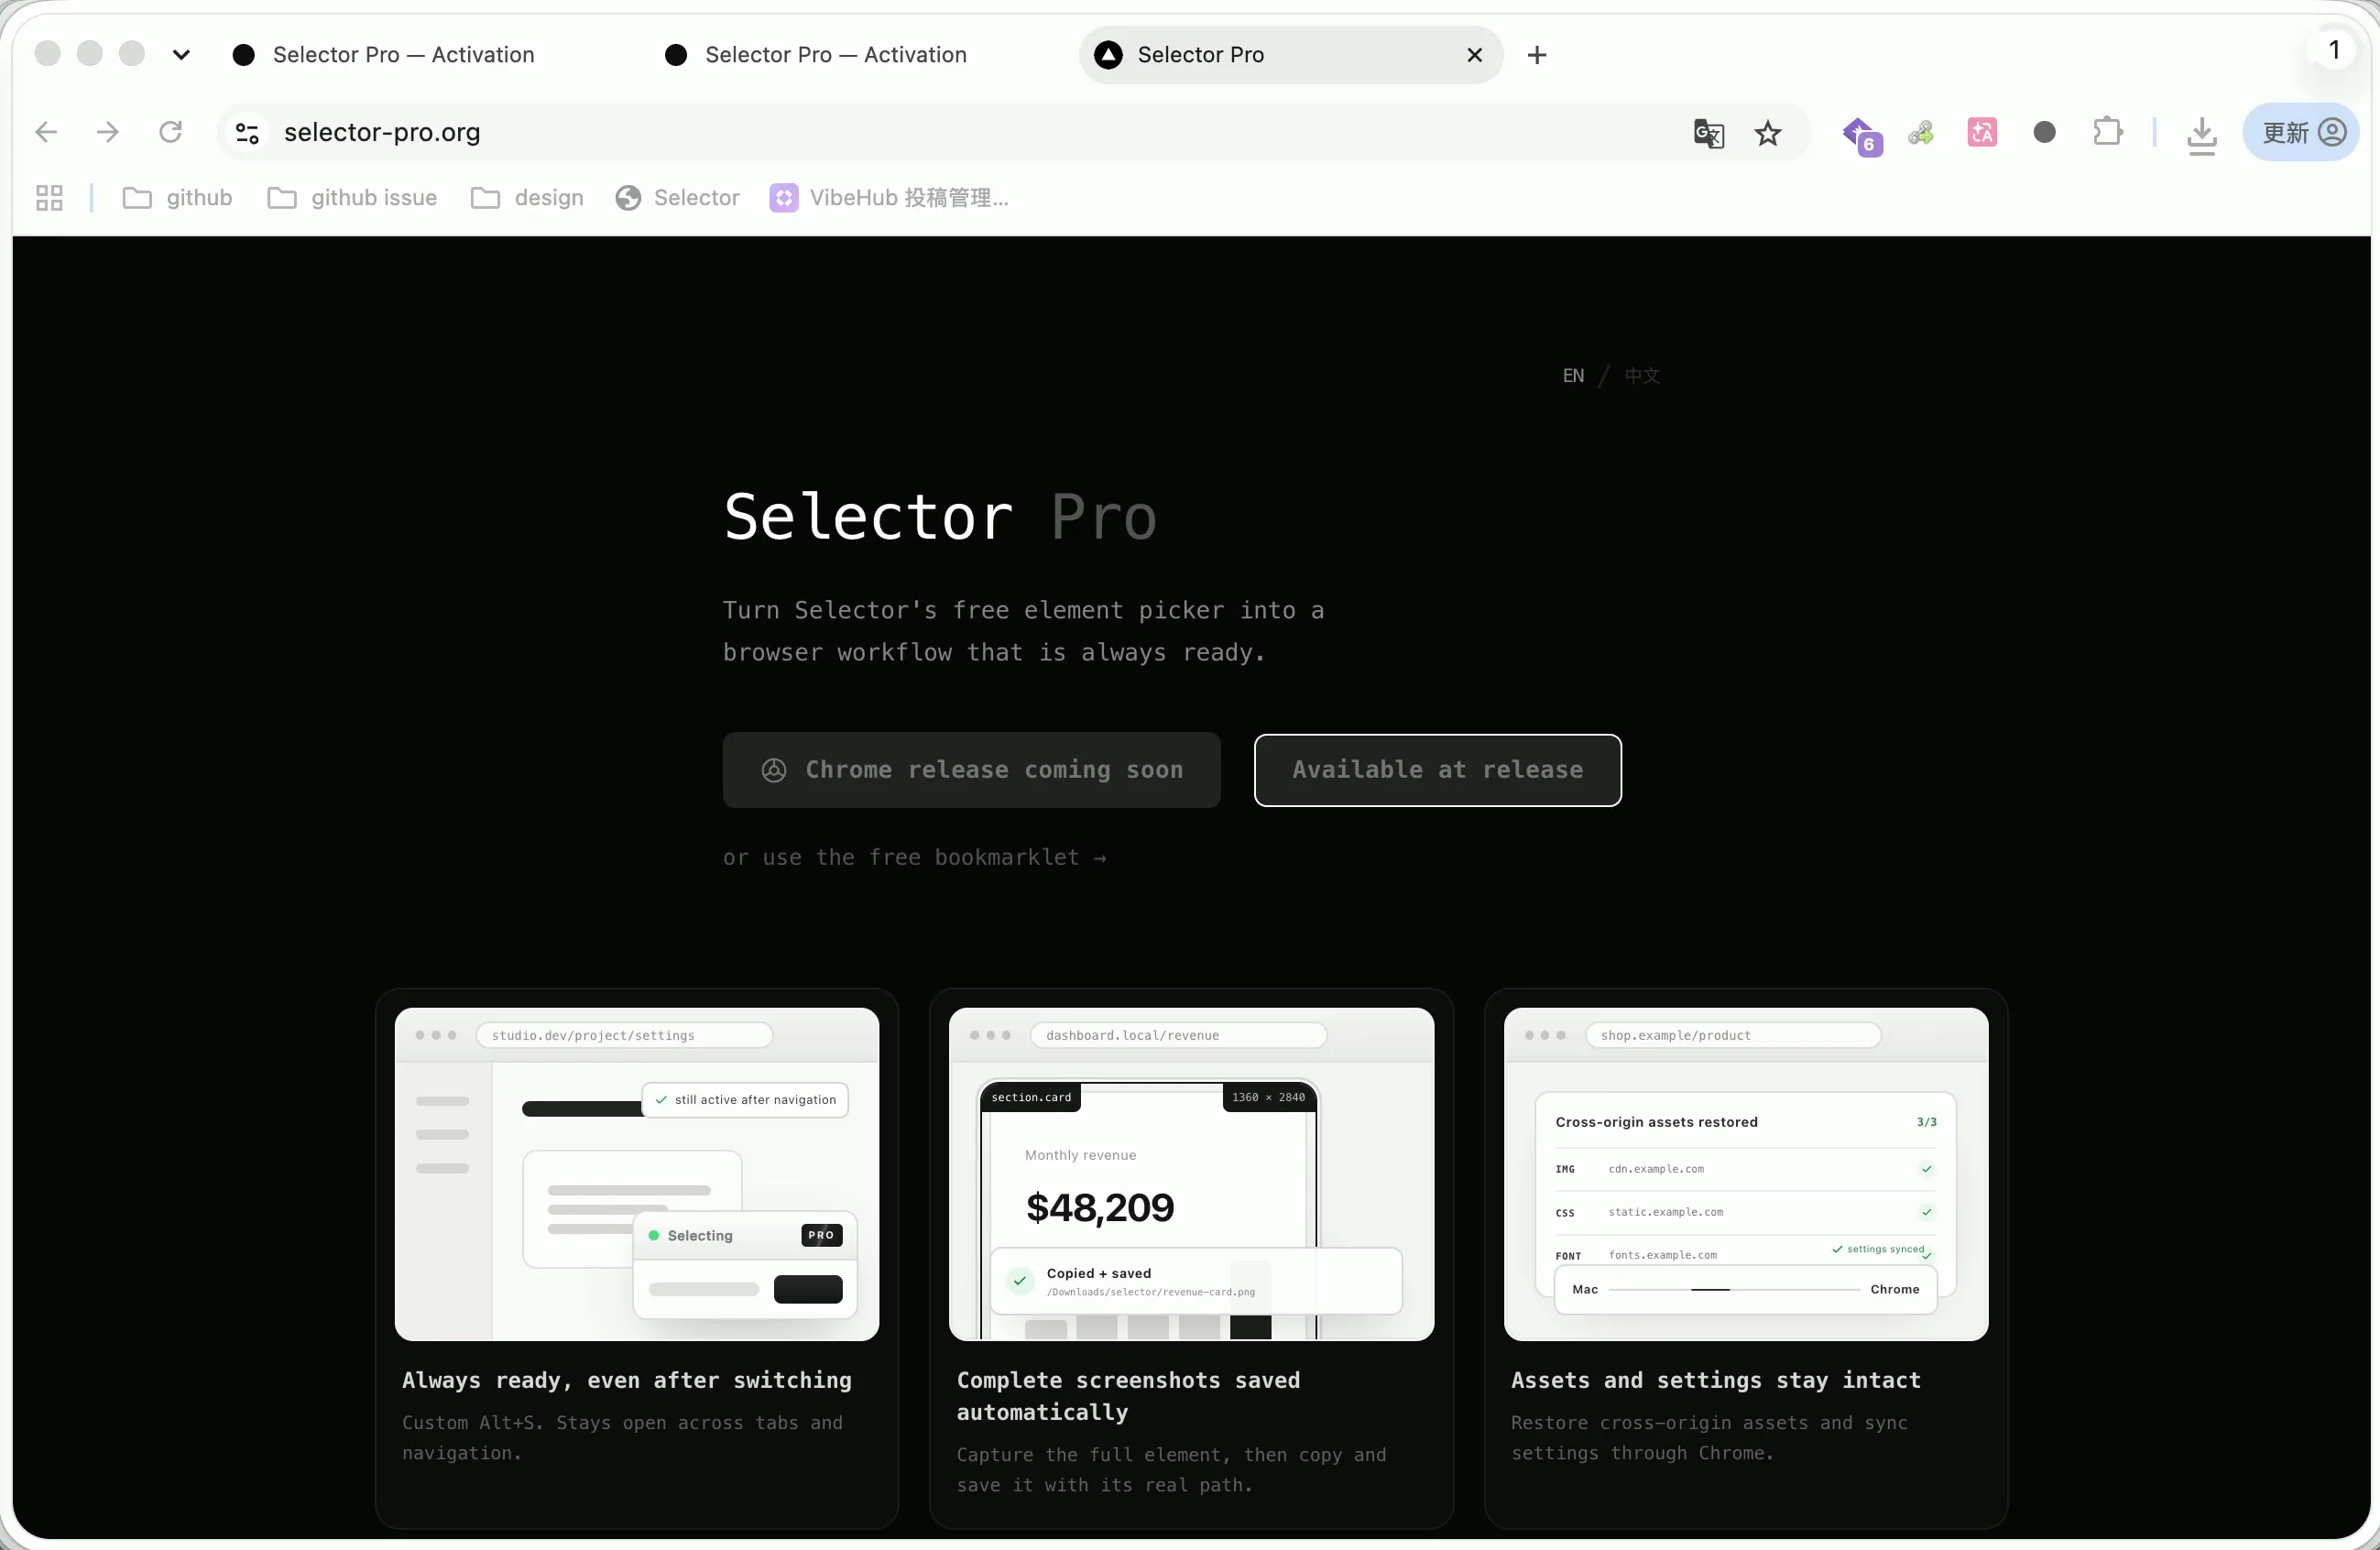
随后我在 Z Code 中接入了 Stripe 的 MCP 文档,把实际支付流程跑通。记录这次使用时,浏览器扩展还在审核阶段,后续是否上线不在当前文章中推断。
扩展形态主要解决的是使用场景受限的问题。原有的书签版本需要在每个页面单独唤起,Pro 版本则可以跨不同浏览器标签页保持运行状态,并支持配置全局快捷键。元素获取和截图操作在实际测试中也更加顺畅,这些是我在实际测试中观察到的变化。
最后一个边界:模型本身和工具链要分开看
完成这几项测试后,我个人最直接的判断是:如果任务属于前端页面设计和视觉排版,我会优先考虑交给 GLM-5.3。这个判断来自上面的实际生成表现,并不等同于官方对全场景能力的承诺。
实际使用中还有一个容易混淆的细节:GLM-5.3 本身并不具备原生视觉识别能力;但在 Z Code 的对话中,可以直接发送页面截图并圈选需要调整的区域。这是因为 Z Code 内置了视觉工具链,可以作为中介参与这条工作流。
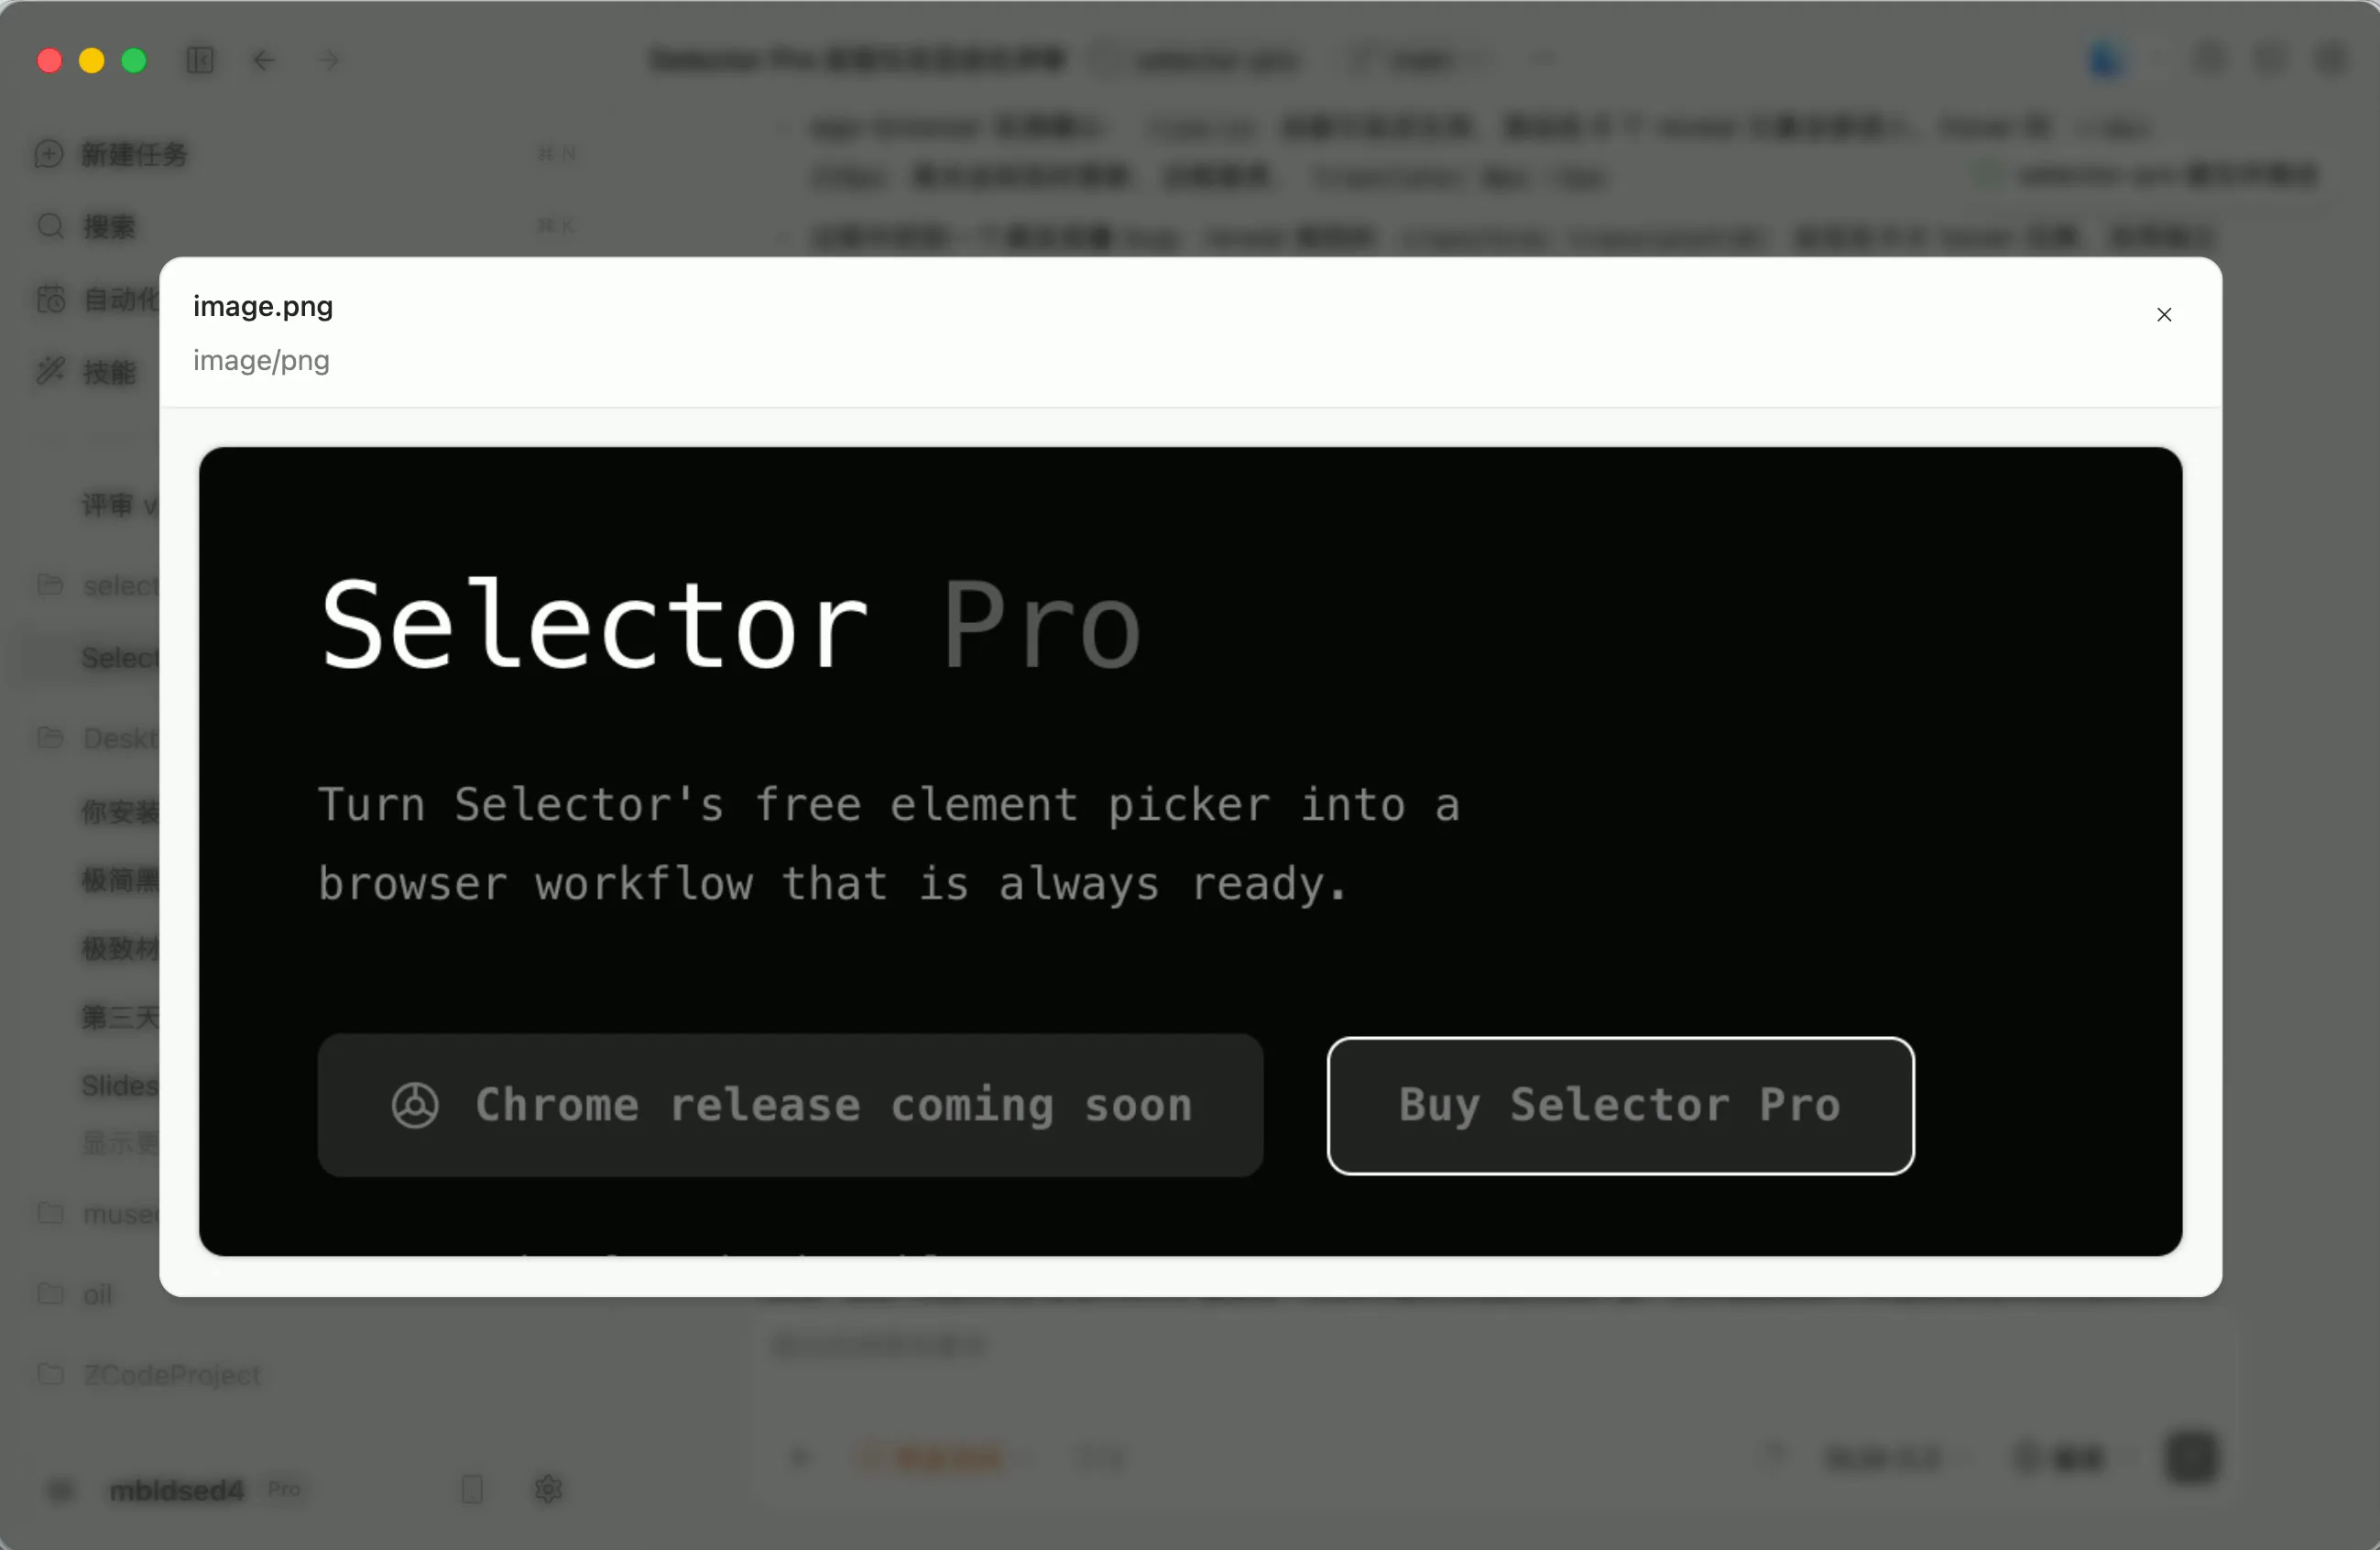
因此,“可以截图反馈”是模型配合编程开发环境后的综合体验,不能简化为“GLM-5.3 原生支持视觉输入”。把模型自身能力与外部工具链区分开来,才符合这次实测的真实边界。
这次实测涵盖了三类前端任务:用短提示词生成 HTML 页面、遵循 Skill 完成网页动画,以及参与浏览器扩展的实际开发。就实际体验而言,它在视觉质感、排版与微交互上的表现最突出;而在需要截图反馈的环节,则需要把 Z Code 提供的工具链一起算进去。