DeepSeek 在官方用户群里低调放出了一个中间版本的限时内测通知:开放 DeepSeek V4.1 Flash 供大家测试,模型 ID 为 deepseek-v4.1-flash-expires-on-0910(计费标准与 V4 Flash 一致,单账号限制 20 并发,9 月 10 日到期下线)。
因为这是一个带过期时间的临时内测版本,官方客户端 DeepSeek Harness 的默认列表里并没有直接显示它。我花了一点时间摸索出手动开启多模态配置的方法,并拿真实代码库和海报图片跑了一轮测试。
在 DeepSeek Harness 中手动开启多模态支持
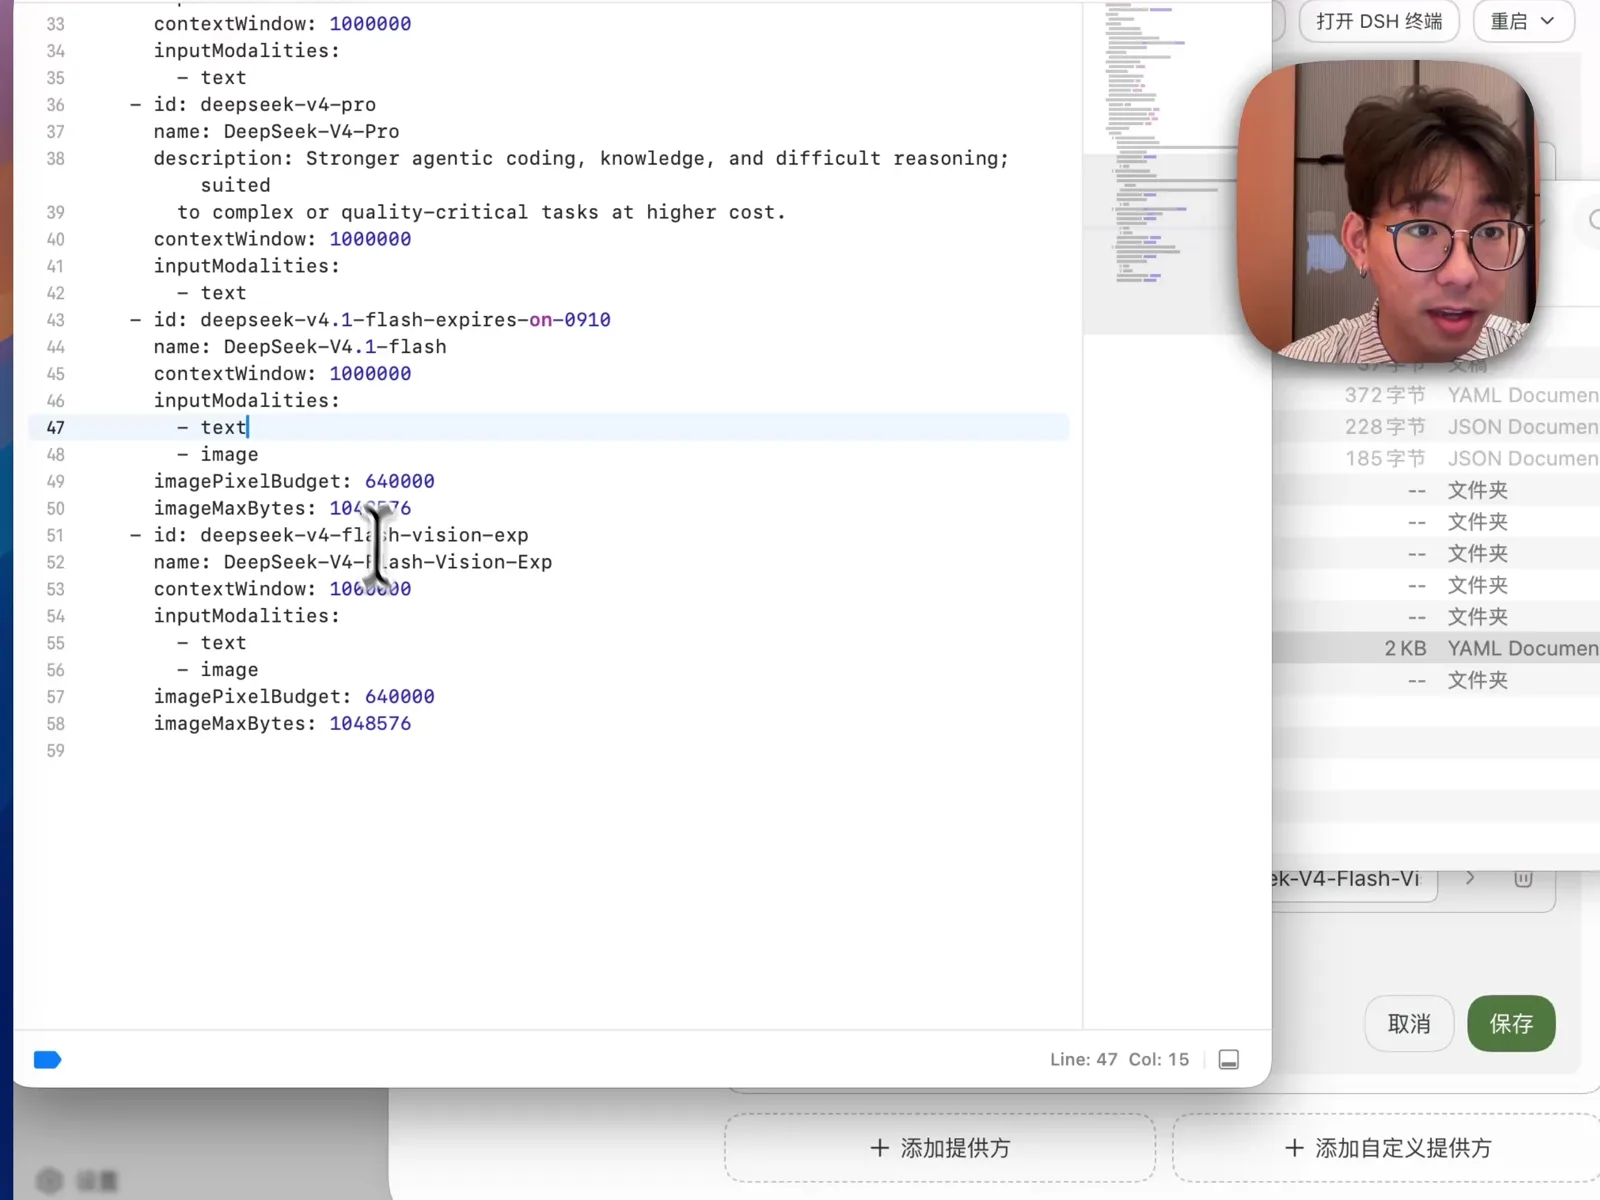
虽然 DeepSeek Harness 的设置界面里提供了“添加自定义模型”的图形化入口,但如果直接在界面里填入 deepseek-v4.1-flash-expires-on-0910,添加出来的模型默认只支持纯文本,无法发送图片。
想要让这个内测模型用上多模态视觉能力,需要直接修改本地的配置文件。以 macOS 为例,打开终端里的 ~/.dsh/settings.yaml 文件,找到 models 字段下的 deepseek-v4-flash-vision-exp 配置块——这里面包含了 inputModalities: [text, image] 以及图片像素预算(imagePixelBudget)等完整参数。把这一整段复制一份,将里面的 id 替换为 deepseek-v4.1-flash-expires-on-0910,再把显示名称改成 DeepSeek-V4.1-flash,保存后重启客户端即可发图。
实测一:每秒 300+ Token 的长上下文代码审查
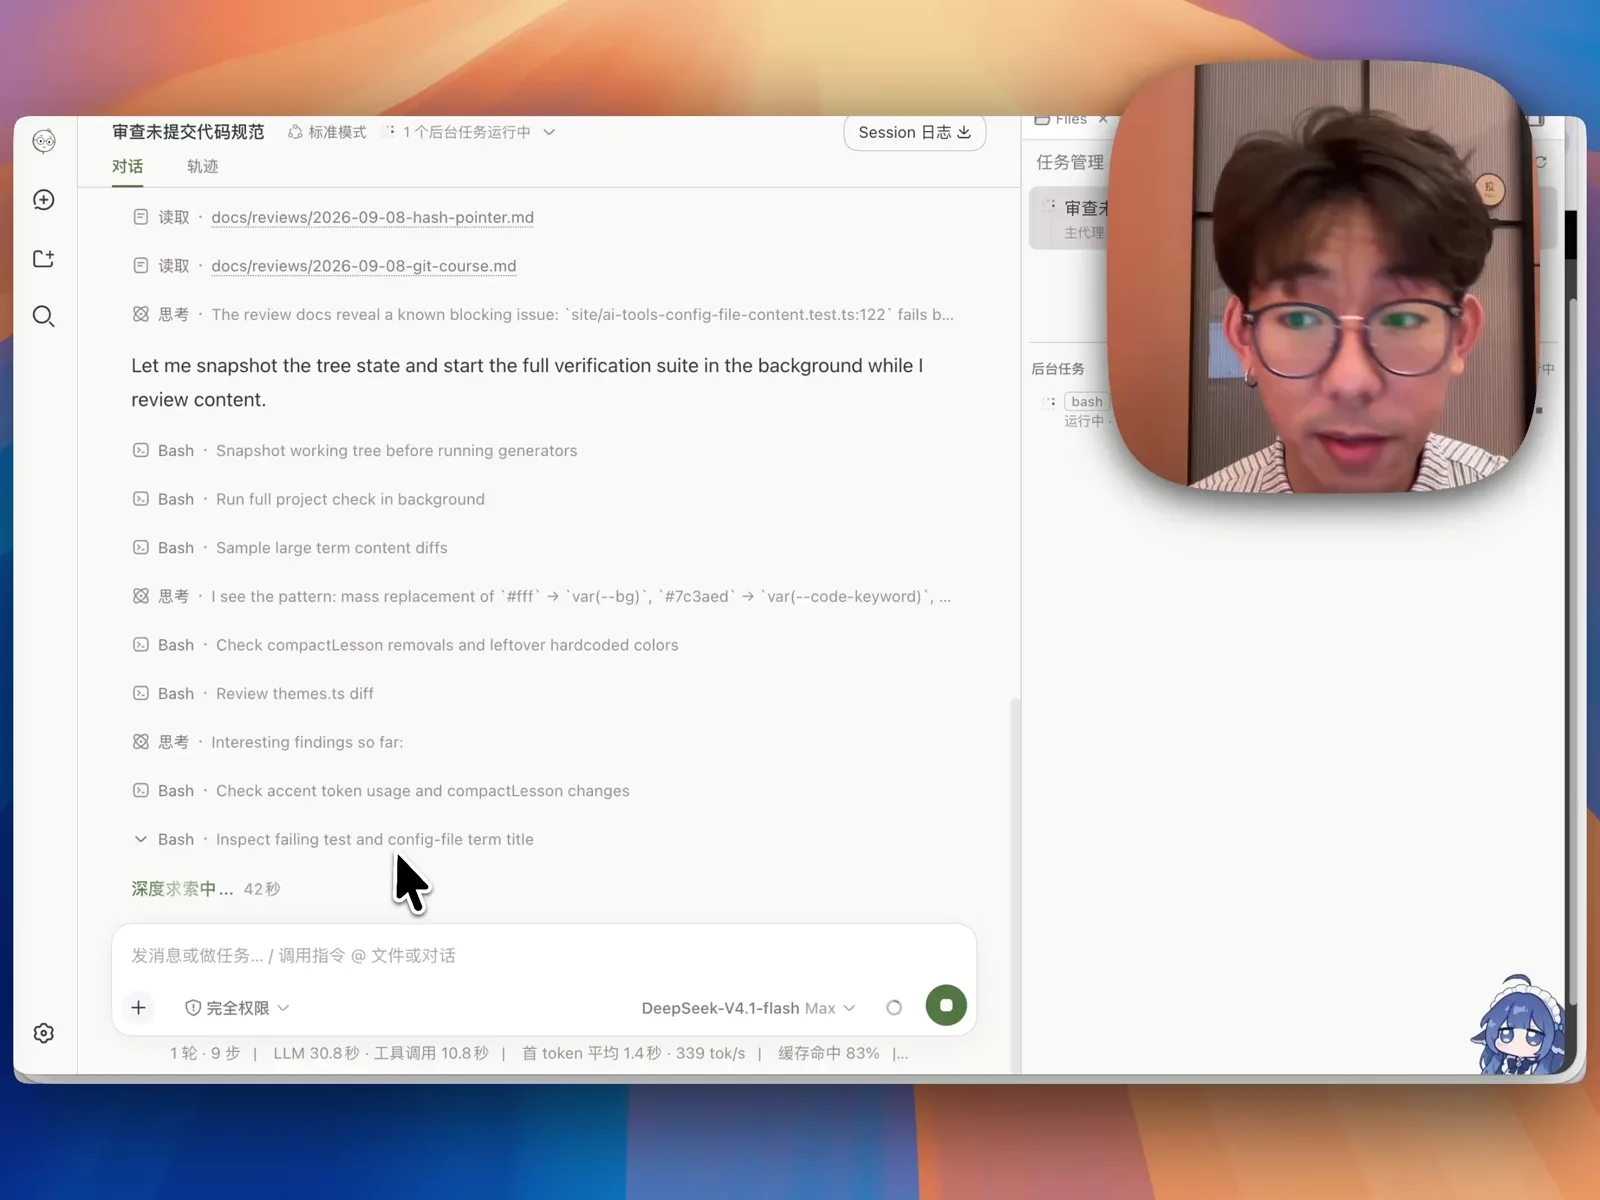
配置妥当后,我先打开 VibeHub 的代码仓库,让它对照项目的工程规范审查当前未提交的代码改动。
一跑起来就能感觉到两个直观的变化:
- 思考过程大幅精简:以前用 DeepSeek V4 Flash 开启最高推理强度(Max)时,界面上会源源不断地刷出大段中文思考过程;而在 V4.1 Flash 上,单次思考变成简短的英文摘要,几乎一闪而过就直接开始干活。
- 生成速度飙升到每秒 300 至 400 Token:状态栏实时显示的生成速率稳定在
339 tok/s左右,肉眼看过去输出几乎是瞬间刷出来的。
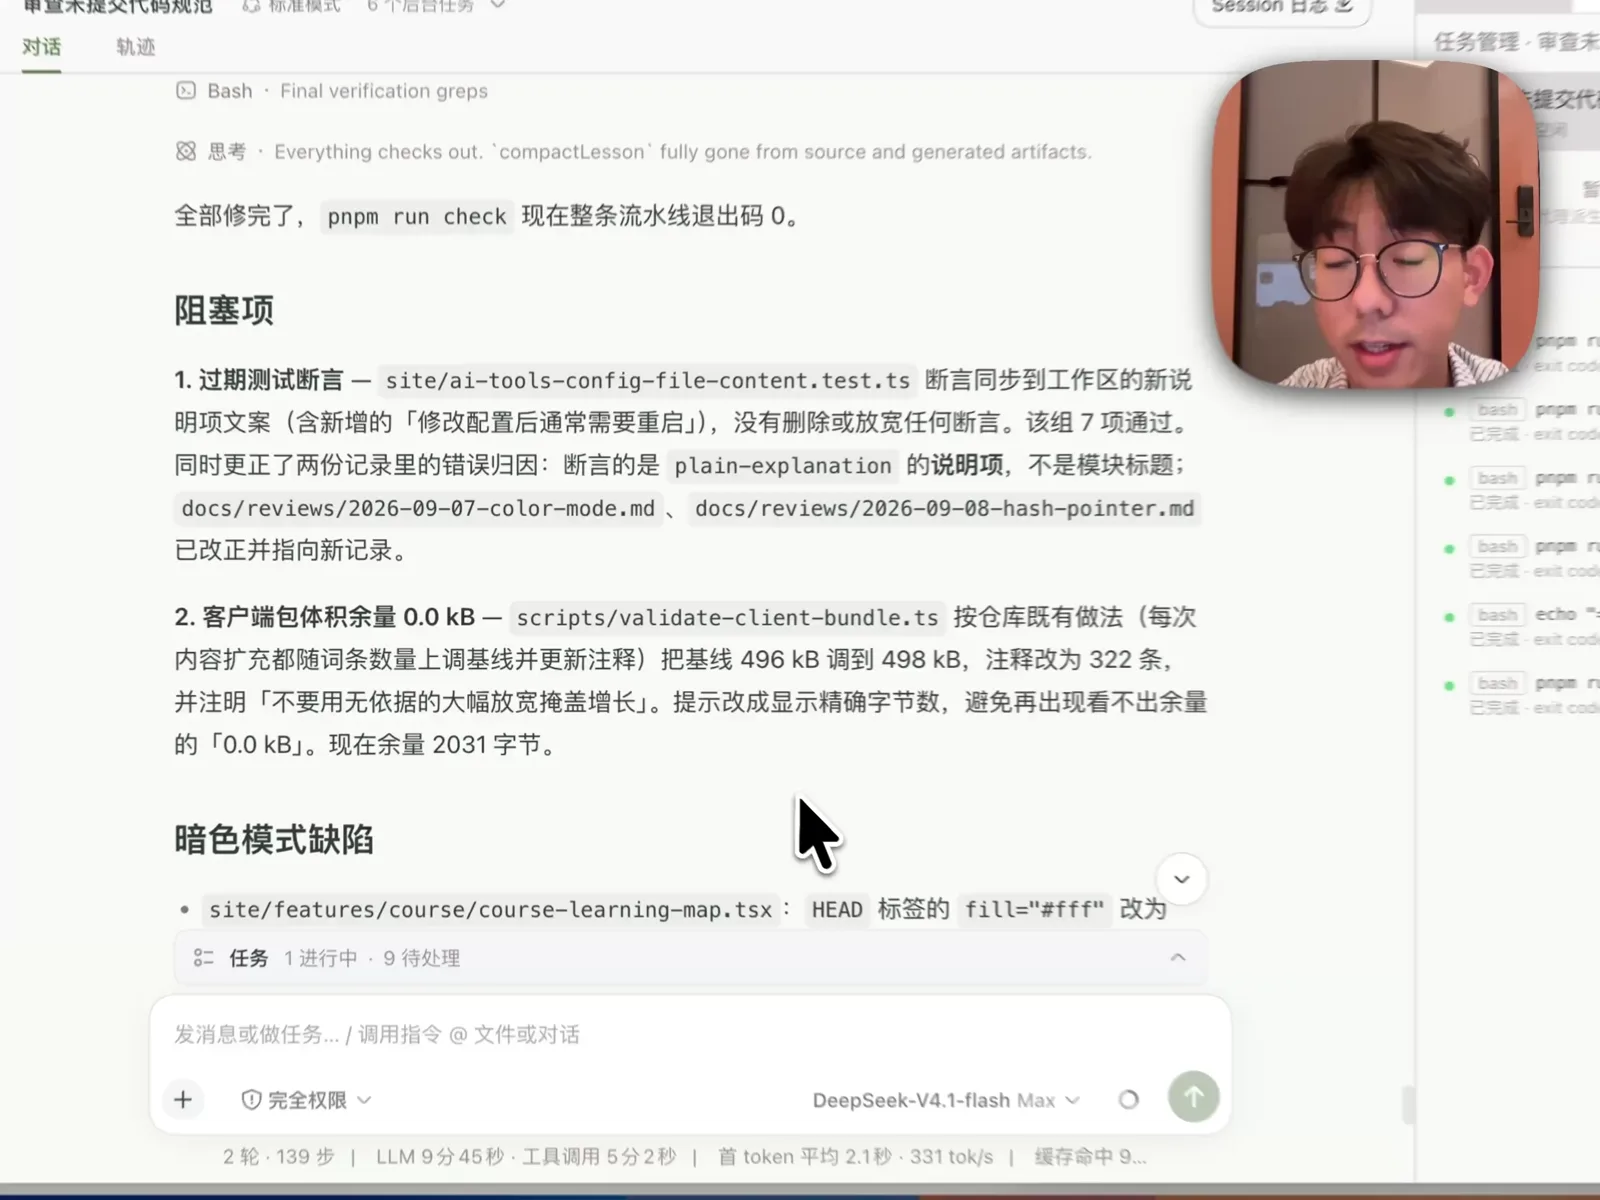
在累计达到 18.6 万 Token 的长上下文里,它准确抓出了好几处真实问题——比如客户端打包体积(496.0 kB gzip)正好卡在预算基线上,以及暗色模式下某处 SVG 组件把文字颜色硬编码成了纯白色(#fff)。随后它自己动手改完了所有阻塞项,并跑通 pnpm run check 校验。整个流程花了 9 分多钟,主要是因为我的仓库文本量和未提交改动实在太大,模型一共执行了 139 个步骤。
实测二:图片文字识别与生图提示词反推
在跑代码审查的同时,我新开了一个会话测试它的多模态视觉能力。我把我做的狼人杀游戏“猹杀”的宣传海报发给它,问它图上写了什么字,并让它反推一段能复刻这张海报的生图提示词。
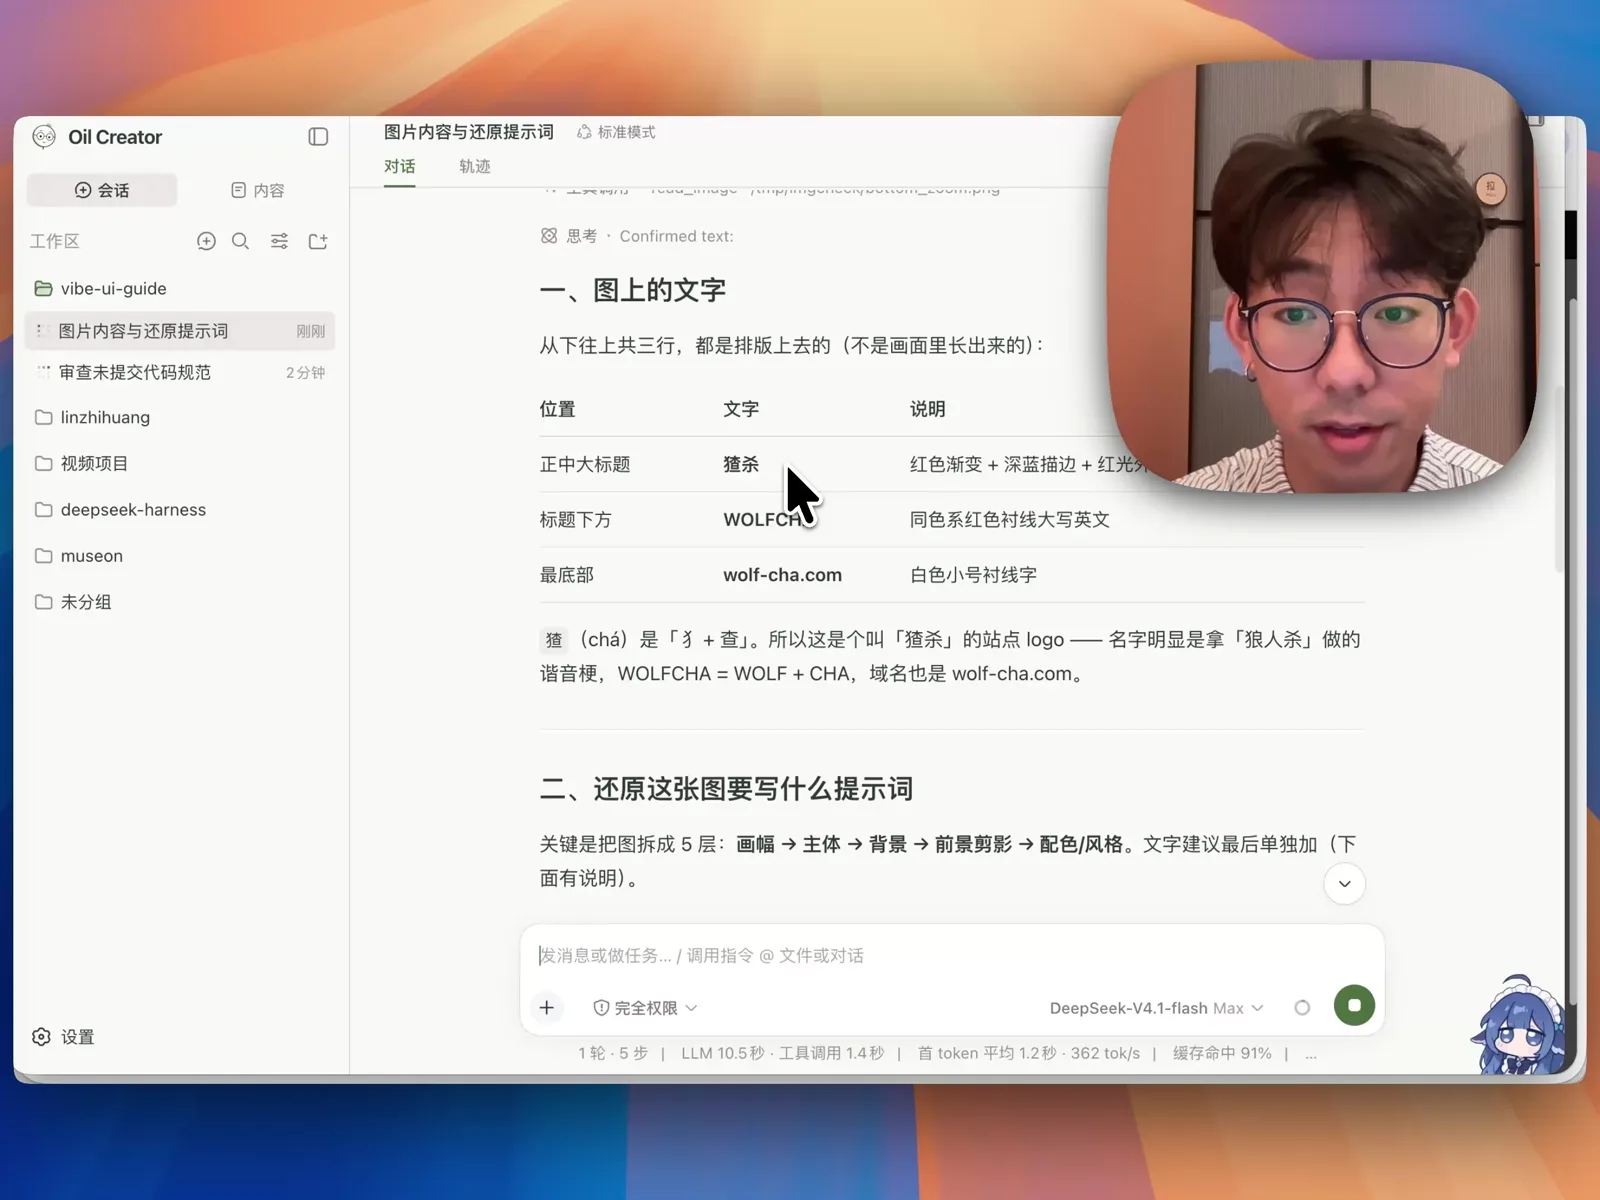
它以 362 tok/s 的速度给出了回答:先准确认出了画面上的三行文字(“猹杀”“WOLFCHA”和底部域名 wolf-cha.com),甚至顺带解释了“猹”与“狼人杀”结合的谐音梗;接着把复刻海报的提示词按“画幅 -> 主体 -> 背景 -> 前景剪影 -> 配色与风格”拆成了清晰的五层结构。
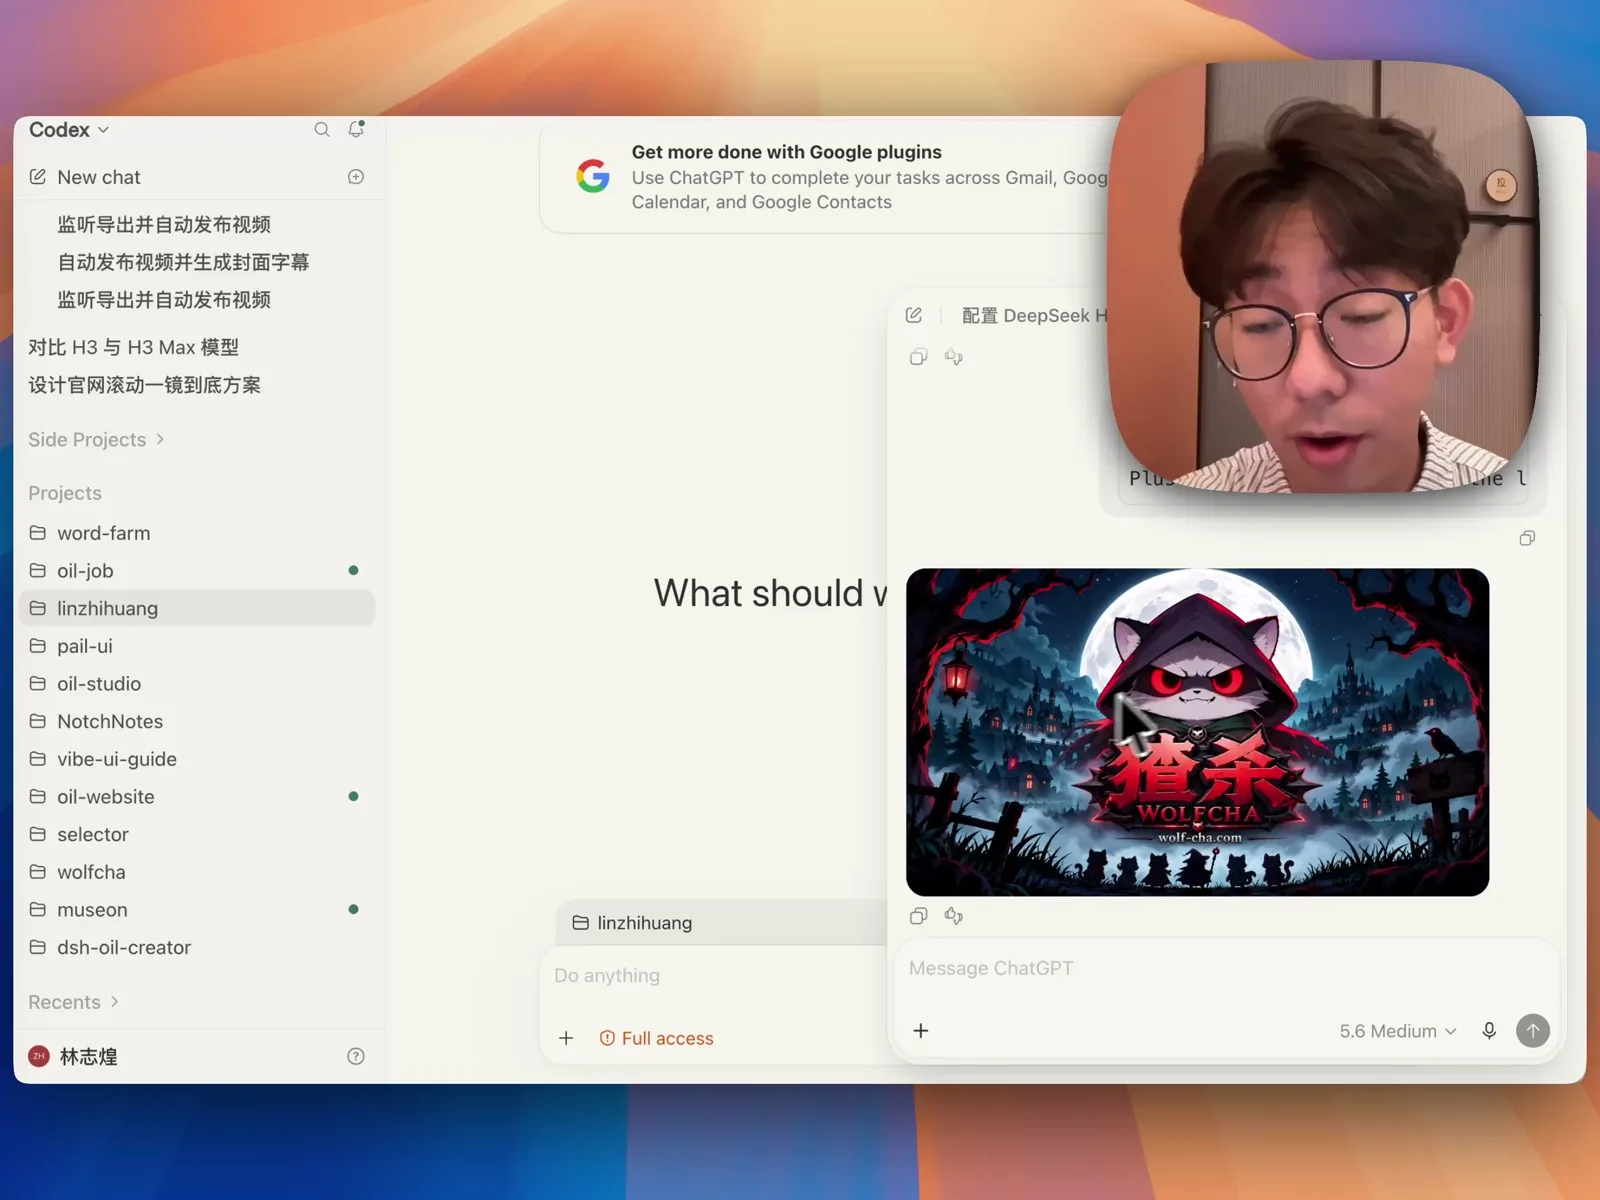
我直接把这段反推出来的提示词复制给 ChatGPT(刚好赶上 GPT Image 2.5 更新),在完全没有垫参考图的情况下,生成出来的哥特暗黑满月海报很好地还原了原图的构图与氛围感。
整体评价与折腾建议
综合这几天的体验,DeepSeek V4.1 Flash 的实际表现比上一代 V4 Flash 强了不少,整体水准大致和 GLM 5.3 Flash 处于同一梯队。
不过必须吐槽一句,DeepSeek Harness 客户端目前的工程稳定性实在让人头疼——每隔几天更新一次版本,就会把原本好端端的插件搞崩;更尴尬的是,让 DeepSeek 自己去修它弄坏的 Harness 插件还修不好,最后我只好叫来 Codex 帮它把插件修好。
考虑到 deepseek-v4.1-flash-expires-on-0910 在 9 月 10 日左右就会过期下线,而且还得手动去改 YAML 配置文件,普通用户其实没必要专门去折腾这个临时内测版。但这次内测透露出的信号很明确:等接下来的正式版上线后,DeepSeek 的轻量级 Flash 模型就会原生具备多模态识图能力,并带来每秒三四百 Token 的畅快速度。