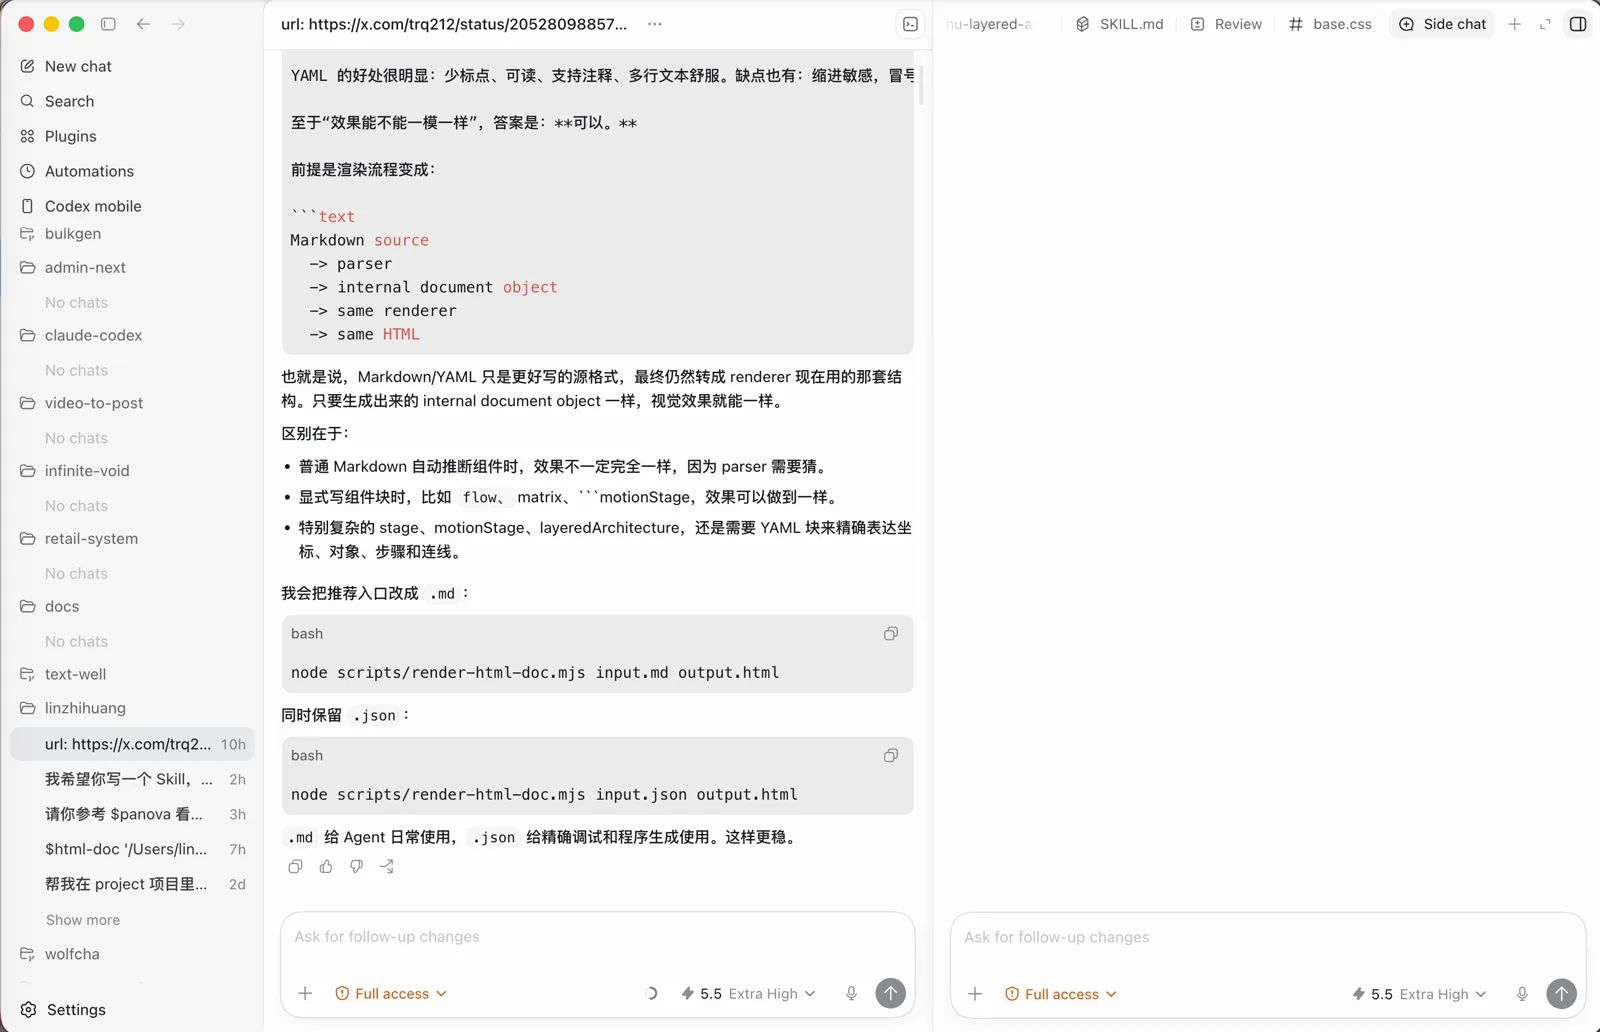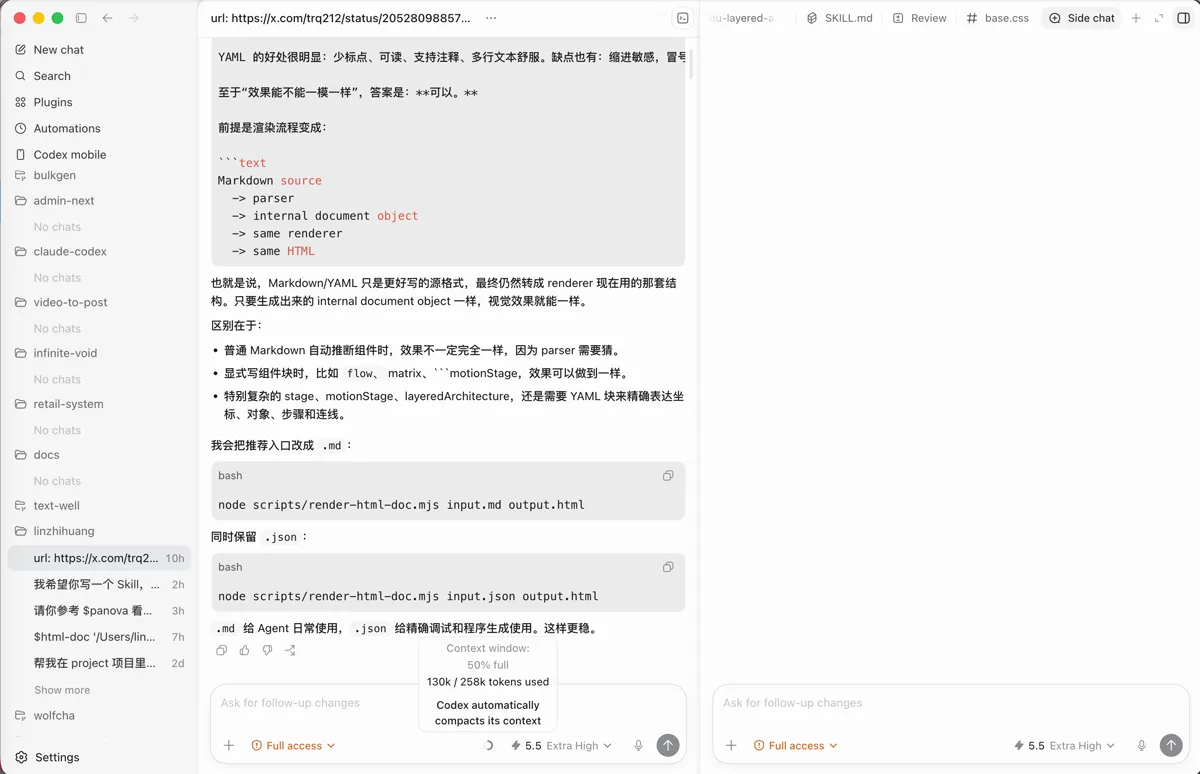
GPT-5.5 刚发布的时候,我推荐过 GPT-5.5 加 Codex 这个编程组合。随着 Codex 最近的产品迭代,我认为它的表现已经比 Claude Code 加 Claude 模型更好,价格更便宜,风控政策也没有那么严格。
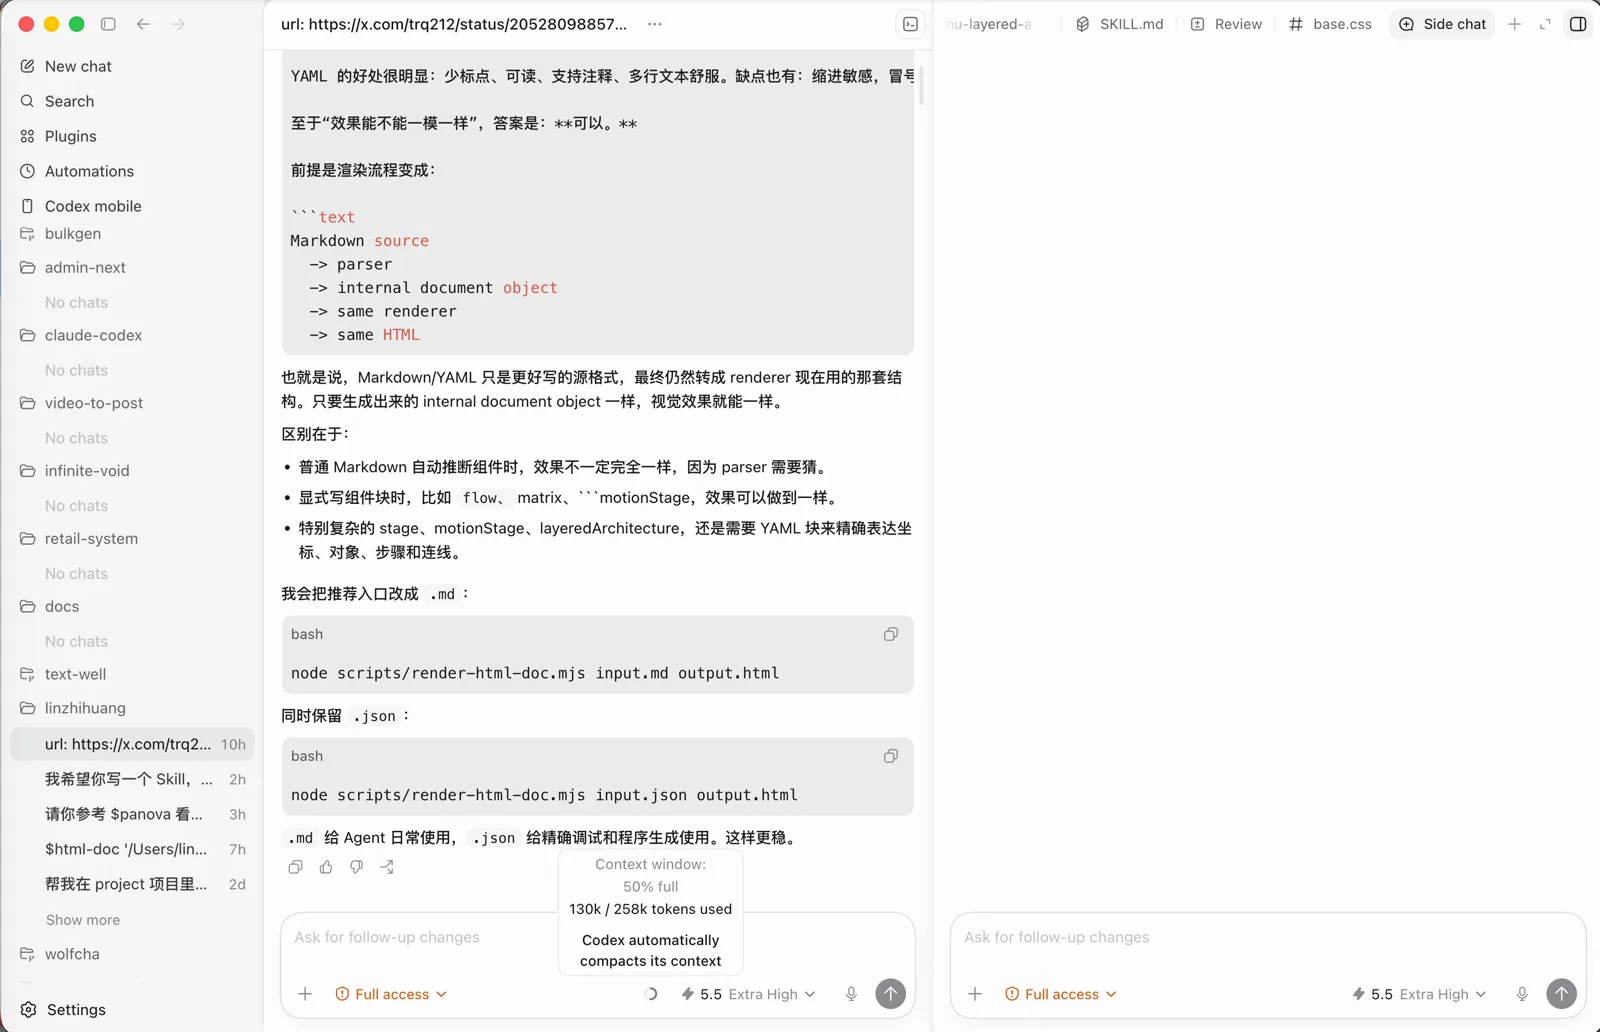
它目前比较大的短板是上下文长度。GPT-5.5 在 Codex 里只开放 20 多万的上下文,100 万上下文要走 API 才能用到。日常使用中,多问几个问题上下文就接近上限了。针对这个问题,我有三个应对技巧。
检查 Plugin 带进来的 Skill
第一个技巧是检查 Plugins 页面里开启的插件。我发现每开启一个 Plugin,它会带进来很多 Skill。
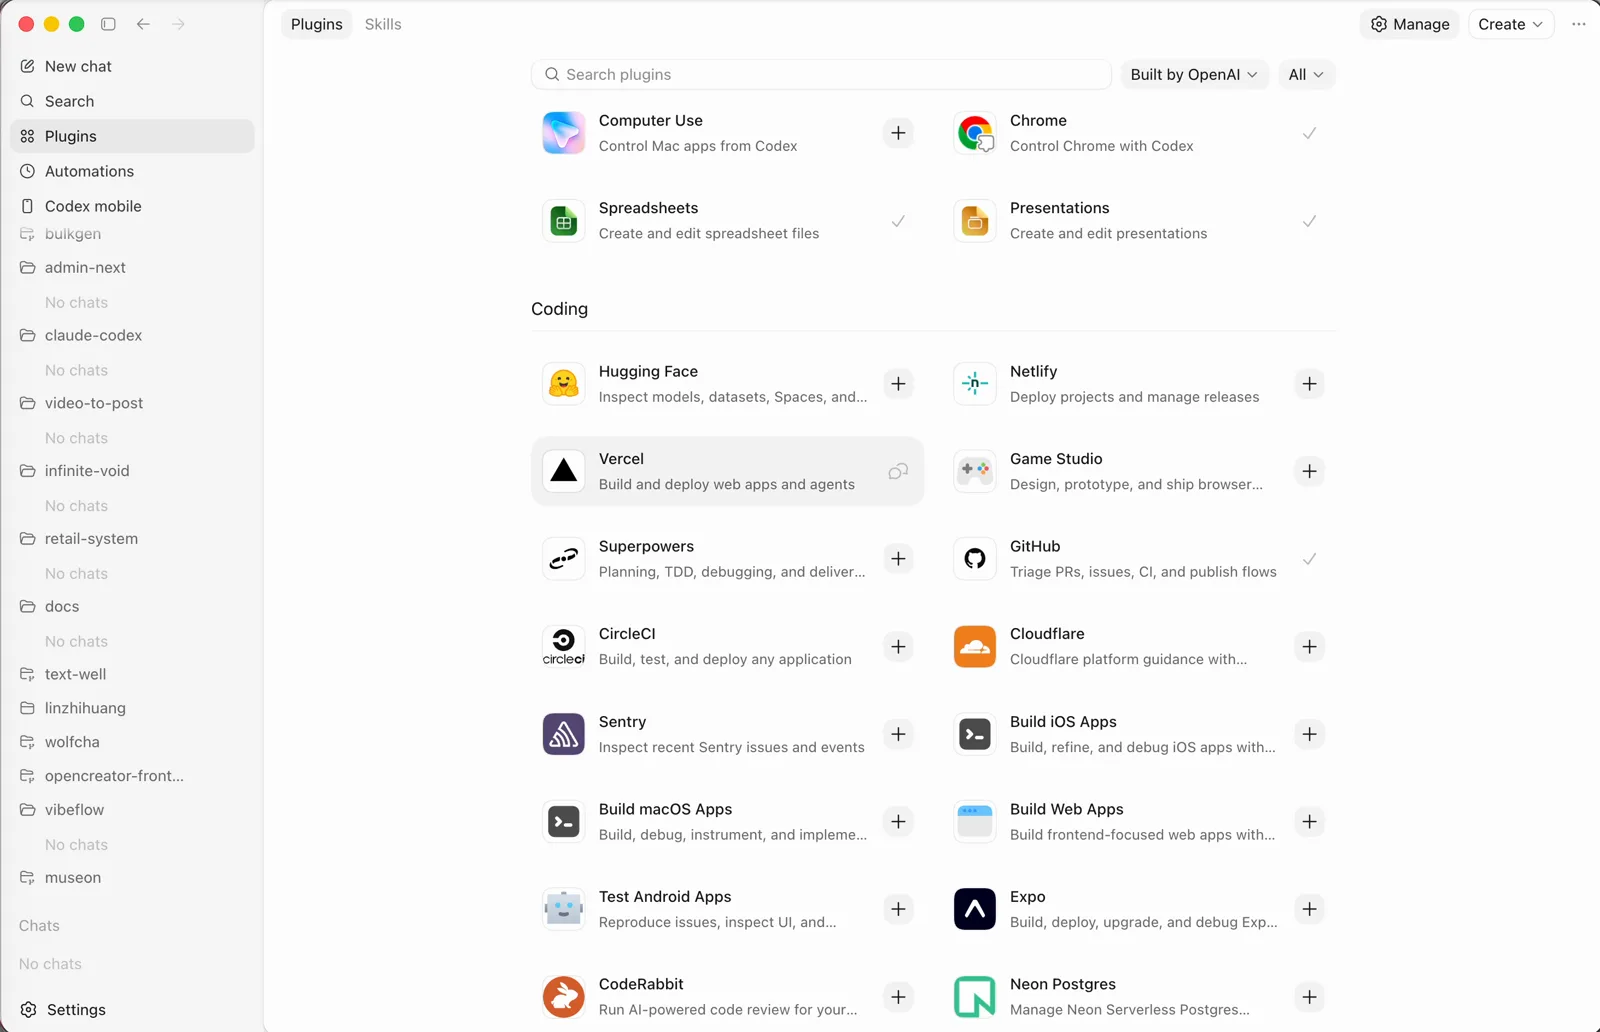
以 Vercel 的 Plugin 为例。开启它的初衷可能只是让 Codex 拿到 Vercel 的部署信息和日志,但点进详情可以看到,它把 Vercel 旗下所有产品的 Skill 都打包了进来。虽然每个 Skill 可以手动关闭,但如果不点进详情,很难发现一个插件带了这么多东西。
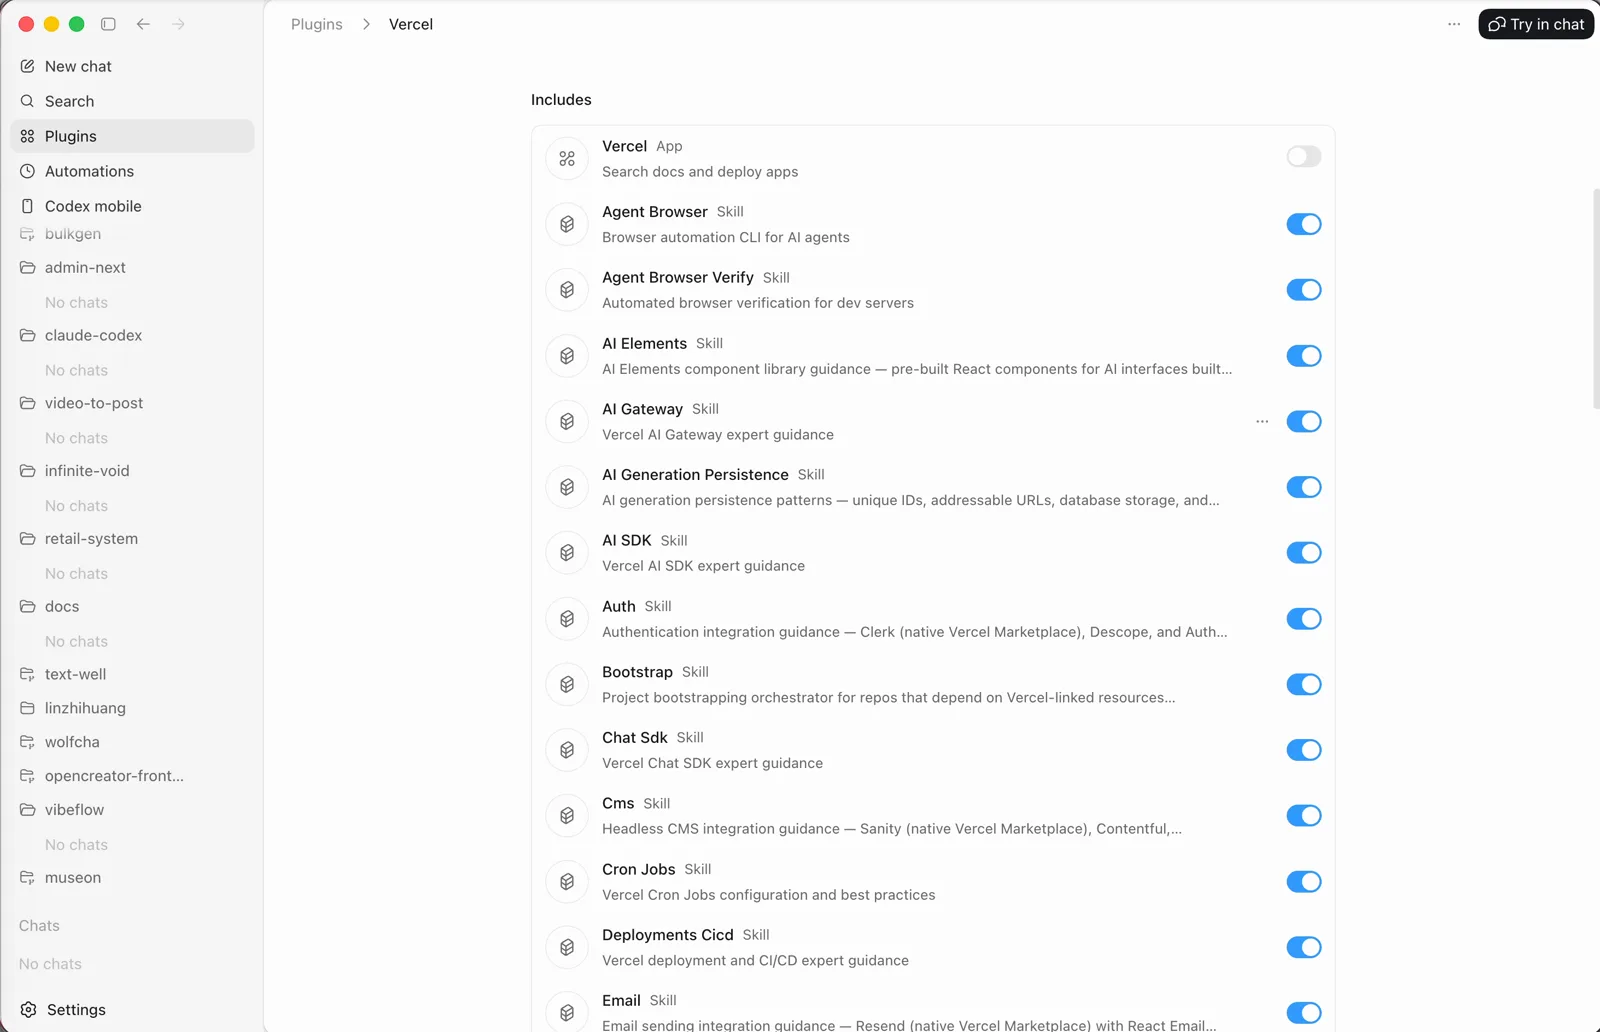
多开几个这样的插件,Skill 数量会快速膨胀。Skill 太多相当于没有 Skill:Agent 面对一大堆描述,很难准确选中该用的那个,基本只能靠我们主动触发。另外,每个 Skill 的描述都会进入上下文,几十上百个 Skill 每次对话都会多带几千个无关的 token。
所以我会定期整理自己的 Skill,也建议大家检查一下自己的 Plugin,关闭那些没注意到、但实际上用不到的 Skill。Skill 不是越多越好,越符合自己的使用场景越好。
用 explore Skill 让子 Agent 先定位代码
第二个技巧和对话过程有关。Claude Code 在需要查看较多代码时,会调用 Explore 子 Agent:子 Agent 负责搜索关键词、确定代码路径,把可能的代码范围交给主 Agent,主 Agent 不需要自己翻遍整个仓库。
Codex 很少主动调用子 Agent,除非我们明确要求。如果仓库比较大,它自己找代码位置可能就要消耗十几万上下文。我按照 Claude Code 的 Explore 设计,自己写了一个 Codex 的 Skill,也叫 Explore。触发之后,它会先让子 Agent 找到关键代码位置,主 Agent 只看子 Agent 交回的结果,这部分上下文可能只有几千,然后再根据结果细看代码。刚开启一段对话时,这个开销会小很多。
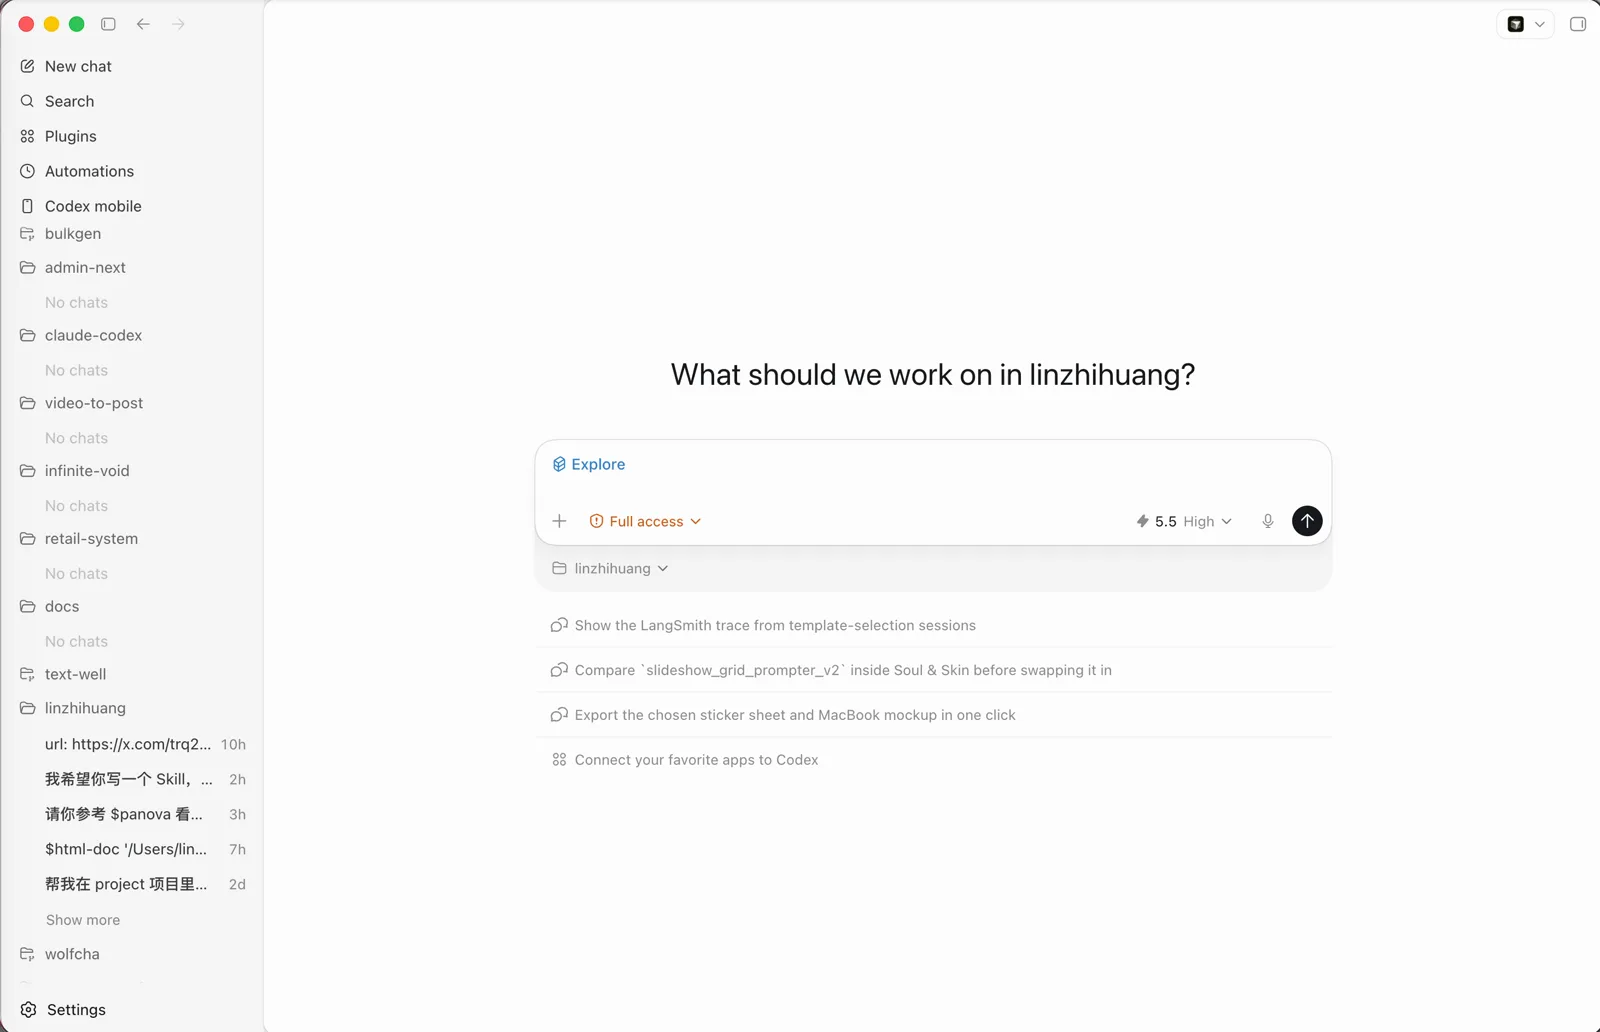
这个 Skill 已经开源,仓库是 codex-explore-skill,可以直接把 GitHub 链接丢给 Codex 安装,也可以手动克隆到 skills 目录:
git clone https://github.com/oil-oil/codex-explore-skill.git ~/.codex/skills/explore
安装之后,每次刚开始对话时,可以主动让它先调用 Explore 查看代码位置,再继续提需求。
用 /side 开启独立的侧边对话
第三个技巧针对的是 Codex 的回滚限制。Codex 目前只能编辑当前这条消息,不能像 Claude Code 或者 Cursor 那样回滚到之前的任意状态,这是它产品上还需要优化的地方。所以每个问题提出去之前,需要想清楚。
对话过程中还有一种情况:改代码改到一半,突然想问一个和后续任务不太相关的问题。这种问题写进主对话,会污染上下文,让里面多出一部分对执行任务没有帮助的内容。Claude Code 里有一个 btw 命令处理这种场景,Codex 里也支持基于当前上下文切出一个新对话,命令是 /side。
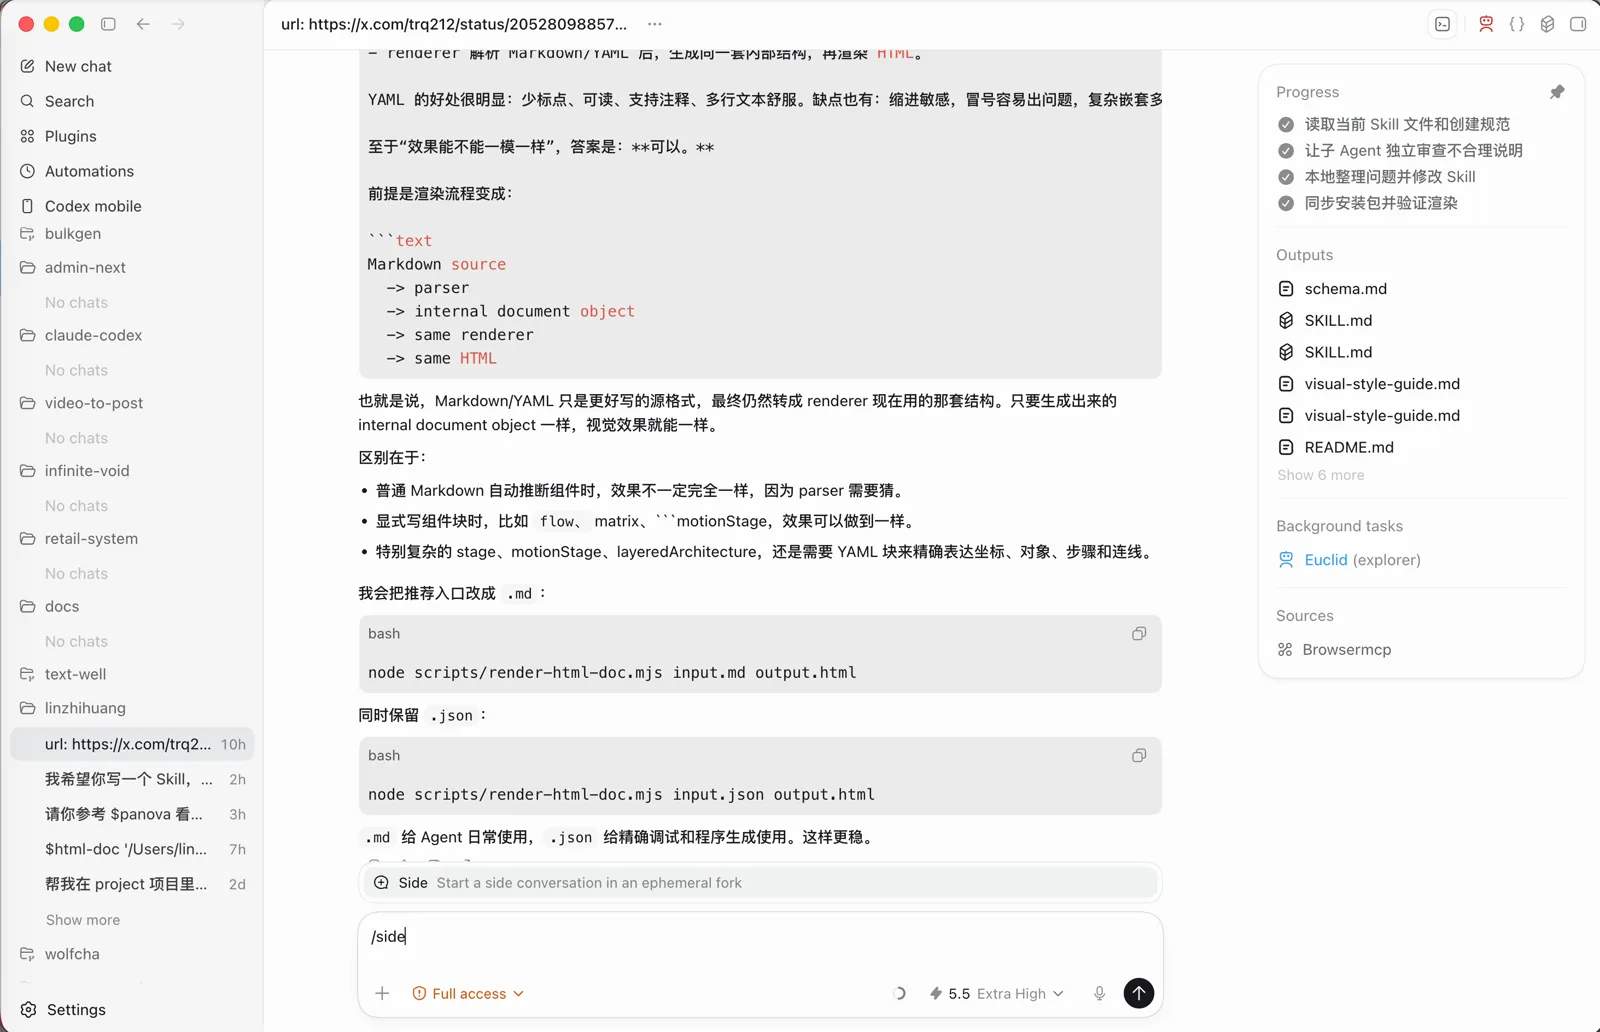
输入 /side 之后,右侧会新开一个会话。它继承了主对话的上下文信息,但在这里的对话不会进入主对话,两边是相互独立的。
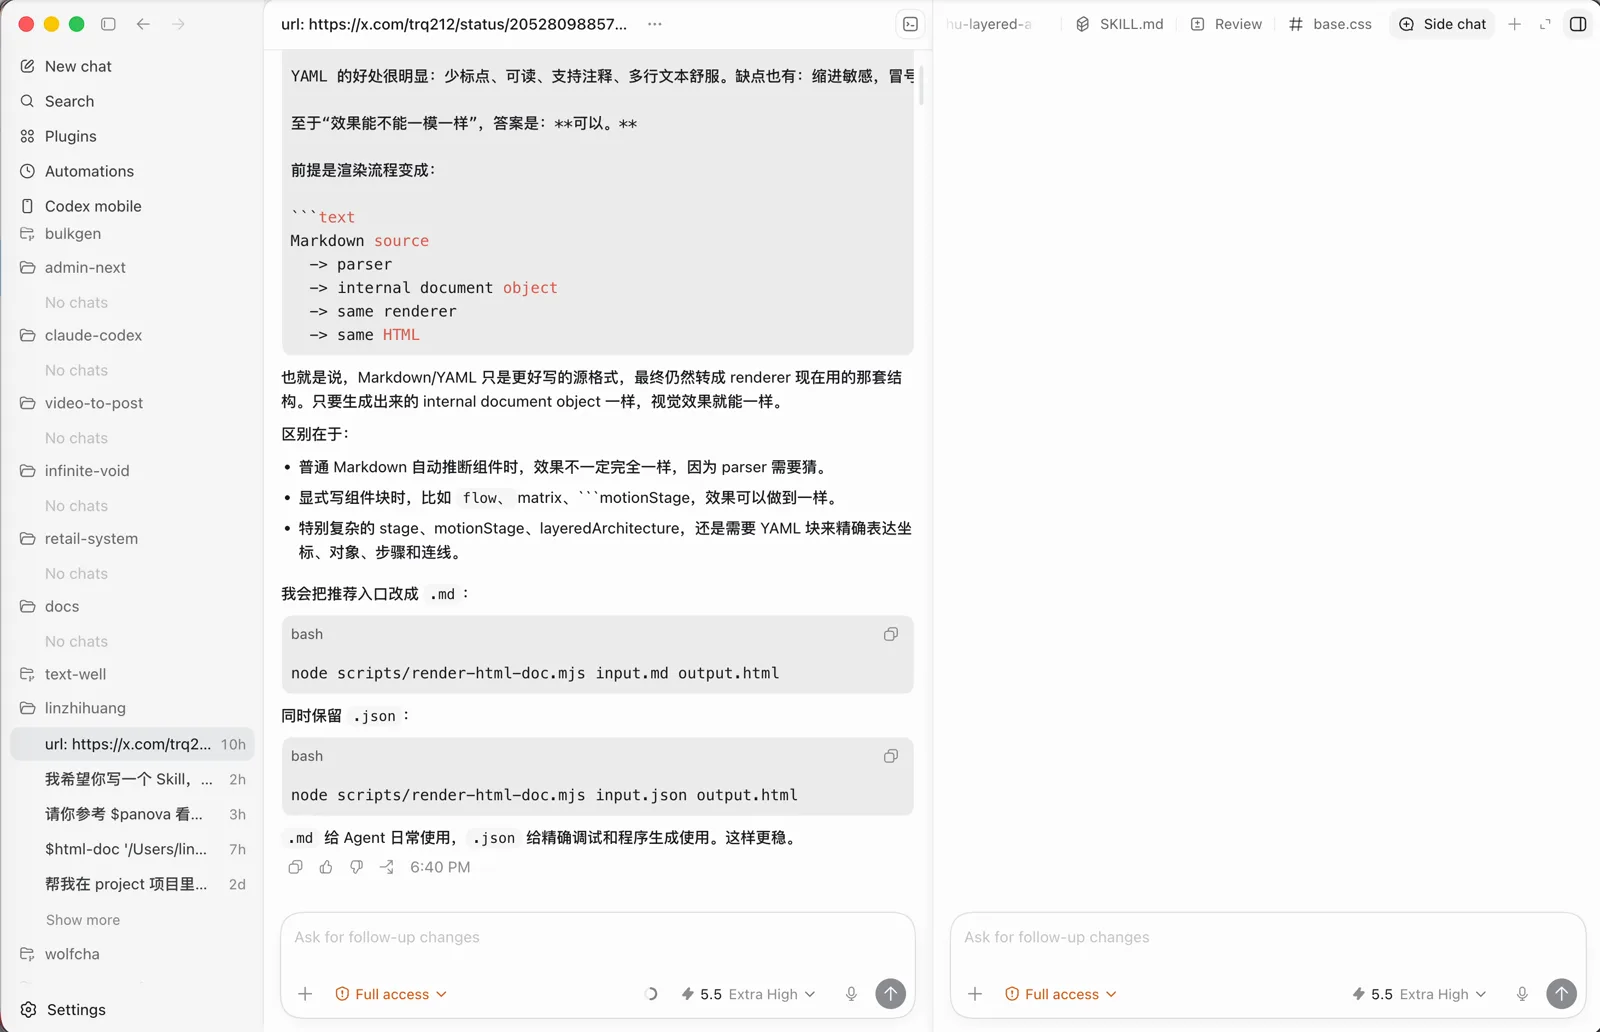
除了临时提问,这个姿势也可以用来并行执行任务:等 Agent 探索了足够的代码、上下文比较丰富之后,左侧执行一部分任务,右侧执行另一部分。我自己日常用得比较多。