最近 Claude 把 100 万上下文正式开放给了 Opus 4.6 和 Sonnet 4.6。在这之前,这两个模型默认是 20 万上下文,要开启 100 万上下文需要按更高的价格计费。正式开放之后,100 万上下文不再额外收费,按标准价格计费,缓存也照常生效。
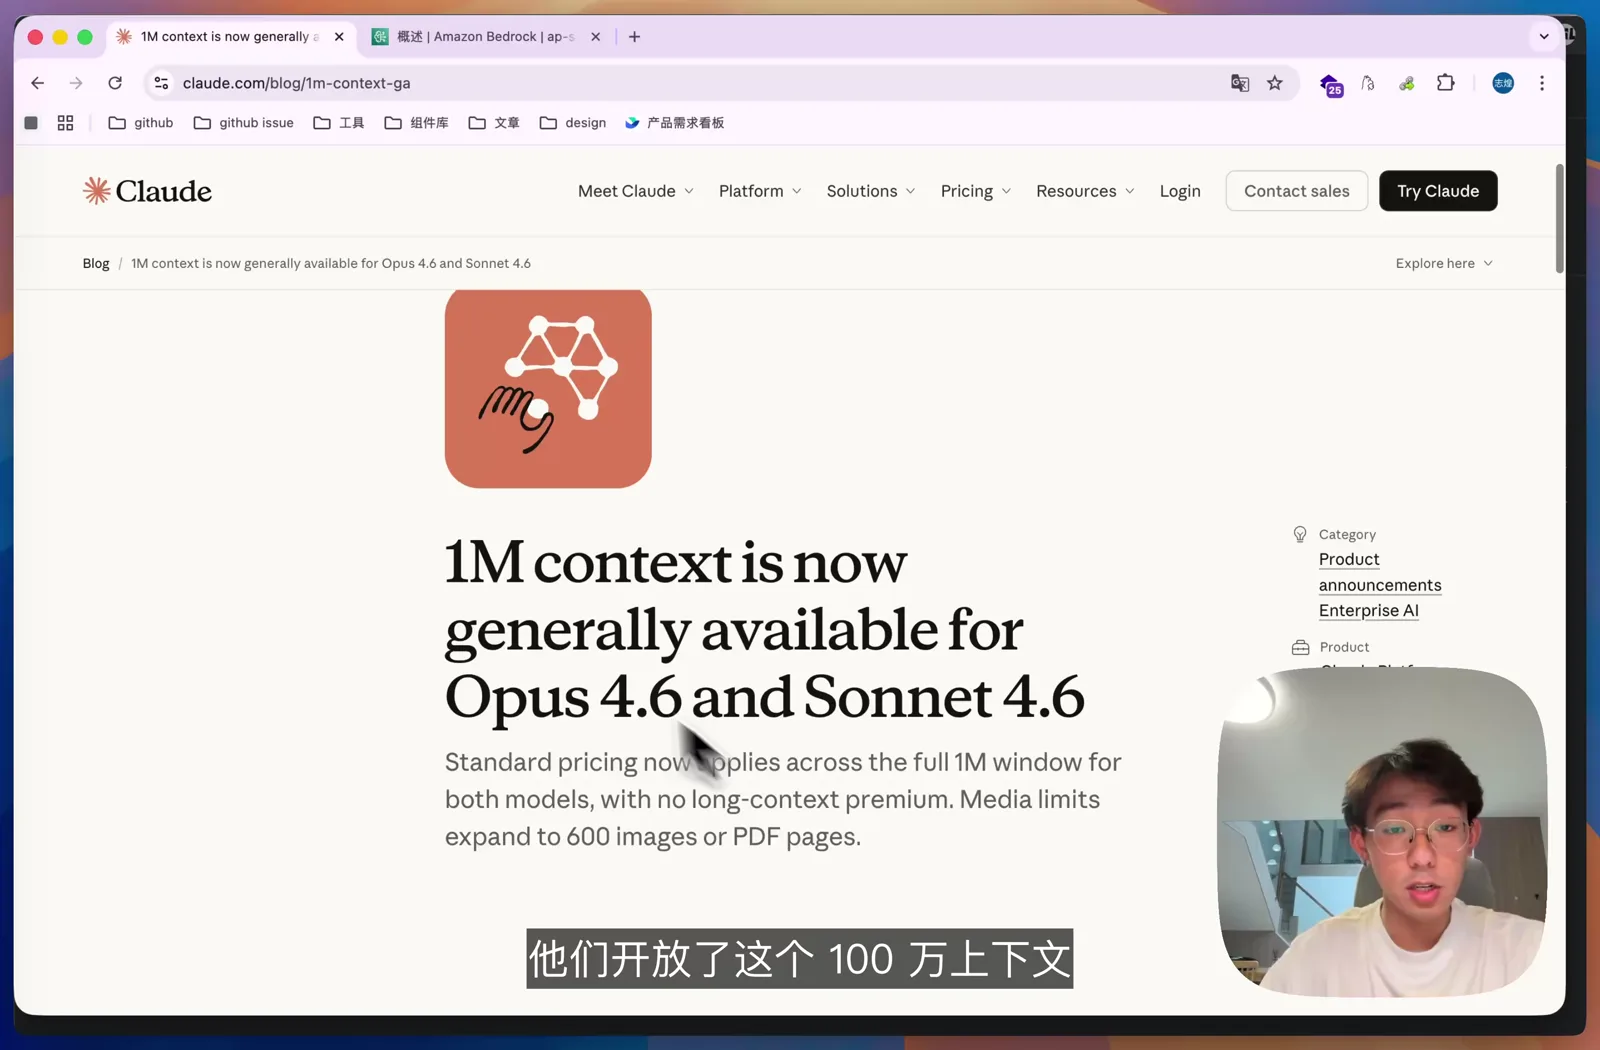
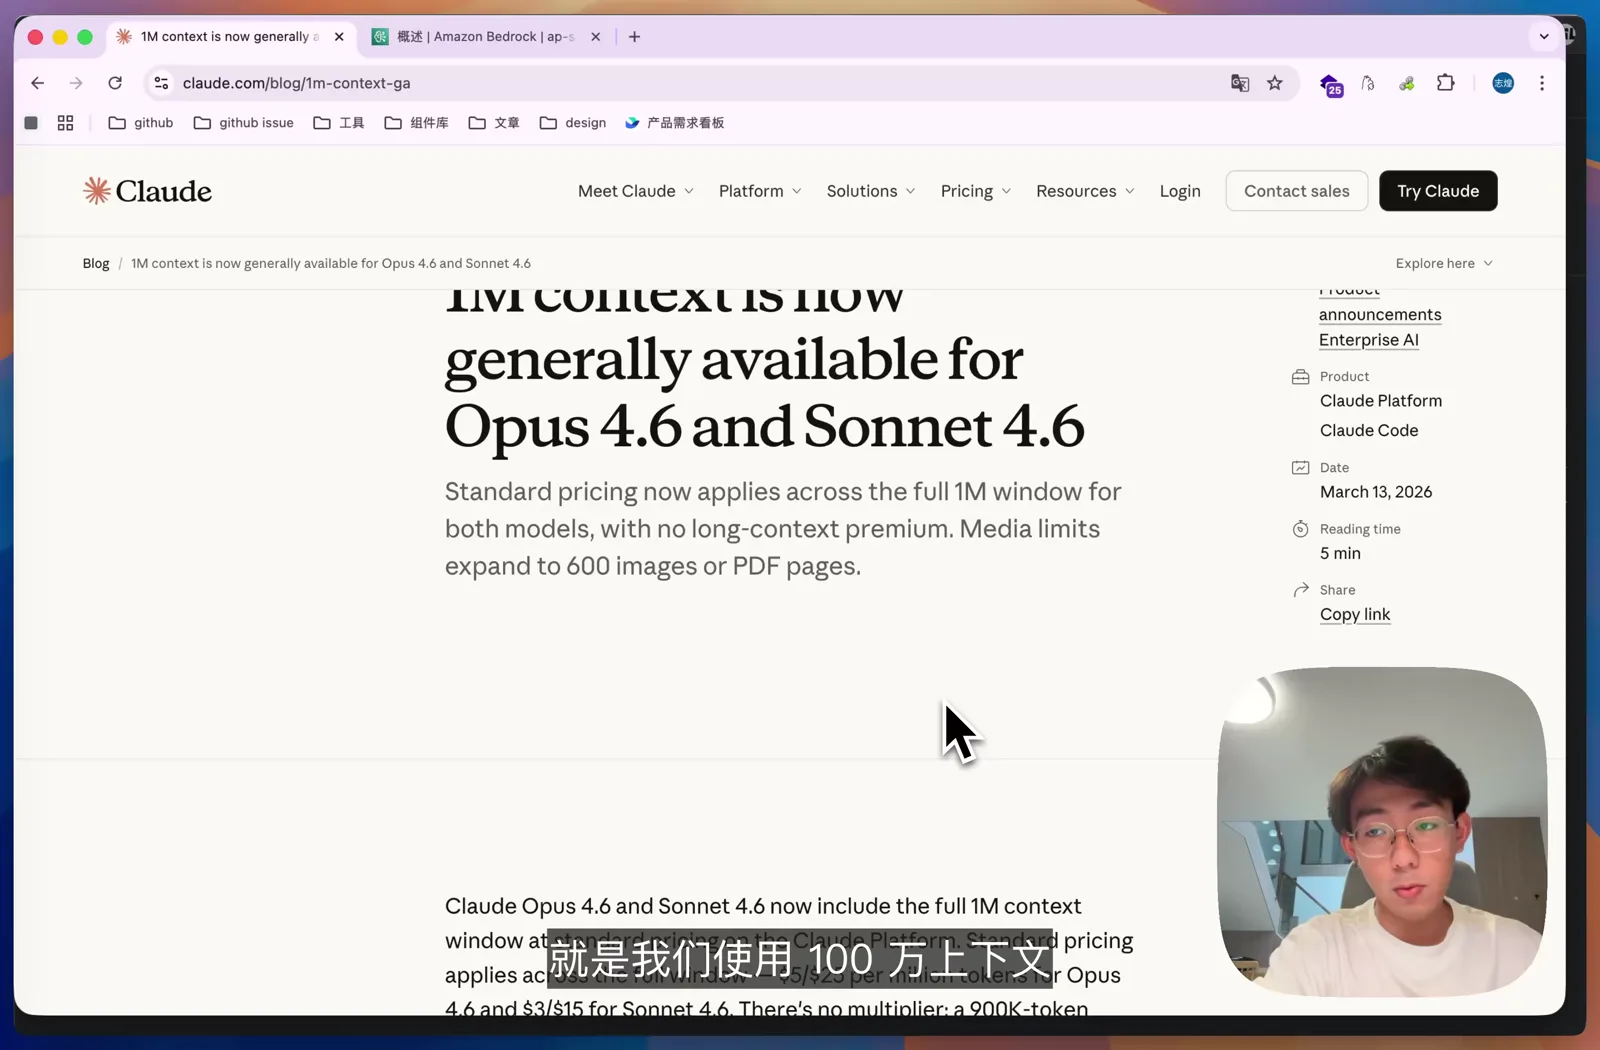
根据 Anthropic 的官方博客,标准价格覆盖整个 100 万 token 窗口:Opus 4.6 是每百万 token 5/25 美元(输入/输出),Sonnet 4.6 是 3/15 美元,没有长上下文加价,90 万 token 的请求和 9 千 token 的请求按同样的单价计费。单次请求的图片或 PDF 页数上限从 100 提升到 600,超过 20 万 token 的请求也不再需要 beta header。
这意味着我们在使用过程中可以尽量少压缩上下文。在比较长的对话里,模型的指令遵循效果也会更好一些。
借着这个消息,我聊一下自己对 Opus 4.6 和 Sonnet 4.6 的选择,以及我平时怎么使用 Claude。
我的 Claude 使用方式
我之前一直通过代理站使用 Claude,因为 Anthropic 对中国用户的风控比较严格,直接购买官方订阅很容易封号,这是迫不得已的选择。现在我改用公司的 AWS API 直连(Amazon Bedrock),不购买订阅套餐,但价格相对更贵,而我对 Claude 的用量又特别大,放开使用一天会花不少钱,所以我在使用 Claude 的时候会考虑成本。这也是我之前说要把 Claude 和 Codex 组合使用的原因:Codex 成本低,效果也不错。
无意识用了一周 Sonnet 4.6
最近这段时间我一直在使用 Sonnet 4.6,起因其实是个巧合。前阵子我更换了配置文件,里面的 ANTHROPIC_MODEL 默认被设成了 Sonnet 4.6,我当时没有发现,就在没意识到的情况下使用了一周。直到今天我想调整模型、研究 100 万上下文怎么开启的时候,才发现这一周使用的都是 Sonnet 4.6。
这一周里我处理了写 skill、开发任务、UI 设计等各种工作,完全没有感知到 Opus 4.6 和 Sonnet 4.6 的差别。尤其是组合 Codex 使用的时候,比较长的执行类任务交给 Codex,Sonnet 作为终端模型的理解能力和 Opus 4.6 一样强;它写的 skill 很好理解,下发的命令,包括上下文快满时最后几条指令的执行,表现都不错。我对模型切换算比较敏感,换成 GLM、MiniMax 这些模型我能清楚感知到差异,但这一周 Sonnet 4.6 一直很稳定地完成了我的任务。
这时候我才意识到,这周其实省了不少钱:在无意识的情况下换了一个更便宜的模型,而且没有感觉出来。后续如果遇到 Sonnet 确实处理不好的困难任务,再切到 Opus 执行也没有问题。所以我建议大家可以提升对 Sonnet 4.6 的使用信心。当然,我的使用场景是在 Claude Code 里使用 Claude 的模型。
模型和工具尽量选同一家的
我主观认为,模型厂商最适配的 AI 编程工具一定是他们自己做的:Codex 适合 GPT 系列模型,目前也只能使用 GPT 的模型;Claude Code 最适配的还是 Claude 的模型。工具在设计的时候会更理解自家模型的表现,模型训练的时候也可能有意无意注入一些未来配合这些编程工具使用的知识,后续的模型迭代也会针对自家 Agent 做专门的优化。这毕竟是他们商业化的产品,Claude Code 给 Anthropic 带来的收入占比已经不小。
有同学在评论区问我,我用 Claude Code 控制 Codex 这个方式,直接在 opencode 里组合两个模型不就好了。我觉得不太一样,因为 Agent 的设计不同:我在 Claude Code 里向 Codex 这个 Agent 发送命令时,它运行在自己最熟悉的 Agent 上,执行效果更好。
除非刚需多模型切换,比如 Cursor 这一类工具,或者不方便开通官方订阅、只能购买第三方服务,这些情况情有可原。如果追求更好的效果,还是选择官方的组合。