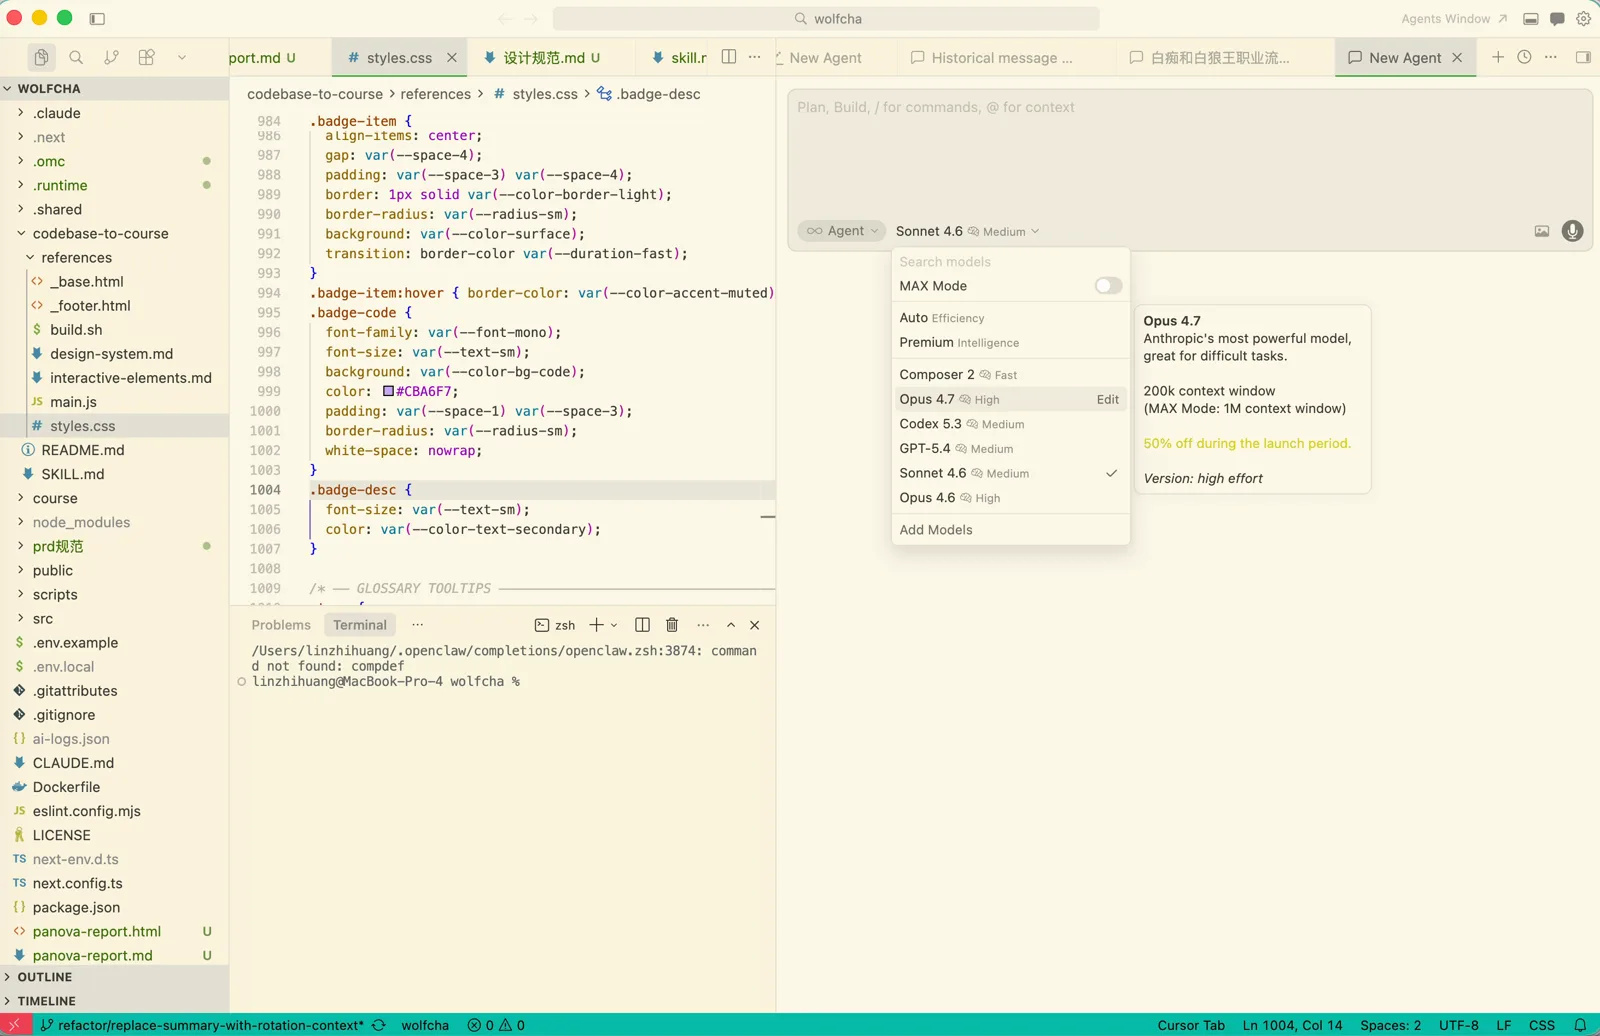
4 月 16 日晚上,Anthropic 推出了最新的模型 Claude Opus 4.7,同时还写了一篇最佳实践文章,叫 Best practices for using Claude Opus 4.7 with Claude Code。模型是前一天晚上刚出的,我只用它做了一些简单的调研任务,还没有深度使用,实践心得之后再跟大家分享。这篇文章先说一下模型本身的变化和官方文章里的建议。
上下文和价格没有变化
Opus 4.7 整体的调整没有那么大。上下文长度和 Opus 4.6 一样,都是 100 万,输入输出的 token 价格也一样,输入 5 美金、输出 25 美金(每百万 token)。
在这之前,我一直认为 Opus 4.6 是编程上最好的模型。很多榜单上 GPT 5.4 的评分高于 Opus 4.6,但 GPT 的问题在于语言表达能力和理解能力跟 Opus 4.6 差得比较多。它像一个很沉闷但很有经验的开发者:给它一个非常明确的任务,比如很长的代码重构或者 review 任务,它会 review 得很仔细,长任务也执行得特别好;但想让它发挥一些创意,比如一起设计一个方案、做调研类的任务,它产出的报告和说的话我们就很难看懂。
我认为这样的模型不太适合大多数人使用,因为不是每个人都是成熟的开发者。不少编程经验没那么丰富的人跟我说,GPT 5.4 说的话老是听不懂,让它调整 UI 也老是改不好。很大程度上,这就是 GPT 5.4 的调教没有 Opus 4.6 好的地方。
文章里的一般性建议
官方文章里先给了一个判断:Opus 4.7 在交互式环境里会在用户回合结束后进行更多推理,这有助于提升长会话里的代码一致性和编码质量,但也会增加 token 使用量。
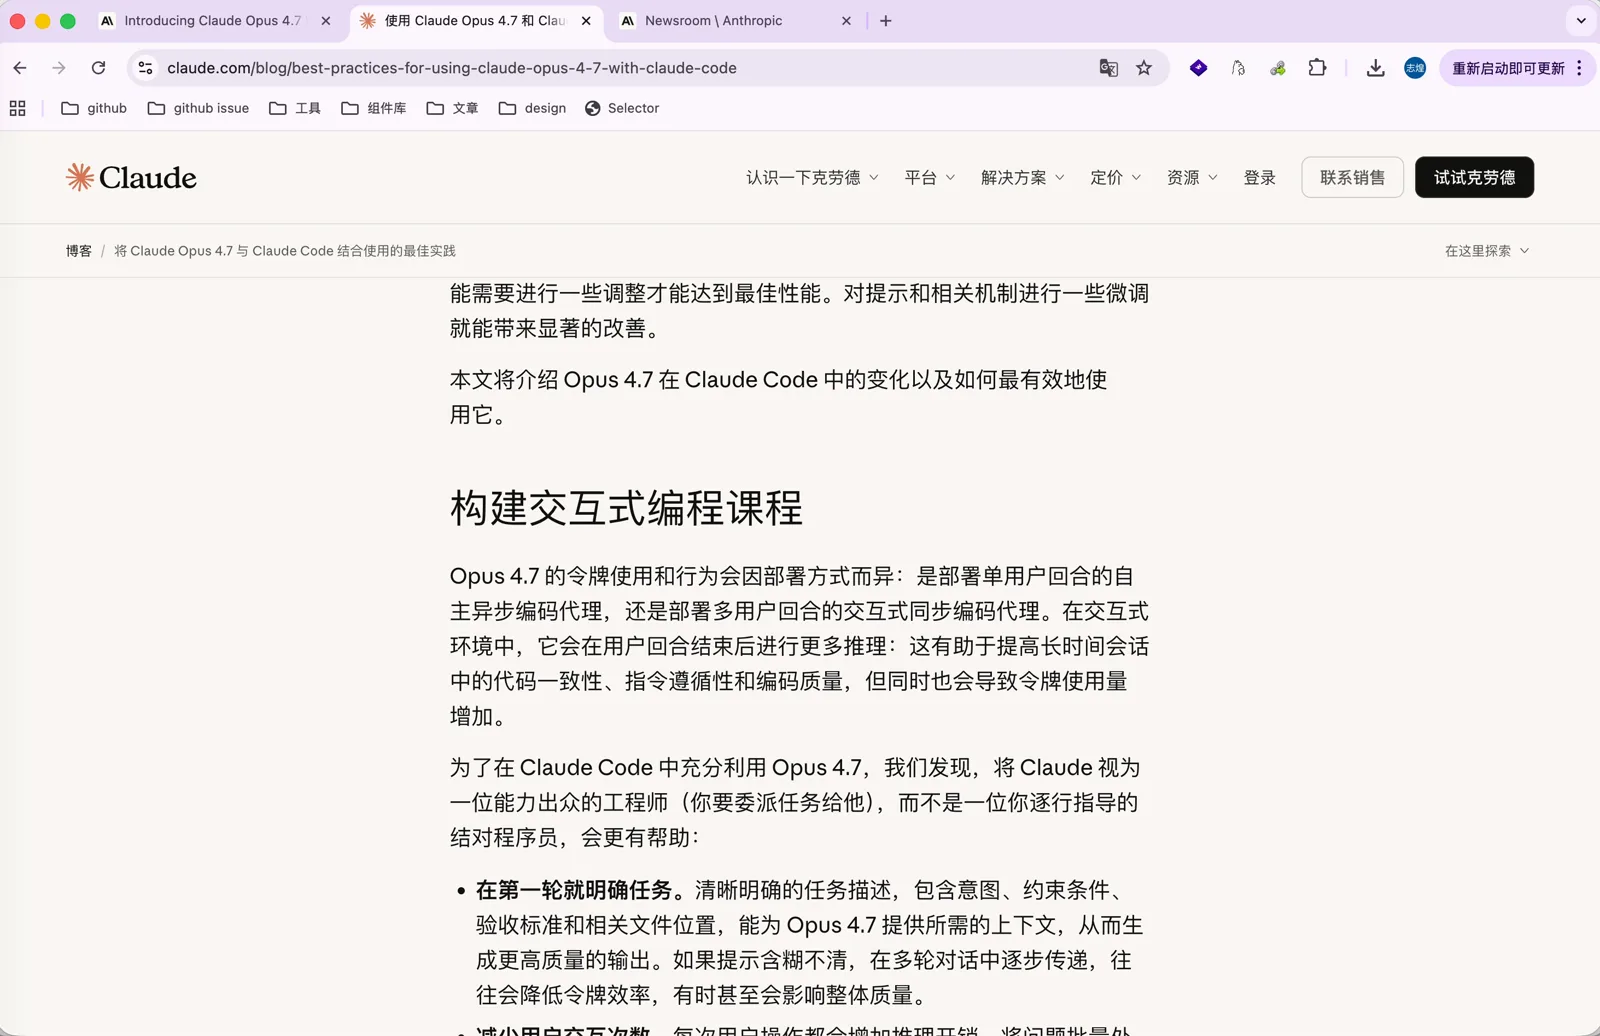
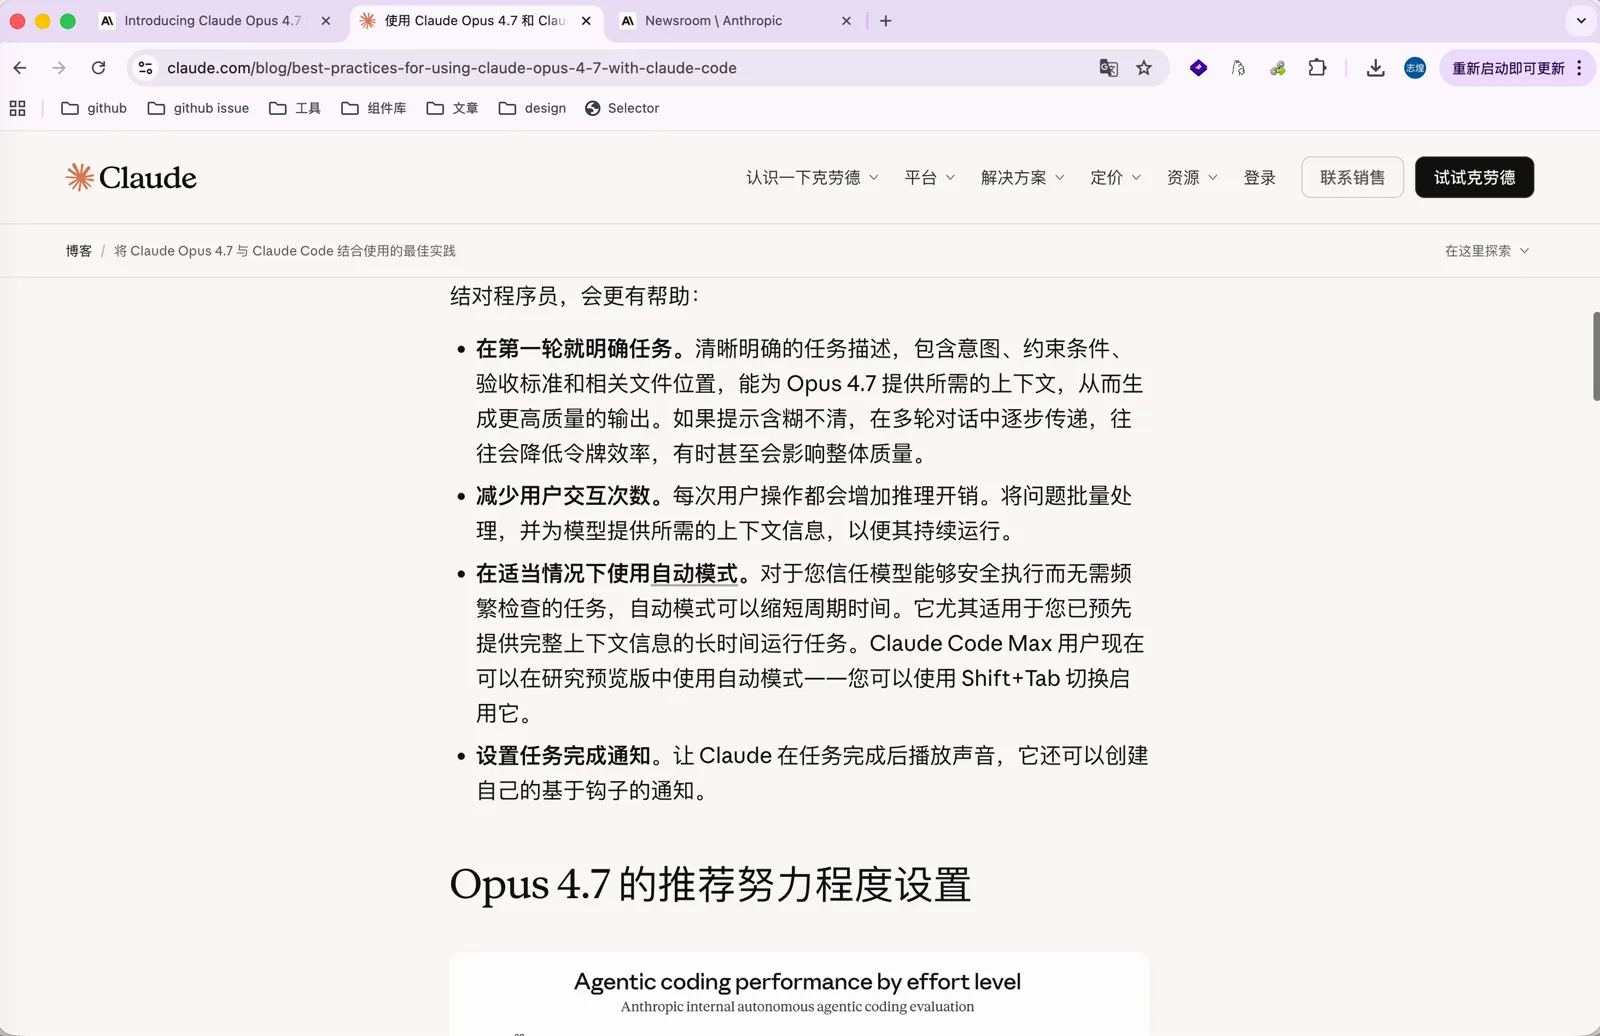
文章建议把 Claude 当成一个可以委派任务的工程师,而不是逐行指导的结对程序员,并给了几条具体做法:
- 在第一轮就把任务描述清楚,包含意图、约束条件、验收标准和相关文件位置;
- 减少用户交互次数,把问题批量处理;
- 信任模型可以安全执行的任务,使用自动模式,Claude Code Max 用户可以在研究预览版里用 Shift+Tab 开启;
- 设置任务完成通知,让 Claude 在任务完成后播放声音。
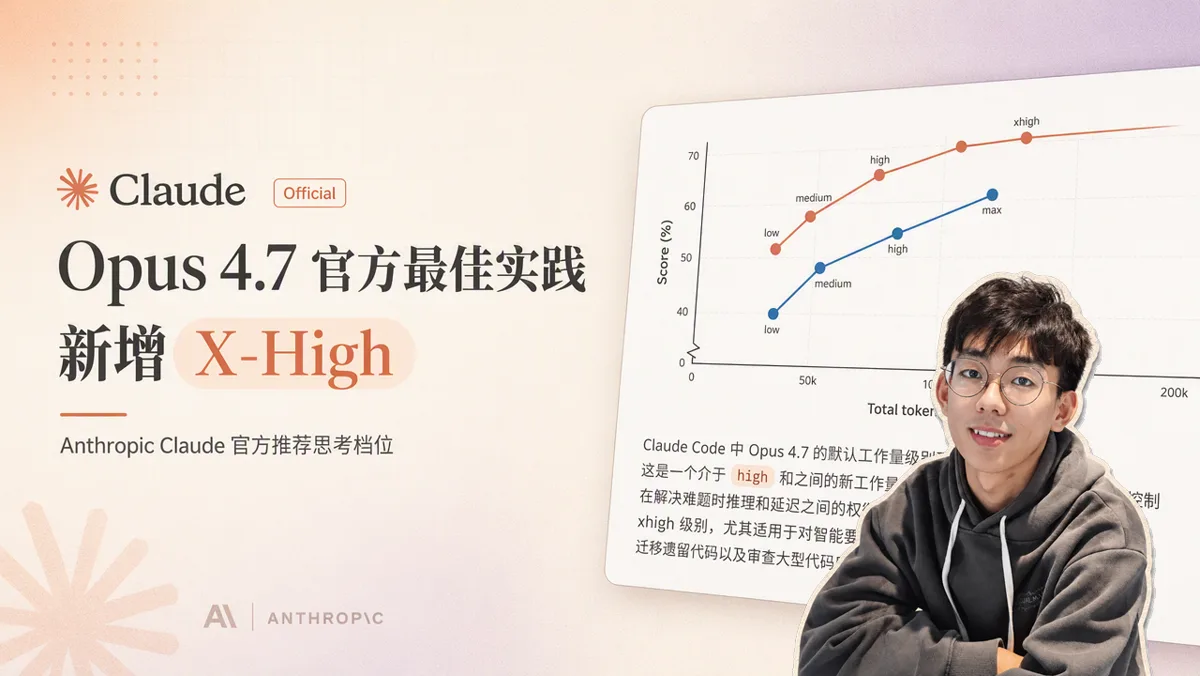
新增 X-High 思考程度
主要的一个变更是思考程度新出了一个级别 X-High,介于之前的 High 和 Max 之间,让我们有更多选择。之前 Opus 4.6 的一个问题是过度思考,一些简单的任务它思考的时间太长。X-High 是一个更平衡的思考程度,能适应大多数任务,现在也是 Claude 默认推荐的思考程度,大多数时候把它设置为 X-High 就可以了。
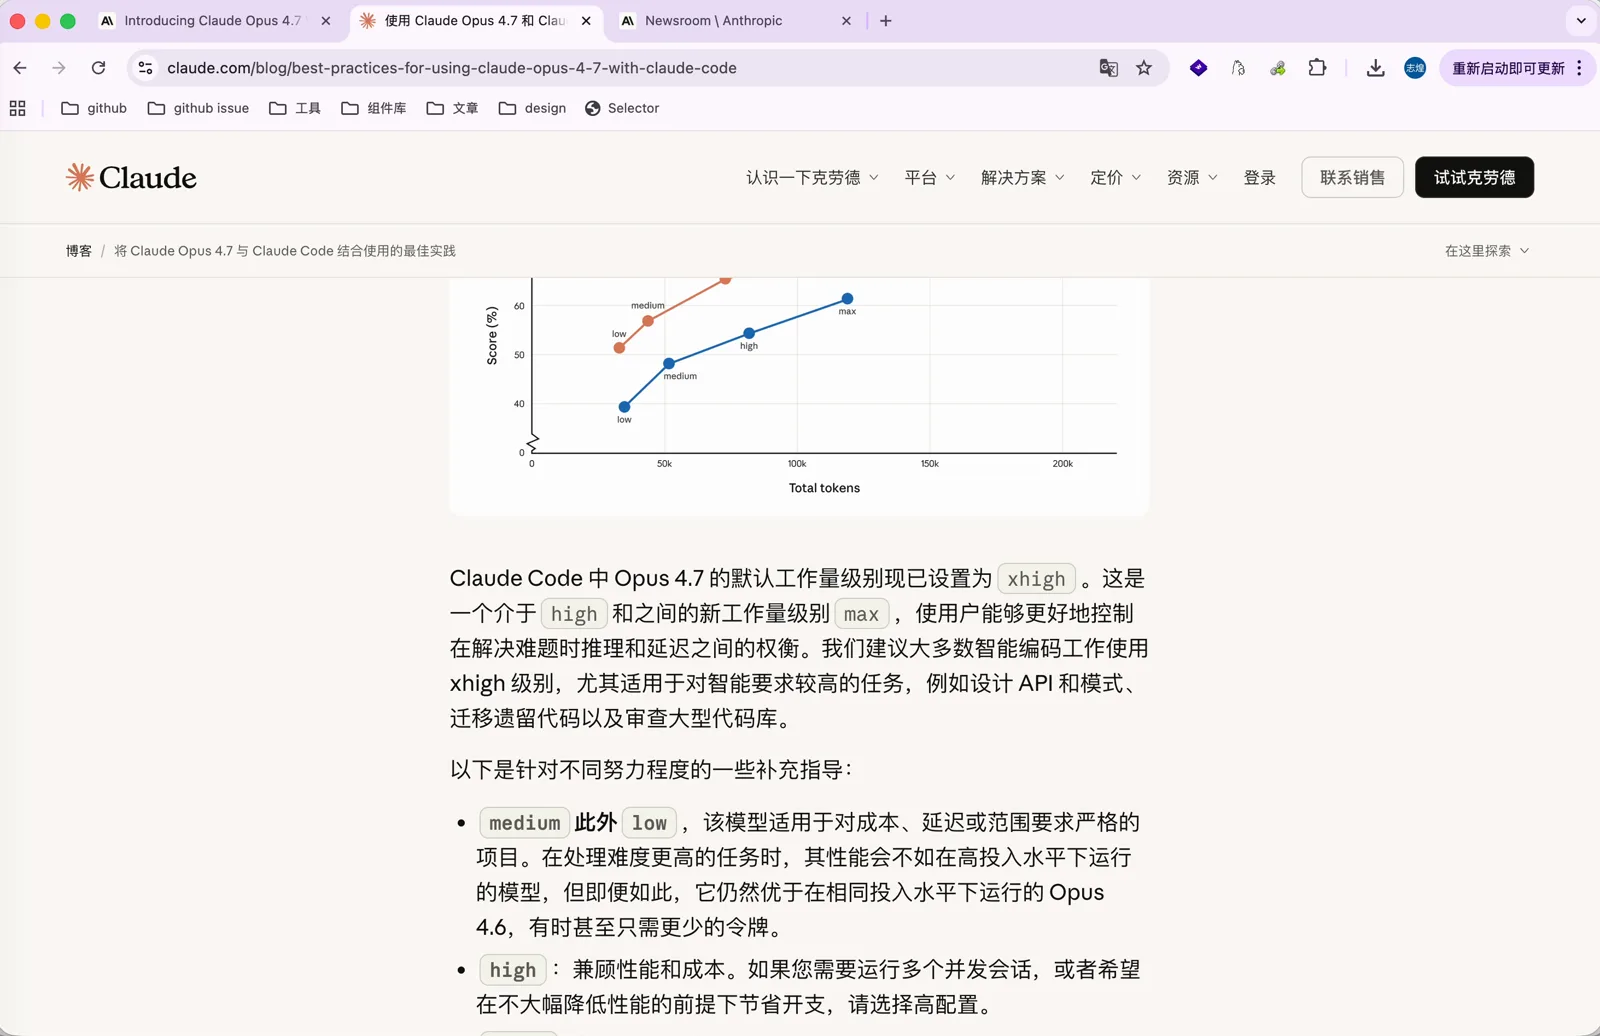
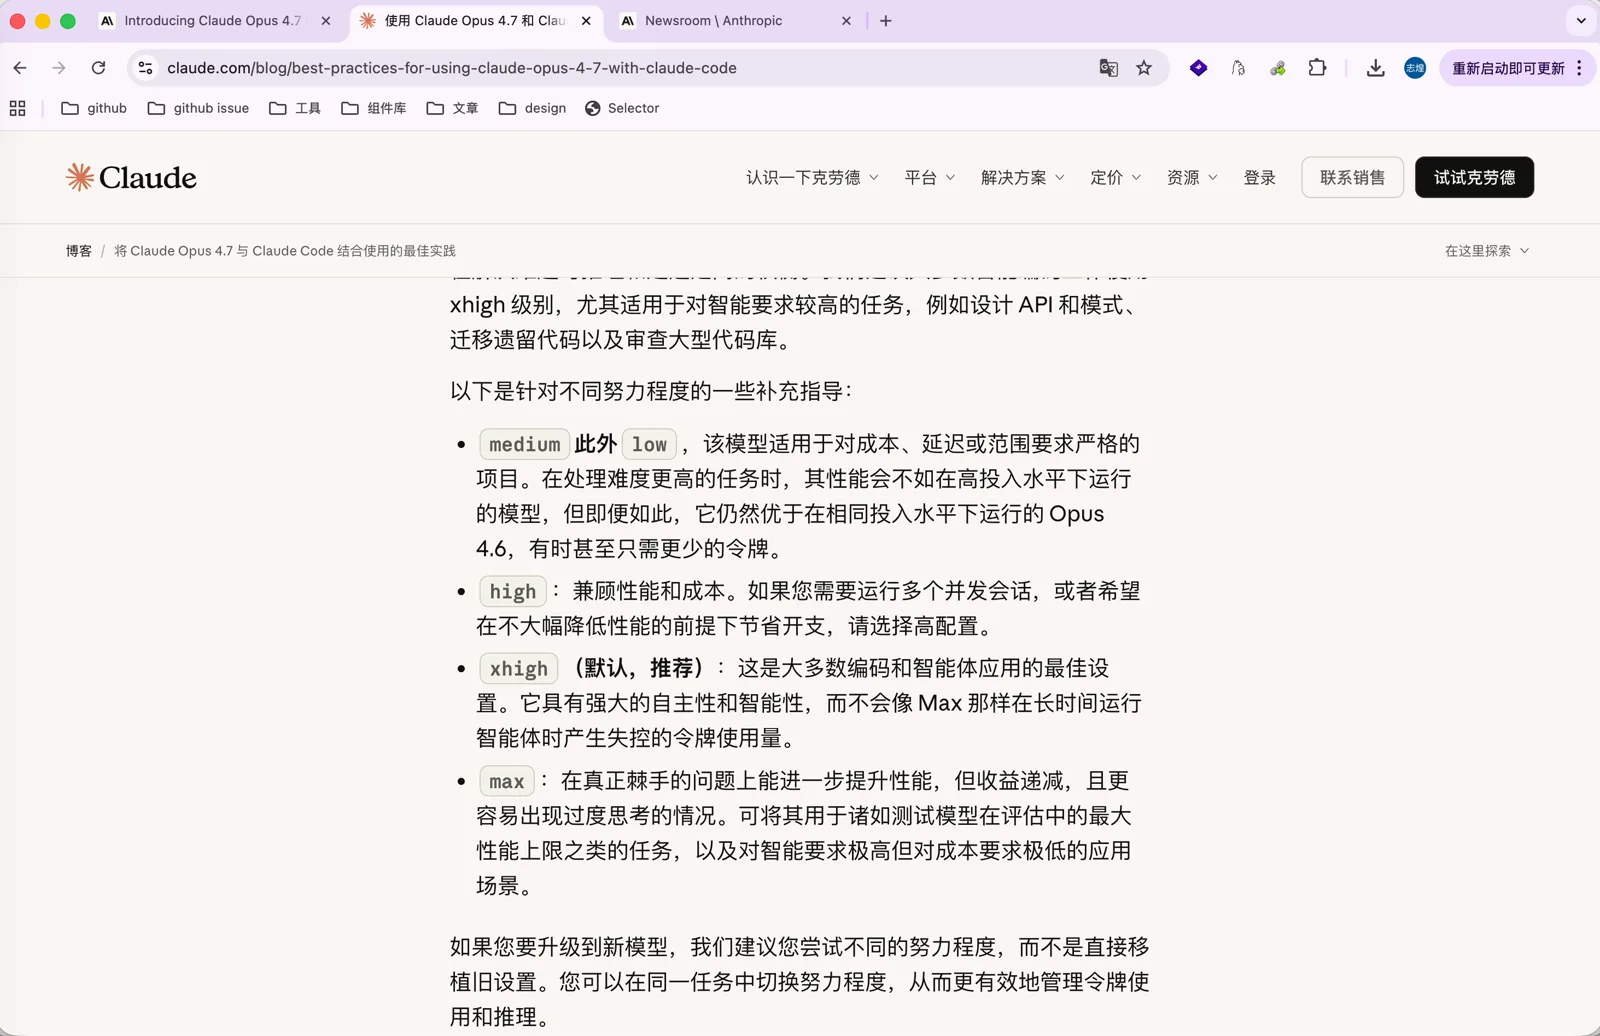
文章里也给了各级别的补充指导:medium 和 low 适合对成本、延迟要求严格的项目;high 兼顾智能和成本,适合同时运行多个会话;xhigh 是大多数编程和智能体任务的默认推荐;max 留给真正棘手的问题,但收益递减,也更容易过度思考。
三个行为变化
文章里还提到三个默认行为的变化。
首先是响应长度会根据任务复杂度调整。Opus 4.6 的默认响应比 4.7 更冗长,4.7 对简单的查找任务响应更短,响应速度预期会更快,长度更加动态和灵活。如果我们的使用场景依赖特定的响应长度或风格,需要在提示里明确说明。
其次是 Opus 4.7 会减少工具的调用次数,增加推理的次数。Anthropic 认为更多情况下这样会得到更好的响应效果。如果我们想让它更积极地调用更多工具,需要明确告诉它去调用外部工具,说明什么时候、为什么应该使用。
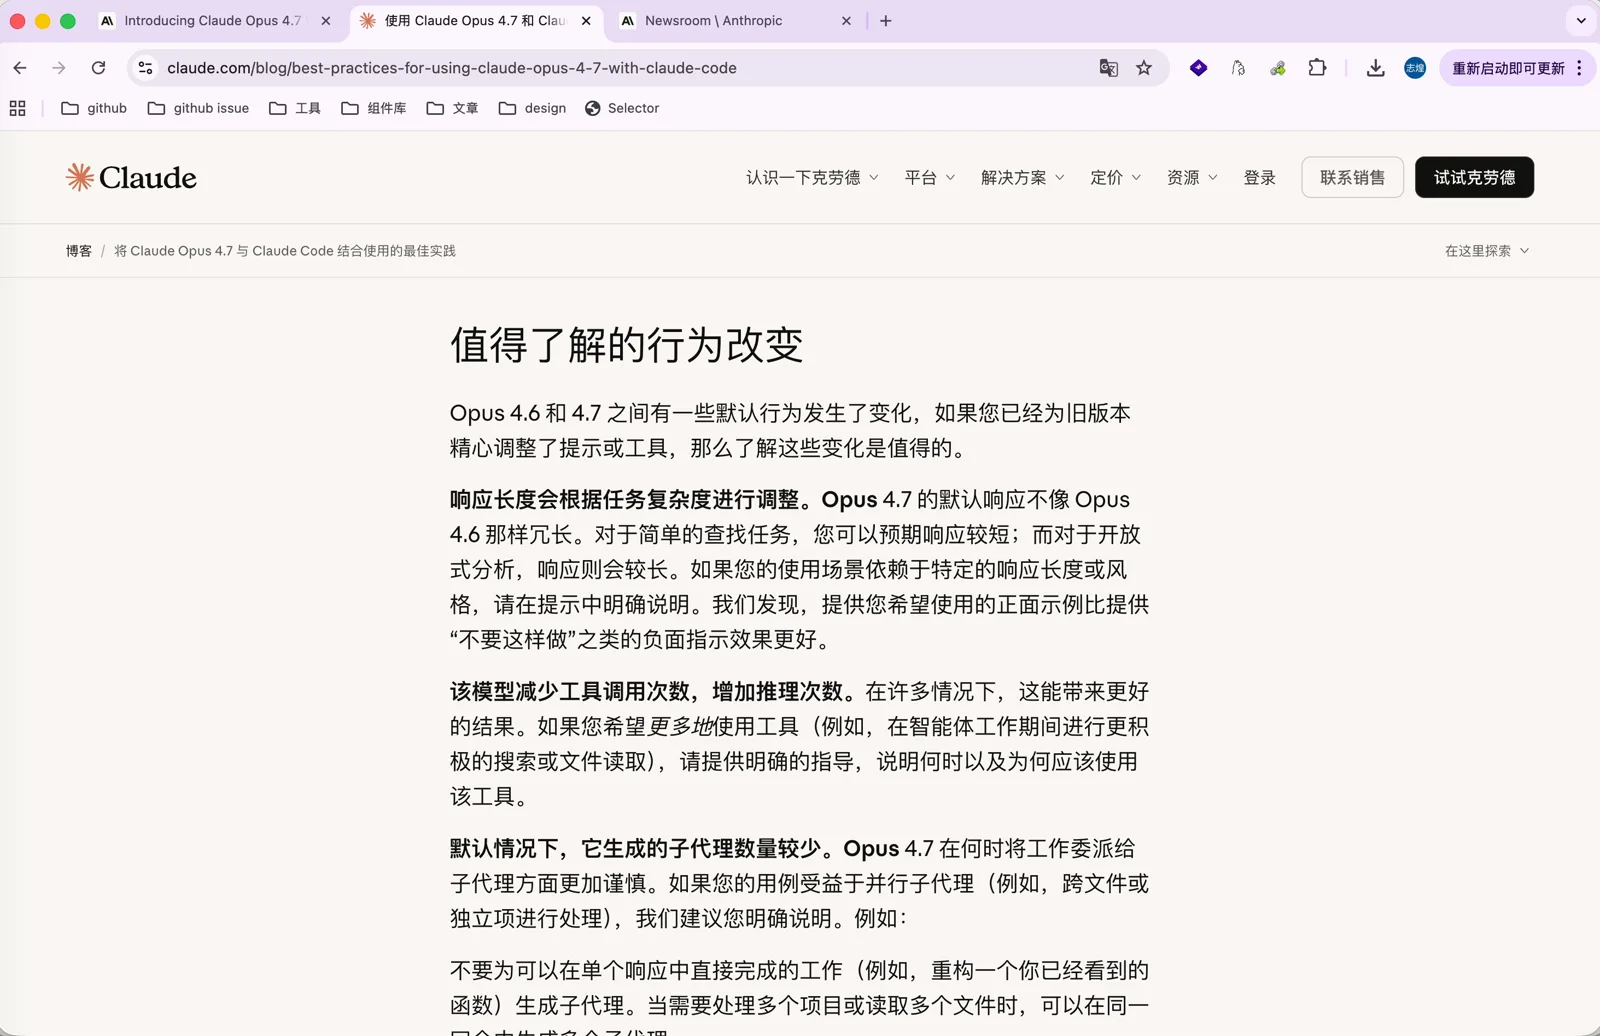
还有一个调整是它默认生成的子代理数量比较少,更倾向于自己独立完成工作。如果我们的任务非常依赖子代理,比如任务很容易把上下文占满,就需要明确跟它说,用子代理去做代码探索,或者执行代码重构、UI 调整这类比较长的任务,这样不会很快把主线程的上下文塞满。
Cursor 已经可以使用
现阶段 Opus 4.7 已经可以在 Cursor 里使用,模型选择器里能直接选到,而且发布期间有 50% 的折扣,相当于打五折。大家可以选择在 Cursor 上使用 Opus 4.7。