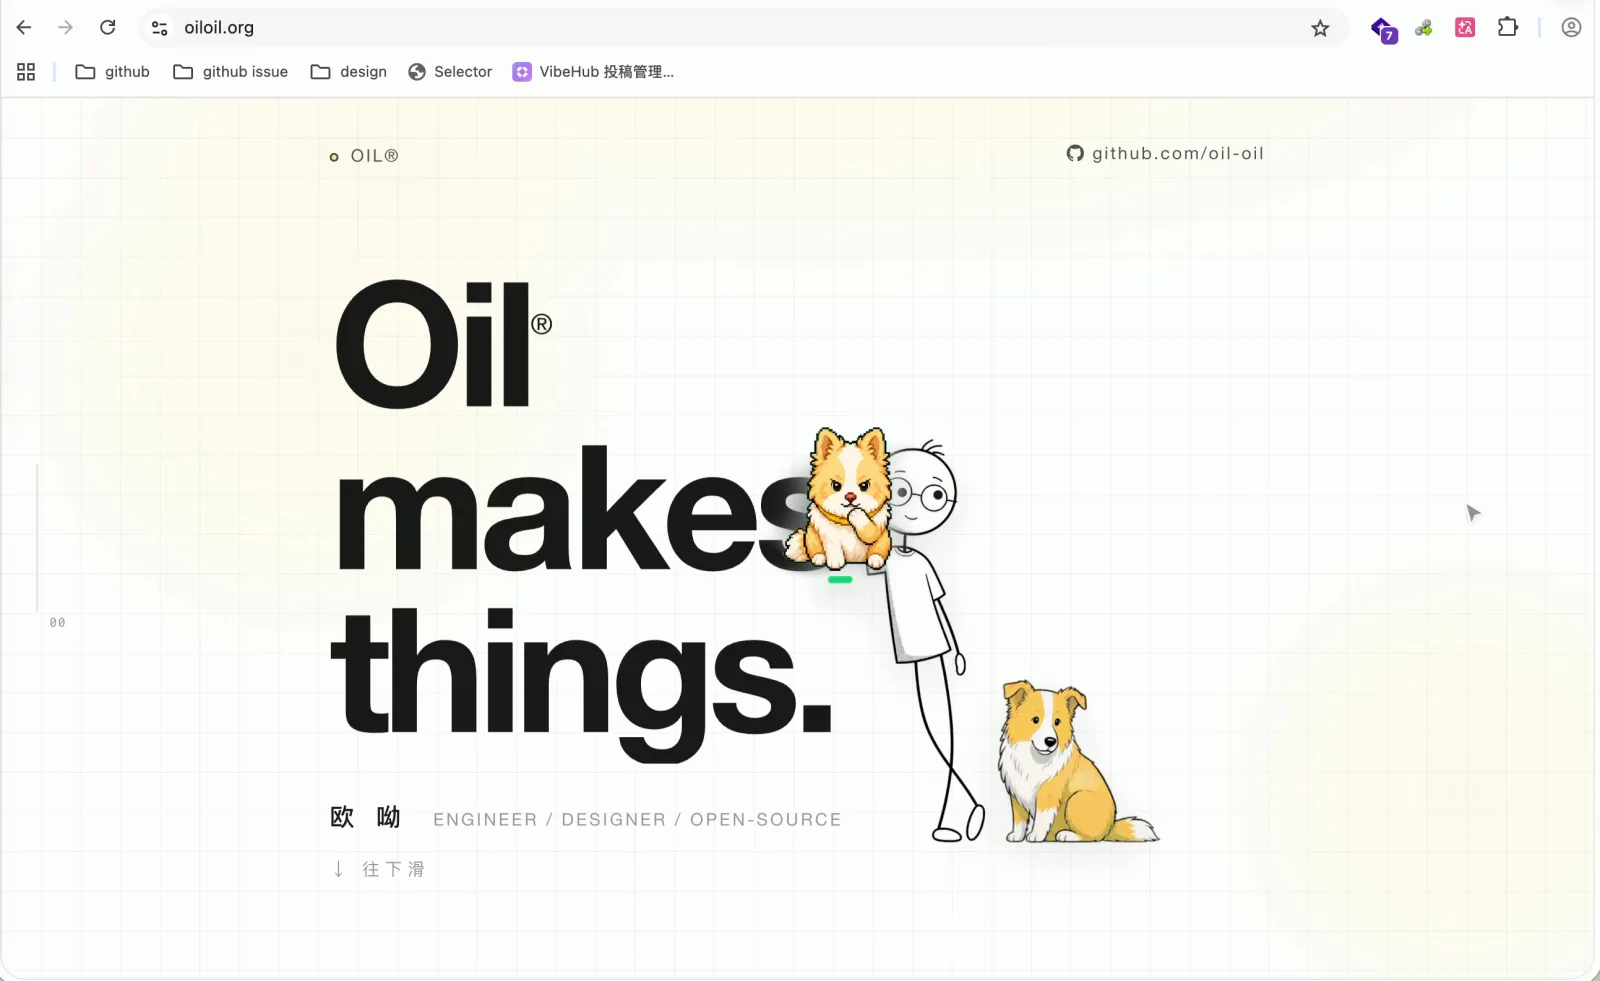
我在做个人网站的时候,想让首屏的人物和小狗能对访客的鼠标产生即时反应:光标移动时,小人的眼珠跟着看,小狗的头也会转向对应的方位。
但我最终没有为小狗专门做 3D 建模,而是通过 AI 生成一段视频,把视频切成一张雪碧图,再把鼠标的坐标位置实时映射成对应角度的画面帧。
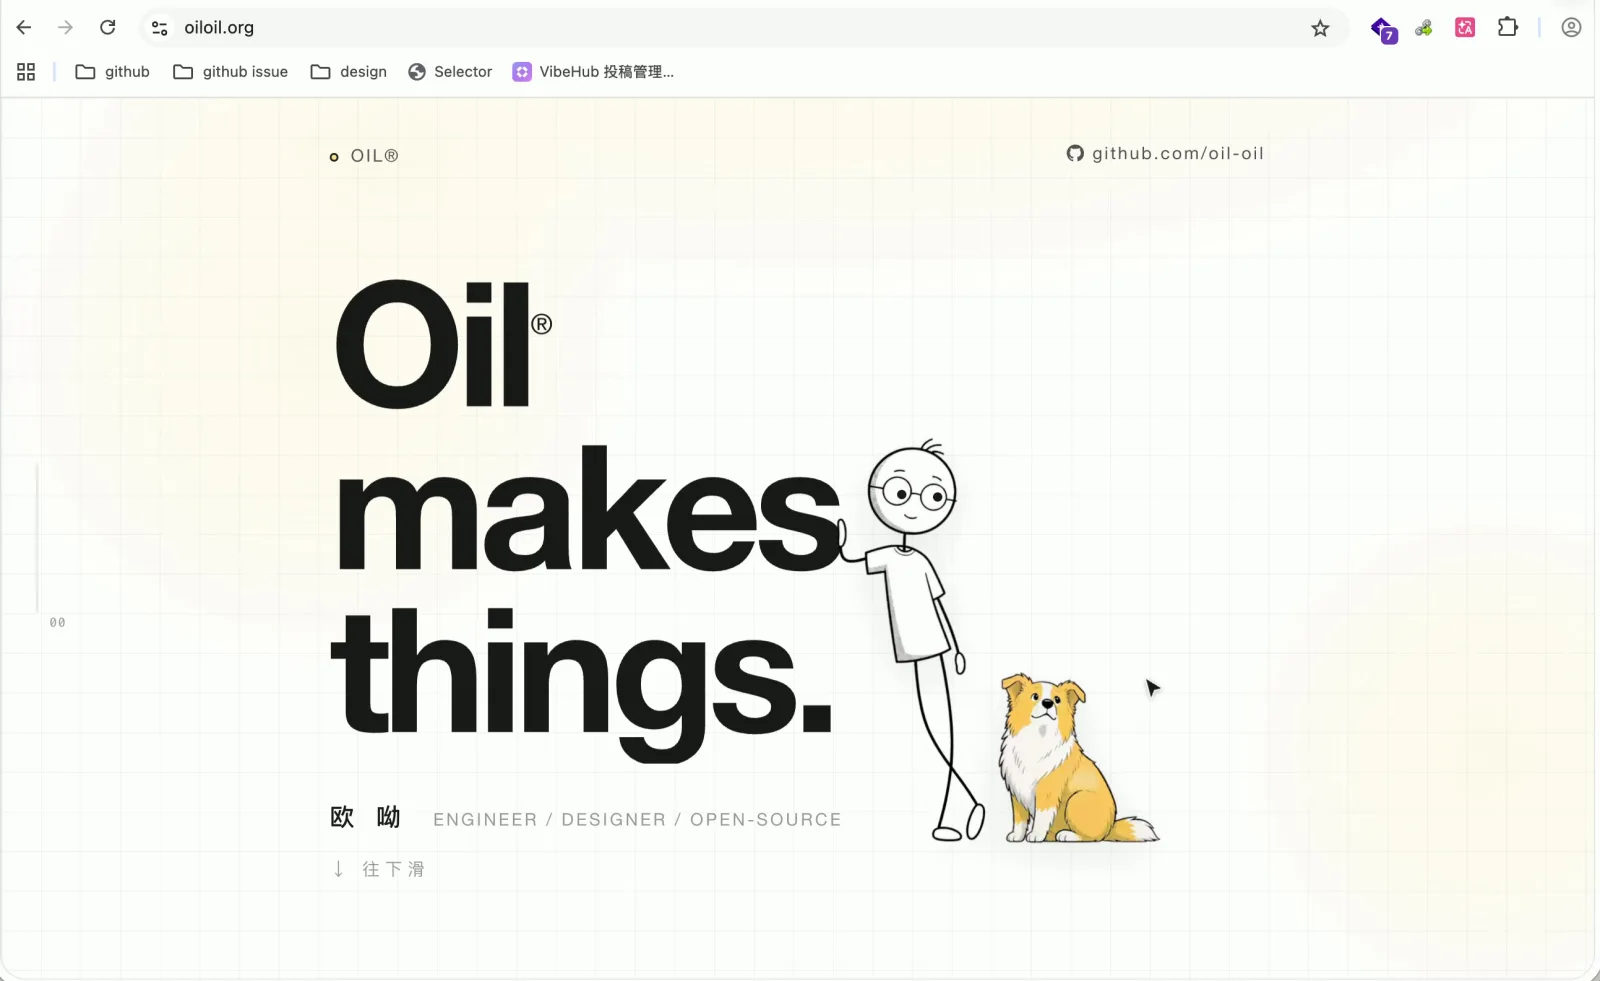
这套交互可以拆成两部分来实现:小人的眼睛纯粹依靠网页前端逻辑驱动,而小狗连续逼真的动作则完全交给 AI 视频处理。
小人只需要一张图
小人的身体保持不动,只有眼珠在转,所以一张静态图片就足够了。
具体做法是先用 AI 生成一张绿色背景的人物图片,把背景扣除;生成时特意将眼睛的位置留空,不要画任何内容,之后再在网页代码里放入眼珠元素,通过 JavaScript 计算光标与人物面部的相对角度,让眼珠跟随鼠标移动。
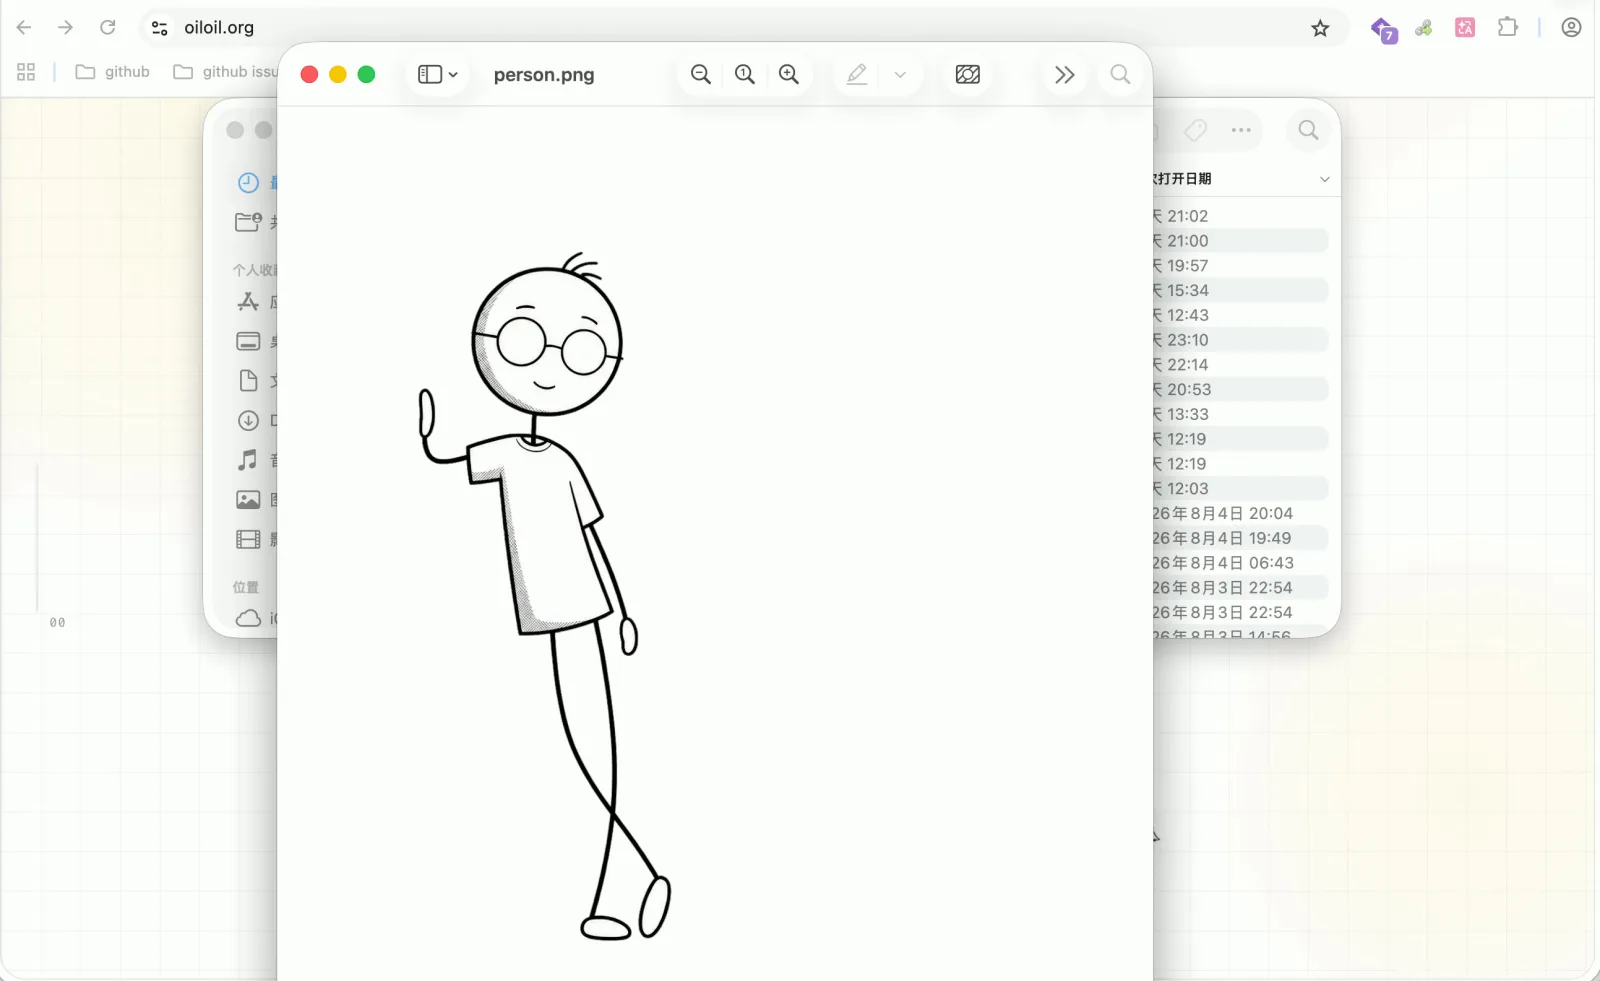
单独看这张留空的原始图片会觉得有些不自然,但当小人的手臂搭在页面左侧的文字上,再加上眼珠会根据光标灵活转动,放回网页首屏之后,整体视觉效果就会非常协调。
小狗用 AI 视频生成连续动作
相比之下,右边的小狗要复杂得多。小狗扭头时带着明显的空间立体感,但实际上并没有使用任何 3D 资产。
它的初始形象和小人类似,也是先用 AI 生图生成绿底的小狗参考图,再把背景抠掉。
在尝试视频方案之前,我试过 Codex 自带的宠物功能。它通常会生成一张横版的序列帧图片,把宠物的动作拆成大概 7 帧左右。但因为总帧数太少,小狗转头时动作会一卡一顿,很难表现出细腻平滑的转向效果。
要让小狗转头更丝滑,改用 AI 视频模型是更好的选择。现在的 AI 视频模型普遍支持首尾帧控制:我们把小狗正对前方的默认状态同时作为首帧和尾帧,模型就会自动生成一段小狗头部转动一整圈、最后又稳稳回到原点的连续视频。
从这段视频里逐帧提取画面,有几个很明显的优势:
- 首帧和尾帧都锁定了同一张参考图,角色形象的一致性非常高,中途不会变形跑偏;
- 不需要人工逐张去生成和对齐图片,一段短视频就能直接提供几十上百帧可用素材;
- 视频生成时同样可以指定纯绿背景,既可以先把视频里的绿幕抠掉再切帧,也可以先切成序列帧再批量抠图。
把视频帧拼成一张雪碧图
提取出来的所有画面帧,会被脚本拼接成一张大图,也就是前端开发里常用的雪碧图(Sprite Sheet)。
这样网页加载时不需要发起几十次图片网络请求,只要下载这一张雪碧图即可。页面监听鼠标在屏幕上的移动位置,计算出光标相对于小狗中心的角度,再按比例换算出对应的帧序号,直接从雪碧图里截取并显示对应区域的画面。
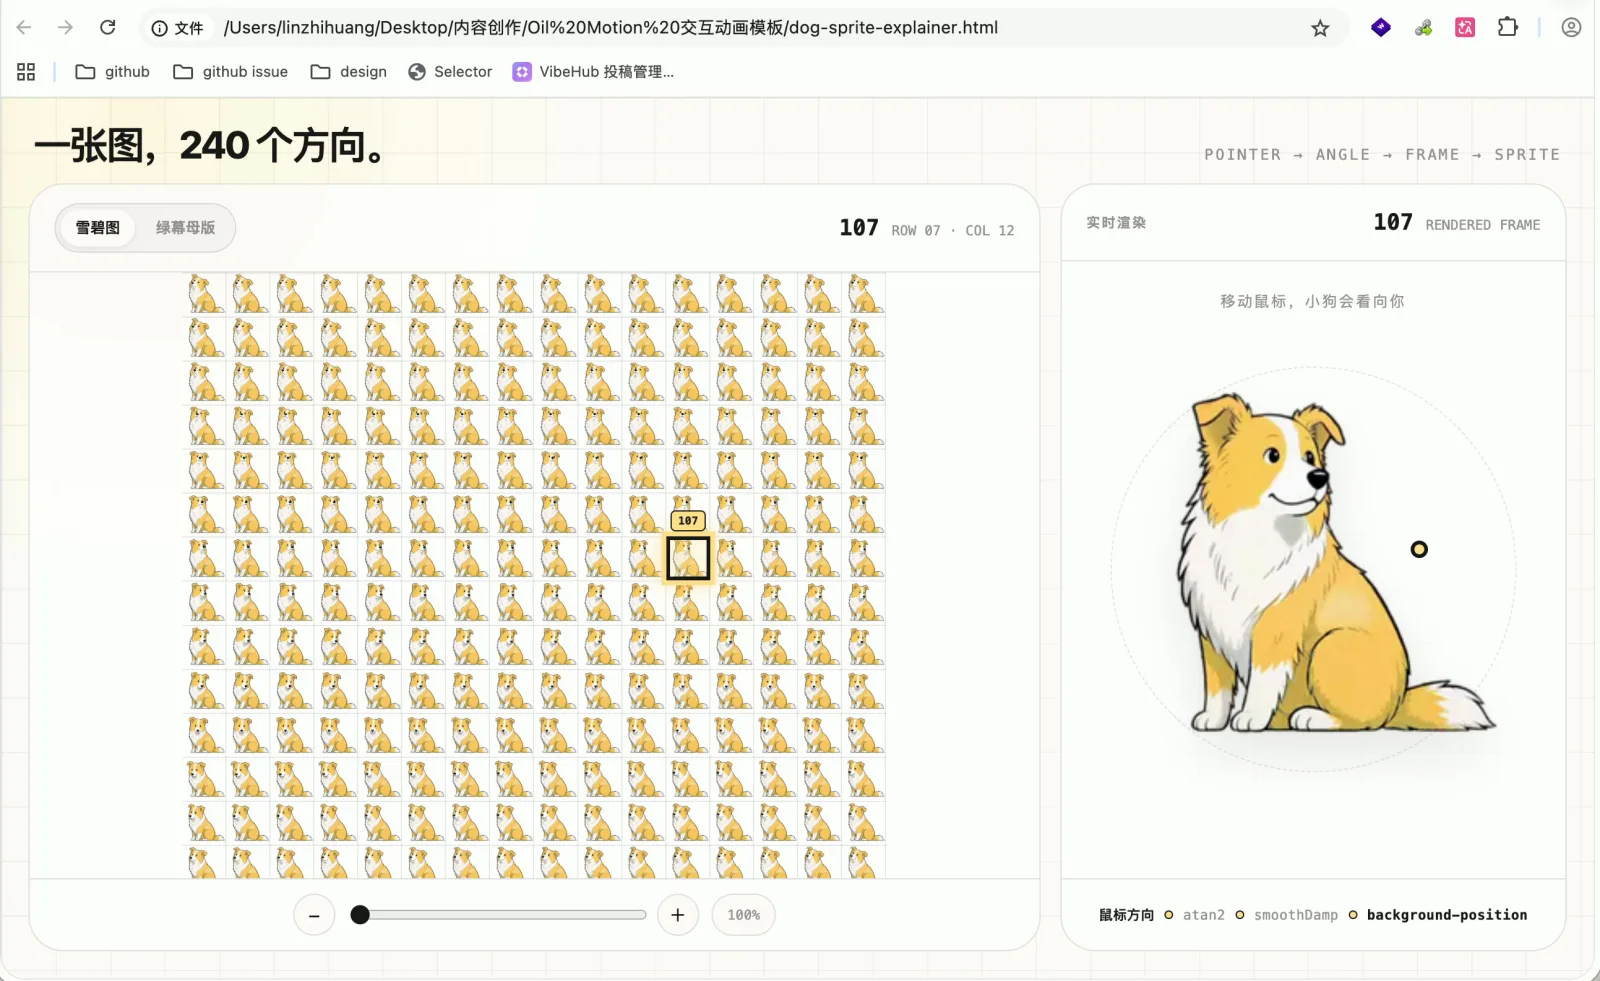
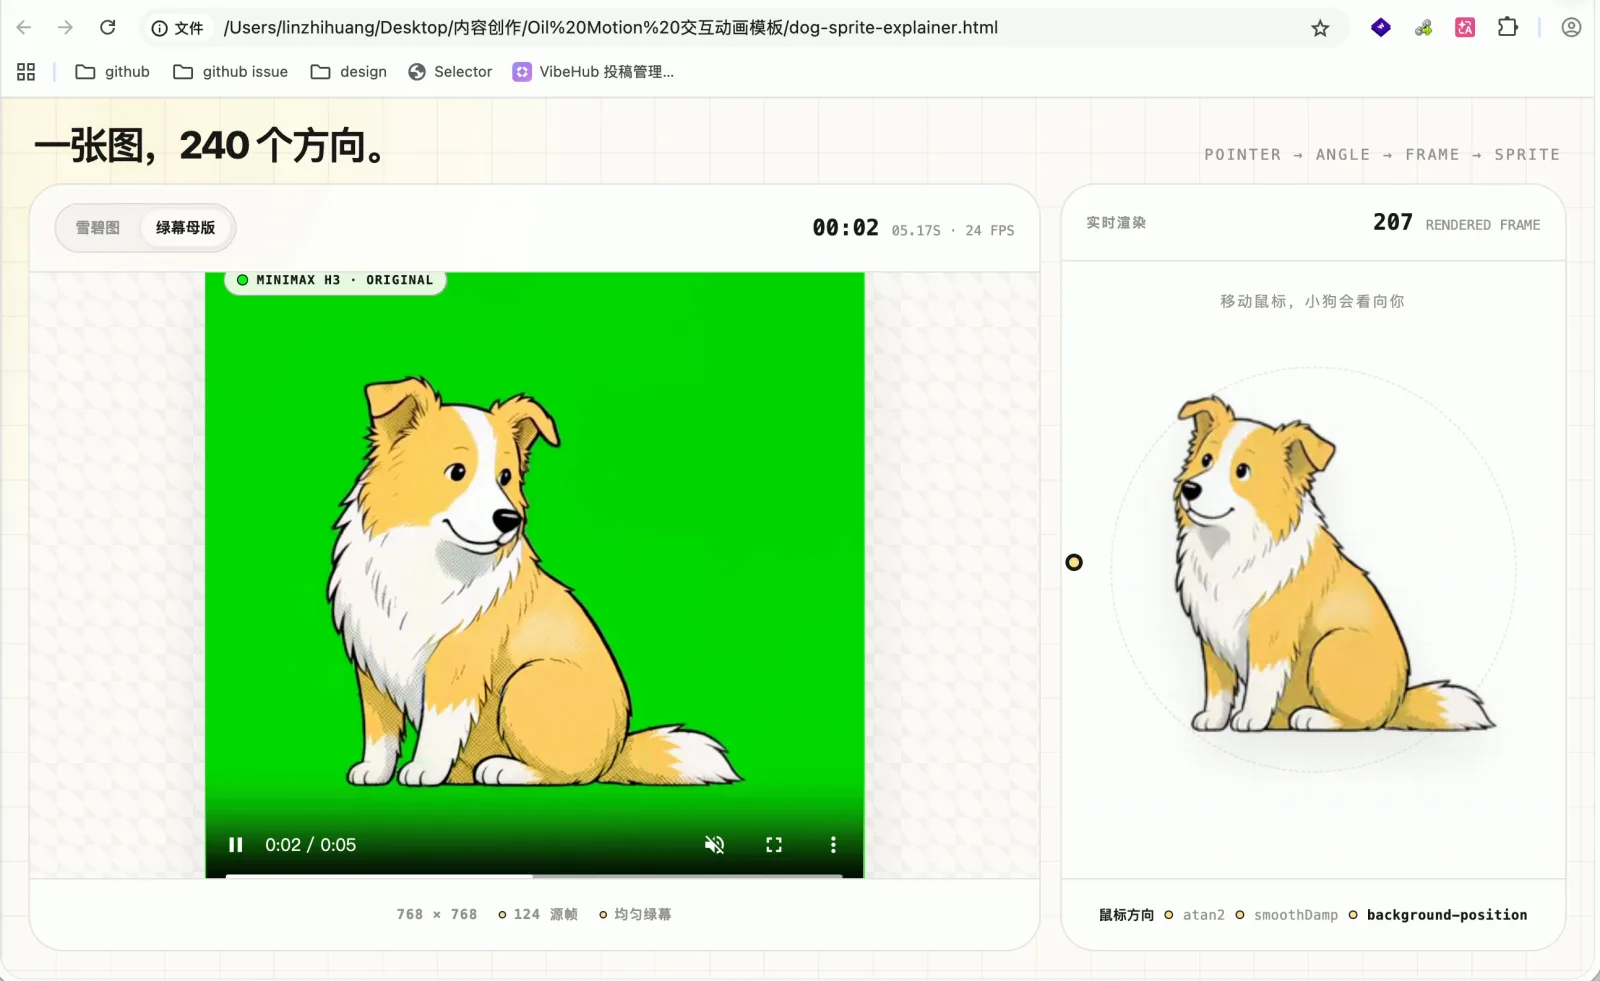
因为小狗的原始视频带有绿幕,抠掉背景之后,整张雪碧图就成了干净的动作素材。鼠标移动时,网页只是在同一张大图内部切换显示坐标,没有任何加载延迟。
压缩和补帧决定流畅度
生成这段小狗视频时,我使用的是 MiniMax H3 模型,这个模型的生成成本相对便宜。
它输出的母版分辨率是 768p,如果全屏放大看清晰度并不算高,但在官网首屏里小狗的显示尺寸本来就很小,所以我们完全可以在画面清晰度和加载性能之间做权衡,对雪碧图进行适当的画质压缩。
此外,AI 原生生成的视频帧率有限,如果直接提取,帧与帧之间的间隔仍然有点大。为了解决这个问题,我用程序给序列帧做了插值补帧。如果平时用过 AE 或者 PR 这类视频剪辑软件,可能接触过光流法补帧,这里的原理基本一样。补帧之后,画面在视觉上变得非常连贯,虽然底层本质上依然是图片切换,但交互起来的流畅感已经非常接近真正的 3D 渲染。
同样的思路也能映射到滚动
「AI 视频切帧 + 交互输入映射」不仅能用来做鼠标跟随,还可以无缝映射到页面的滚动条上。
比如在页面向下滚动时,把滚动进度映射为视频进度,让画面元素随着滚动慢慢展开。在这个例子里虽然帧数不算特别高,慢速滚动时能感受到轻微的跳跃,但只要稍微加快滚动速度,动作就会显得相当顺畅。
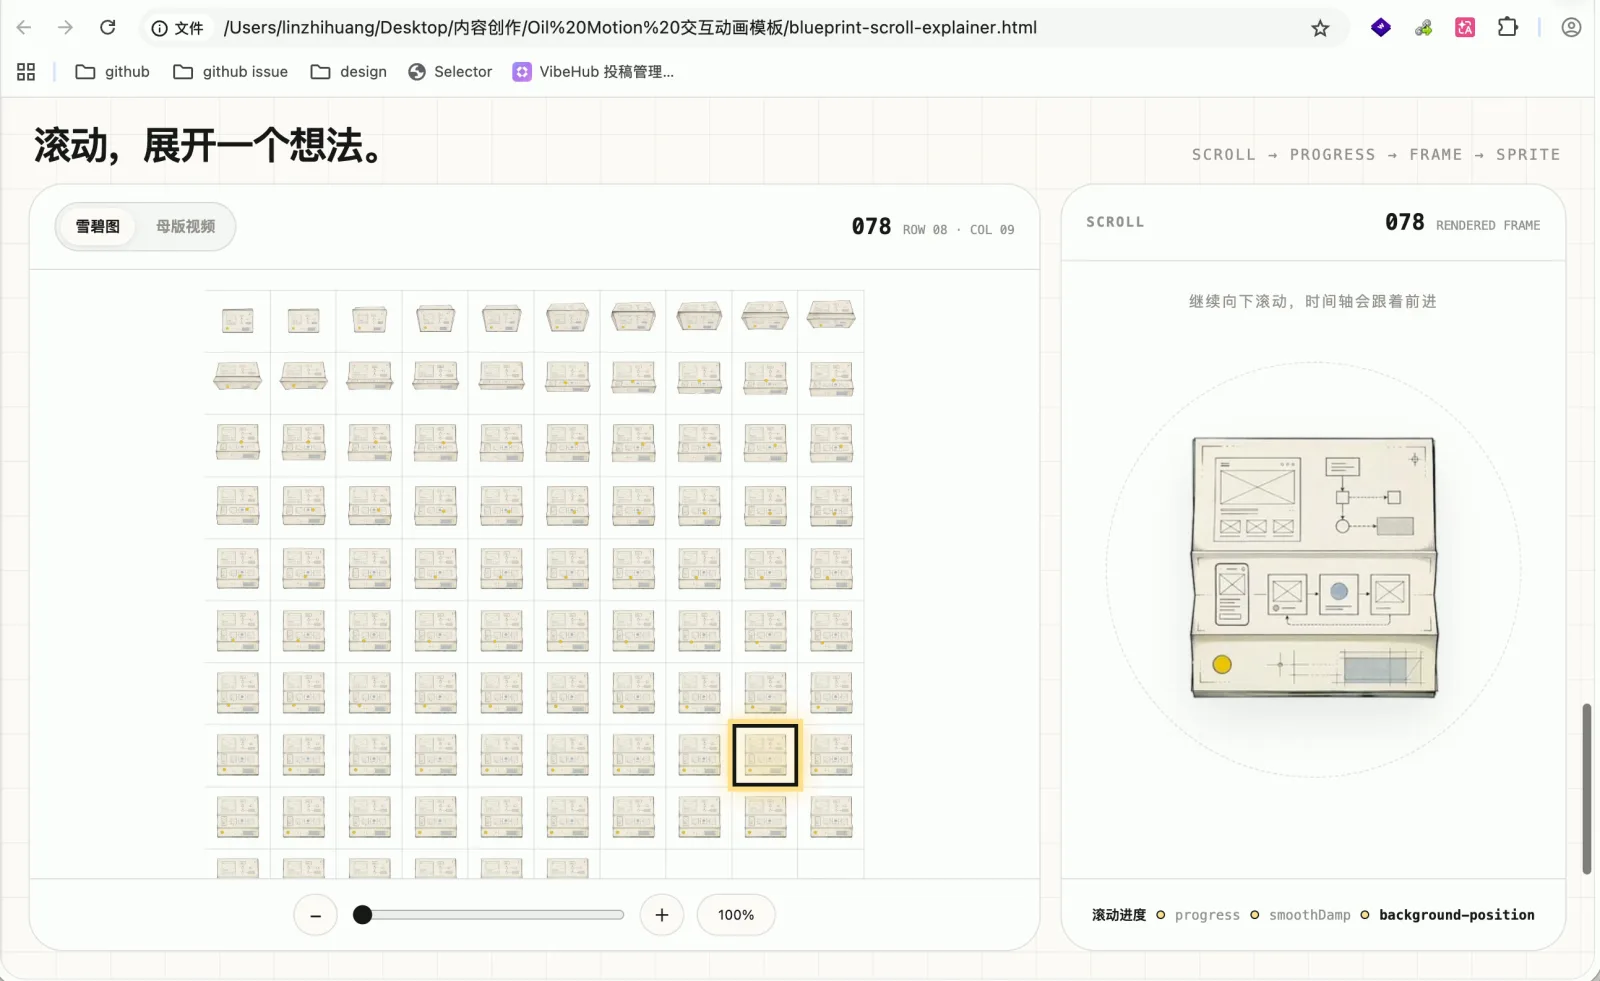
更进一步,我们还可以用这个思路做出类似苹果官网产品介绍页的滚动爆炸图动画:
我们把一台完整的 iPhone 作为首帧,把一张精细拆解的 iPhone 爆炸图作为尾帧,交给 AI 视频模型生成中间的连贯拆解过程。生成视频后切成序列帧放进网页,当访客向下滑动页面时,原本紧凑的手机就会在滚动中慢慢散开,各个内部零件逐一悬浮展现。
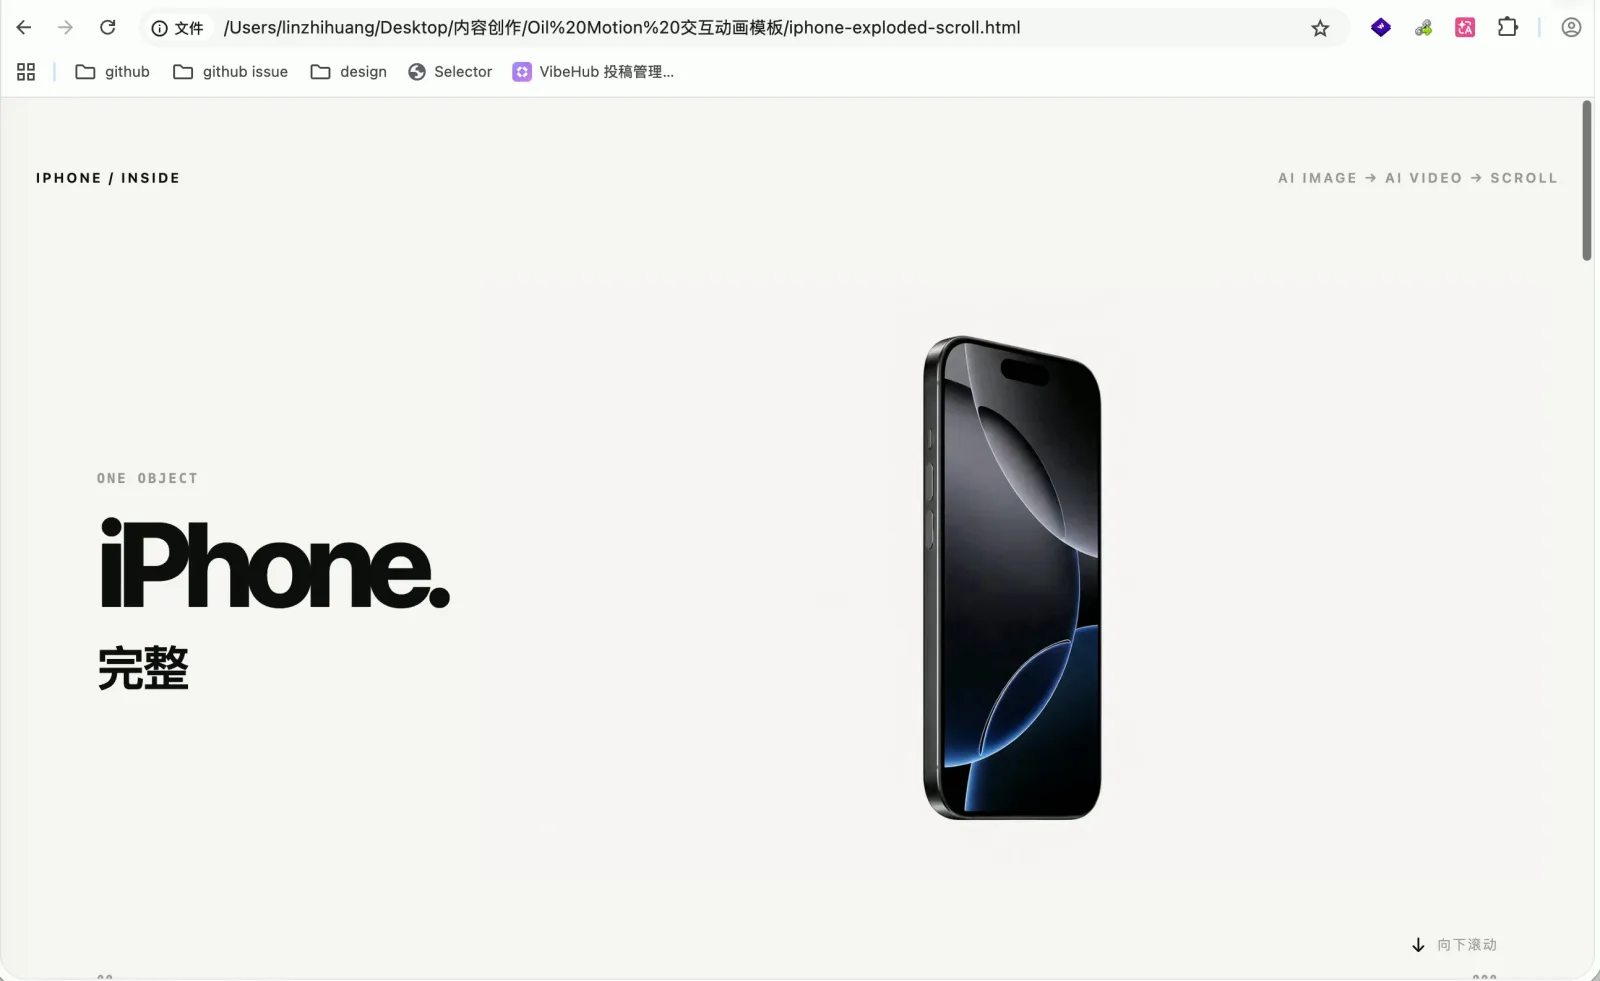
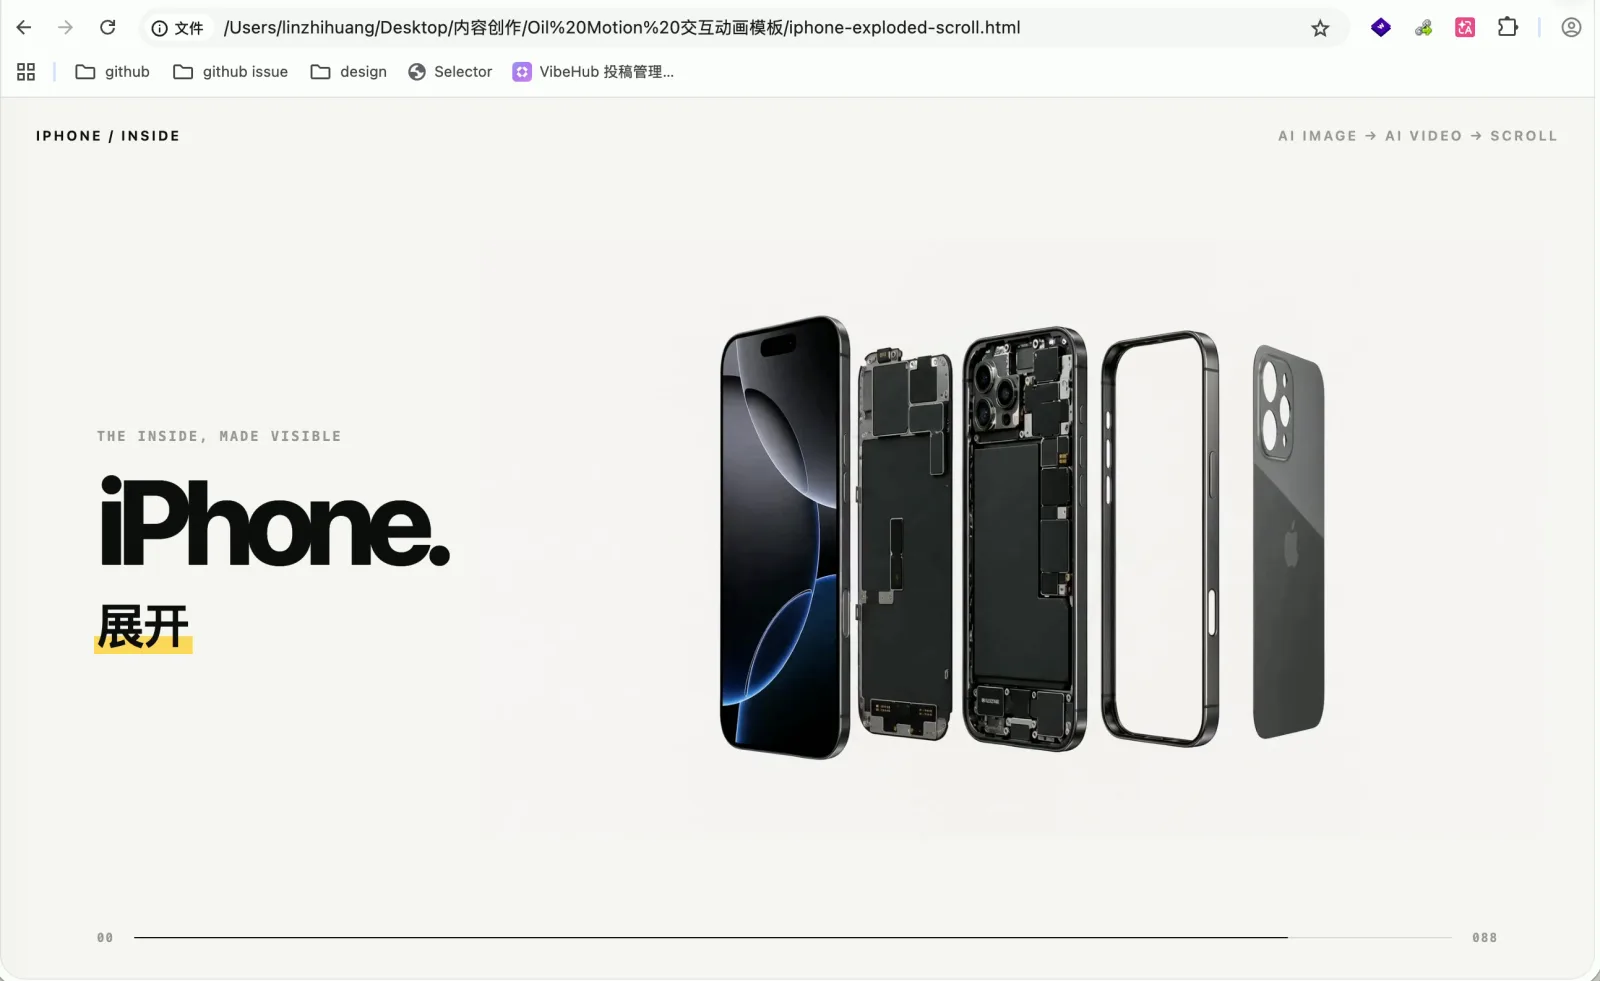
如果想做更长的一镜到底动画,还可以通过首尾帧接龙的方式一直做下去:手机散开成零件之后,把散开的尾帧作为下一段视频的首帧,再生成一段零件重新汇聚、拼接成一台 iPad 的过渡视频。这样访客顺着页面一路往下滚,画面就会自然地从手机平滑演进到平板电脑,呈现出类似官网穿梭镜头的交互质感。
开源 Skill:oil-motion
我把这套从视频取帧、补帧、拼雪碧图到输入映射的完整流程,整理成了一个开源 Skill oil-motion。这篇文章里的各个交互预览,也是通过这个 Skill 自带的模板运行出来的,动画生成之后可以直接在本地预览最终效果与原始视频对照。
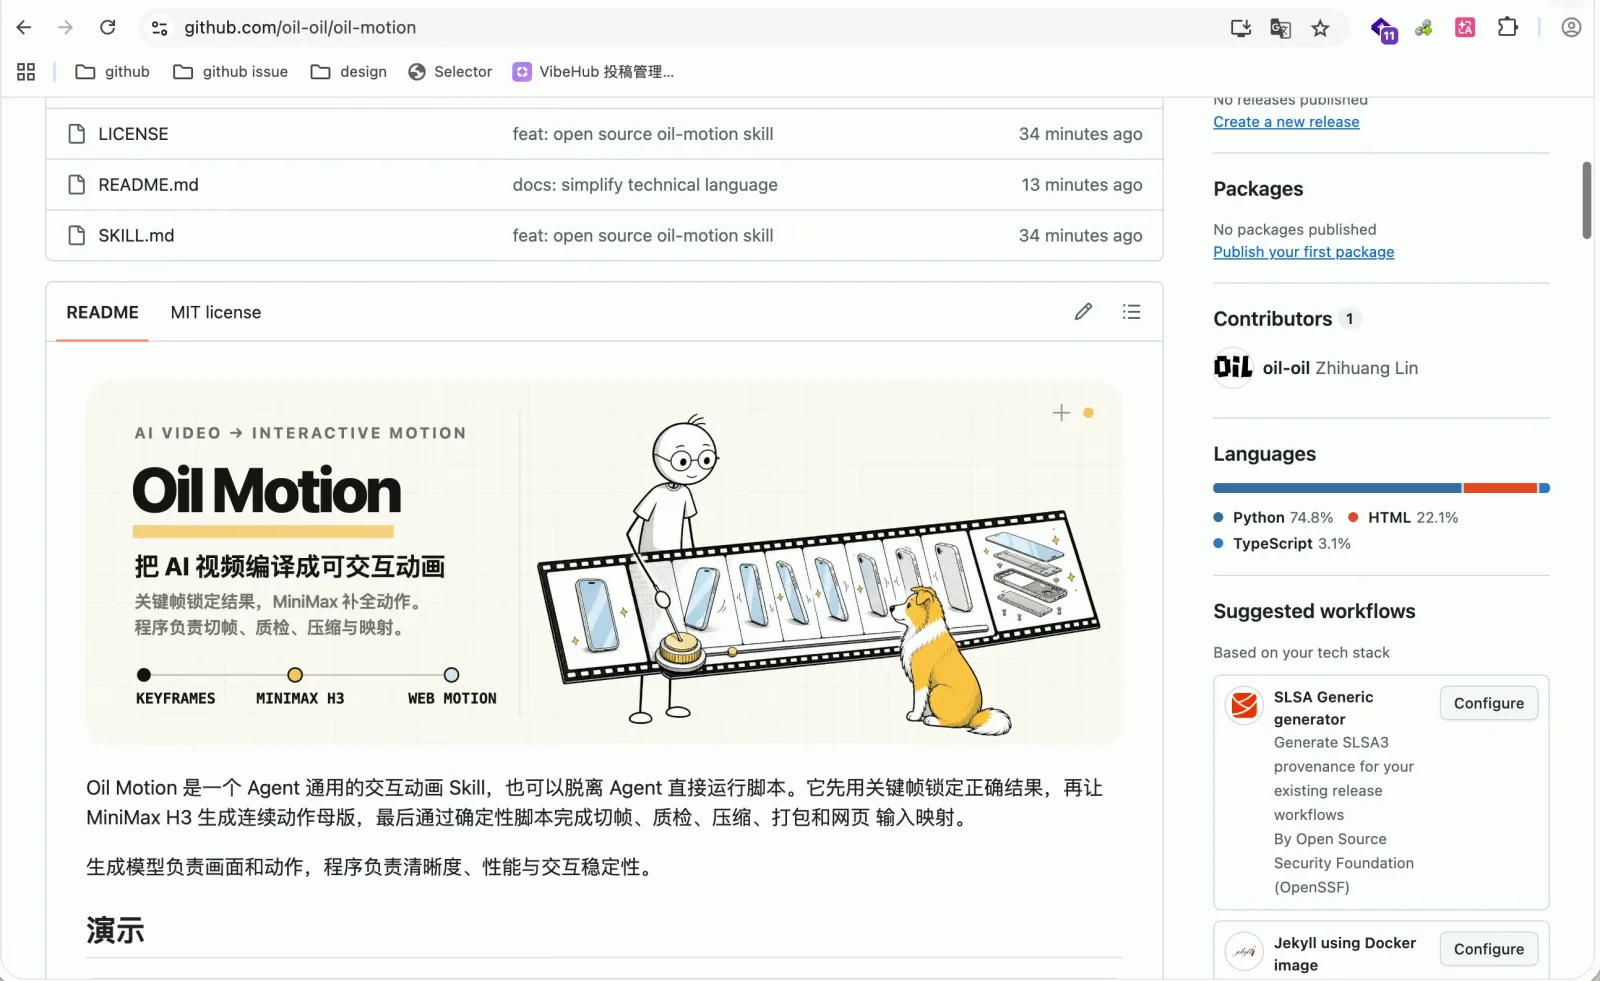
安装非常简单,直接让 Agent 安装 https://github.com/oil-oil/oil-motion 即可。
因为视频生成依赖 MiniMax H3,第一次使用时,Agent 会引导在终端配置一次 ZenMux API Key。密钥只保存在本地机器上,后续调用会自动读取。
Skill 内部已经封装了鼠标跟随、页面滚动和移动端重力感应等常见交互模式。如果大家有自己具体的动画想法,只要把想要的交互逻辑和角色描述提供给 AI Agent,它就能自动生成对应的素材并把整套交互组装好。