我在 vibe coding 里控制开销时,会同时考虑 token 用量和模型单价。不同模型的价格不一样,只减少 token 用量,很多时候没法在保证相同执行质量的前提下把总开销降下来。我的目标是在完成相同任务的情况下,尽可能减少整体开销。
按任务混合使用不同的模型
不是所有的任务都值得用贵的模型,不同模型的取向也很不一样。我自己的搭配是:
- Claude Sonnet 是主模型,负责和我对话、拆解需求,我自己用得最多的工具是 Claude Code;
- 写前端代码用 GLM,写后端代码用 Codex,都在 Claude Code 这一个入口里以子 Agent 的方式调用,分别配置各自的模型执行;
- Gemini 用来出设计稿。
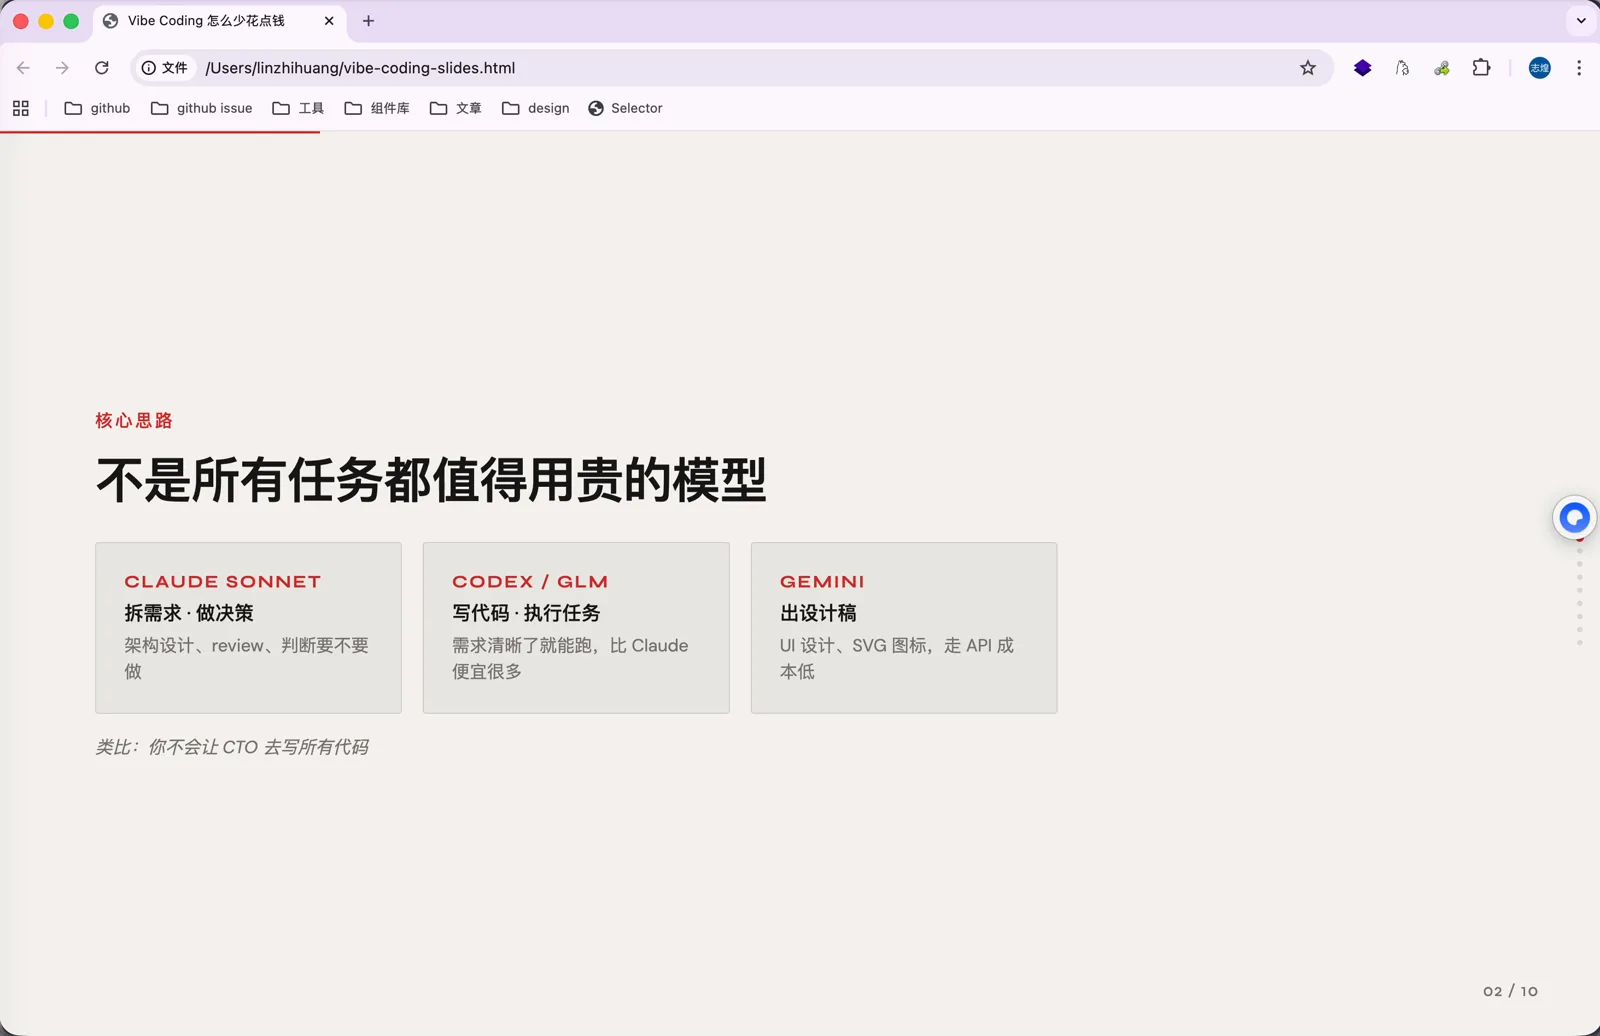
这样分配是因为各模型擅长的方向不同。比如设计稿这件事,我用 Gemini 一次就能做好,换 Claude Sonnet 去做效果不好,反复修改反而是在浪费钱。而复杂的前后端任务,Claude Sonnet 自己拆解需求再执行也能做好,但 GLM 和 Codex 的 token 价格比 Claude Sonnet 便宜:GLM 大概是 Claude 的十分之一,Codex 如果走代理站,开销几乎可以忽略。把任务拆给这些模型会消耗更多的 token,但按单价算下来,整体价格更低。
之前有人在视频下面问,买这么多模型的订阅不是很贵吗。可以算一笔账:假设原来花 2000 块钱全部用 Claude Sonnet,现在花 1000 块用 Claude Sonnet,再花 500 块买其他的模型,整体开销就省了 500 块。前提是我的用量足够大、任务足够多。
主模型选 Sonnet 而不是 Opus
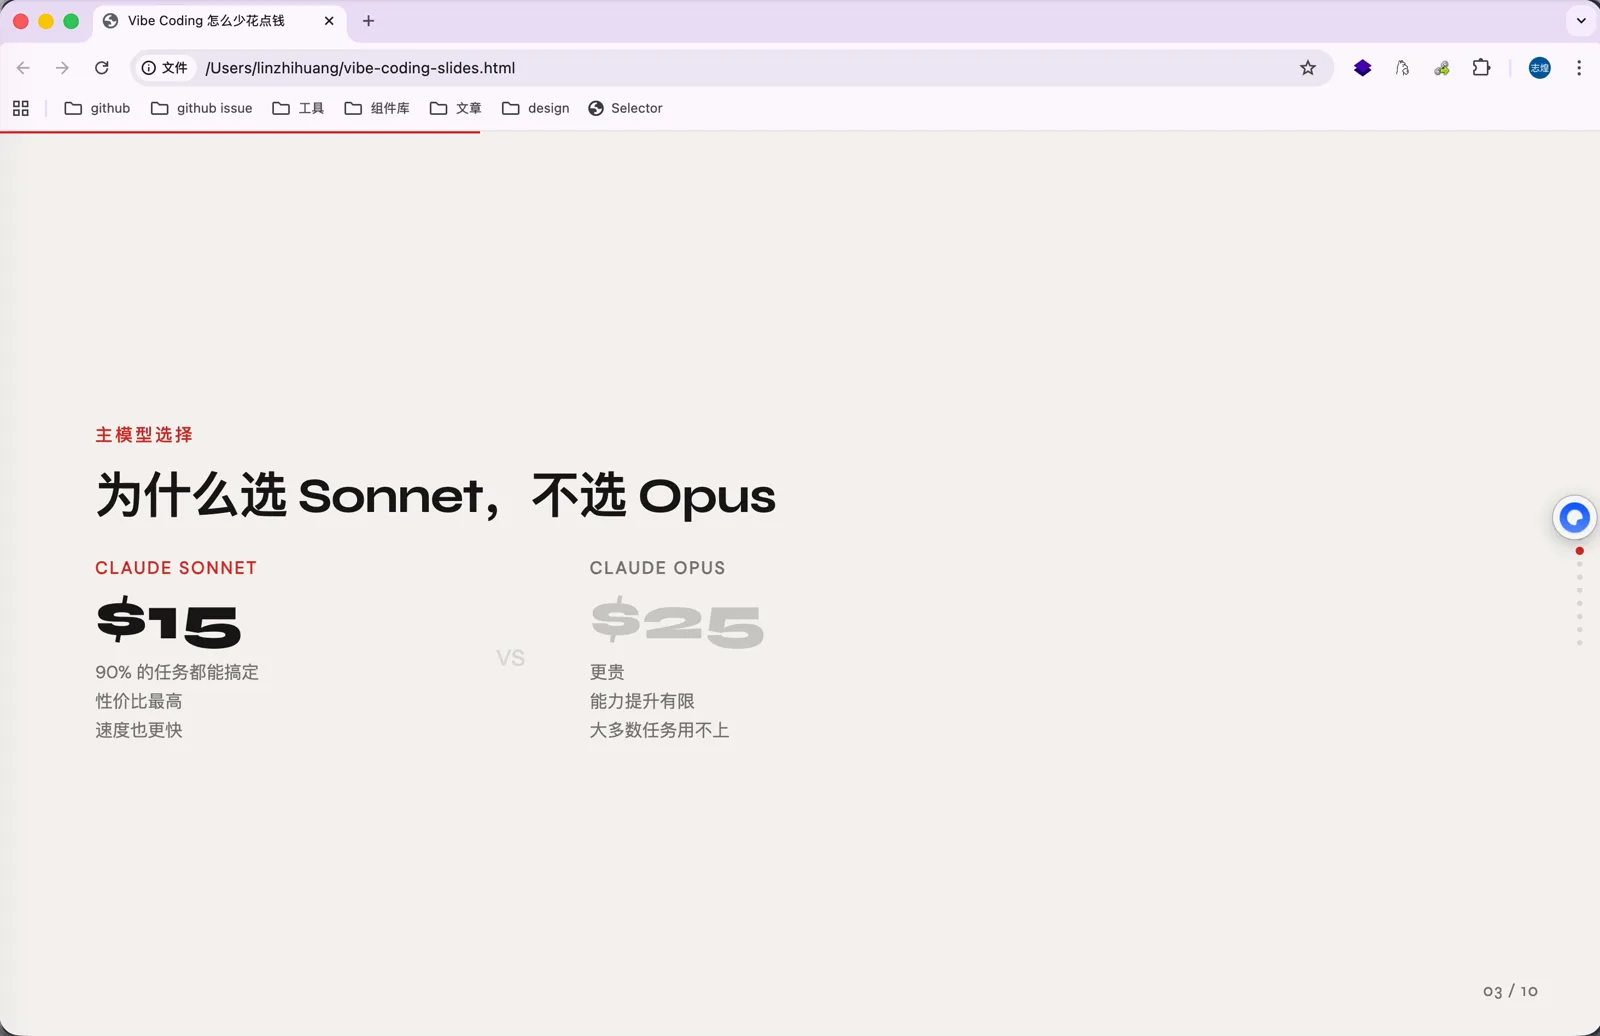
我的主模型之所以是 Claude Sonnet 而不是 Opus,起因是一次意外的配置:我不小心把主模型设成了 Sonnet,一直没发现,用了一个星期才知道。我平时用量比较大,对执行效果比较敏感,但那段时间大多数时候 Sonnet 的执行效果都不错。
价格上,Sonnet 是 15 美金每 100 万输出 token,Opus 是 25 美金每 100 万输出 token。用量大的话,一天下来节省的开支就很可观。而且这不是一个非此即彼的选择,真有 Sonnet 处理不了的任务,我再临时切到 Opus 就可以。
能用脚本做的,不要让 AI 做
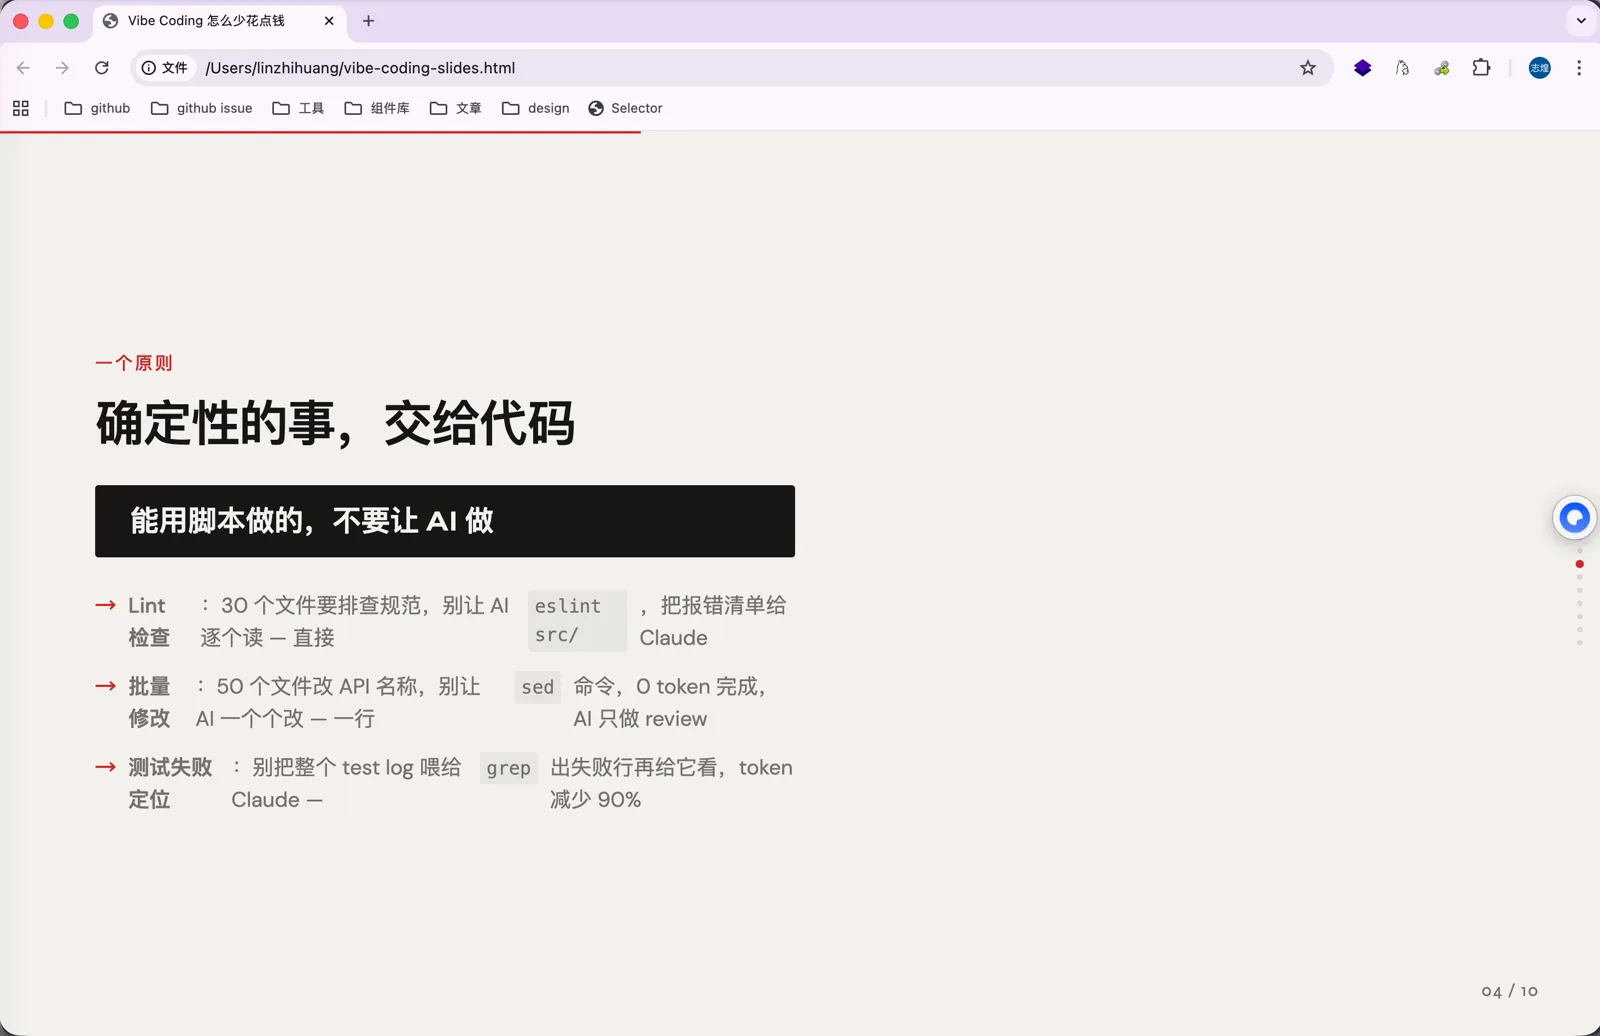
这是另外一个非常重要的原则:能用程序、能用脚本完成的事情,就不要让 AI 自己去执行。举三个例子。
第一个是代码检查。如果让 AI 自己检查代码,它很可能要把每个文件都读一遍。但如果配好 ESLint 这类工具的规则,AI 只要调用一次脚本,比如直接运行 eslint src/,就能拿到所有文件的检查清单,通过程序的方式减少 AI 自己的输入输出 token 量。
第二个是批量修改。如果不明确说明,AI 很有可能和人一样,先搜索代码的位置,再一个一个替换。如果让它写一个脚本批量替换,比如一条 sed 命令改完 50 个文件,事情很快就完成了,AI 只需要 review 结果,既省 token,执行速度也更快。
第三个是测试日志。日志打到控制台往往一大堆,全部复制下来有很多冗余内容。处理方法有两个:打日志的时候就告诉 AI 不要打得太膨胀,重复输出同样内容的地方要合并;另外我们人有开发经验的话,复制时可以自己挑选和当前问题相关的日志喂给 AI,而不是一股脑全部塞给它。这样既能帮助 AI 更好地定位问题,也能节省开销。
RTK:只把有价值的输出传给模型
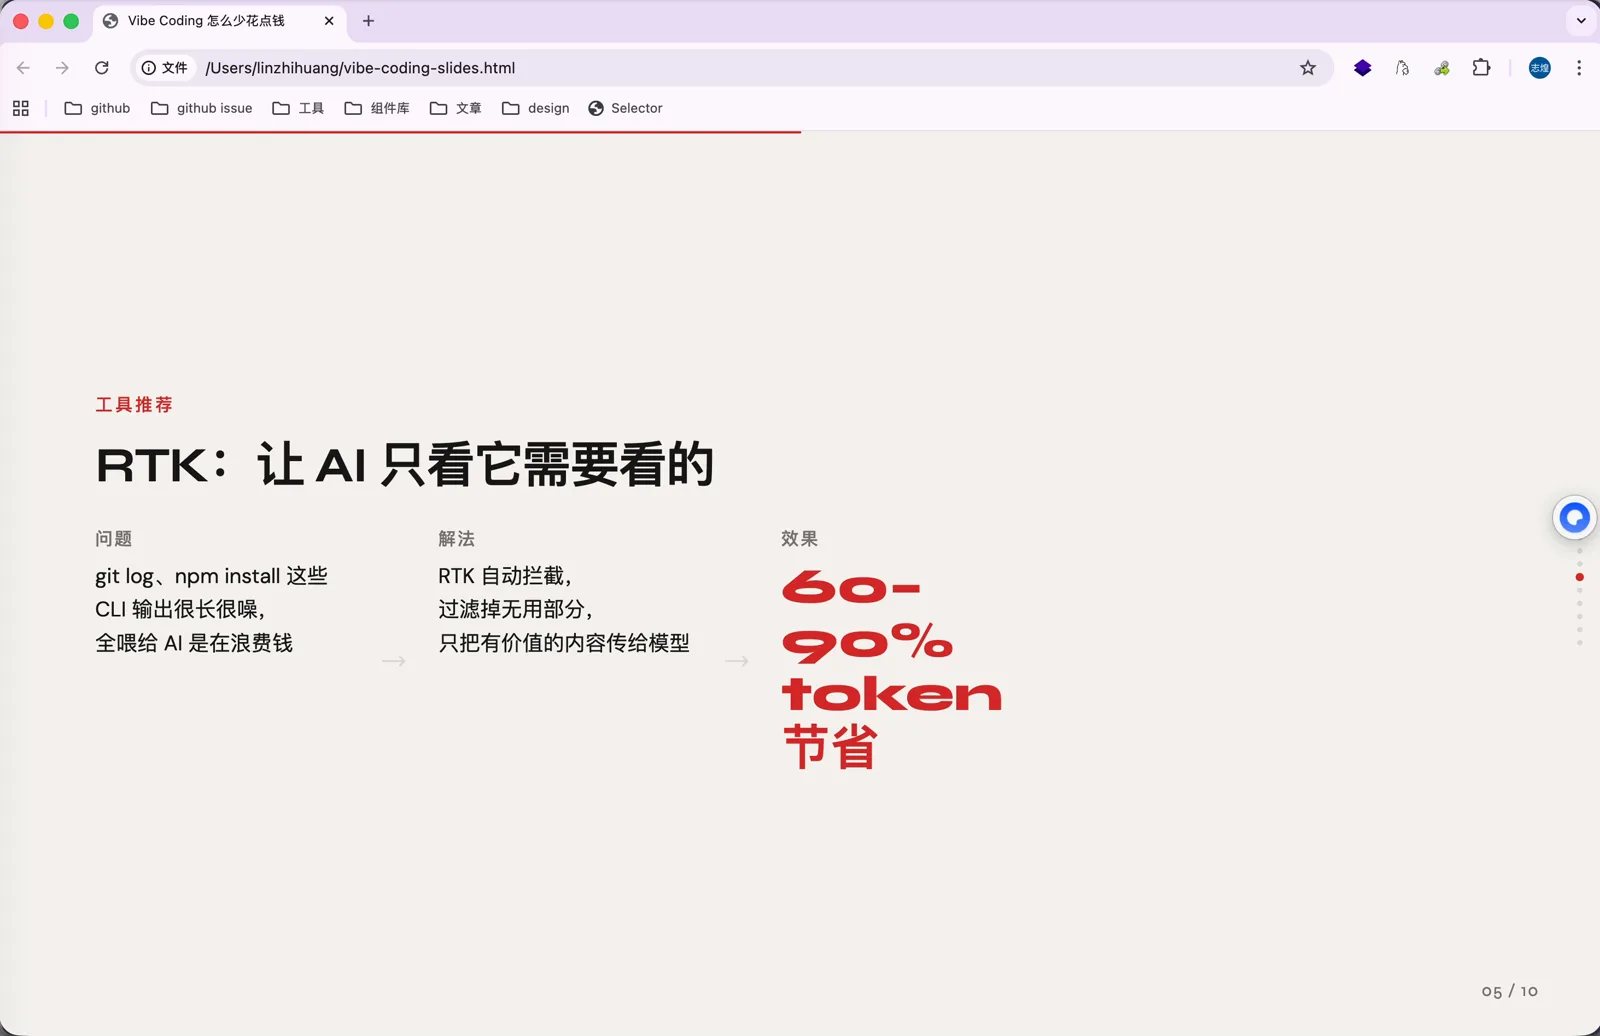
RTK 是一个可以配置在 Claude Code hook 上的工具。Claude 执行 git log、npm install 这类命令时,输出会带有大量额外信息,这些信息原本是给人看的,人没有上下文开销的问题,写得越清楚越好;但给 AI 看,很多噪音信息就是在浪费钱。RTK 会把这些输出过滤压缩之后,再把有价值的部分传给模型。
仓库地址是 github.com/rtk-ai/rtk,按照官方文档安装就两步:
brew install rtk
rtk init -g
rtk init -g 会把自动改写命令的 hook 装进 Claude Code,装完重启 Claude Code 生效,之后 Claude 执行的 bash 命令会被自动改写成 rtk 版本。
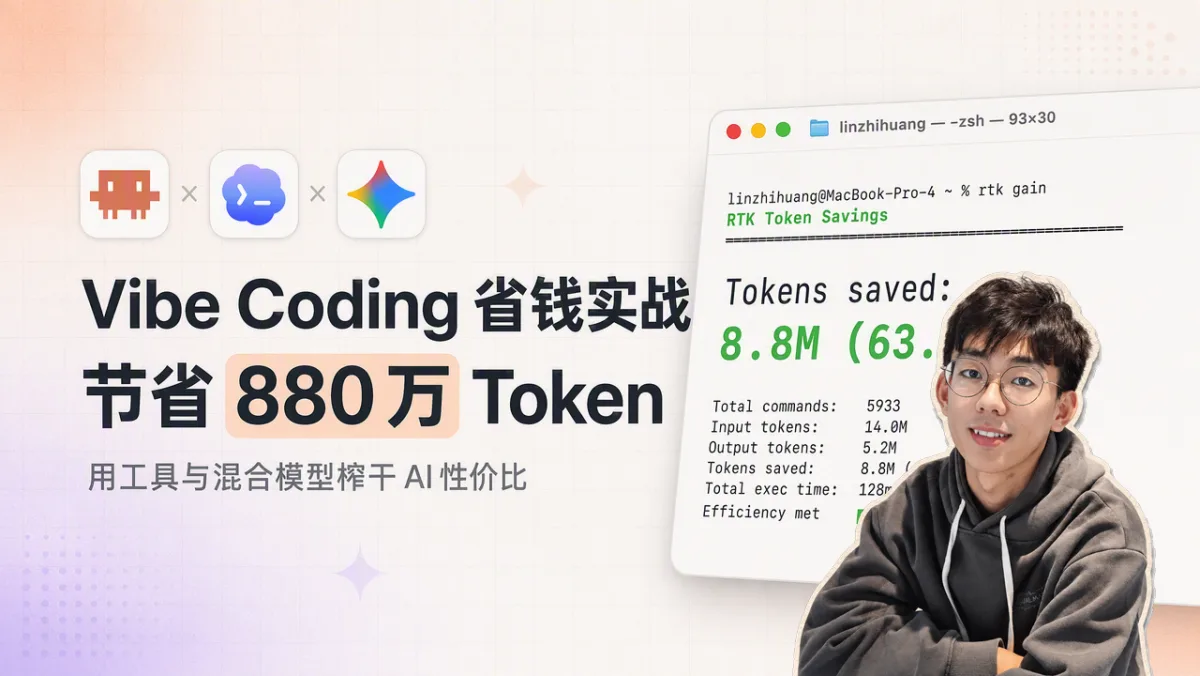
它还有一个查询节省了多少 token 的命令 rtk gain。下面是我的统计:目前一共节省了 880 万 token,节省比例 63.1%,节省的主要是输入 token。帮我节省最多的命令是 lint 相关的代码检查、代码格式化和读文件这几类。
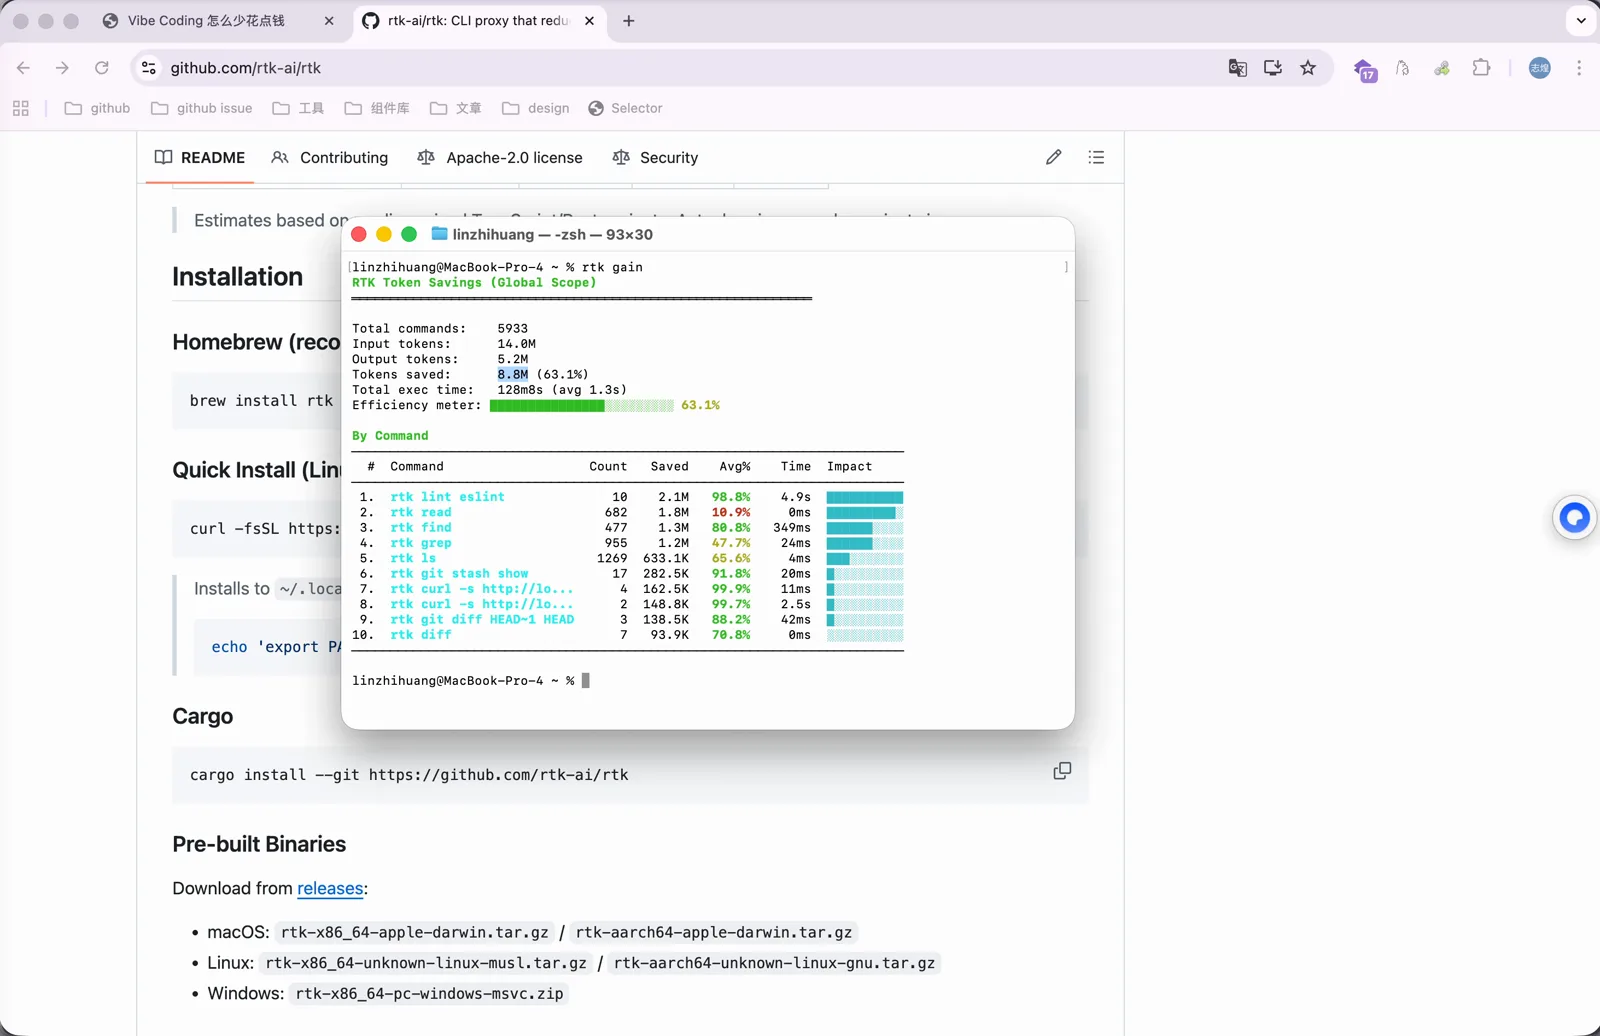
配置这个工具之后,AI 的执行效果不仅没有削弱,反而是增强的,因为上下文更干净、噪音更少。我觉得这类工具非常实用。
用 Skills 减少重复探索
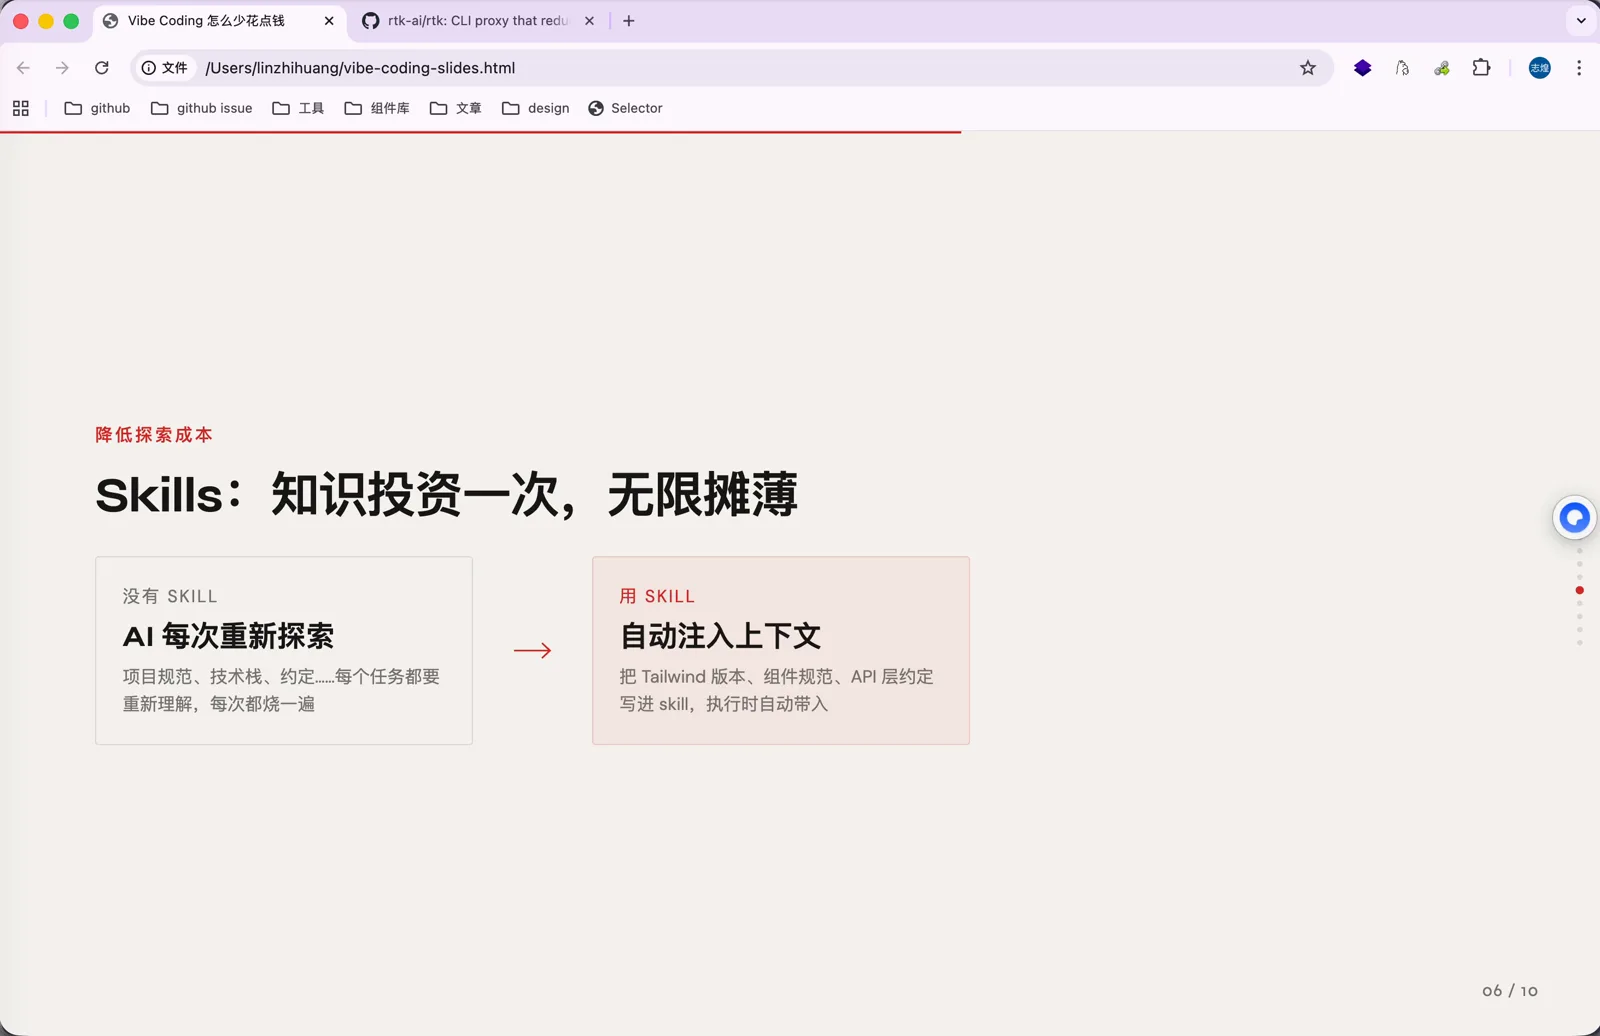
Skills 的作用是把我常用的工作流记录成 skill 的格式。在我自己的项目里,我会维护前端和后端相关的 skill:前端 skill 里是组件规范,以及前端可以调用的 API 端口;后端 skill 是业务层面、整体架构层面的规范。这些规范分别提供给前后端对应执行的 Agent。
和 CLAUDE.md、AGENTS.md 不太一样的地方是,skill 可以写很多内容,并且支持渐进式加载:这次任务涉及组件,AI 就读组件的规范;要写落地页,就读配色和落地页相关的规范。我把多种规范集合成 skill,帮助 AI 快速了解整个项目,它每次新开上下文之后需要花时间探索的代码就少很多,结果也更准确。
新话题的冷启动
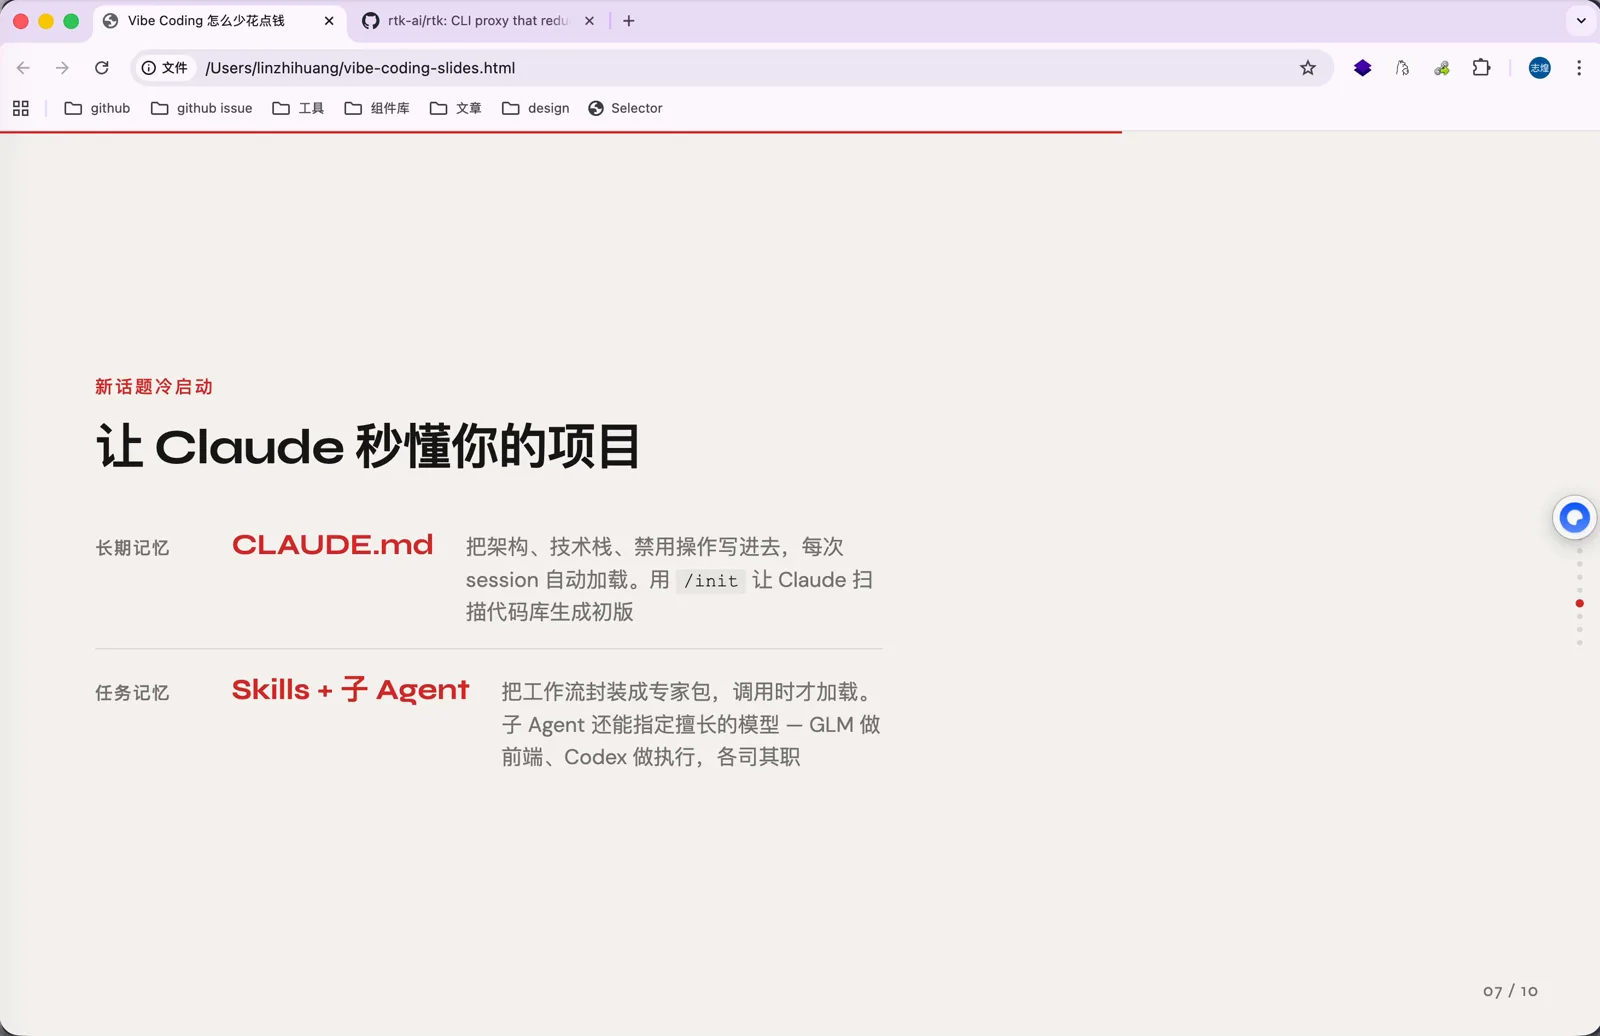
在 Claude Code 里每开一个新的话题,它是没有任何记忆的。最常用的方式是用 /init 让 Claude 扫描整个代码仓库,把使用的组件库、代码依赖和整体架构写进 CLAUDE.md,帮助 AI 在新话题里快速了解项目。
另外一个做法是把子 Agent 也包装成 skill。比如 Codex 是我的后端开发,Claude 在调用这个 Agent 的时候,我会明确让它读取后端对应的 skill。这样子 Agent 的上下文更加独立,Claude 进入项目时不用把前后端代码全部读一遍,只要先拆解我的需求,再调用对应的子 Agent,由子 Agent 去读自己的 skill。整体执行效率更高,而且各司其职之后,GLM、Codex 这些比较便宜的模型可以负责更大量的执行,极大节省开销。
对话管理
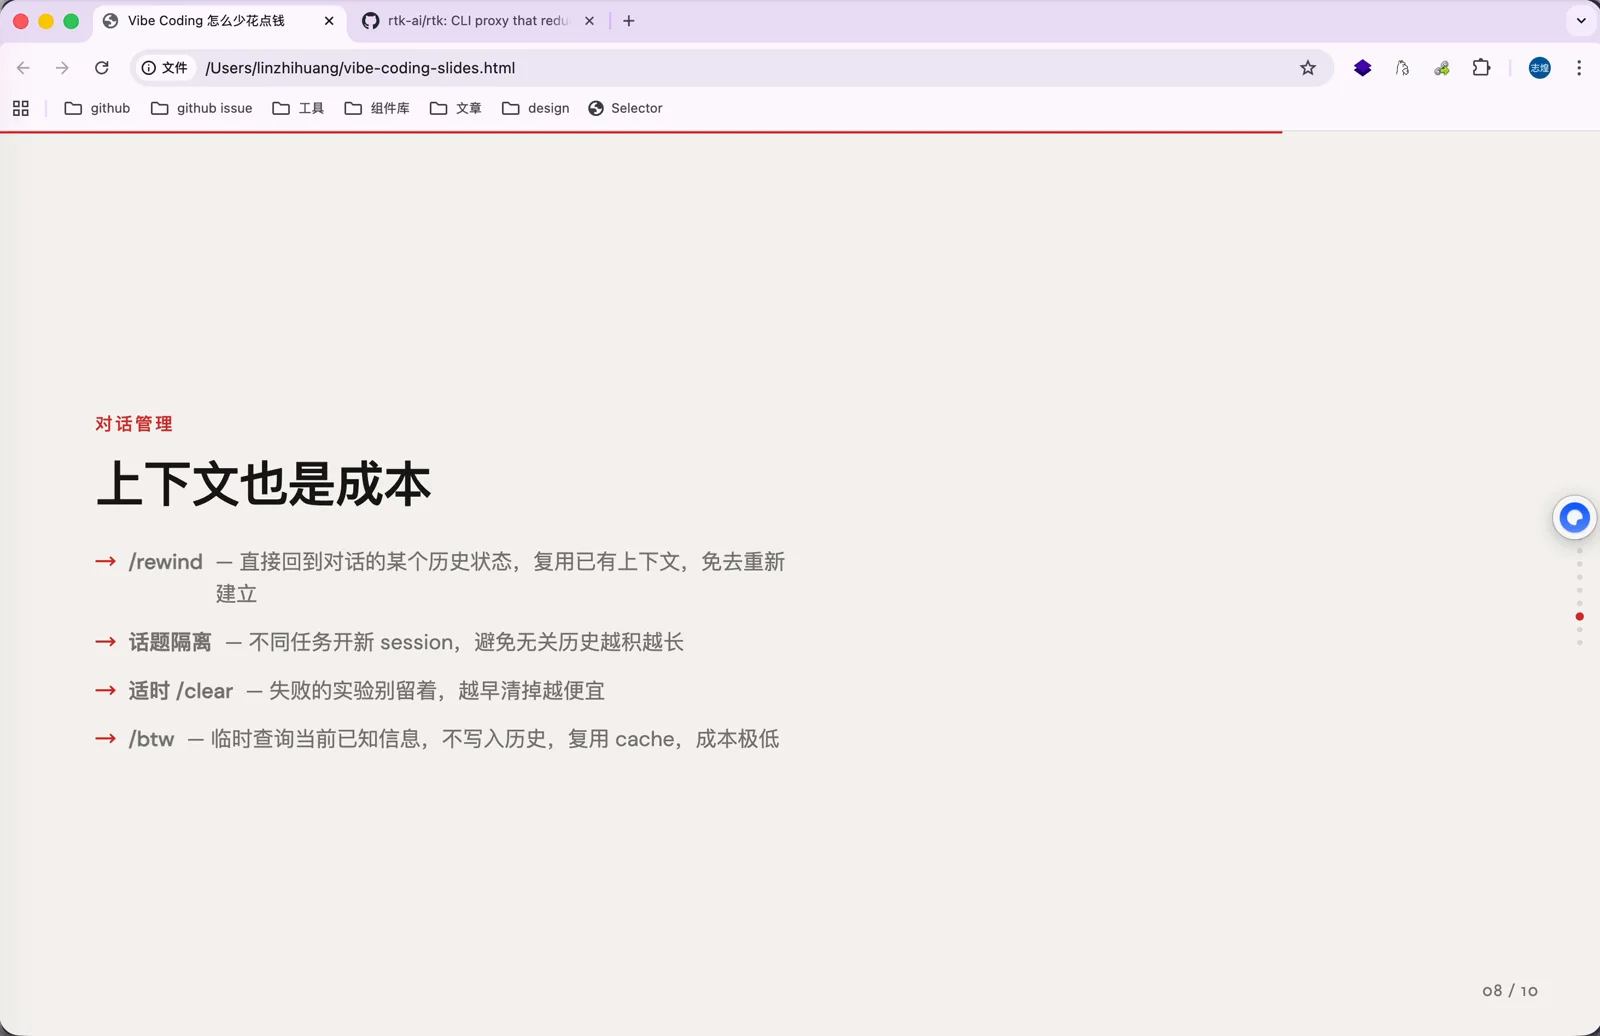
对话管理里有一个我非常常用的技巧。在一个很长的对话里已经执行了很多任务,突然有一个新任务也依赖当前会话的上下文:有些工具有 branch 功能,可以从长对话的某个位置切一个分支出来,比如 AI Studio。Claude Code 里没法切分支,但可以用 /rewind 把后面的对话直接从上下文里去掉,同时不回滚代码。这样既保留了前面对后续任务有用的信息作为上下文,又不用完全重开一个对话、重新探索代码。之前的上下文对新任务有没有价值,这个由我自己评估。
然后是话题隔离。不要把完全不同的任务都放进同一个会话,可以新开一个会话,或者重新打开一个终端让它独立执行。这样可以隔离上下文,两个任务也能并行。如果不需要并行,直接使用 /clear,就相当于新开一个话题。
Claude Code 里还有一个比较实用的命令 /btw(by the way)。它可以基于现有的上下文快速问一个简单的小问题,这个问答不会插入原本的上下文。比如 AI 正在修改另外一个逻辑,我对之前的实现有个疑问,直接 /btw 把问题问进去,它会独立给我一个响应,不执行任务,也不会写进历史。和当前话题不太相关、又不希望污染上下文的问题,都可以用这个命令。
把需求说清楚
最后一点最容易被忽视:我们自己要把需求说清楚。AI 看代码和人是一样的,我们提供的提示词越清楚,它定位得越准。比如要修改一个位置,就要非常明确地告诉它改哪个地方。
除了用语言描述,还可以借助工具。Claude Code 支持 @ 符号,可以 @ 某一个文件。如果仓库里有多个项目,@ 某个项目里的文件,除了告诉 AI 具体的文件位置,还给了它路径,它第一次查询就能把范围缩小到对应的项目里,减少误解的风险。
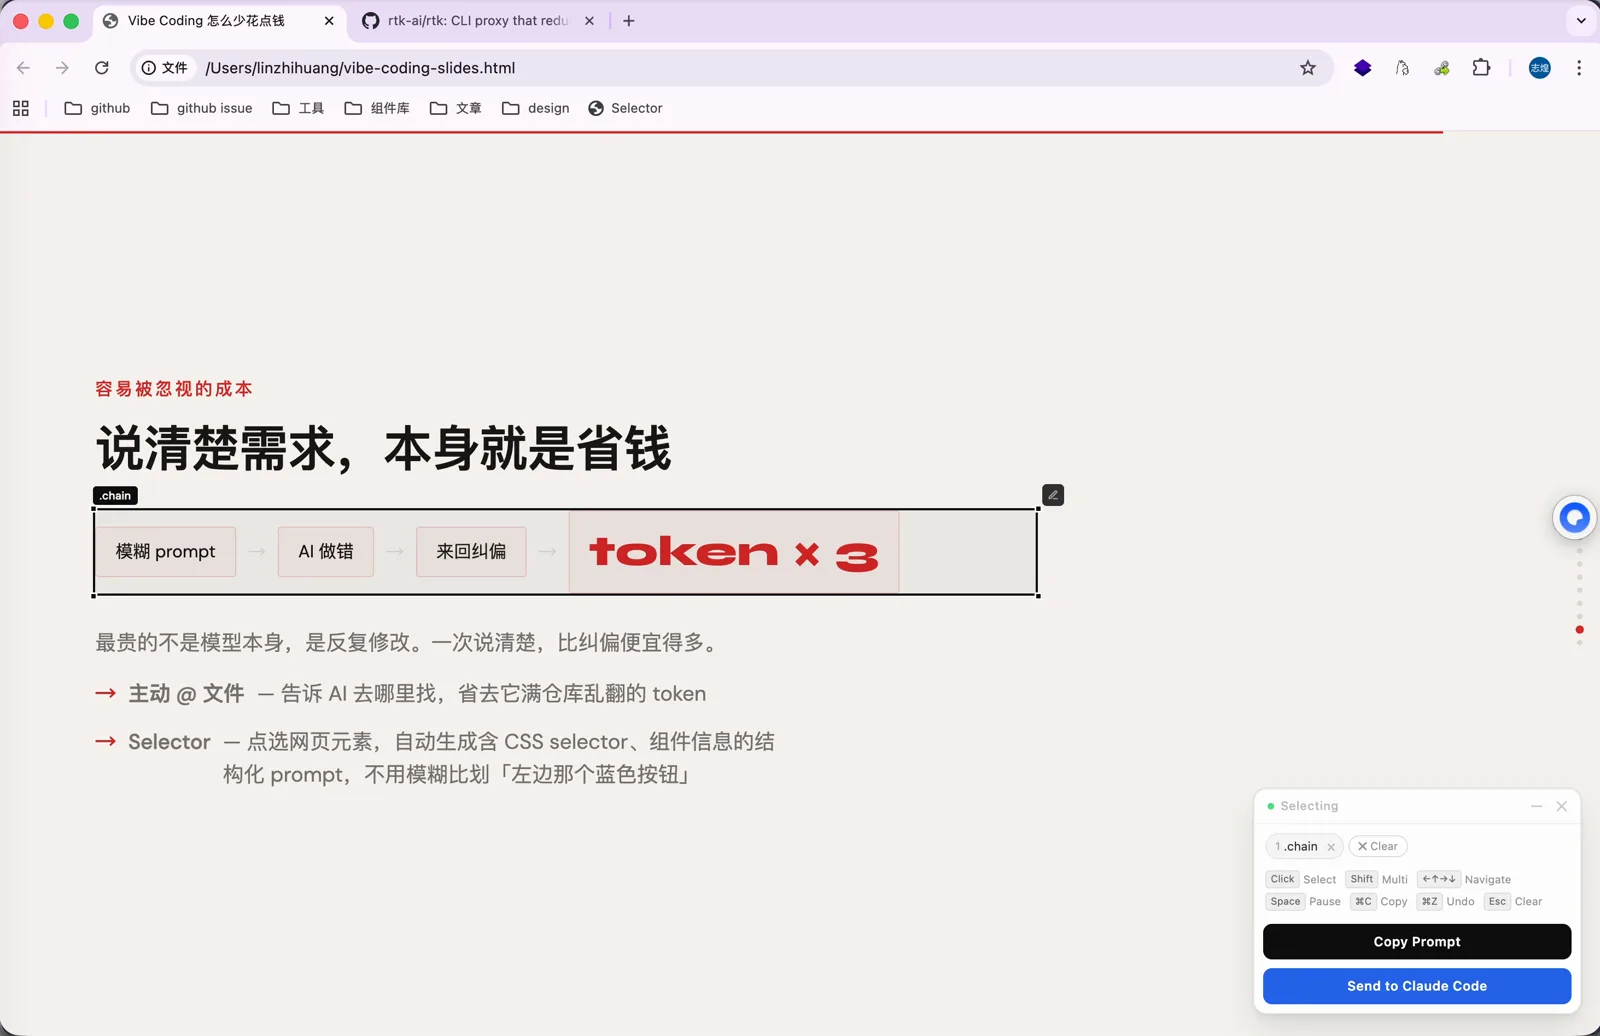
另一个是我自己做的 Selector 工具。点击之后可以在页面上选择元素,按 Cmd+C 就能把元素复制为提示词,里面包含元素的 CSS selector、组件信息和样式信息。告诉 AI 要修改 UI 的时候,不用再截图,也不用费劲描述「页面上哪个位置的下面的哪个地方」,这种描述其实很难说清楚;也不用自己打开控制台去看元素有哪些类型和样式文件。对 AI 去查代码来说,这是最直观的方式。