我们现在创建 Skill 大多是通过 AI 生成的。但如果没有人为地提供 knowhow,生成出来的 Skill 帮助其实不大:让 AI 自己写给 AI 自己看的内容,它只会用到自己已有的知识,效果不会好。
所以有必要了解 Skill 本身的工作原理和写法。Codex 自带一个叫 Skill Creator 的 Skill,它就是创建 Skill 的官方指南。我让 Codex 基于这个 Skill 生成了一份 HTML 讲解文档,这篇文章按照这份文档,把 Skill 的设计原理整理出来。
Skill 是怎么被 Agent 读取的
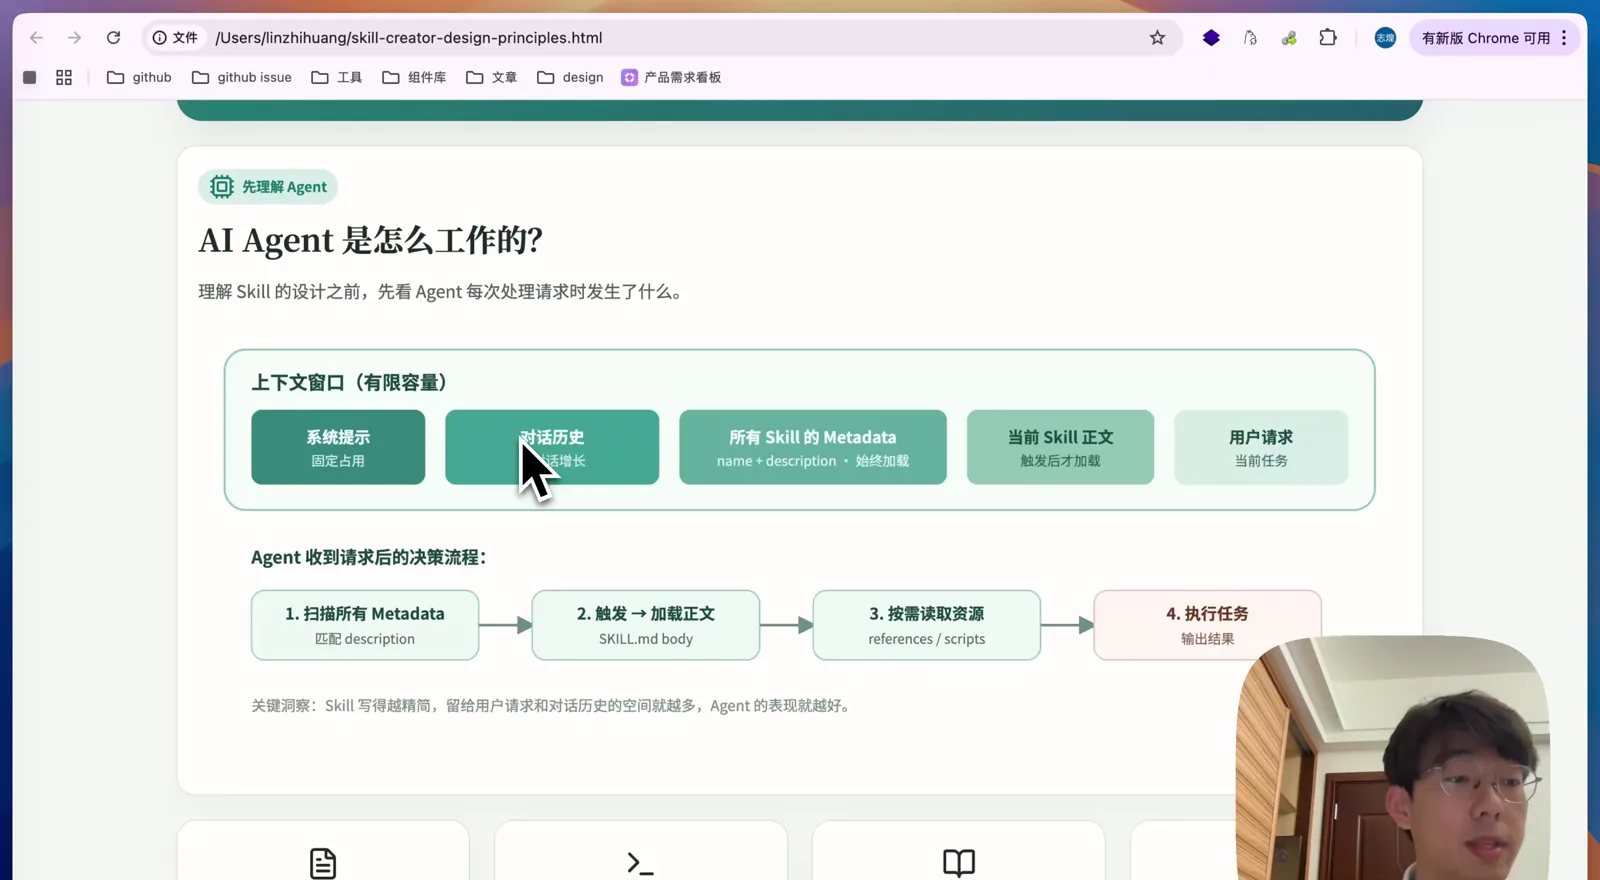
先理解 Agent 每次处理请求时发生了什么。AI Agent 有一个容量有限的上下文窗口,里面装着这几样东西:
- 系统提示:固定占用,比如「你是某个 Agent」;
- 对话历史:我们的每一次提问和 AI 的响应,随对话增长;
- 所有 Skill 的 metadata:始终加载,是每个 Skill 的 name 加 description;
- 当前 Skill 的正文:触发之后才会加载;
- 用户请求:当前任务本身。
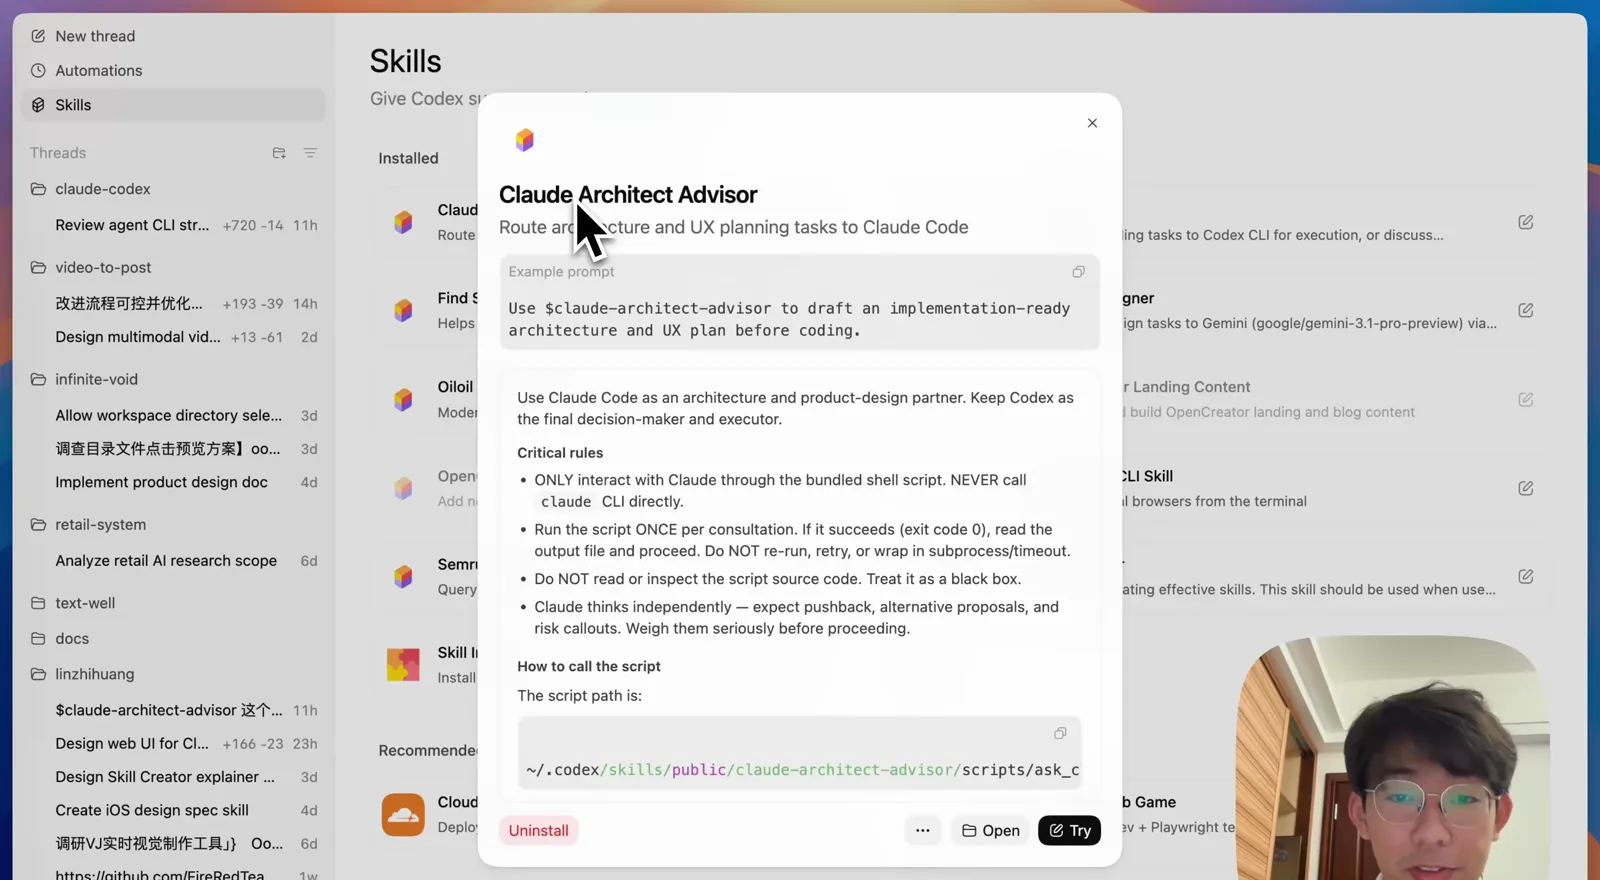
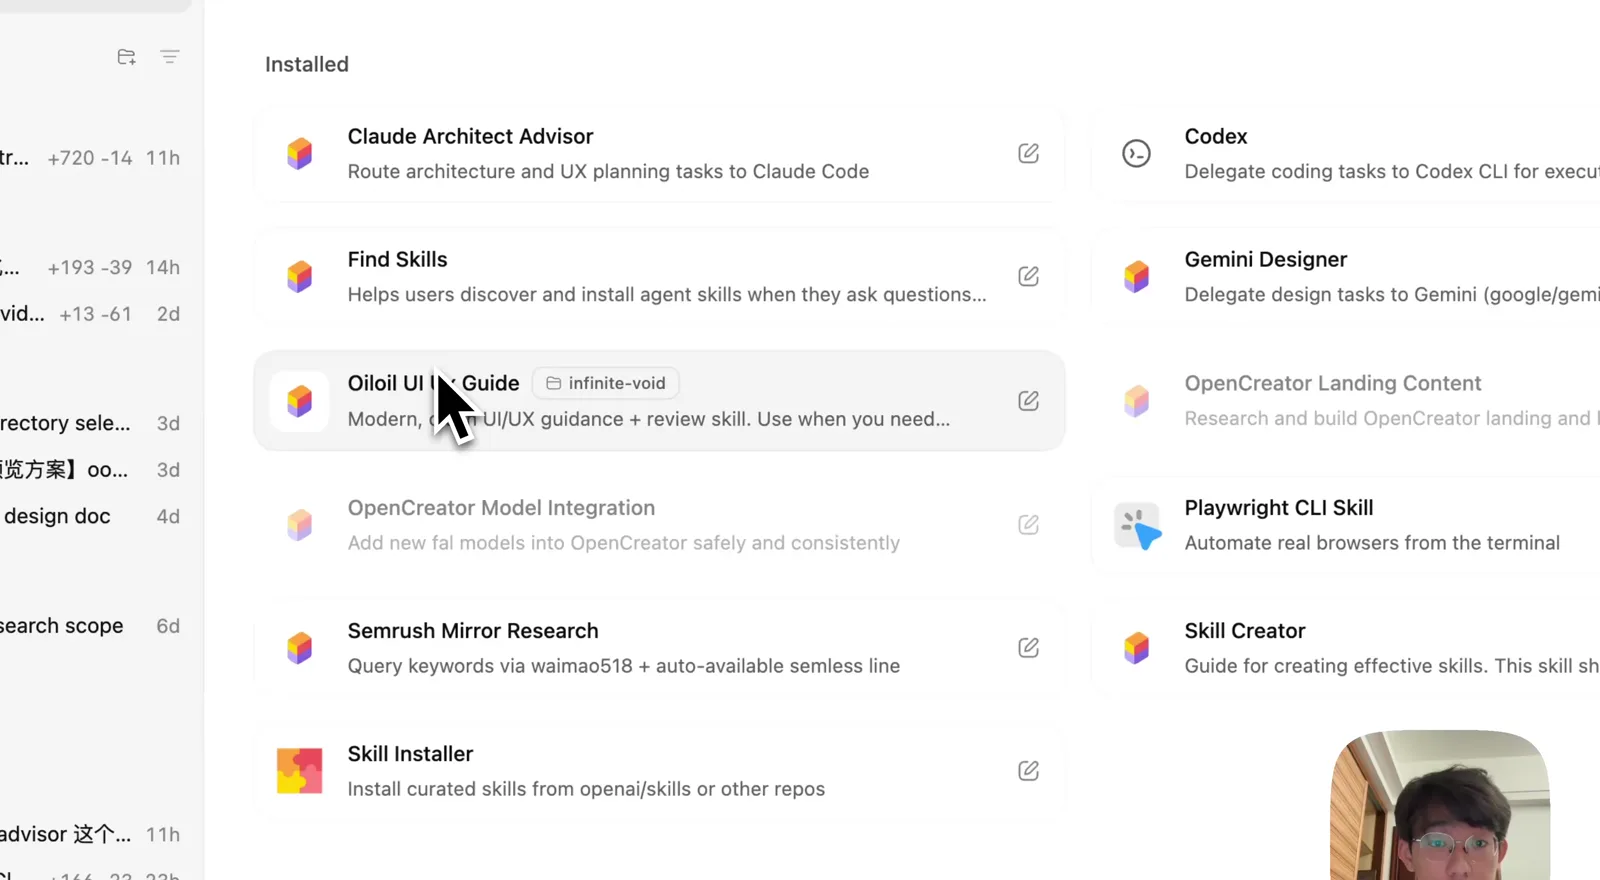
metadata 里的 name 和 description 很重要。比如我有一个 Claude Architect Advisor,可以在 Codex 里调用 Claude Code 辅助做架构和 UX 规划,它的名字和描述就是 Agent 判断要不要使用它的唯一依据。
Agent 收到请求后的决策流程是四步:先扫描所有 Skill 的 metadata,把 description 和我们的需求做语义匹配;匹配成功才加载这个 Skill 的正文;正文里如果要求执行某类任务时再去读某个依赖文件,就按需读取 references 或 scripts;最后执行任务。
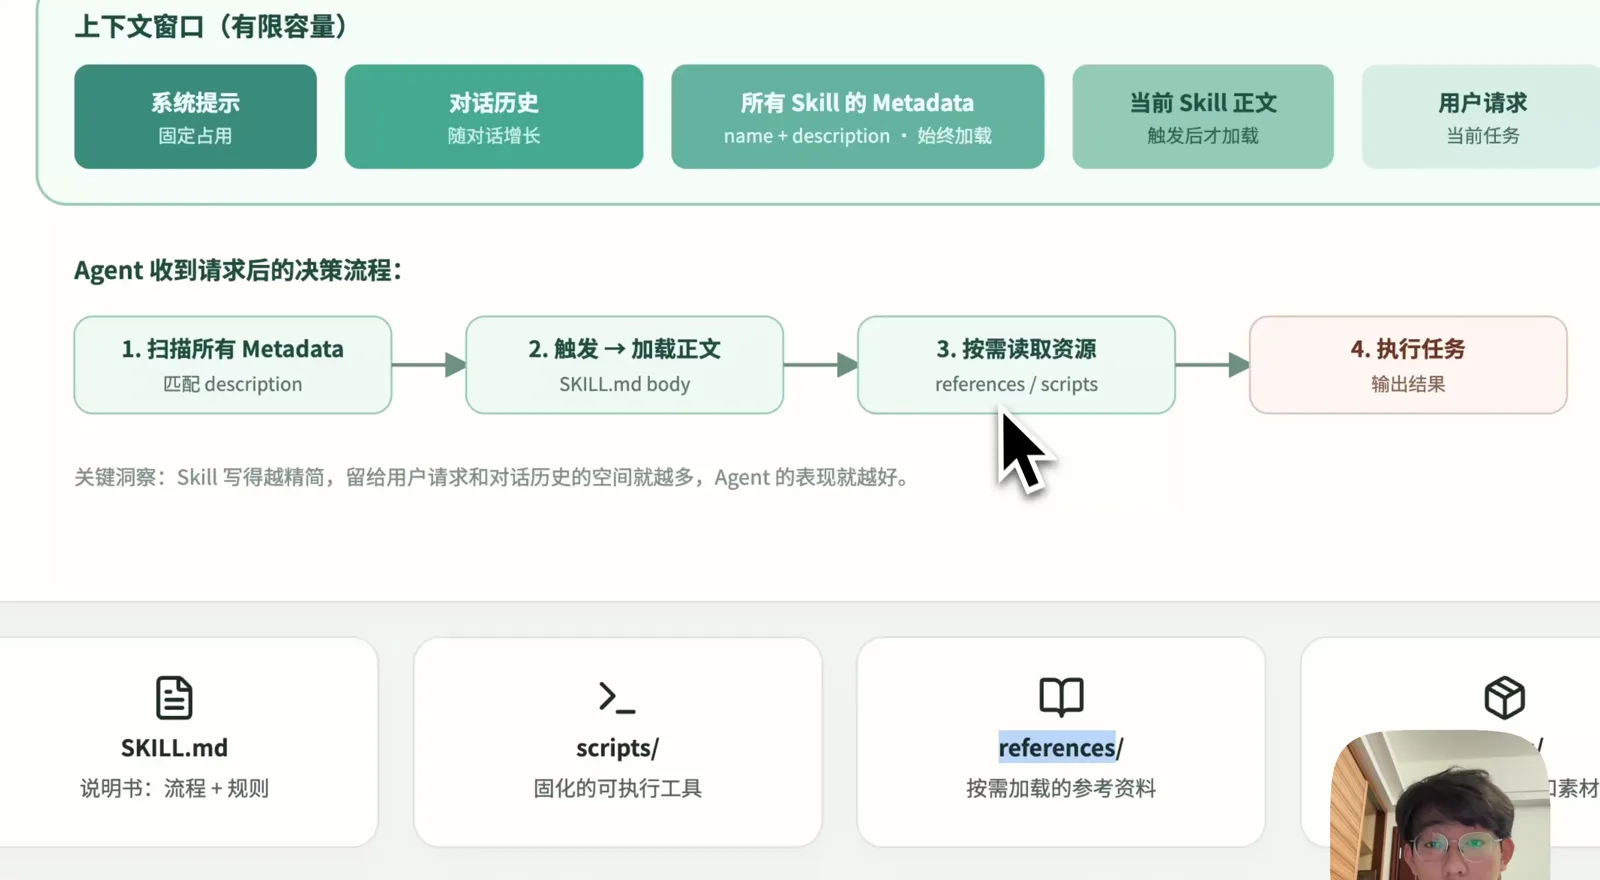
正文不默认带进上下文,是因为 Skill 越多,占用的空间就越大。有些人会配置很多宽泛使用的 Skill,觉得它们是渐进式读取、一层一层往里读的,问题不大。但本质上这些不相关的 metadata 还是会干扰 AI 的决策:我想做后端开发的时候,上下文里放着一个前端设计的 Skill 并没有作用。上下文越精简,Agent 的表现就越准确。
scripts、references 和 assets
正文之外,Skill 还可以带三类资源。
scripts 是固化的可执行工具。比如我想让 Agent 读取小红书或抖音的内容,可以编写一个脚本,把 token 之类的认证信息写在里面。这个脚本可能比较复杂,但工作量放在创建脚本的时候,之后使用时 Agent 不需要重新编写,执行效率就高。
references 是按需加载的参考资料。比如我的 UI/UX Skill 里放了一份设计心理学的内容,Agent 需要的时候会自己去读这个文件。
assets 是模板。比如视频里这份 HTML 文档,如果把它做成模板,把标题之类的内容换成占位符,下次 Agent 读到模板之后只要填空就可以了。
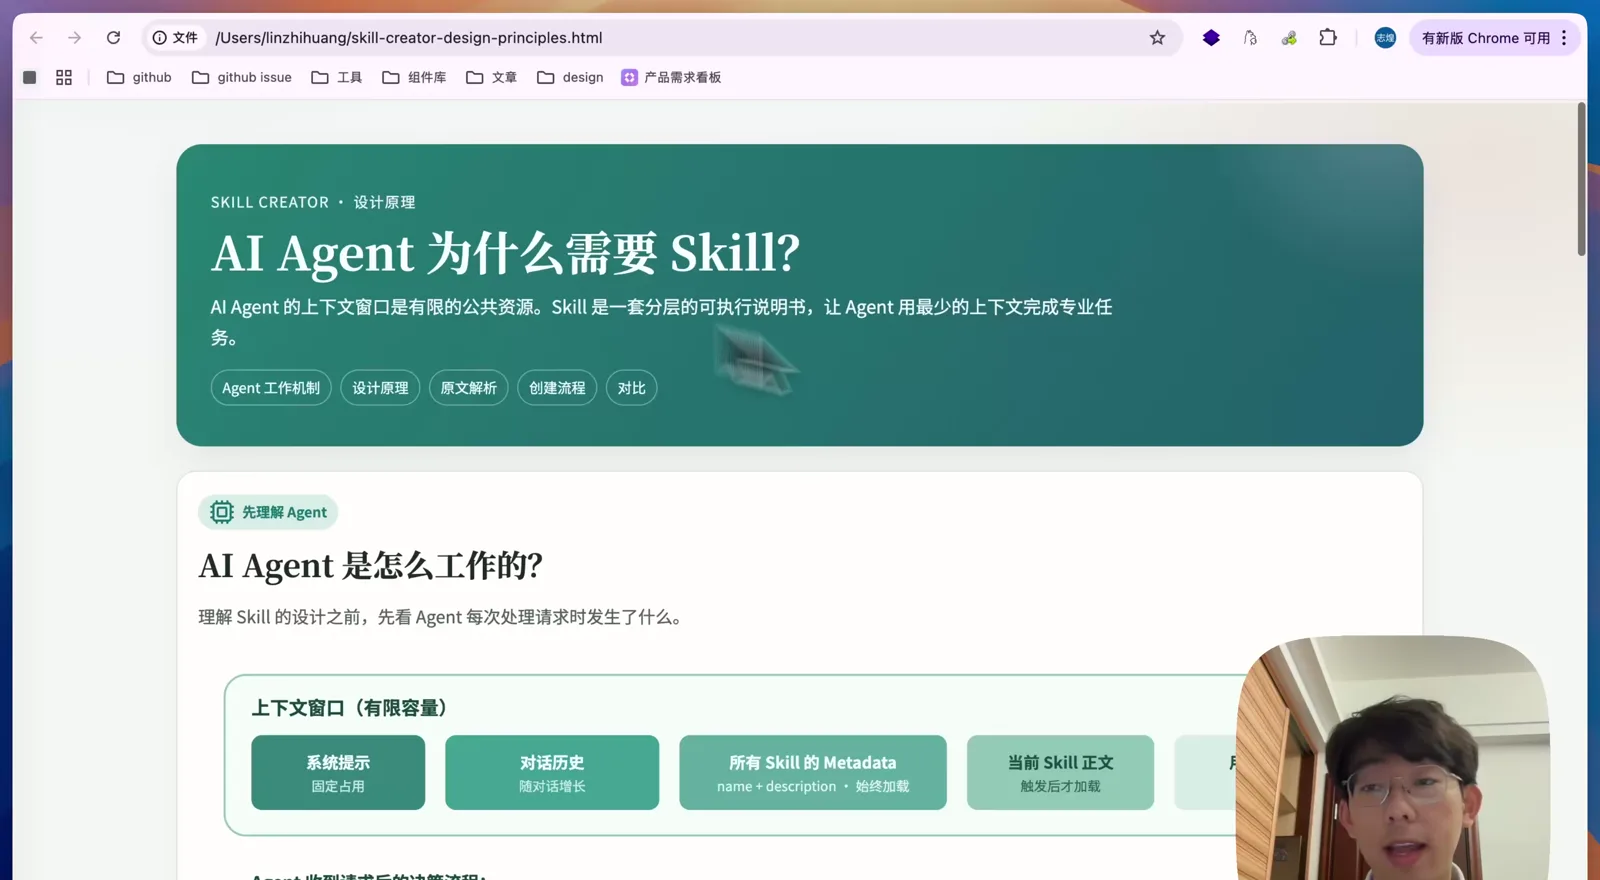
这三类资源的共同点是:把复杂的工作量放在创建 Skill 的时候,使用的时候就轻松了。Skill 能以文件形式承载,也是因为 AI Agent 会自己规划行动,并且具备读取文件的能力。
Skill Creator 原文里的定义
这份 HTML 文档还解析了 Skill Creator 的原始 SKILL.md。文件最前面是 YAML frontmatter 元数据区,包含 name、description 和简短描述,底下才是正文。
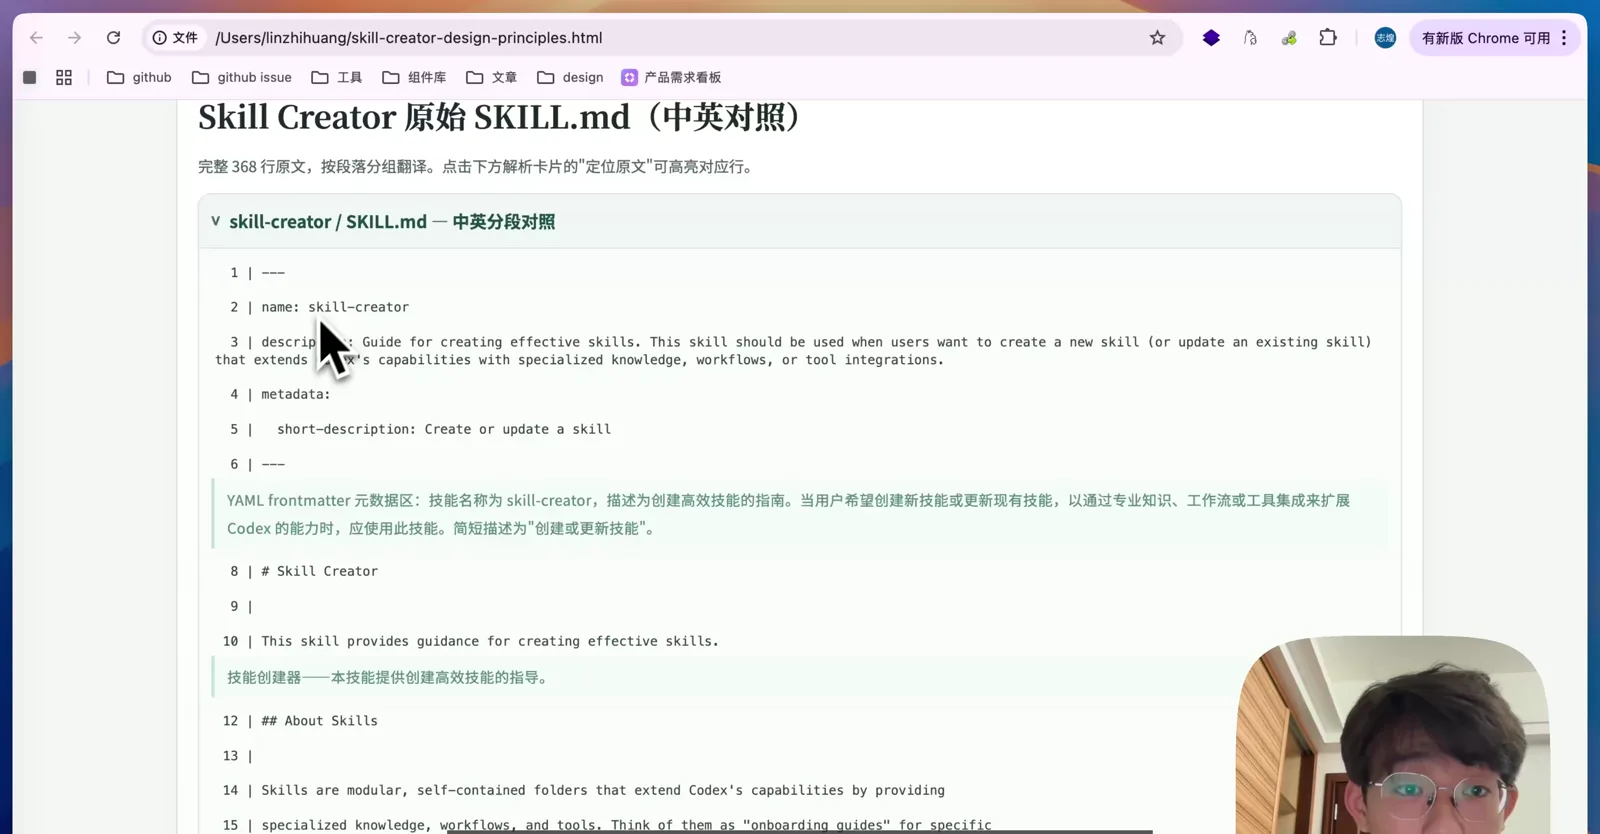
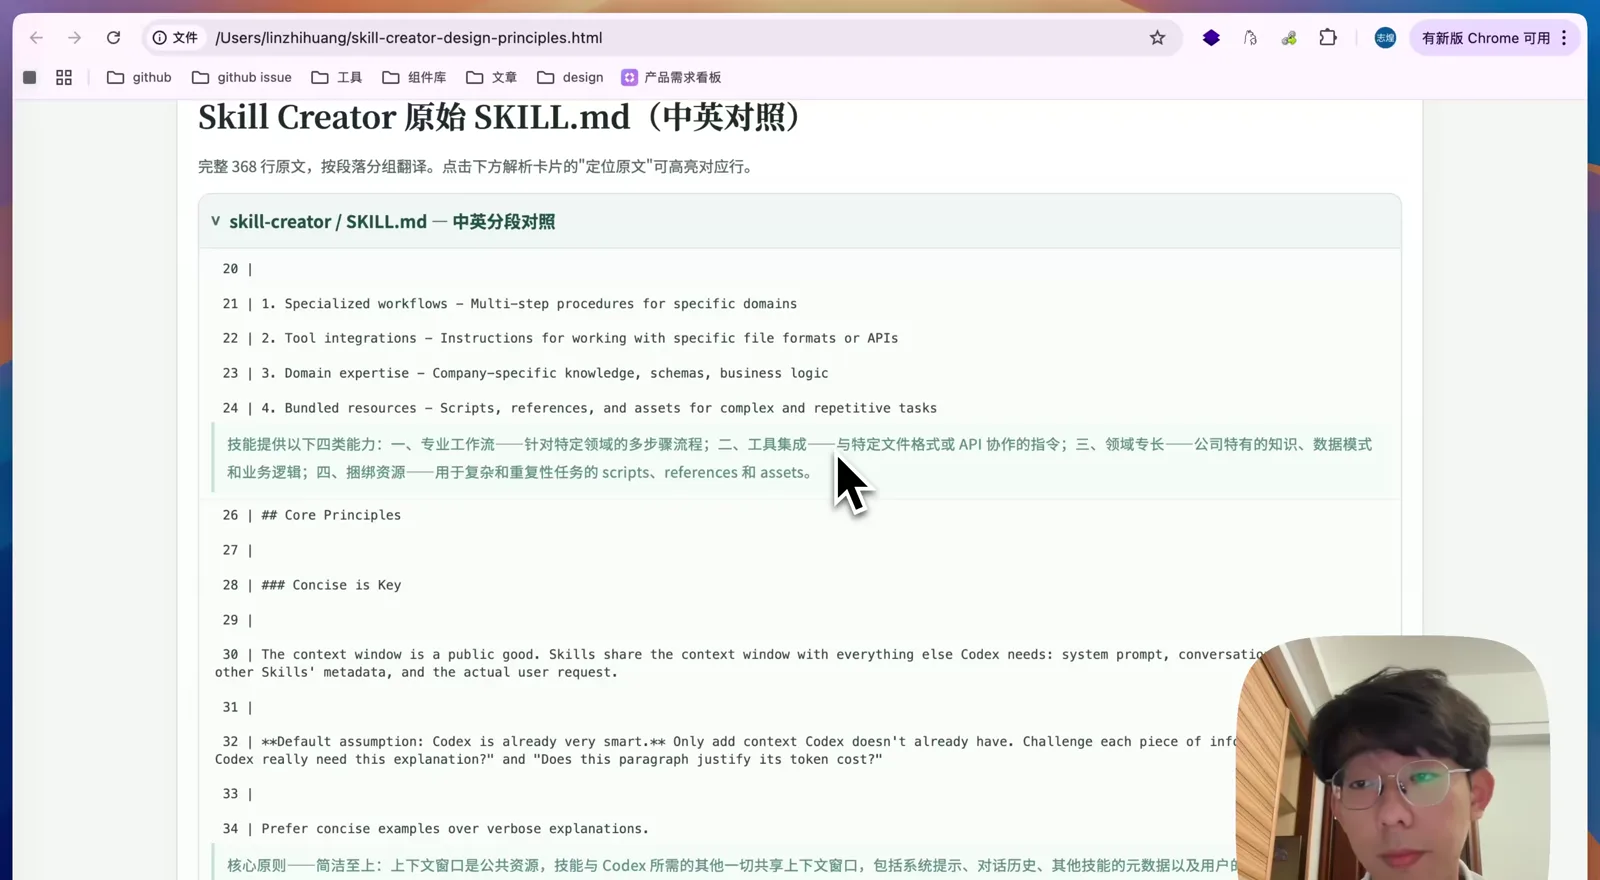
Codex 对 Skill 的定义是:模块化、自包含的文件夹,通过提供专业知识、工作流和工具来扩展 Codex 的能力,可以理解为特定领域或任务的入职指南。Skill 能提供四类能力:
- 专业工作流:针对特定领域的多步骤流程;
- 工具集成:与特定文件格式或 API 协作的指令,比如怎么发送请求、怎么读文件;
- 领域专长:公司特有的知识、数据模式和业务逻辑,类似知识库;
- 捆绑资源:处理复杂和重复性任务的 scripts、references 和 assets。
什么时候值得创建一个 Skill?一是 AI 本身做不好的事情,做好的就没太大必要;二是日常会反复执行的工作流,比如每天都要执行两次以上的流程,可以固化成可复用的资产。
简洁至上和六步创建流程
Skill Creator 的第一条核心原则是简洁至上。上下文窗口是公共资源,Skill 要和系统提示、对话历史、其他 Skill 的 metadata、用户的实际请求共享这个窗口。窗口一般是 20 万 token,多的到 100 万,但肯定是越精简越好。
所以写 Skill 的时候要对每一条信息提出质疑:Codex 真的需要这个解释吗?这段内容值得消耗 token 成本吗?优先使用简洁的示例,而不是冗长的解释。不是内容越多越好。
从一个想法到一个可复用的 Skill,Skill Creator 给出的流程是六步:
- 理解场景:收集触发话术,比如做一个 UI 设计的 Skill,描述里就要写清楚「需要做设计时使用这个 Skill」;
- 规划资源:确定这个 Skill 需要哪些脚本、参考资料和资产;
- 初始化骨架:用 Skill Creator 自带的
init_skill.py脚本初始化整个目录结构; - 编辑和测试:先把资源创建出来,再编写 SKILL.md。资源创建好之后才知道它们叫什么名字,就像写正文之前先写目录;
- 校验:用
quick_validate.py检查格式规则; - 实战迭代:根据真实使用中的卡点修正。
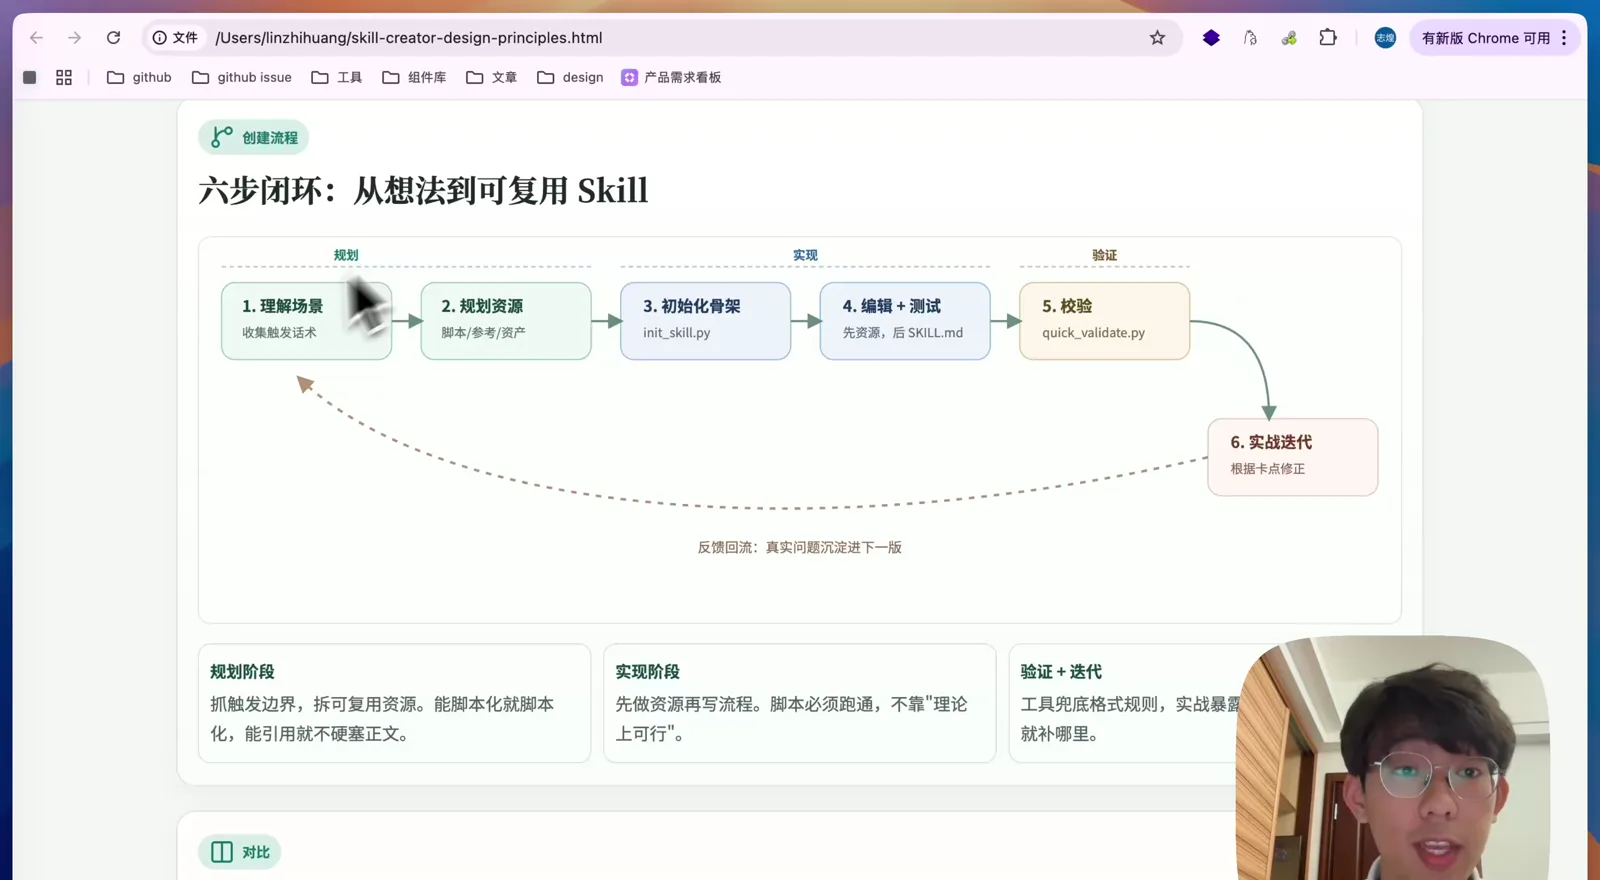
实战迭代这一步很重要。Skill 不是创建好就一直用下去的。如果发现 AI 对某一个点总是理解不好,比如明确了某条设计规范之后它矫枉过正、过度依赖那条规范,说明写得太死了,要给它提高自由度。修改 Skill 的过程依然可以让 AI 来执行。
普通文档和 Skill 的区别
普通文档按照 Skill 的方式组织,只要 Agent 具备读文件的能力,也一样可以执行。Skill 不是一个全新的东西,它只是一种文件的组织形式:主流程放在 SKILL.md,资料放在 references,工具放在 scripts。我们以前编写的依赖脚本的文件式工作流,其实就是没有固定目录结构的 Skill,Claude 把它封装了一下,固定了这些约定。
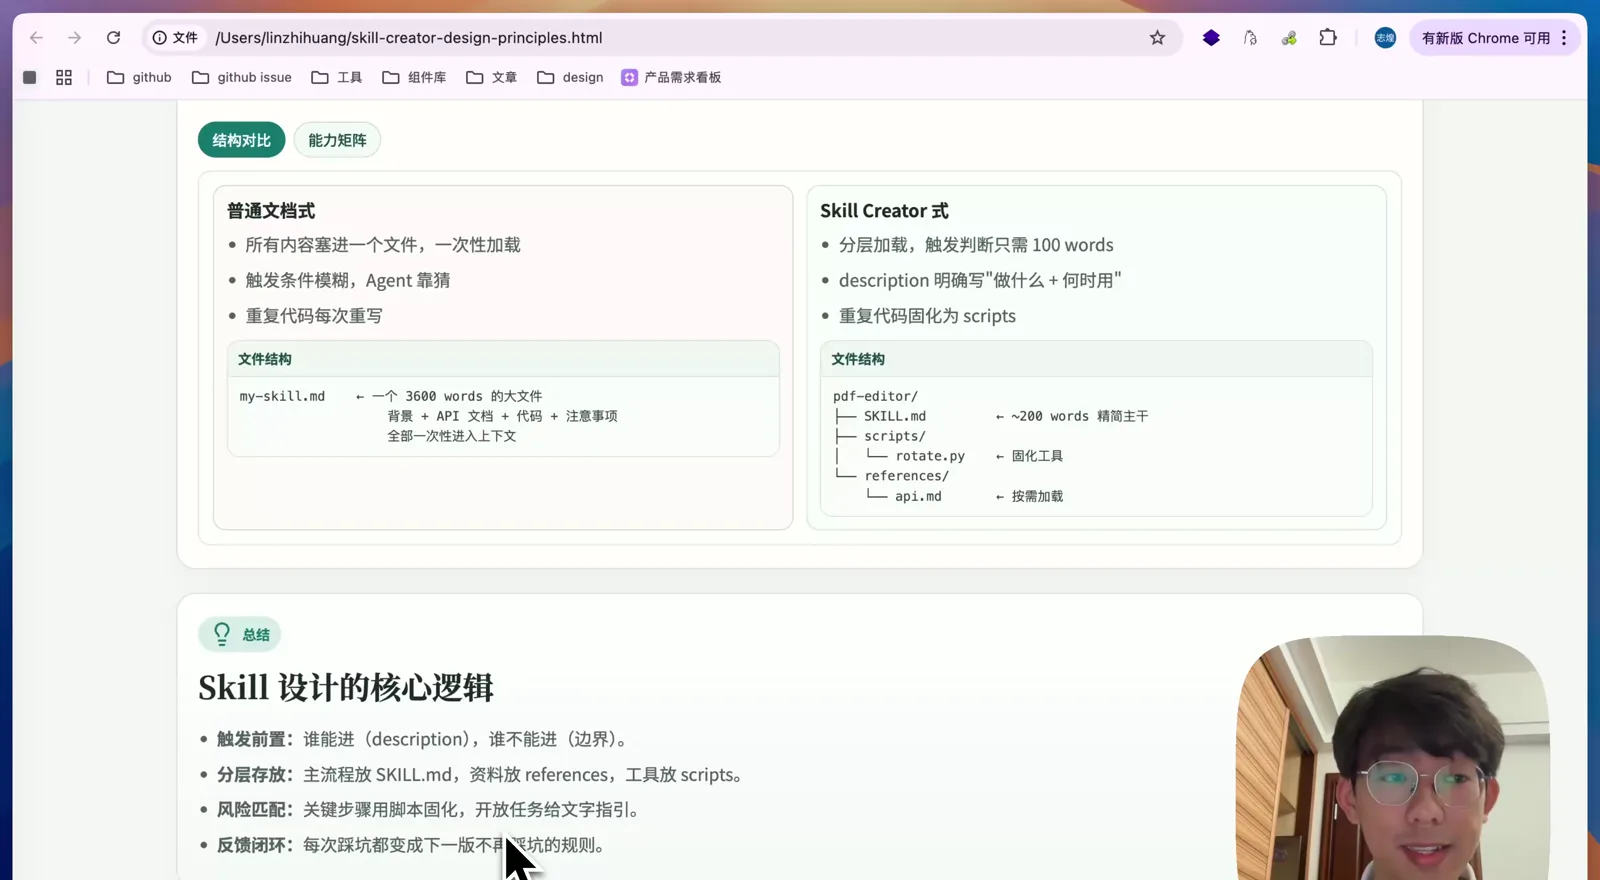
最后总结一下 Skill 设计的核心逻辑:
- 触发前置:name 和 description 决定谁能触发这个 Skill、什么时候加载正文;
- 分层存放:主流程放 SKILL.md,资料放 references,工具放 scripts,匹配到需求之后才把更多上下文注入窗口;
- 风险匹配:针对性很强的 Skill 写得越清楚越好;开放式的 Skill 不要写死具体规则,而是提供 knowhow 和洞察,把 AI 可能没考虑到的点告诉它,让它自己做决策;
- 反馈迭代:发现 Skill 不好用的时候要找出具体原因,人要进入 Skill 的优化过程,而不是让 AI 一直自己优化。AI 只会把自己已有的知识再复用到 Skill 里,读取它已经知道的东西没有意义。我们把 AI 做不好的事情强调给它,Skill 才会变得越来越好用。