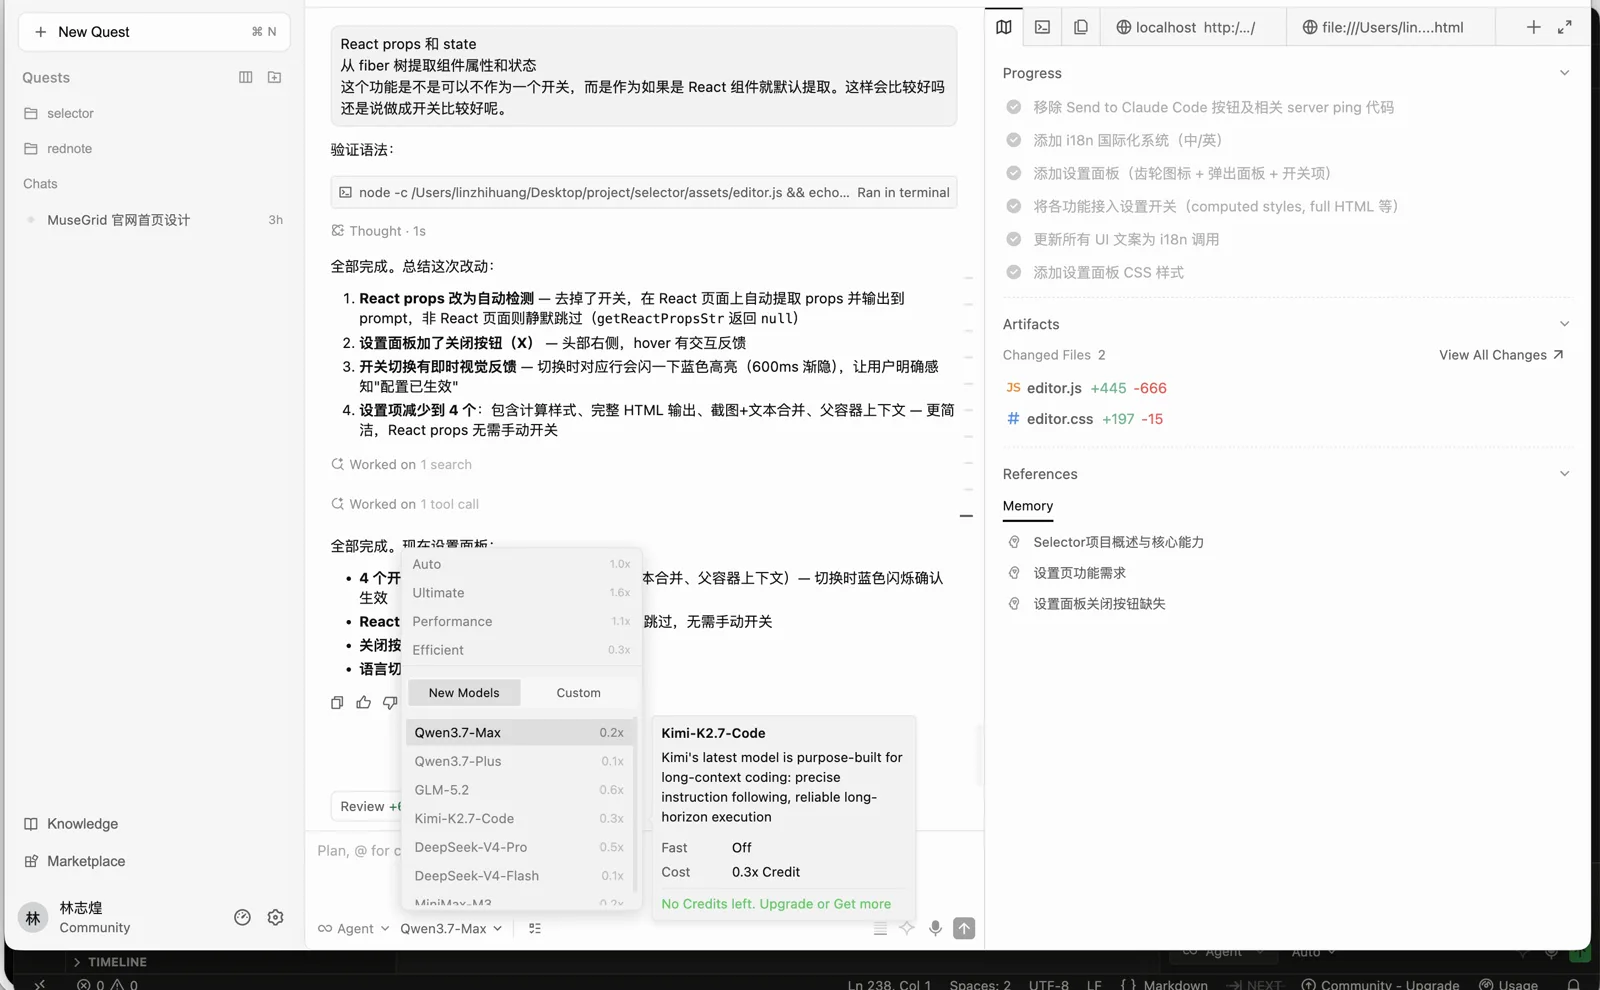
我之前用过 Qoder,最近也用过 QoderWork,这两个在国内的 Agent 产品里做得比较好。设计都很清爽,QoderWork 里提供了连接器,可以自定义管理自己的配置,没有盲目塞一大堆专家进去。它虽然有专家套件,但做得比较收敛,是一些相对实用的 Skill 和连接器的聚合。
最近 Qoder 里有一个活动,Qwen3.7-Max 每天有 200 次免费对话的机会,所以我就来体验了一下 Qoder 现在做得怎么样。
这里要先说明一下,200 次免费不是可以发送 200 次对话,而是在单个对话里面,每次请求 Qwen3.7-Max 算单独的一次。一个任务有可能会调用几次到几十次模型。
Qwen3.7-Max 这个模型本身,上下文长度是 100 万,模态是文本到文本,目前还不支持多模态。输出价格是 3.75 美元每 100 万 Token,算是相对比较便宜的,因为它对标的是能力比较强的模型。它是 Qwen3.7 系列里面最旗舰的一个模型,主要面向 Agent、Coding 或者办公生产力这一类的长任务场景。所以这期我主要从编程的场景去测试它的效果。
Qoder 的产品形态
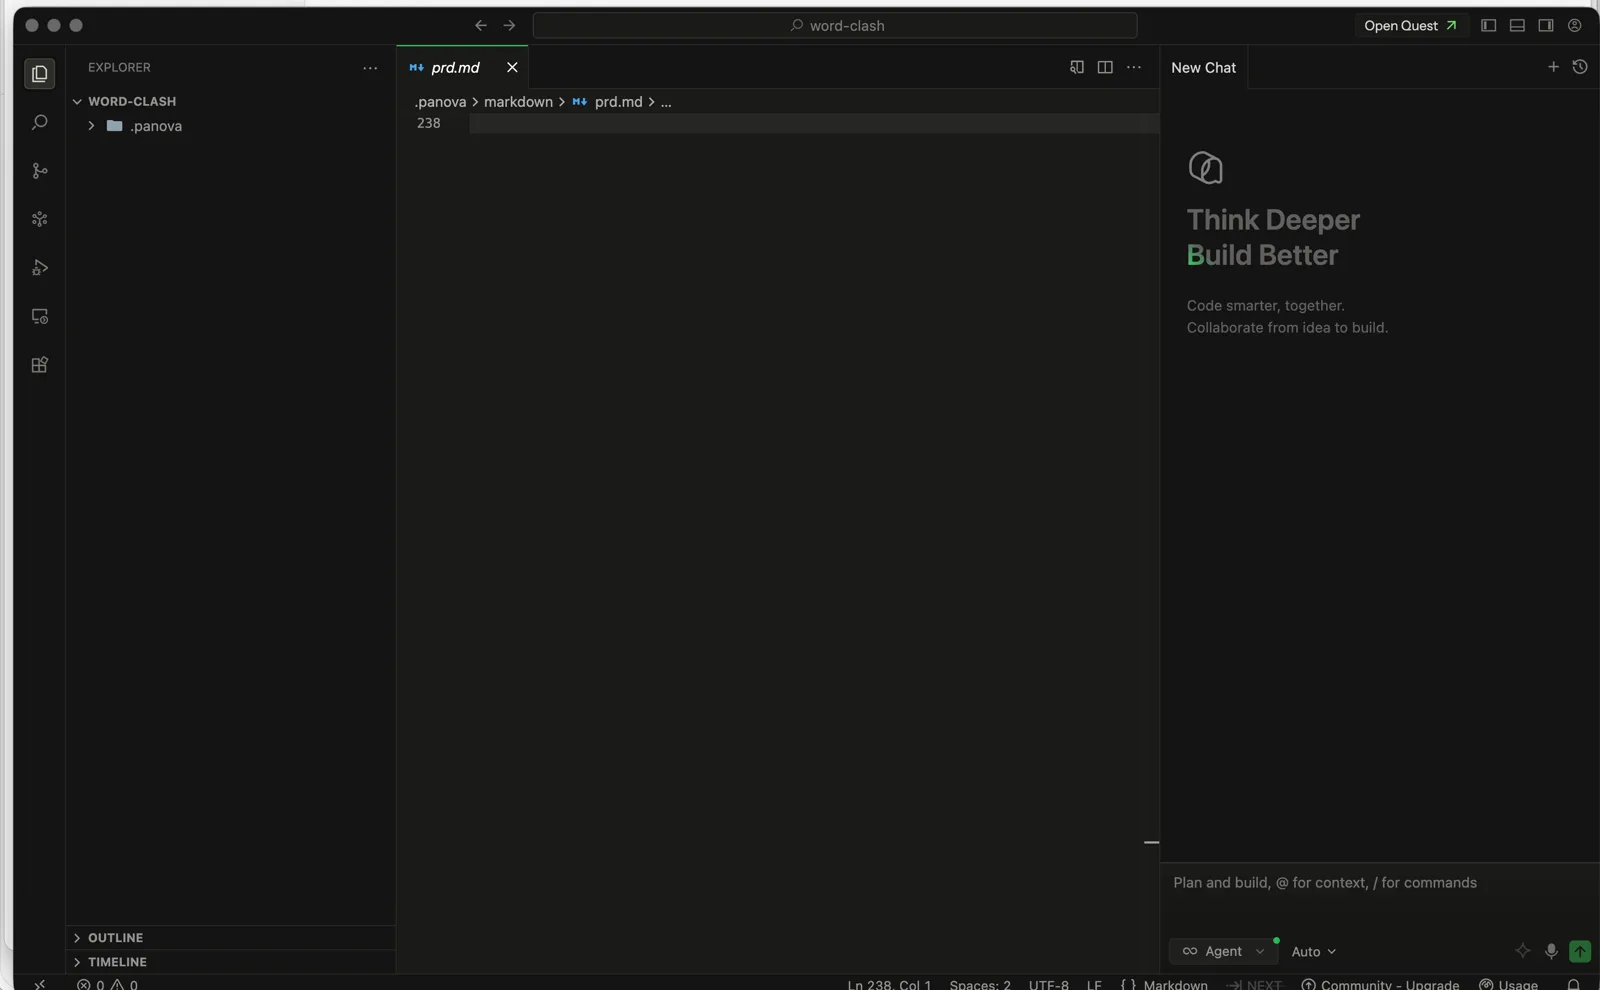
Qoder 有两种页面形态。一个是类似 Cursor 这样的传统 IDE 页面。
另一个是 Qoder Quest,类似 Codex 的 Agent 界面,以话题为主导,话题列表在左侧,下面实际操作的截图里可以看到。
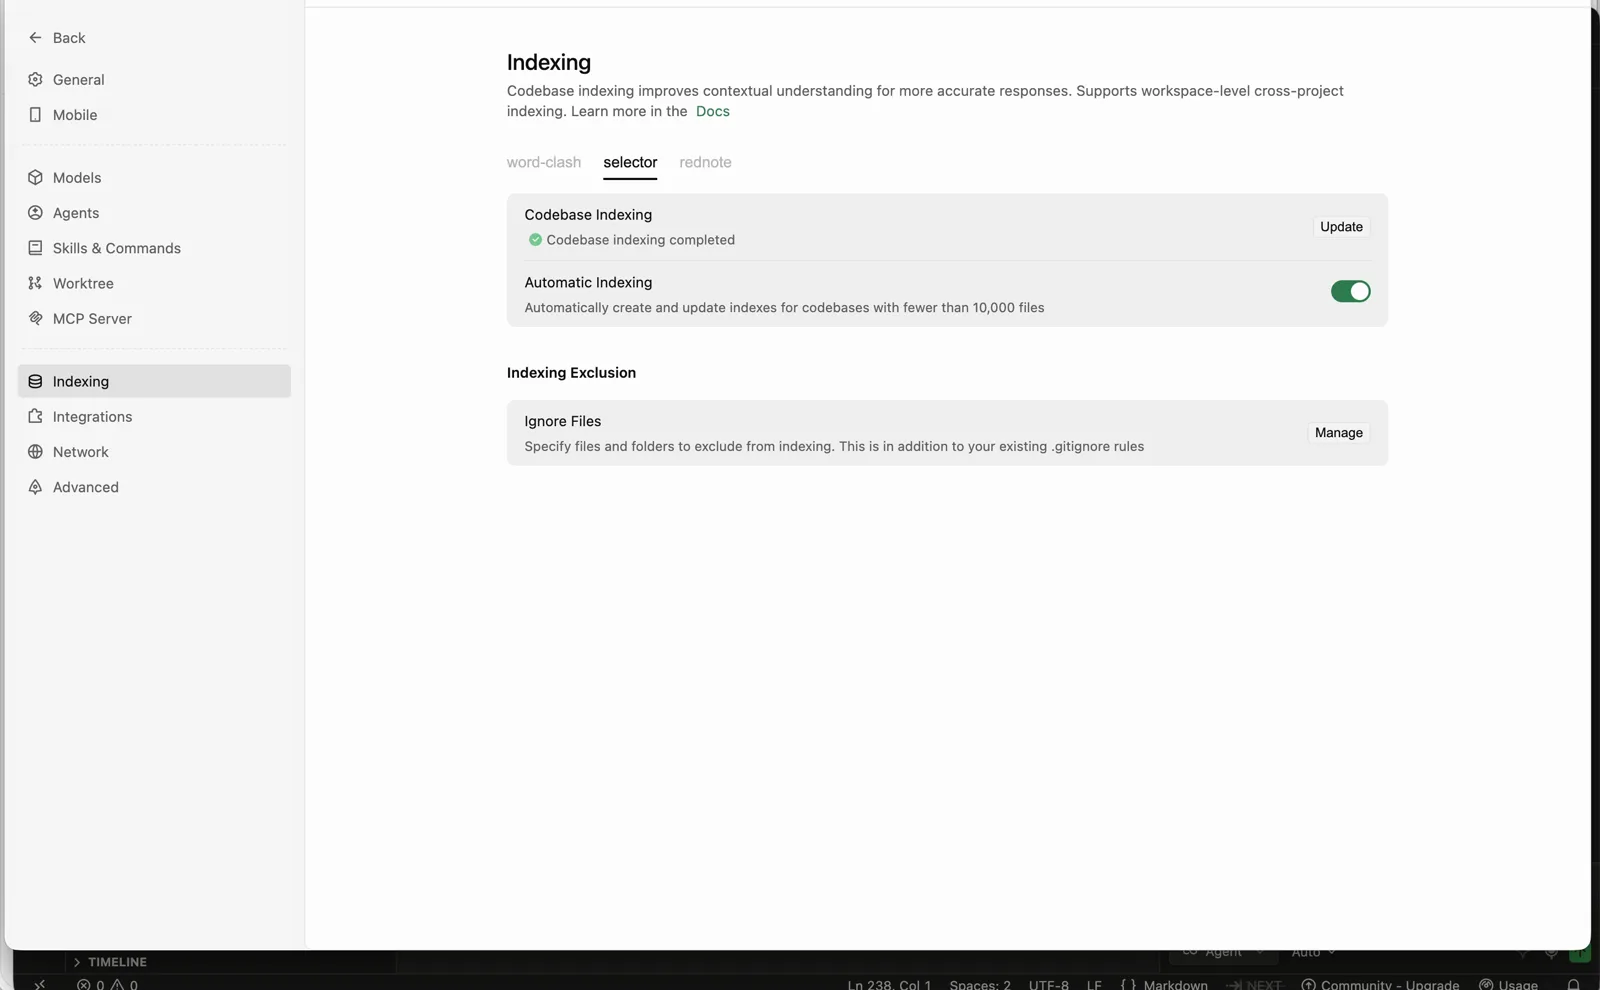
由于他们之前想做类似 Cursor 的形态,所以 Qoder 支持 codebase indexing,可以提升代码索引的速度。
除此以外,产品内部还提供了 Project Information,类似于 AGENTS.md,只是它不会影响项目内本身的文件,是一个产品级别内置的记忆。
给 Selector 增加区域截图功能
这一次我让 Qoder 做的事情,是优化我之前做的 Selector 这个小工具。它是一个小书签,把书签拖到书签栏就安装成功了。安装之后点击书签,页面右下角会出现一个小窗口,这时可以点击页面上的任何元素,点复制,再回到 Qoder 粘贴,就可以把刚才选中区域的属性和上下文提供给 AI Agent,帮助它快速定位到有问题的区域。比如我想调整某个元素的间距和样式,就可以直接这样发送给它,比起截图会更加精确一些。
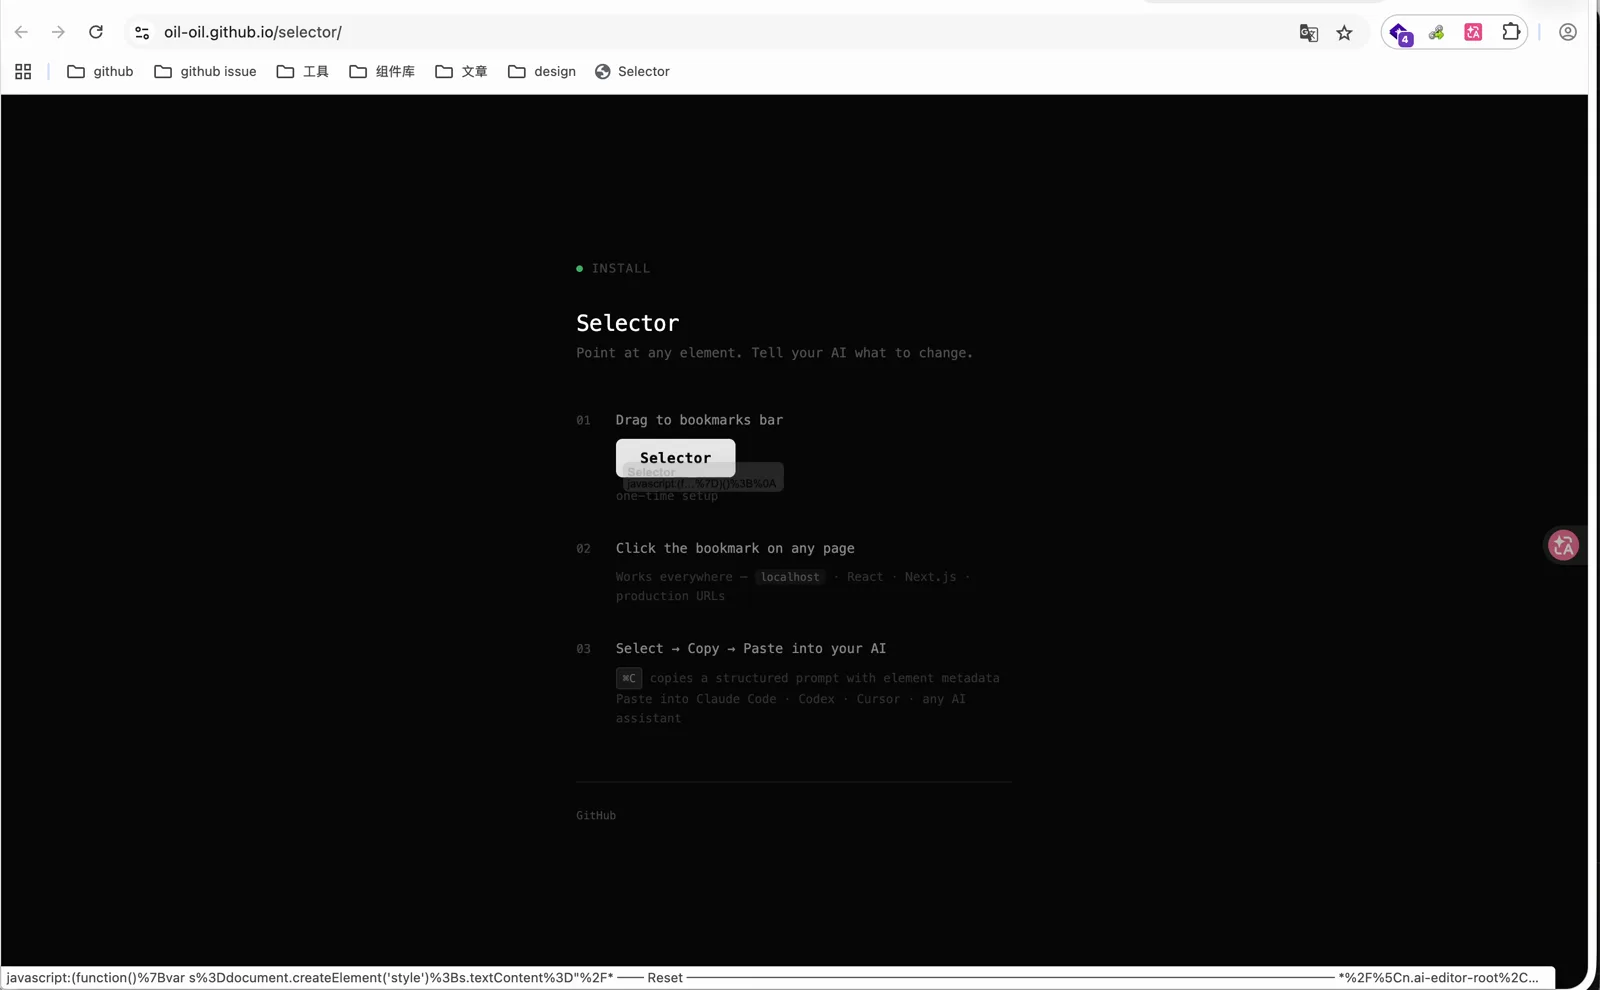
这一次优化的点是:我之前觉得光复制一个上下文,有时候信息还不是很充足,想让它能不能直接把那一片区域的 UI 截成图片。这样选中一个位置,既能复制上下文,也能截图,一次做两件事情,比使用其他截图工具更方便。
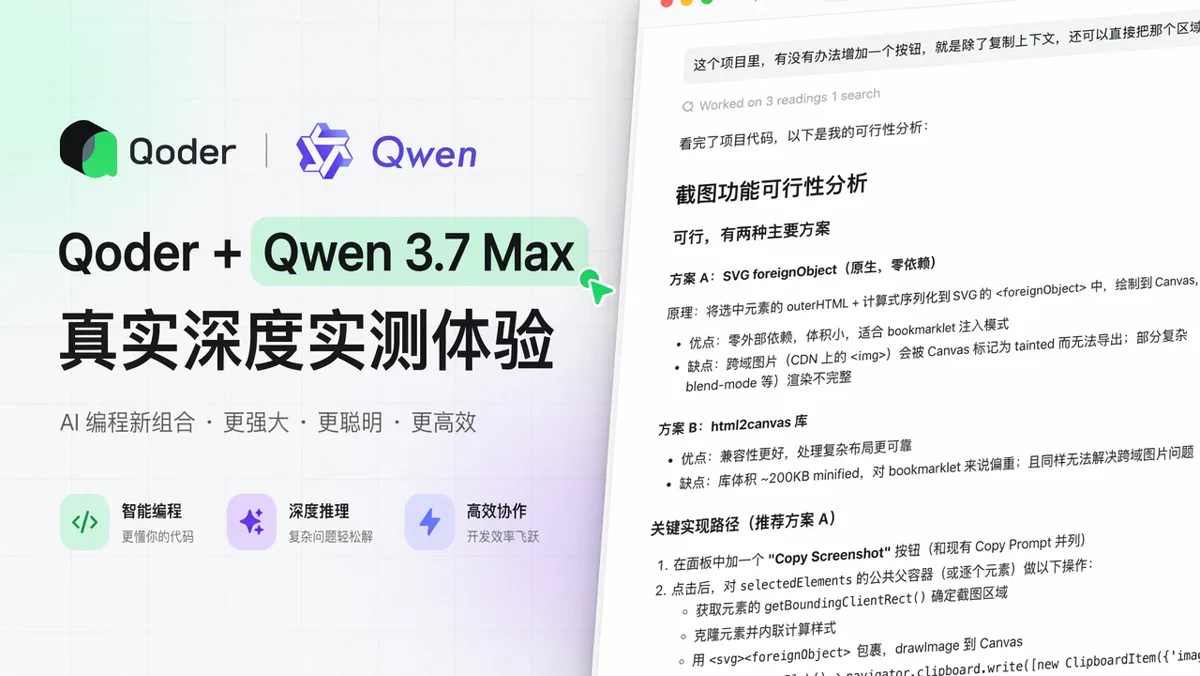
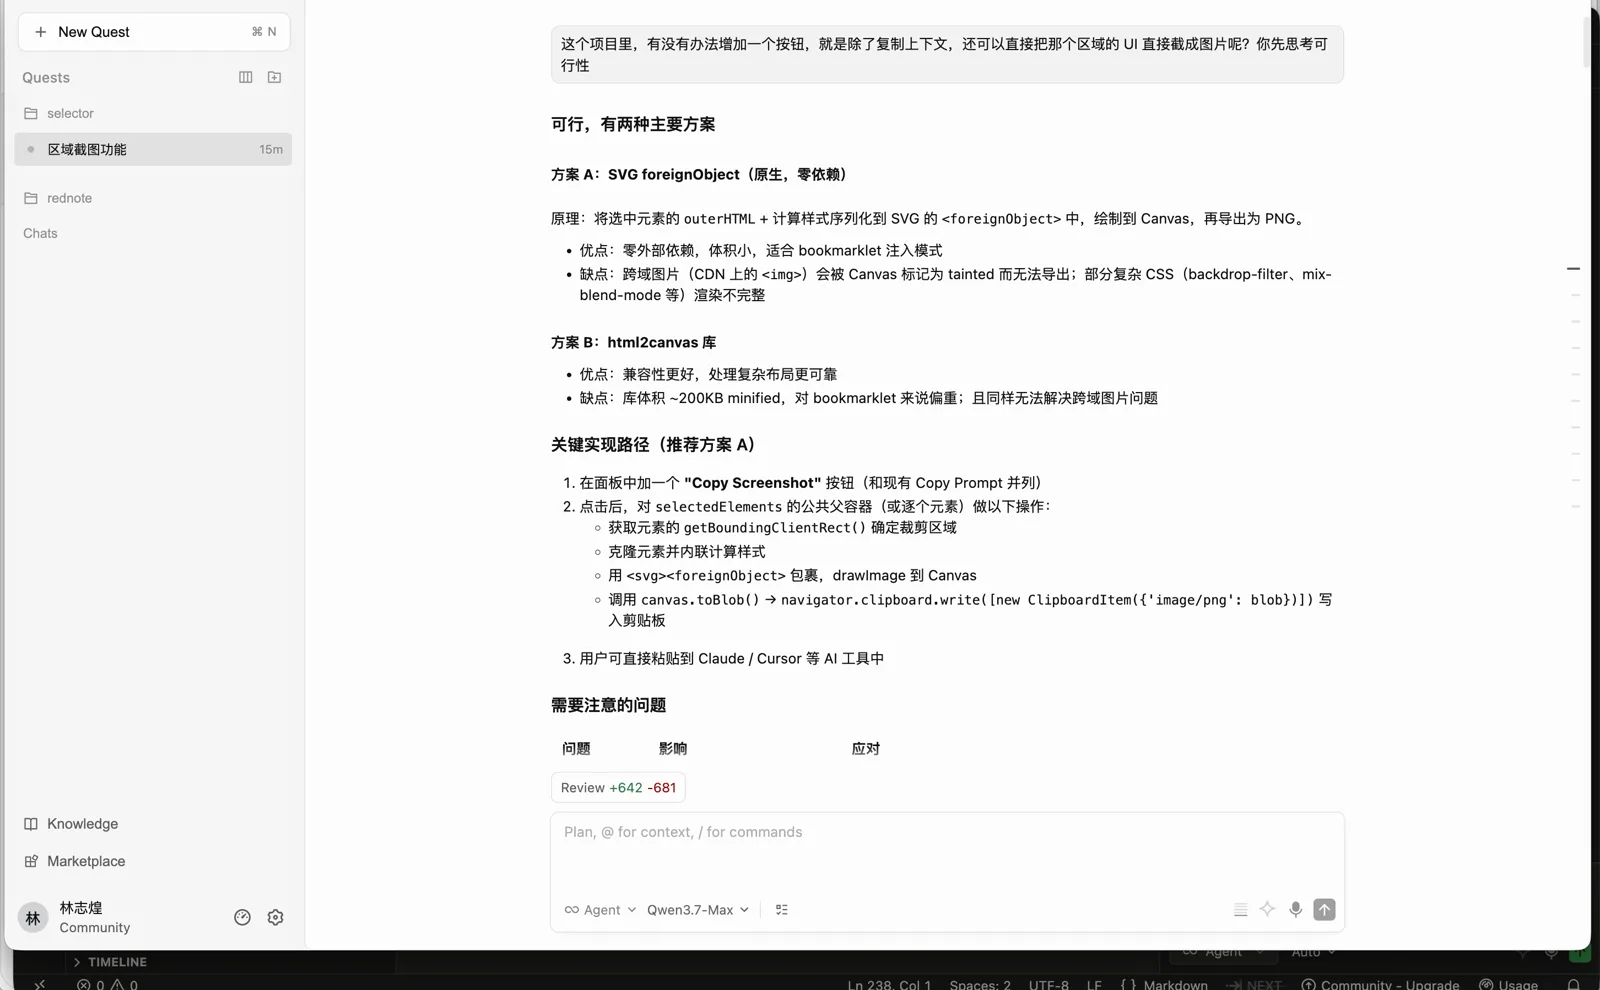
我先问 Qoder,除了复制上下文,还有什么办法能把 UI 截成图片,让它先给我一个可行性分析。它给了我两个方案:方案 A 是 SVG foreignObject,原生零依赖;方案 B 是 html2canvas 库。它比较推荐方案 A,我就让它参考方案 A 把最终的代码实现出来。
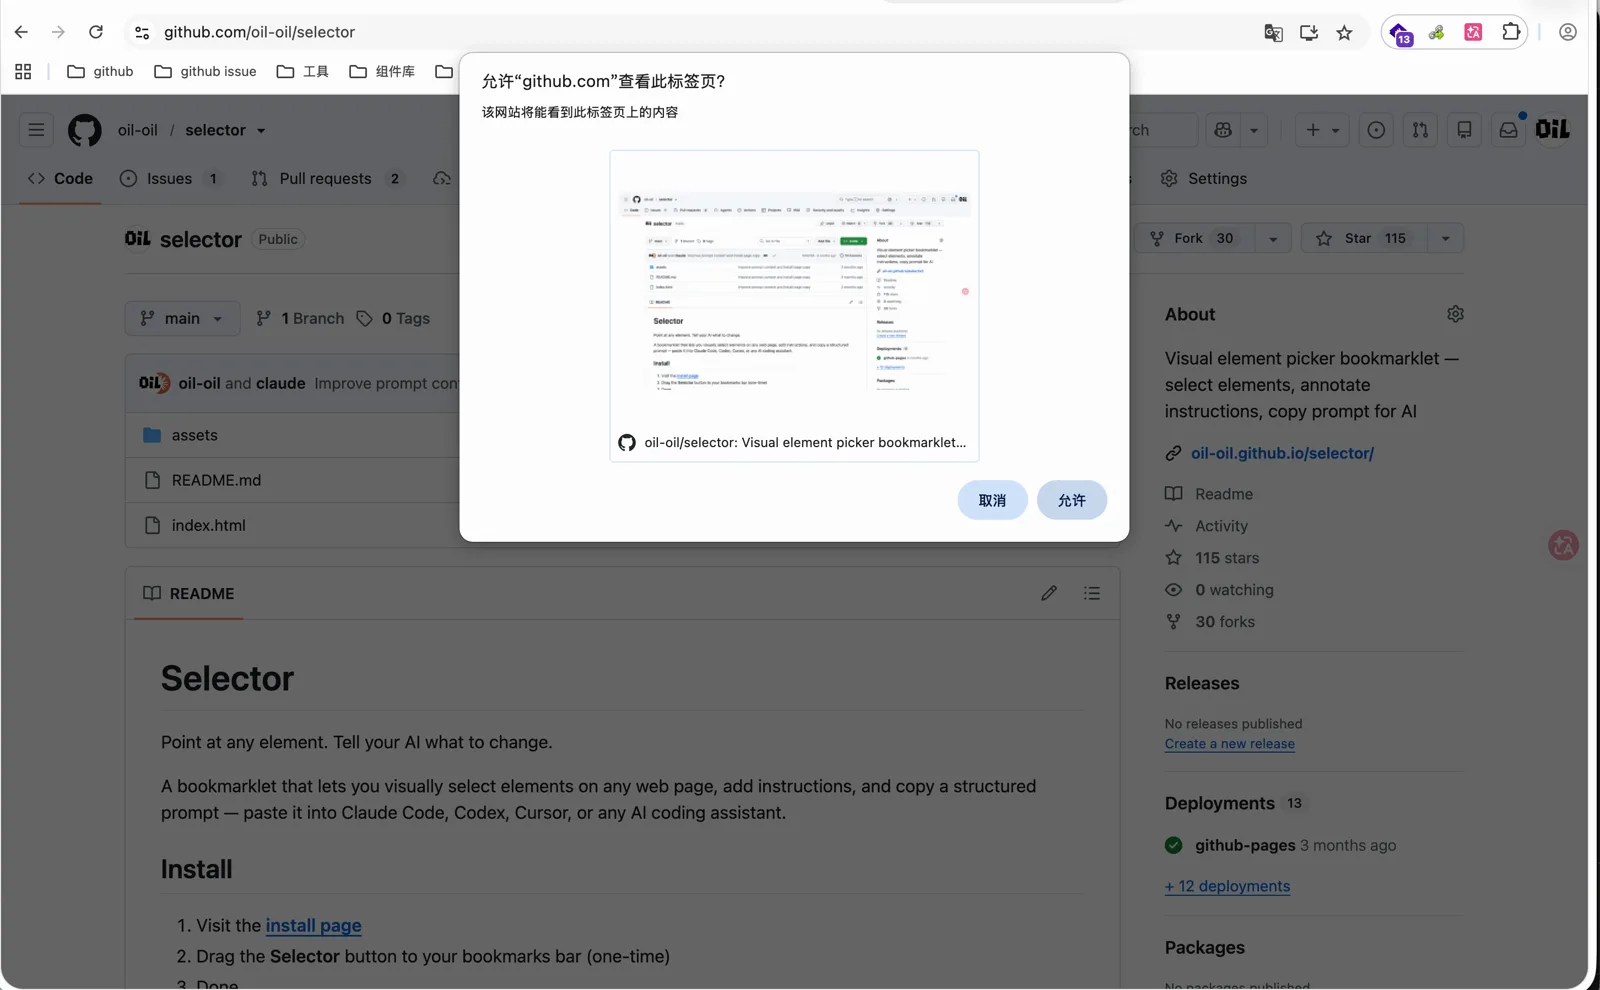
实现出来之后,小弹窗里多了一个复制截图的按钮。选中一个区域,点复制截图,浏览器会请求查看标签页的授权,点允许,截图就复制好了。
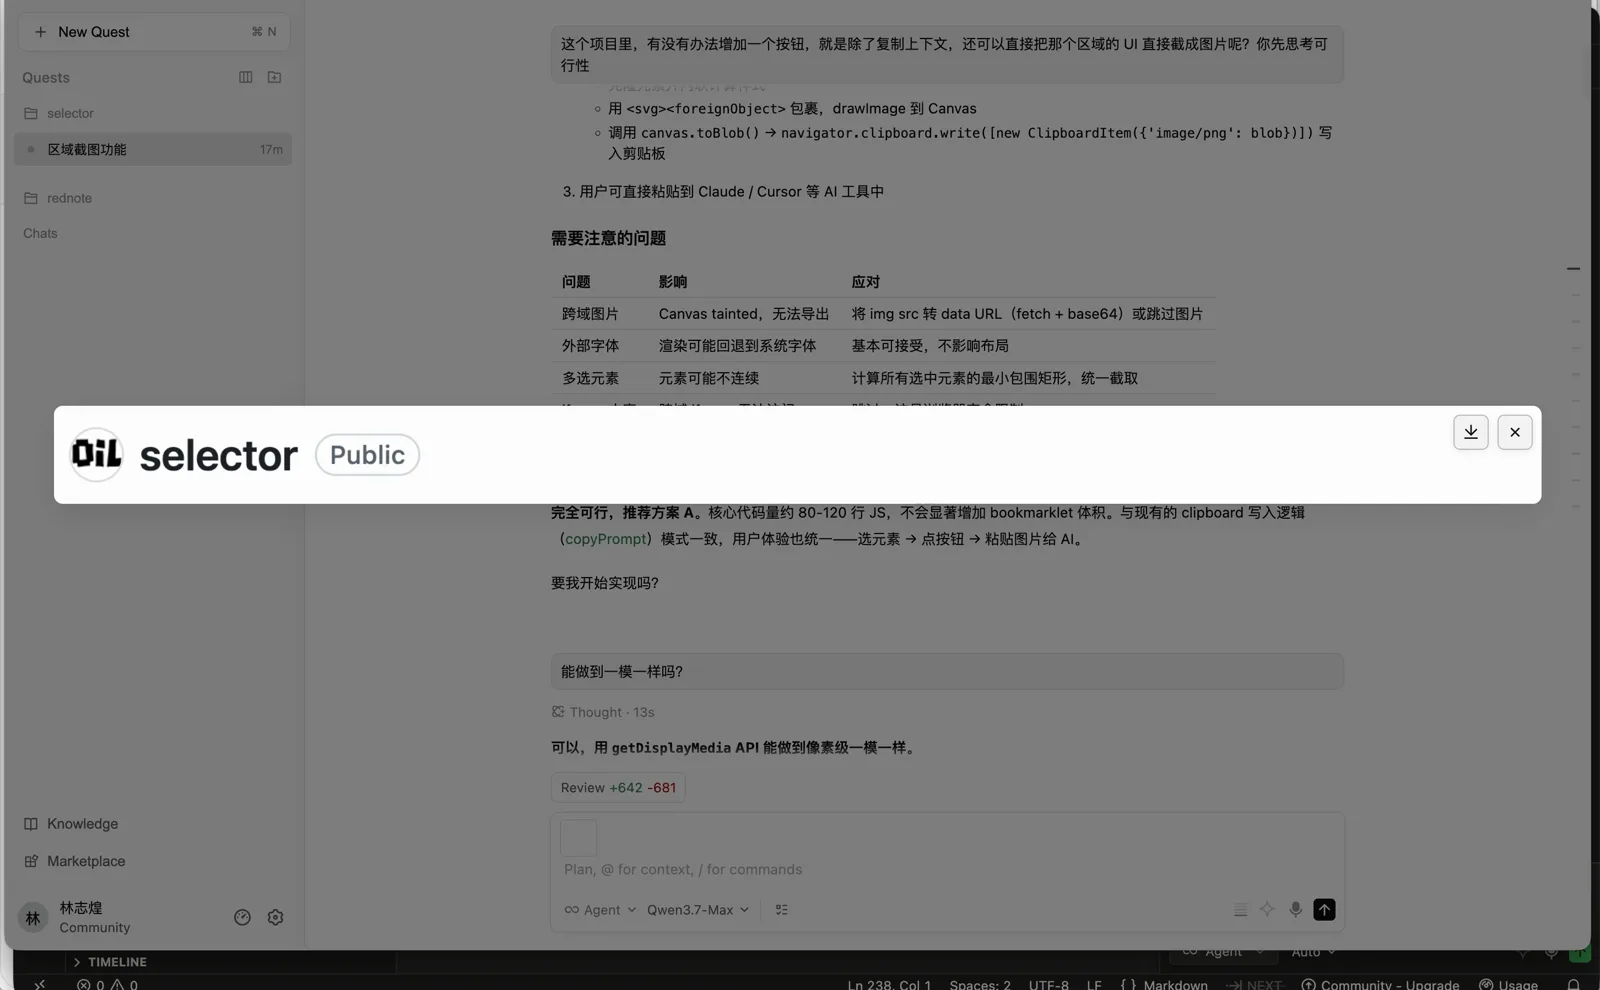
回到 Qoder 里面粘贴,可以看到就是刚才那个区域非常精确的截图。
假设选中的区域是比较抽象的元素设计,比如一个圆形气泡,同样可以把这一块的截图直接复制下来。想要复制提示词也可以,想要复制截图也可以。
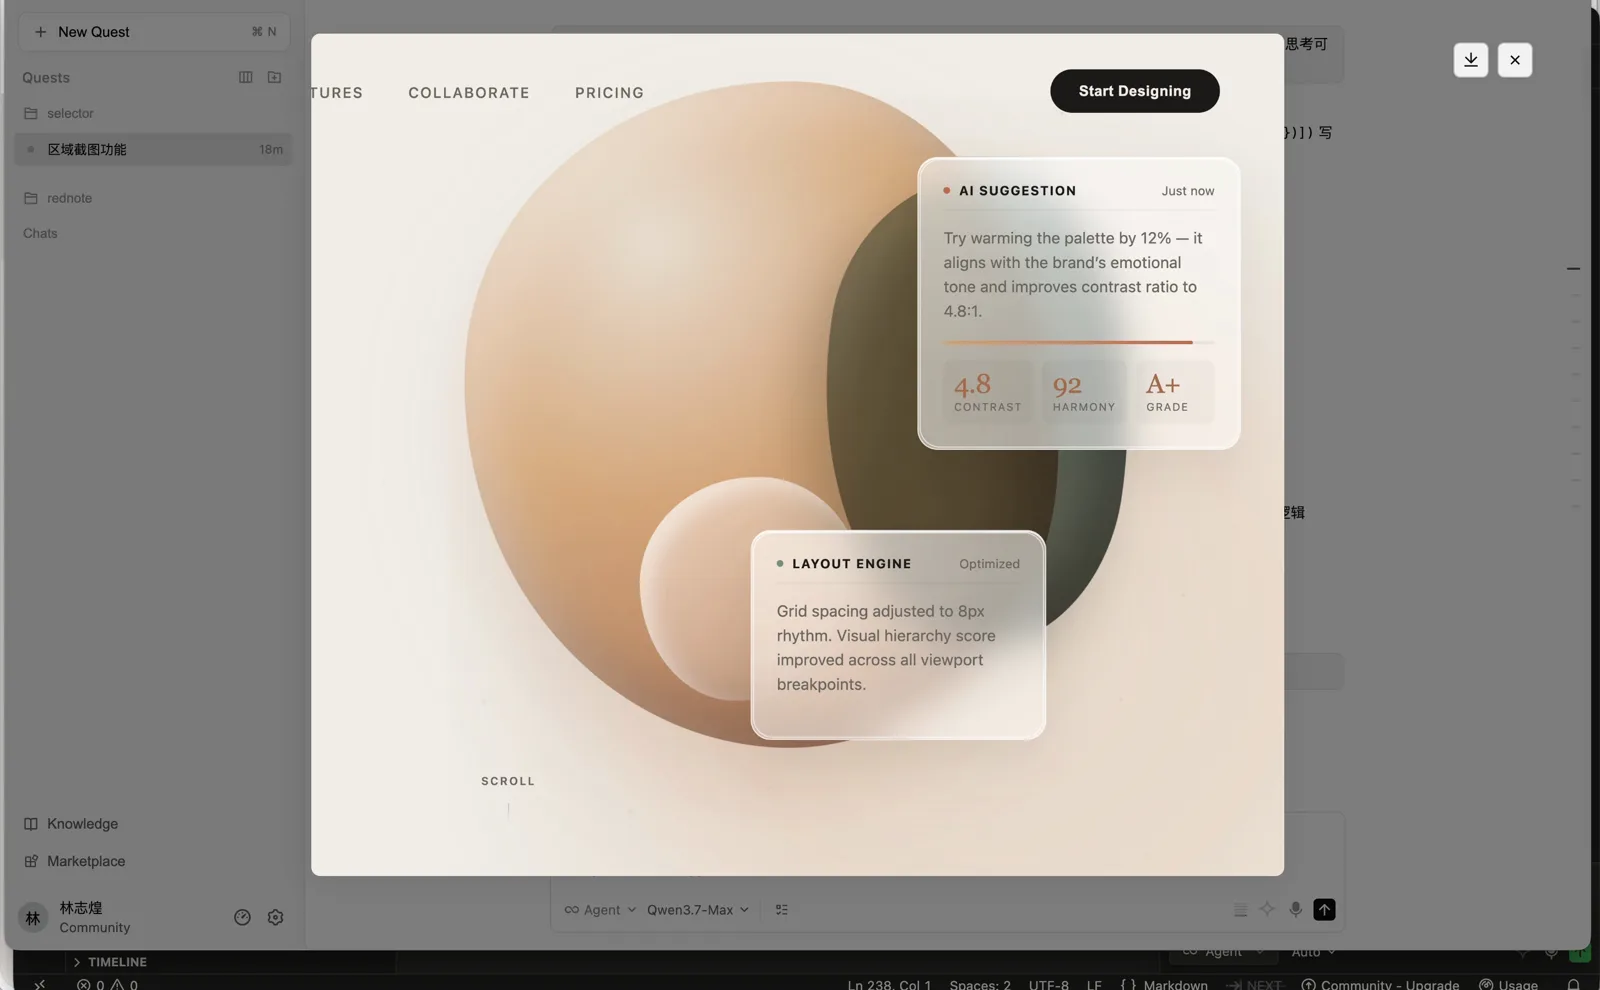
这个方案我觉得设计得比较完善。首先是增加了 UI 上的按钮,除了按钮之外还增加了一个快捷键,因为我这里面所有的功能都有提供快捷键。它还考虑了一些边界情况:截图的时候会把自己本身的元素隐藏掉;另外支持了高分辨率的屏幕,做了一些 API 上的兼容。最终实现出来的效果,和我想象中是一模一样的。
UI 生成和视觉识别
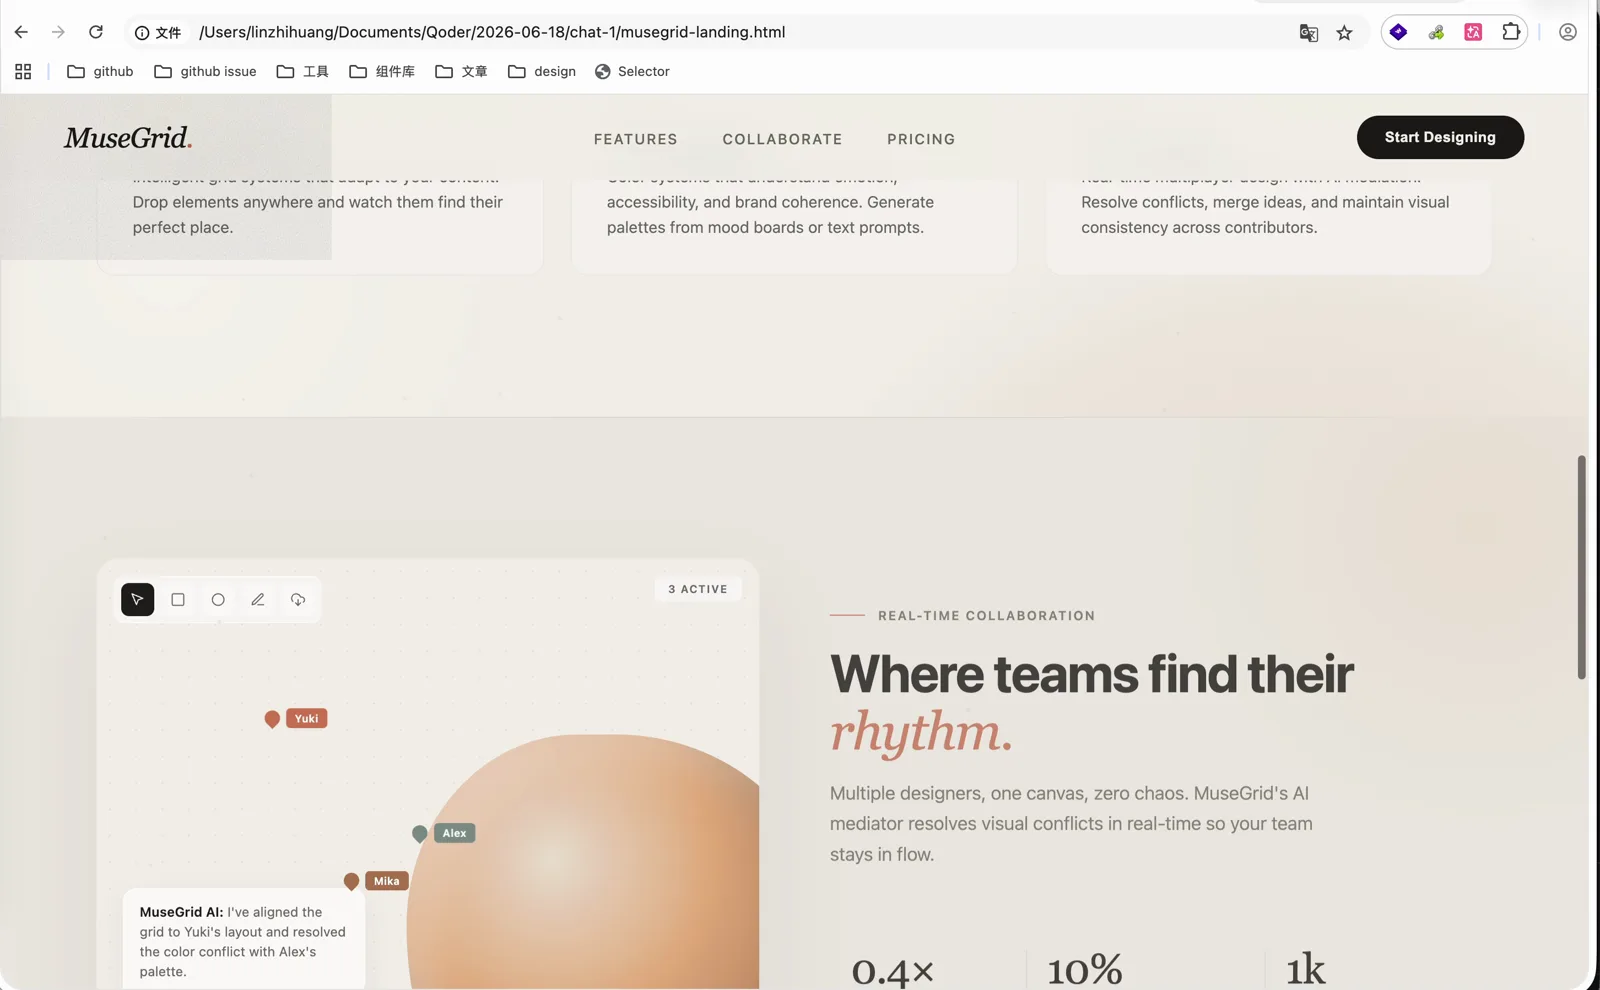
在这个过程中,我还测试了一下 Qwen3.7-Max 的 UI 设计能力。下面这个页面,是我给了它我之前的一个风格的提示词,让它一次性生成的一个 HTML。我觉得做得还是挺不错的:整体的 UI 设计比较克制、比较清爽,不会做得那么繁重,页面上的文案遵循性也比较强,各种材质的纹理也做得挺好。
还有一点要提一下:Qwen3.7-Max 虽然不支持多模态,但是在 Qoder 里面,它是支持视觉识别工具的。而且这个视觉识别工具不是用 MCP 实现的,是一个原生的工具,像 read_file 这样,在读文件的时候就可以读图片,应该是内置了 Qwen 的 VL 模型。我试了一下,给它加了一张图,让它分析里面的字体和配色,它都讲得很清楚,视觉识别效果非常好。
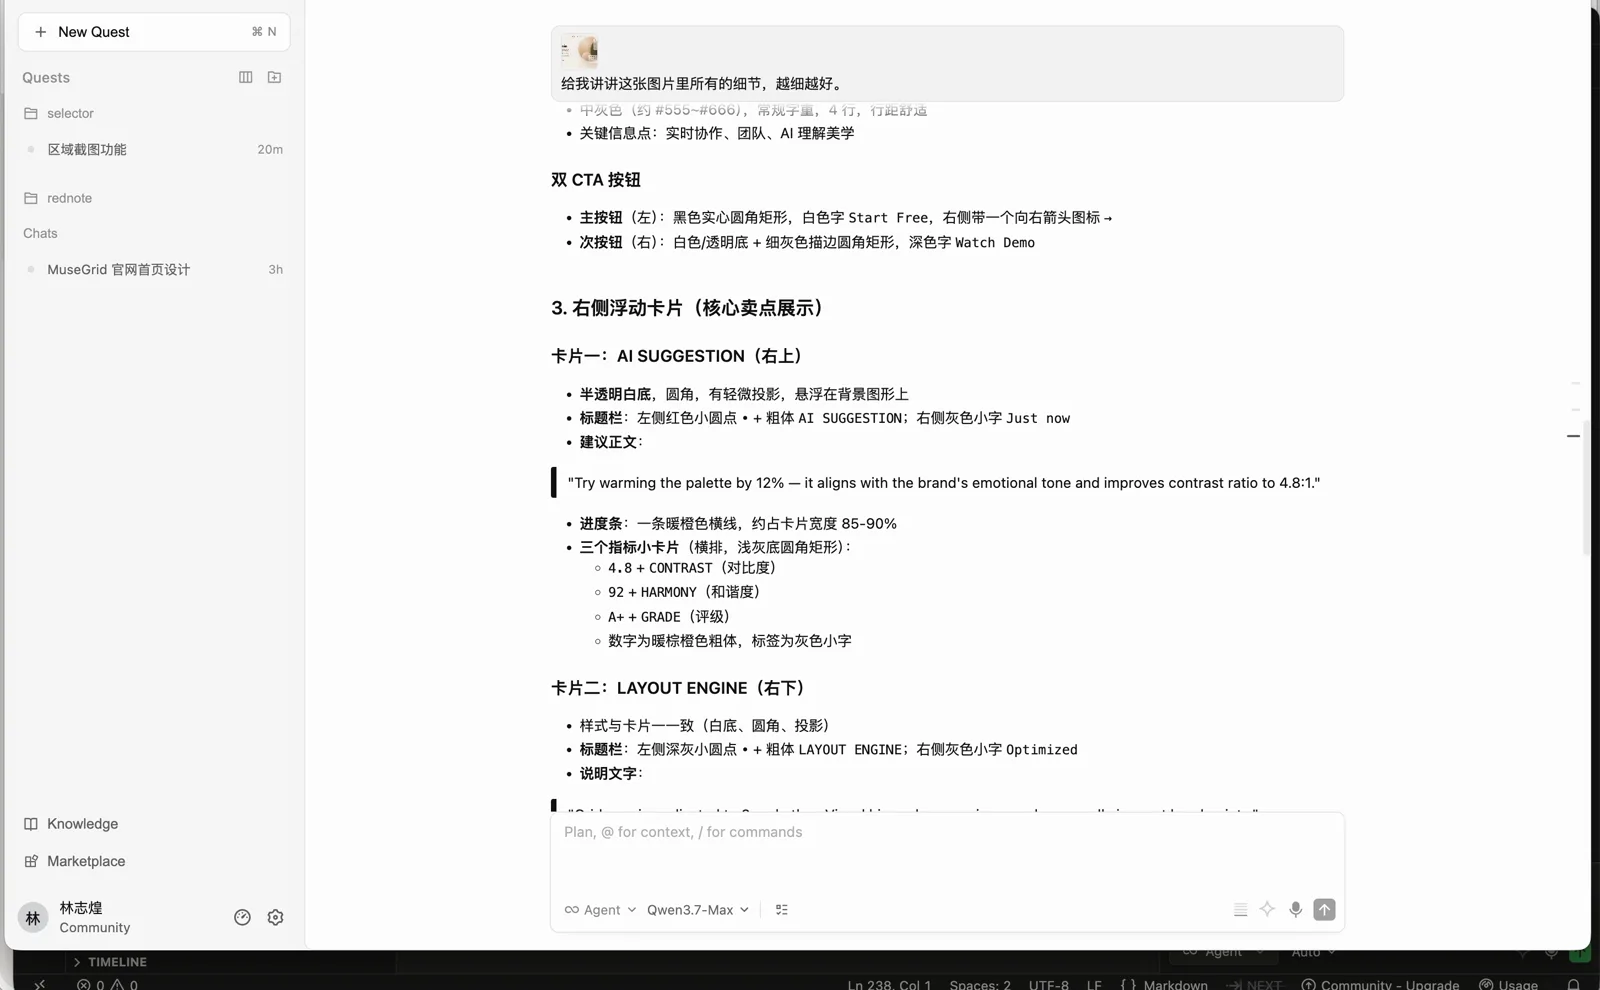
千问的模型类型很多,音频、视频、文字、视觉识别都有在发力,所以我会觉得,千问的模型在它自己家的工具里面使用效果是更好的。
自动化任务:采集小红书数据
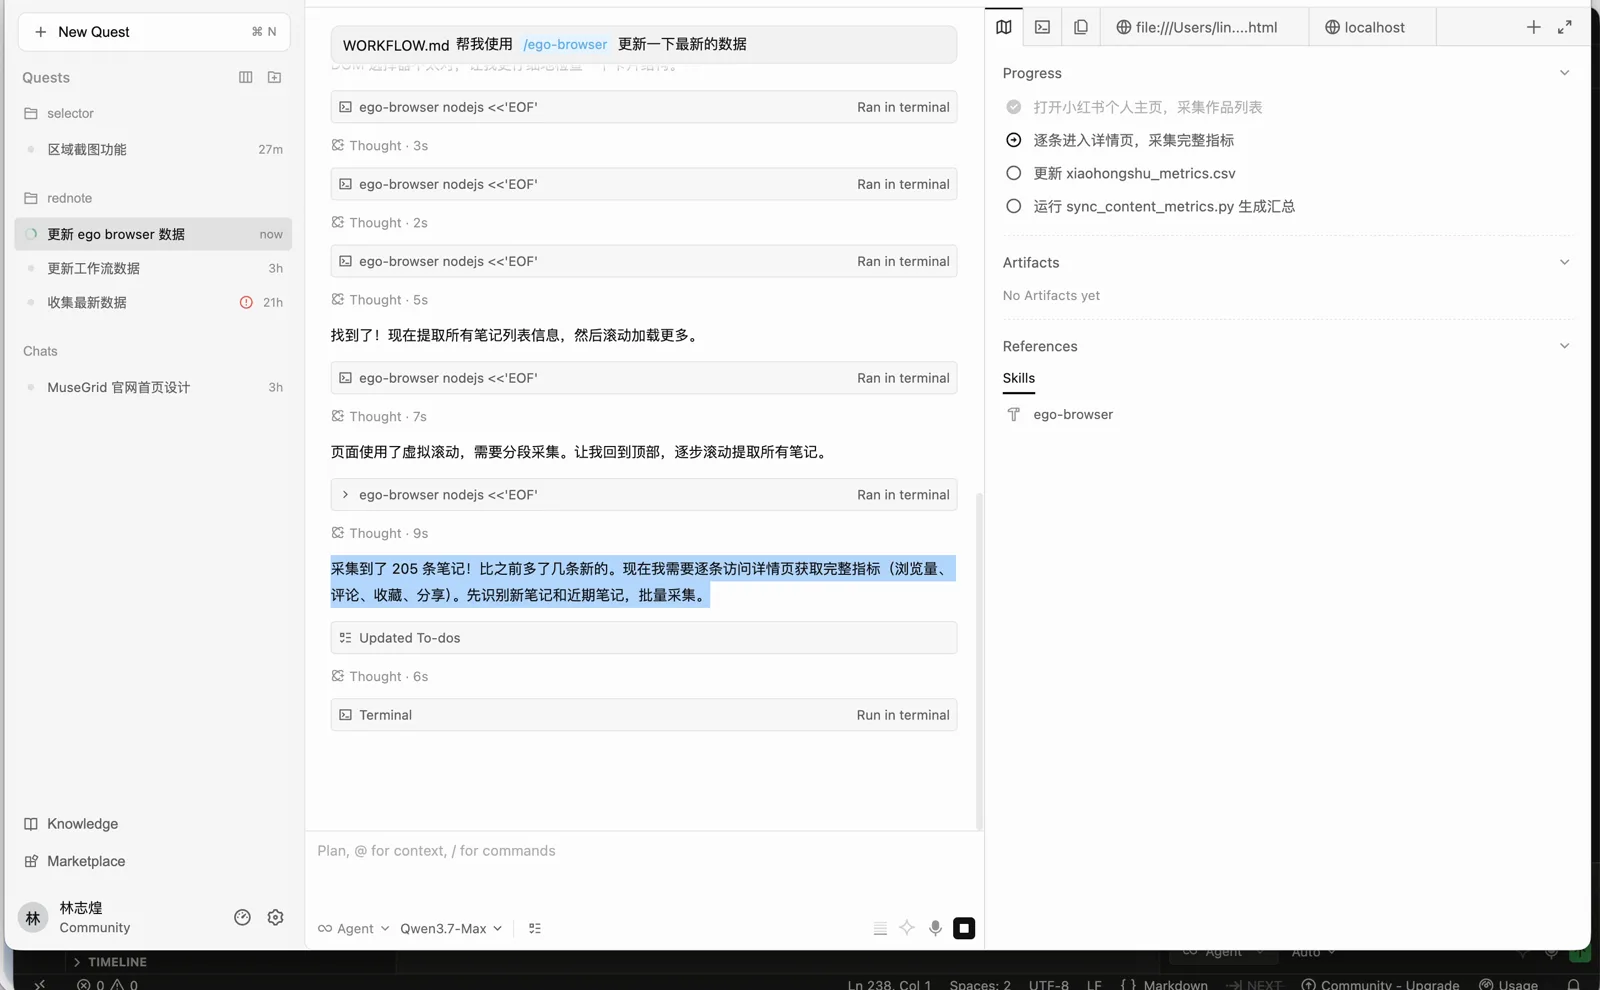
这里再演示一个 case,让 Qoder 去做一些自动化的任务。我跟它说,参考我的 workflow,使用 Ego Browser 这个 Skill 去更新一下我最新的小红书的数据,然后回车发送给它。
浏览器里面,它开始自动化地浏览我的页面,拿我页面里面的最新数据。因为我之前发的帖子比较多,它会一步一步往下面滚动,把我全部的数据都获取到。
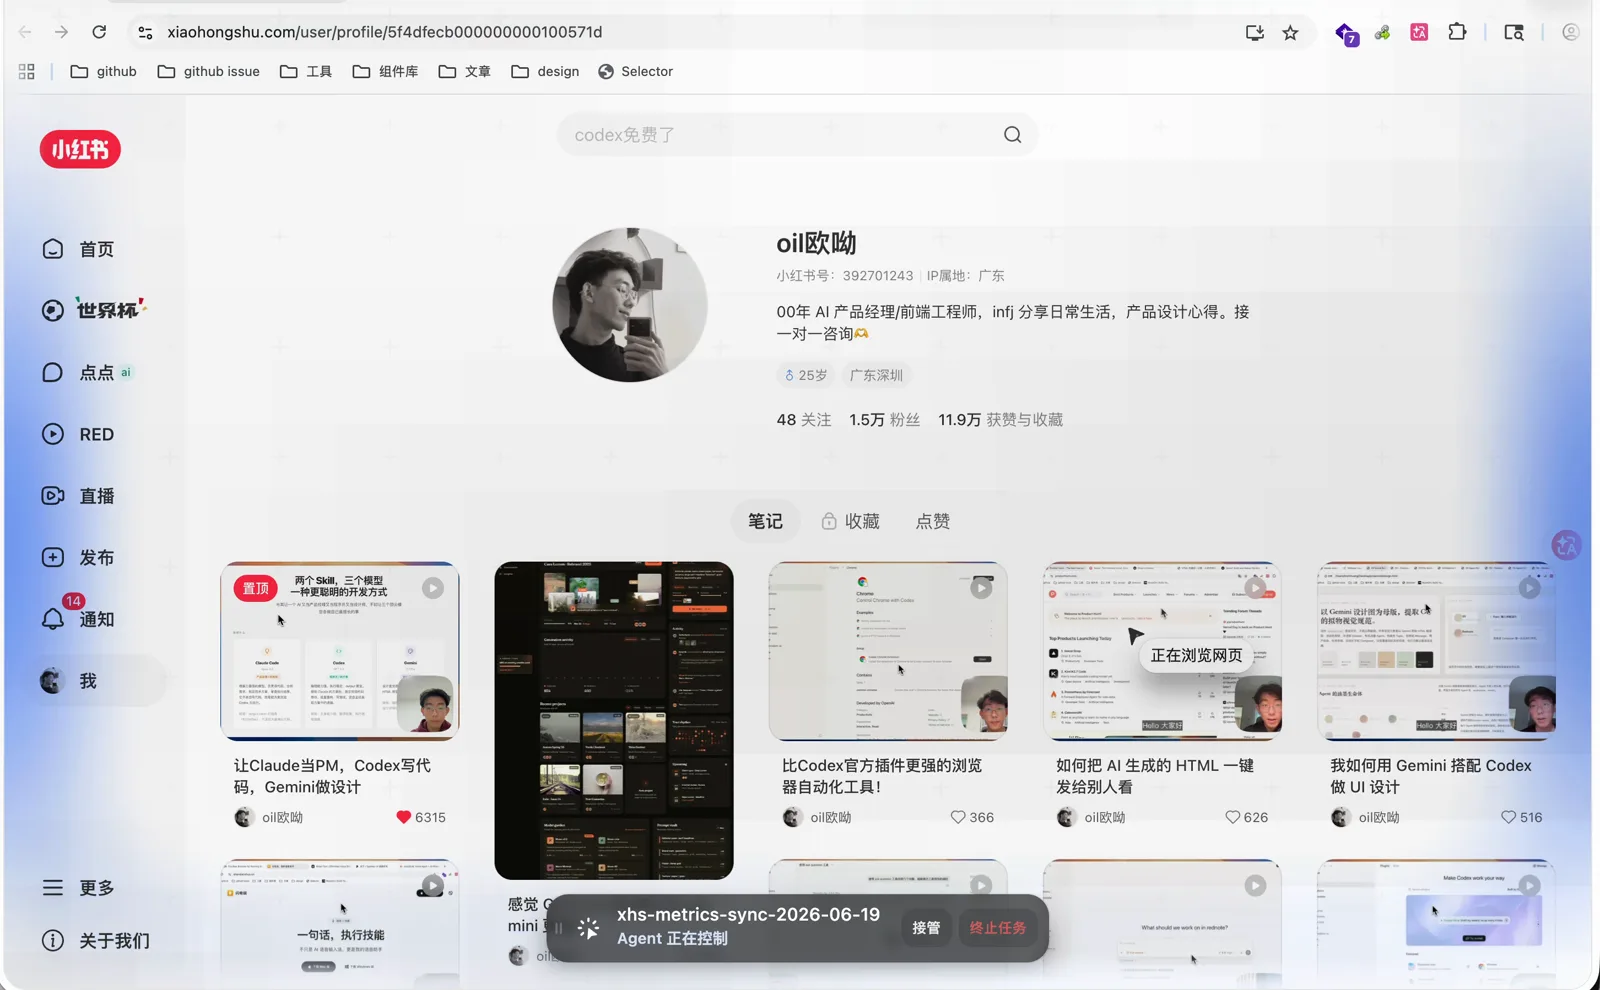
回到 Qoder 应用里面看,它会自己去分析:我们现在这个页面使用了虚拟滚动,所以它会自己判断应该使用什么策略来执行,分段采集。最后它采集到了 205 条笔记的数据,接下来把这些数据全部写到我之前的一个 Excel 表格里面。
这种自动化的任务对于 Qwen3.7-Max 来说还是比较轻松的,它本身的 Agent 能力比较强。
费用和额度
如果我们本身在用 AI 写代码,想选择一些国内的产品,我觉得 Qoder 加 Qwen3.7-Max 是非常值得一试的。它现在每天有 200 次的免费使用额度,订阅 59 块钱一个月就有 2000 的 credits。在 Qoder 里面可以看到,Qwen3.7-Max 的额度消耗是 0.2 倍,甚至低于 DeepSeek V4 Pro,整体的性价比很高。