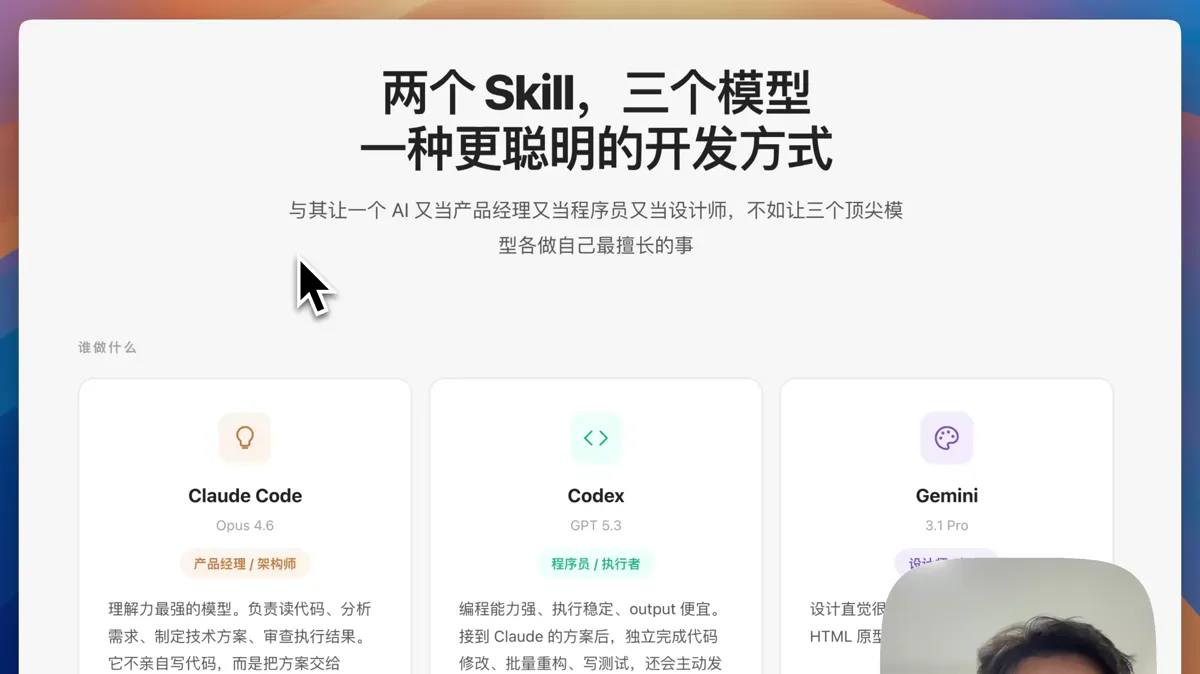
最近几天我在高频使用一种新的开发方式:用一个主 Agent 去调用其他模型的 Agent。具体做法是在 Claude Code 里面创建了两个 Skill,一个调用 Codex,一个调用 Gemini,Claude Code 会根据不同的任务自己调度它们。
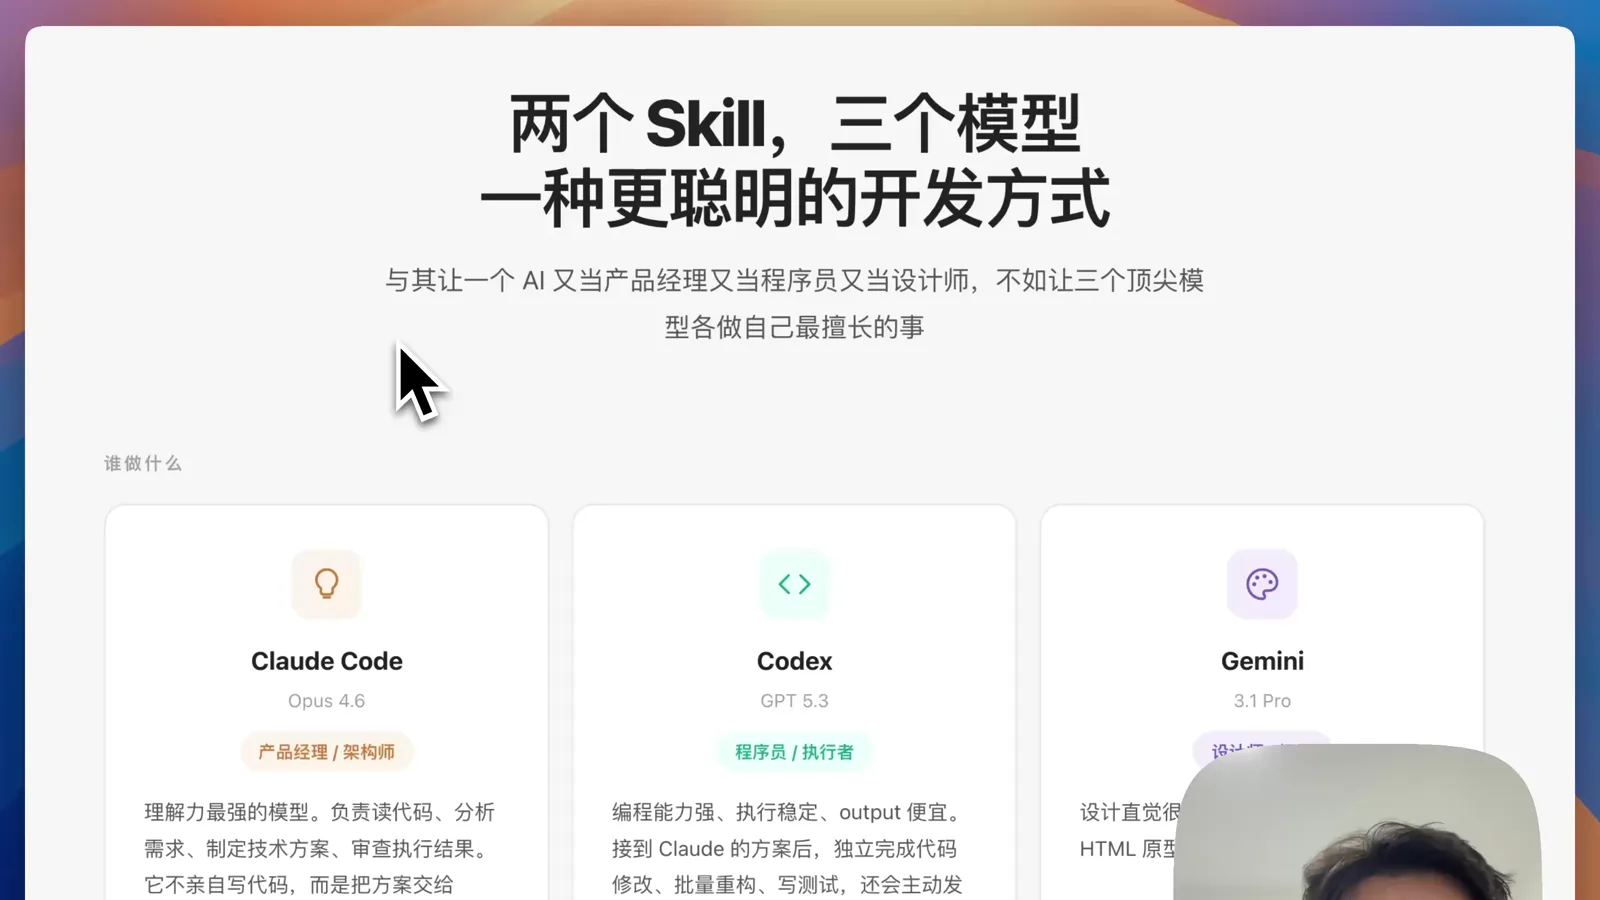
三个模型各自负责什么
目前几个顶尖模型的优缺点都比较明显,让三个模型各做自己最擅长的事,比一个模型包打全场更合理:
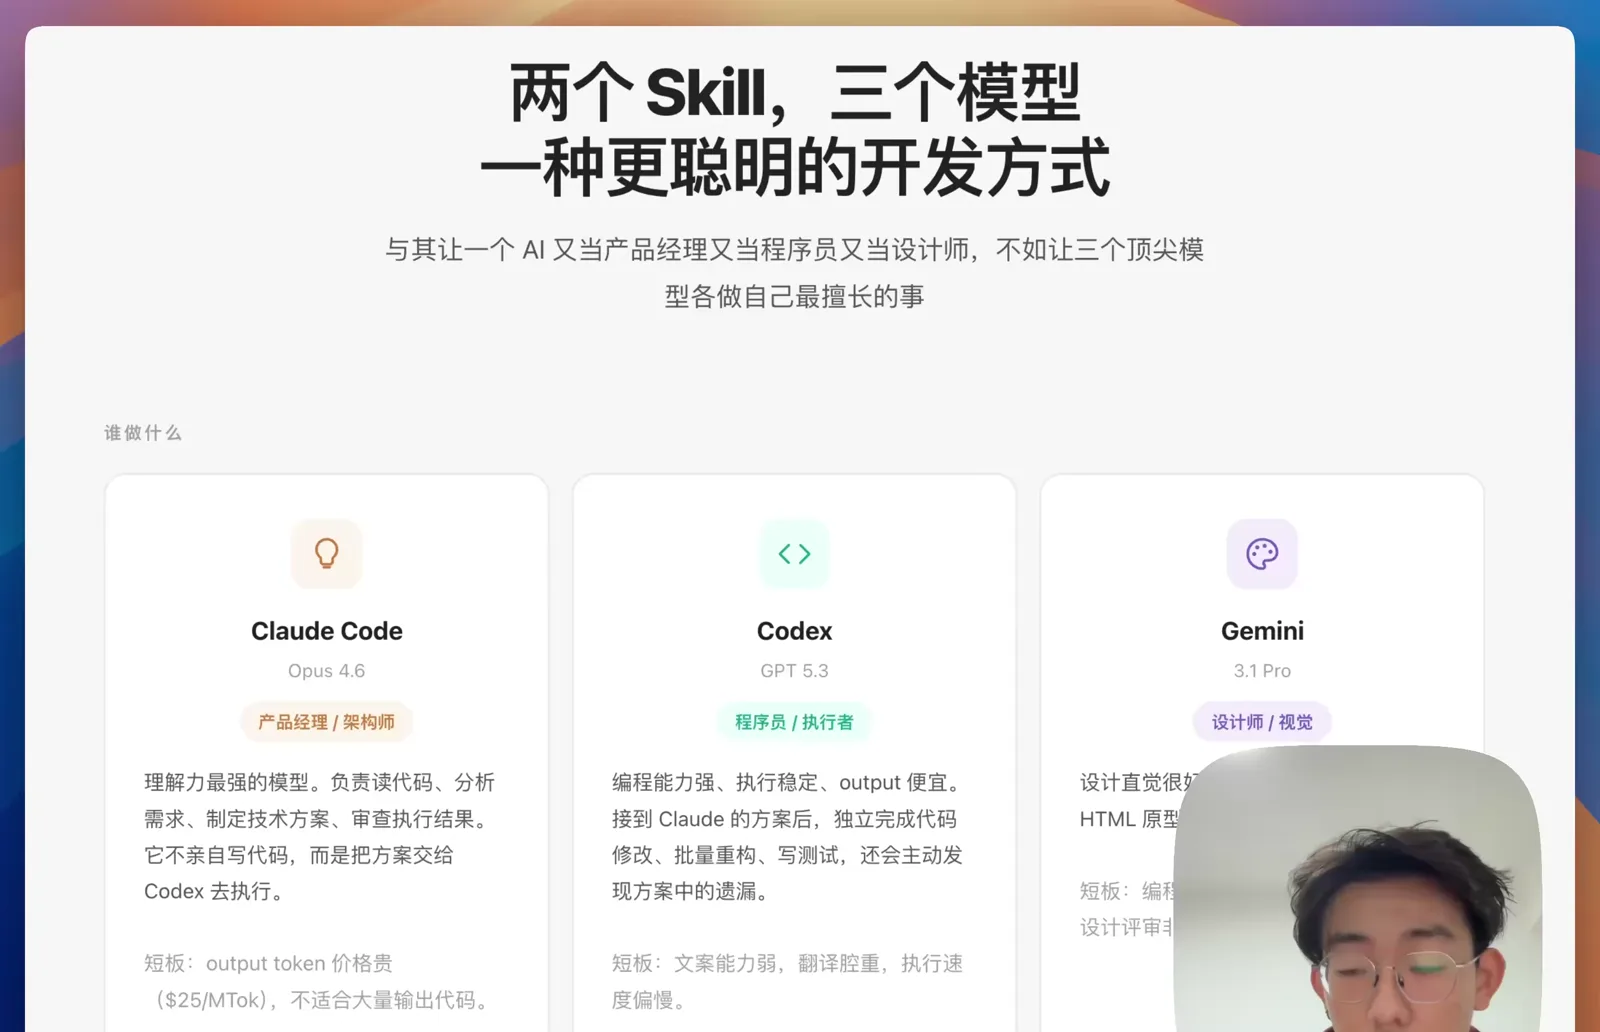
- Claude Code 的理解能力和代码能力最强,负责读代码、分析需求、制定技术方案、审查执行结果,但价格贵。它不亲自写代码,而是把方案交给 Codex 执行。
- Codex 价格便宜,编程能力强、执行稳定,负责接到方案后独立完成代码修改、批量重构和测试。它的短板是文案能力弱,写出的方案翻译腔比较重,UI 和 UX 能力也偏弱。
- Gemini 的视觉设计做得很好,做 SVG 和写方案也不错,负责设计类任务。它的短板是长上下文编程,经常自己改着改着就改乱了,指令遵循性也会变差。
两个 Skill 里,一个调用 Codex 的命令行工具,另一个直接向 Gemini 发送请求。Gemini 那边有一个脚本,可以把产出的内容固定为 Markdown,或者固定为 HTML 设计稿。
省钱:让贵的模型少输出
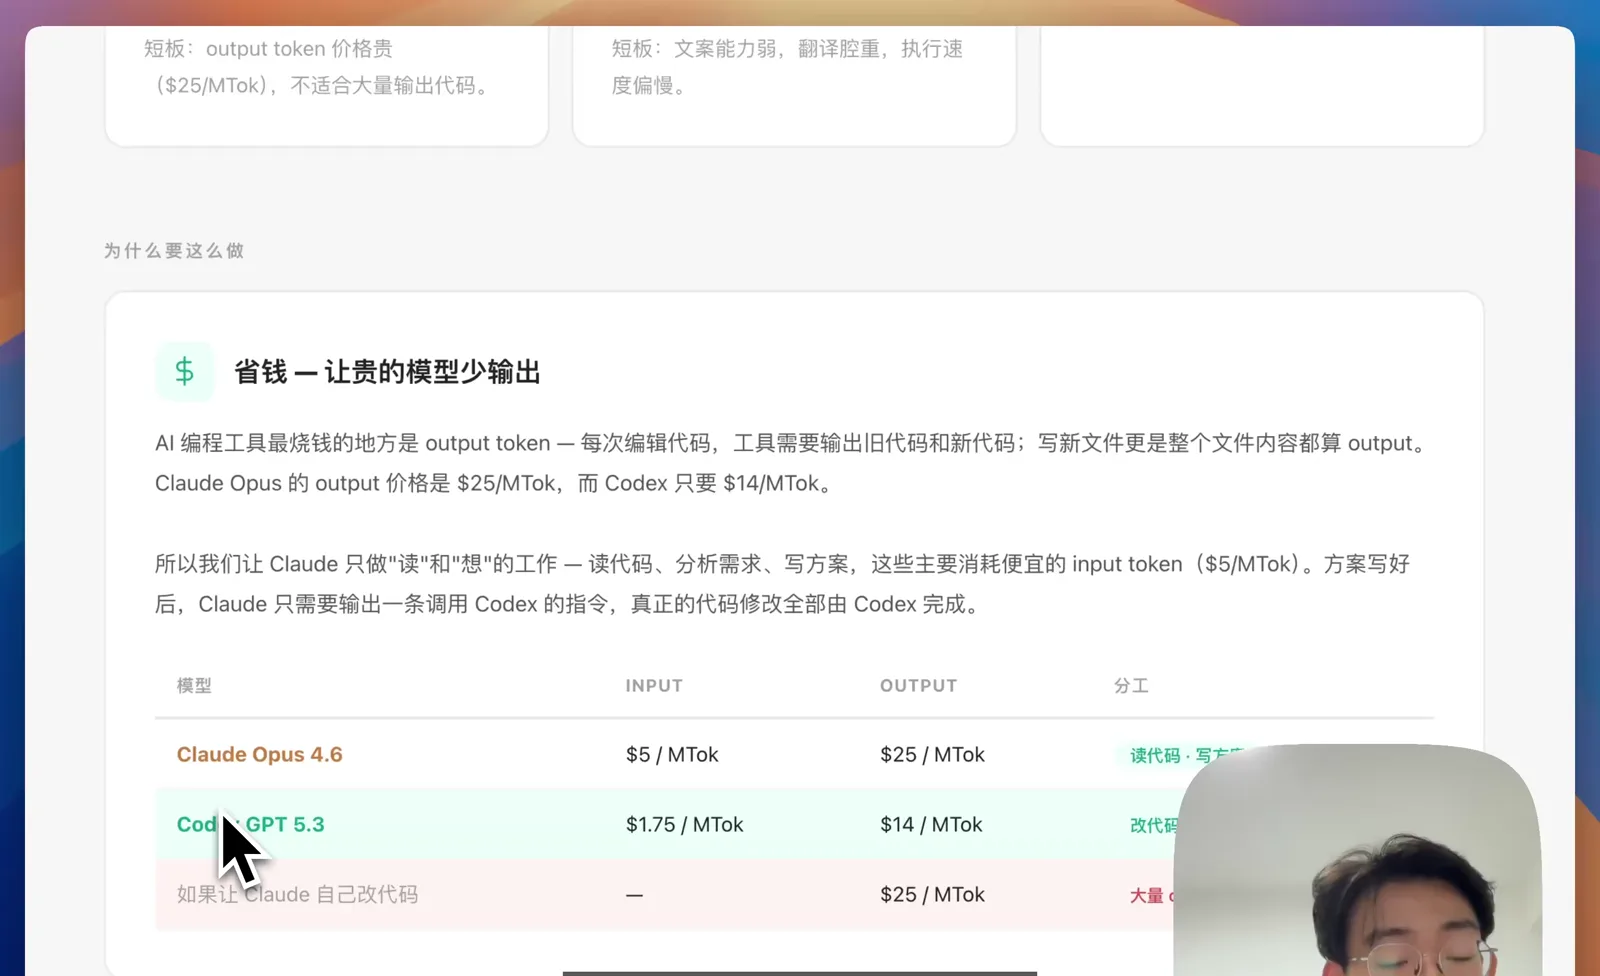
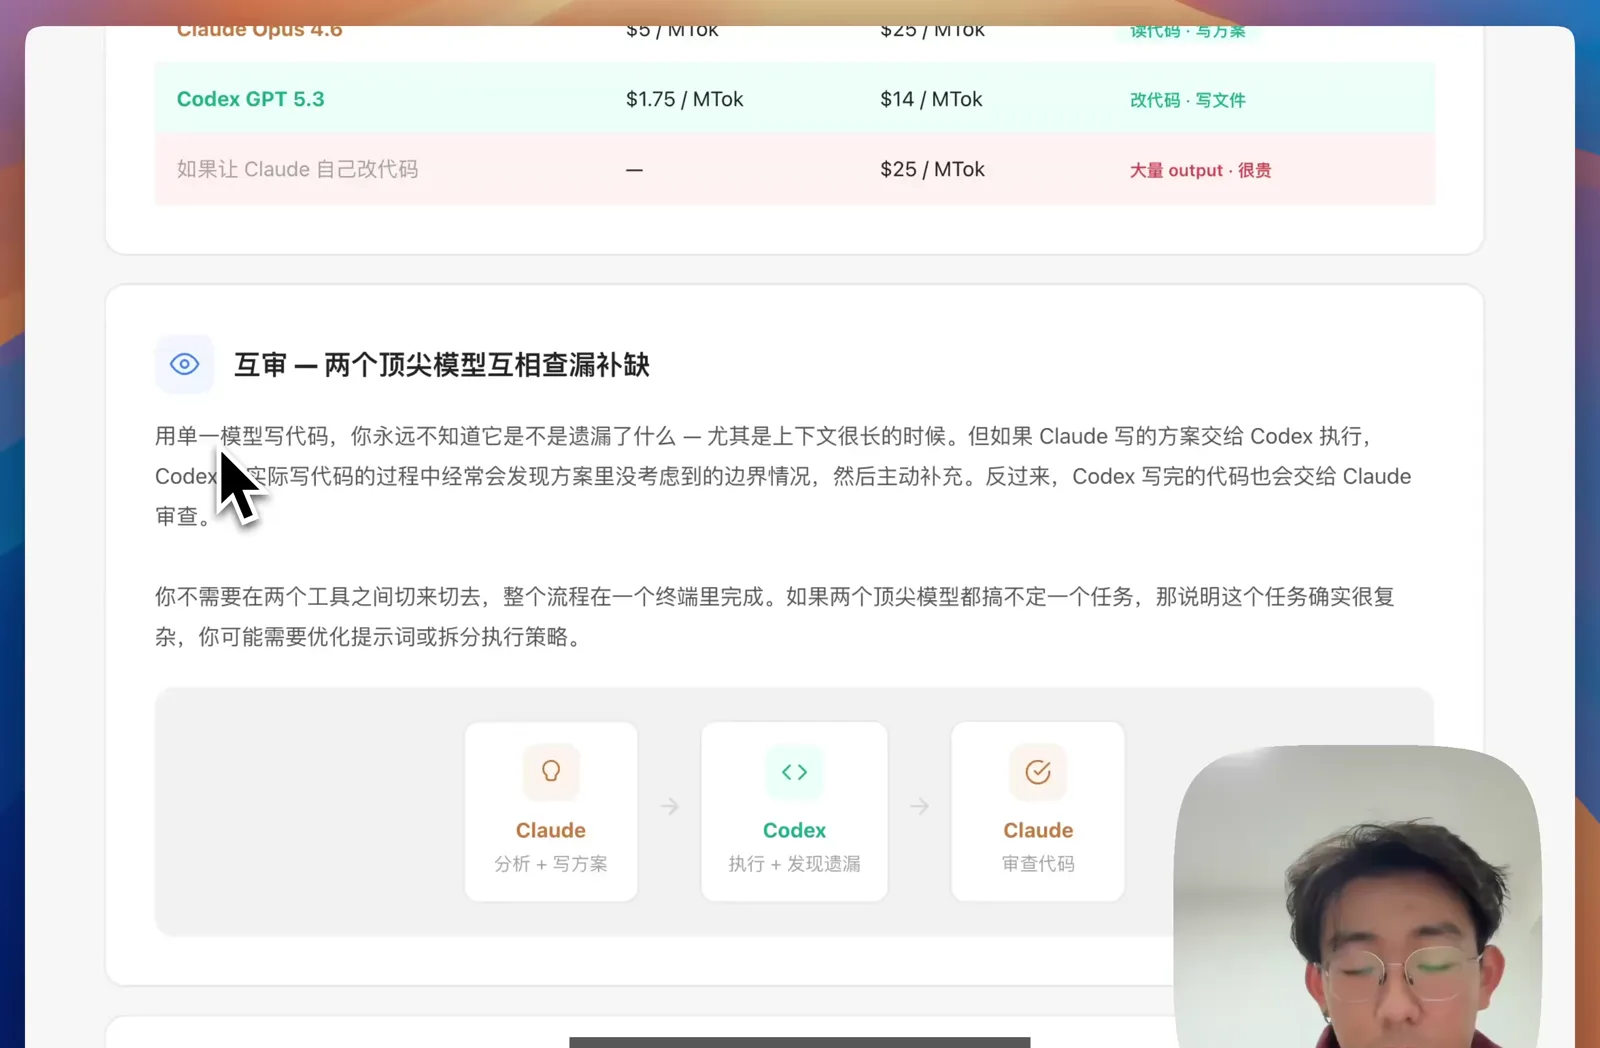
我最开始只做 Claude Code 调用 Codex,动机就是省钱。AI 编程工具最烧钱的地方是 output token:每次编辑代码,工具都要输出旧代码和新代码。Claude Opus 的 output 价格是 $25/MTok,而 Codex 只要 $14/MTok。让 Claude Code 自己执行,一次任务可能就要几美金,一天下来大几十美金是常有的事。
现在的分工是,Claude 只做读和想的工作,也就是读代码、分析需求、写方案,这些主要消耗便宜的 input token($5/MTok)。方案写好之后,Claude 只需要输出一条调用 Codex 的指令,真正的代码修改全部由 Codex 完成。Claude 的输出 token 很少,Codex 本身价格又便宜,整体算下来省了很多钱。而且在长上下文的情况下,Codex 的执行有时表现得比 Claude 还更稳定。
互审:两个模型互相查漏补缺
用单一模型写代码的时候,我总会有心理负担:用 Claude Code 写,会怀疑这个任务是不是交给 Codex 执行更好;用 Codex 执行,又觉得它的方案不如让 Claude Code 来写。
两个模型协作之后,流程变成 Claude 写方案,Codex 先审查方案再执行,执行完 Claude 再审查代码。彼此的方案和代码都可以相互检查、相互补充。后面的案例会看到,这种协作确实能发现很多单个模型会遗漏的问题。
上下文精简:让决策者保持清醒
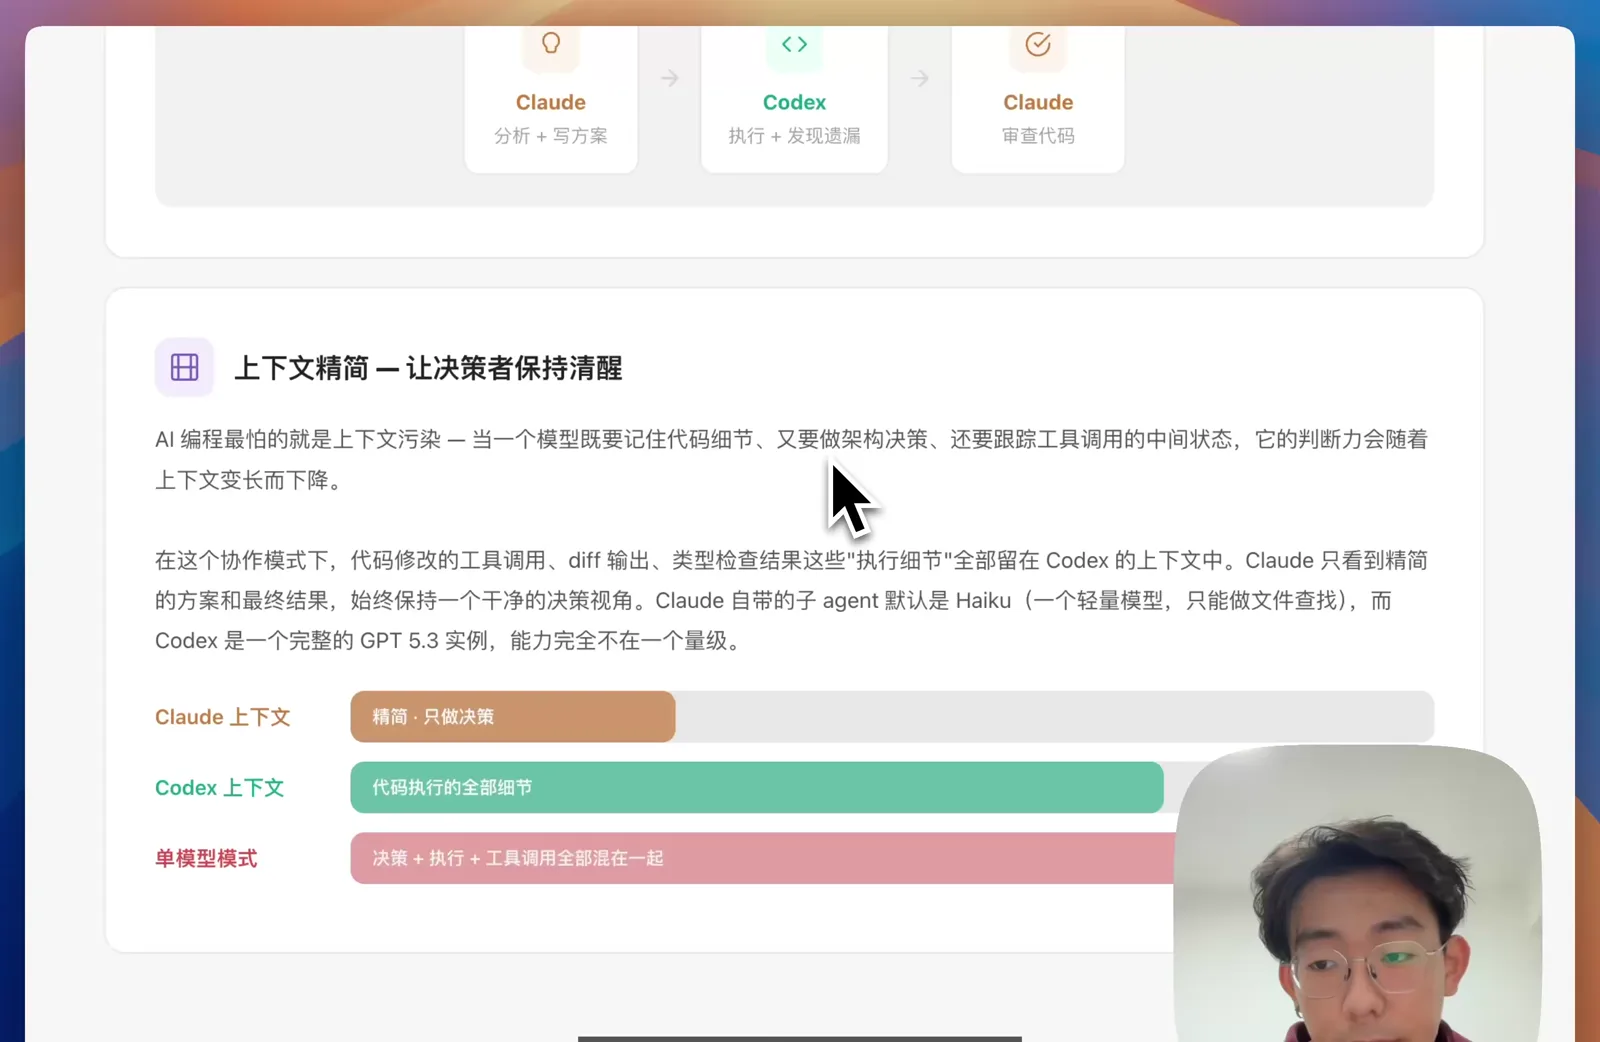
在 Cursor 里面,同一个话题下切换不同的模型,之前的上下文还是共用的。用 Agent 的形式就不一样了:Claude Code 调用 Codex 的时候,只把方案传过去,Codex 拿到明确的方案和需要查看的文件,省掉了前面的探索步骤。执行过程中产生的文件修改、diff 输出、旧字符串和新字符串这些内容,全部留在 Codex 的上下文里,不会进入 Claude Code 的上下文。Claude 只看到精简的方案和最终结果,始终保持一个干净的决策视角。
另外,Claude Code 自带的子 Agent 默认是 Haiku,一个轻量模型,只能做文件查找。用 Codex 作为子 Agent,代码能力比 Haiku 强很多,价格比 Haiku 高一些,但还是比 Opus 便宜很多。
三个实战案例
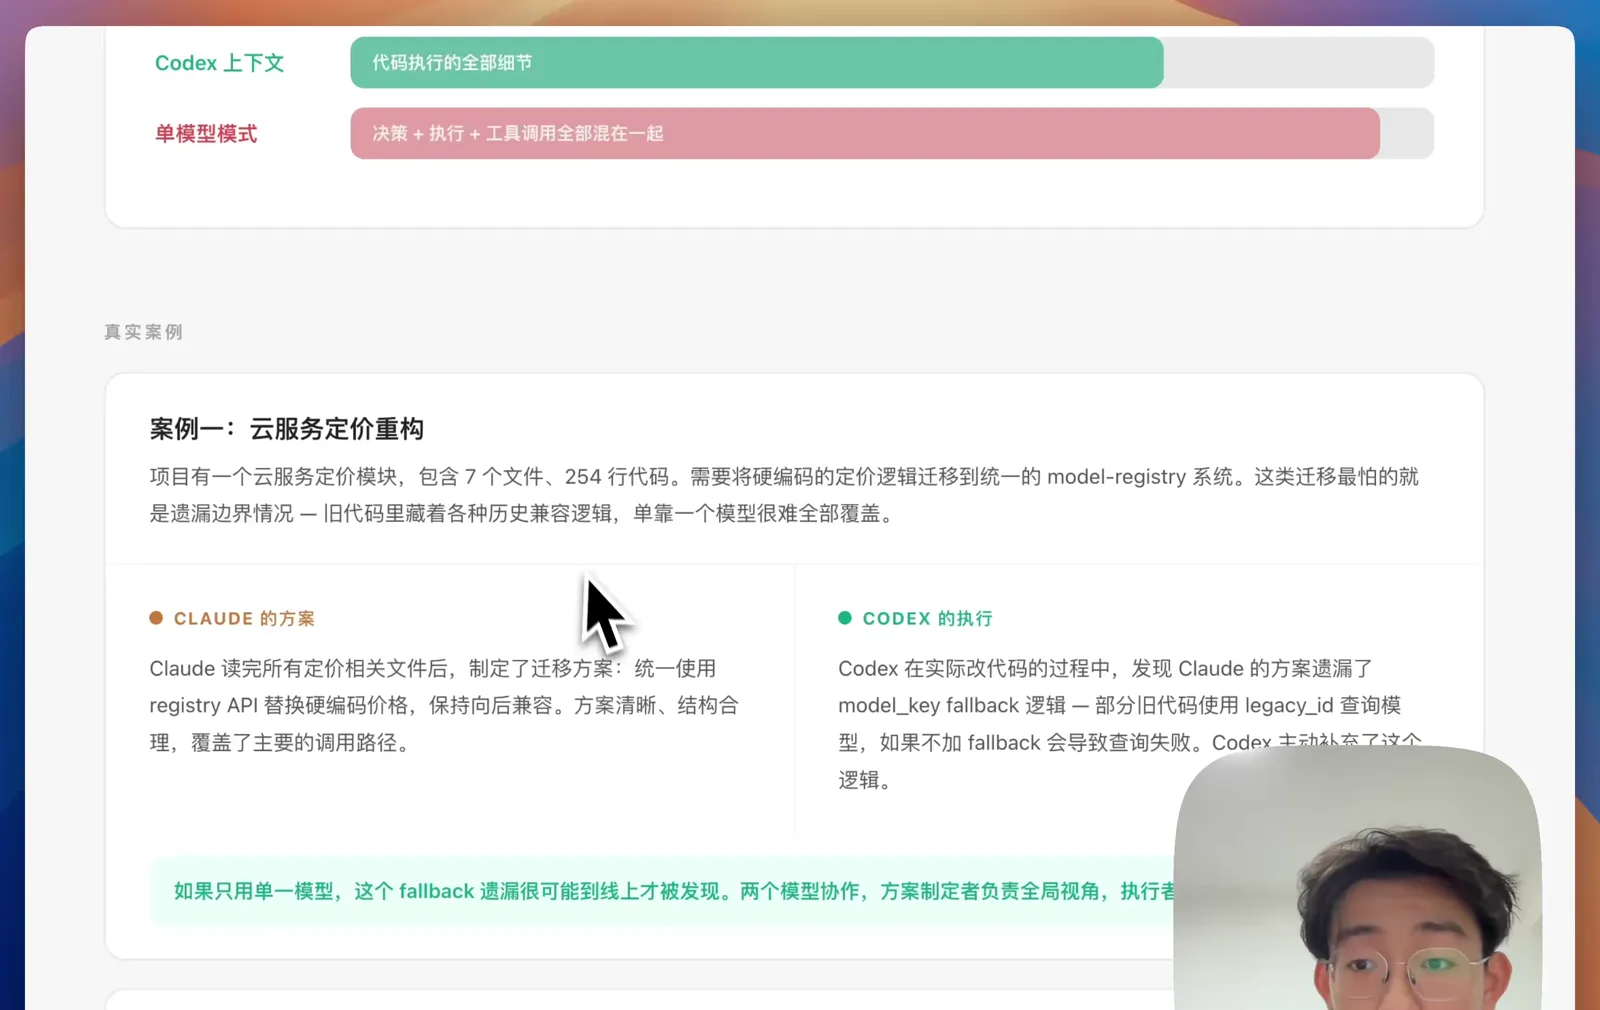
第一个案例是云服务定价重构。项目里有一个定价模块,包含 7 个文件、254 行代码,需要把硬编码的定价逻辑迁移到统一的 model-registry 系统。Claude 读完所有定价相关文件后制定了迁移方案,方案清晰、结构合理。Codex 在实际改代码的过程中,发现 Claude 的方案遗漏了 model_key fallback 逻辑:一部分旧代码使用 legacy_id 查询模型,不加 fallback 会导致查询失败。Codex 主动补充了这个逻辑,再反馈给 Claude,Claude 看过觉得没问题,这个逻辑基本就确定下来了。如果只用单一模型,这个遗漏很可能到上线才会被发现。两个模型协作,一个负责全局视角,一个负责细节审计。
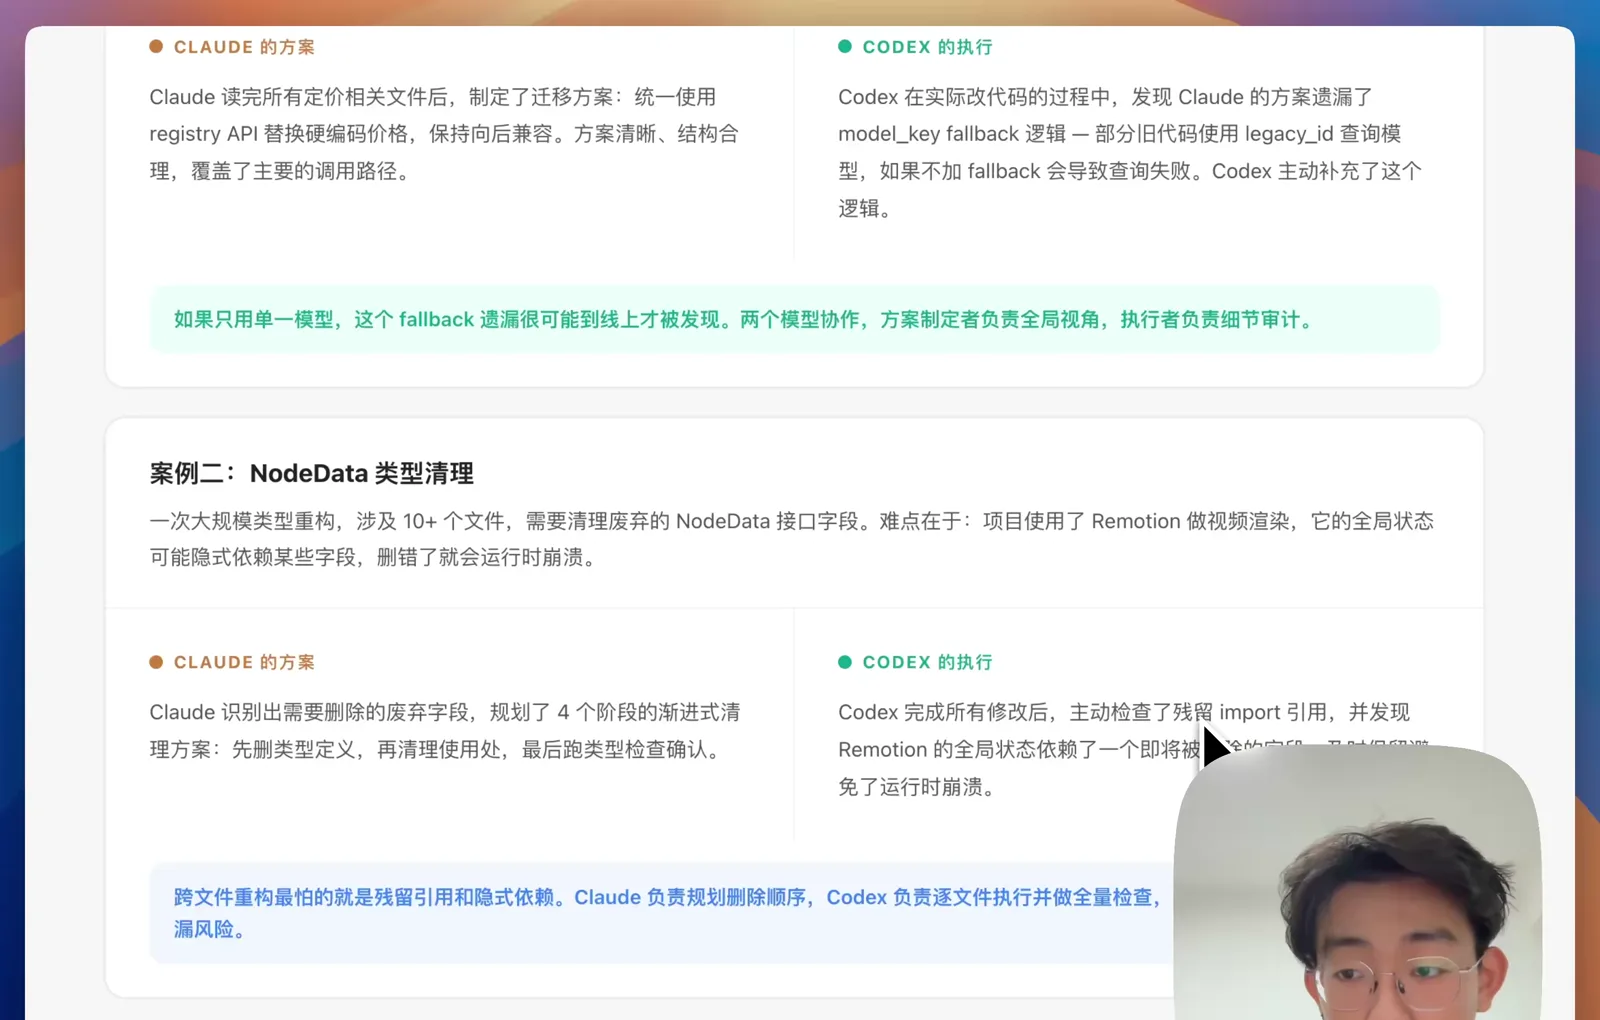
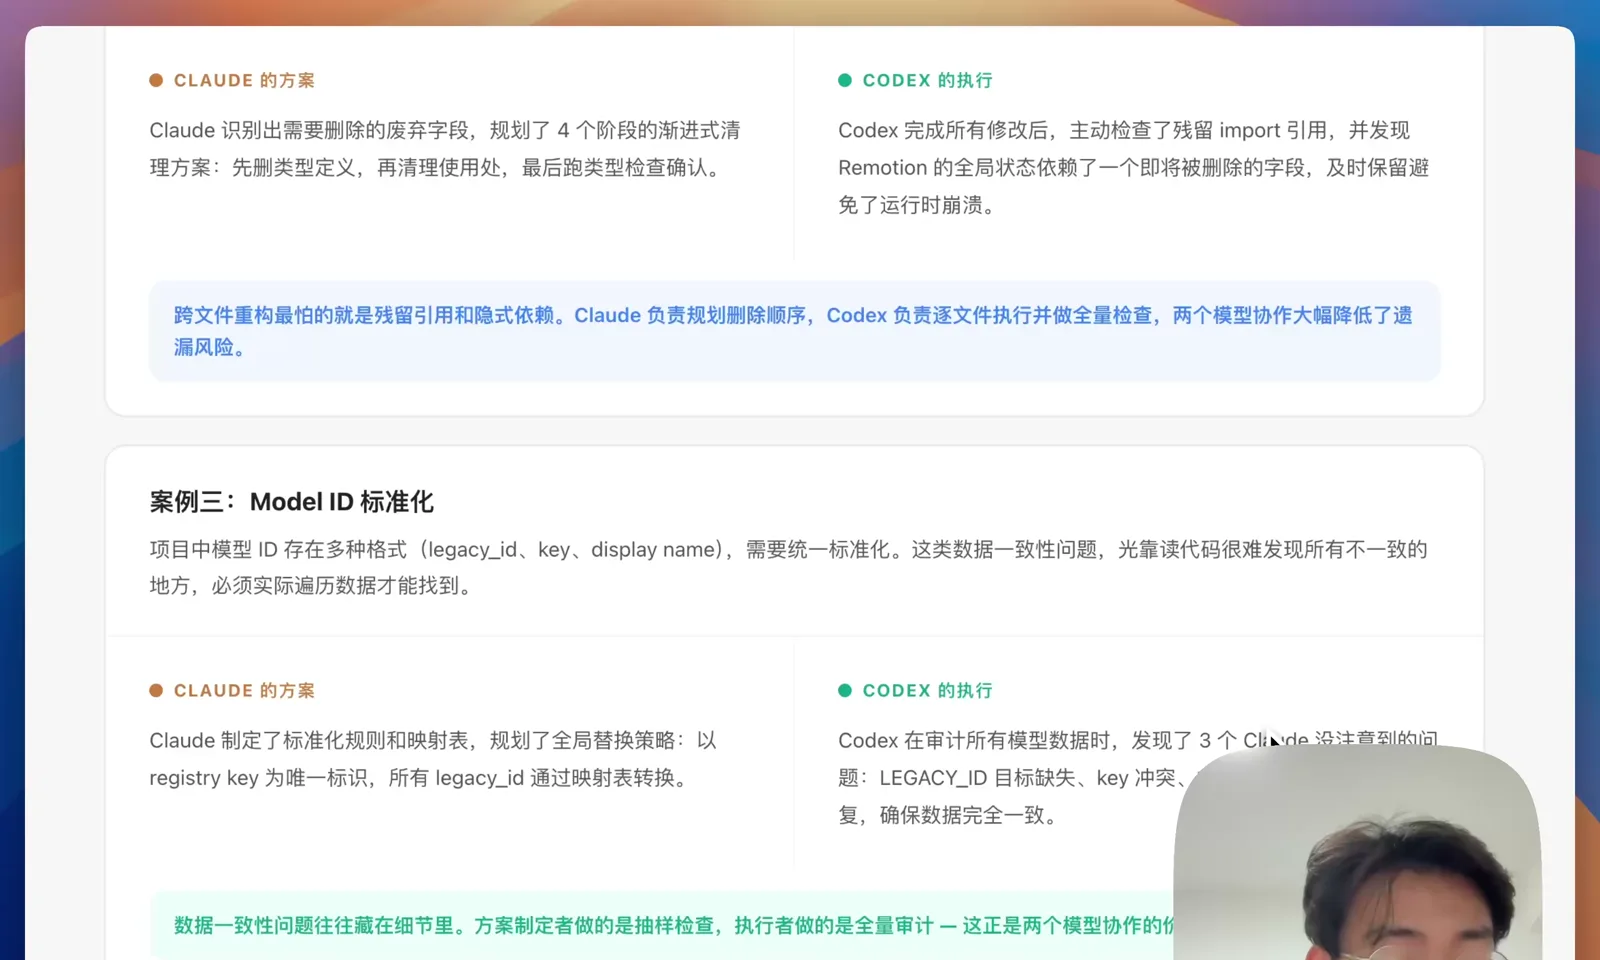
第二个案例是一次大规模类型重构,涉及 10 个以上的文件,需要清理废弃的 NodeData 接口字段。难点在于项目使用了 Remotion 做视频渲染,全局状态可能隐式依赖某些字段,删错了就会运行时崩溃。Claude 识别出需要删除的废弃字段,规划了 4 个阶段的渐进式清理方案。Codex 完成所有修改之后,自己主动多做了一步:检查残留的 import 引用,结果真的发现 Remotion 的全局状态依赖了一个即将被删除的字段,及时保留了下来,避免了运行时崩溃。
第三个案例是 Model ID 标准化。项目里的模型 ID 存在 legacy_id、key、display name 多种格式,需要统一。这类数据一致性问题,光靠读代码很难发现所有不一致的地方,必须实际遍历数据。Claude 制定了标准化规则和映射表,Codex 在审计所有模型数据时,发现了 3 个 Claude 没注意到的问题:LEGACY_ID 目标缺失、key 冲突、本地标准化漂移,并逐一修复。
这种互审能发现光靠读代码发现不了的问题。就像真实开发一样,产品经理的方案想得再全,corner case 也往往是在落地过程中才发现的。现在 Codex 执行的对话信息全部会存档成 Markdown,Claude 会去查看它具体做了什么事情再审查,一个审查方案,一个审查执行效果。
安装和使用
这两个 Skill 我都已经开源了。Codex 的 Skill 安装命令是:
npx skills add oil-oil/codex
它要求本地已经安装了 Codex 的命令行工具。另一个是 Gemini 设计的 Skill:
npx skills add oil-oil/gemini-designer
这个 Skill 需要一个能调用 Gemini 官方接口的 API key。
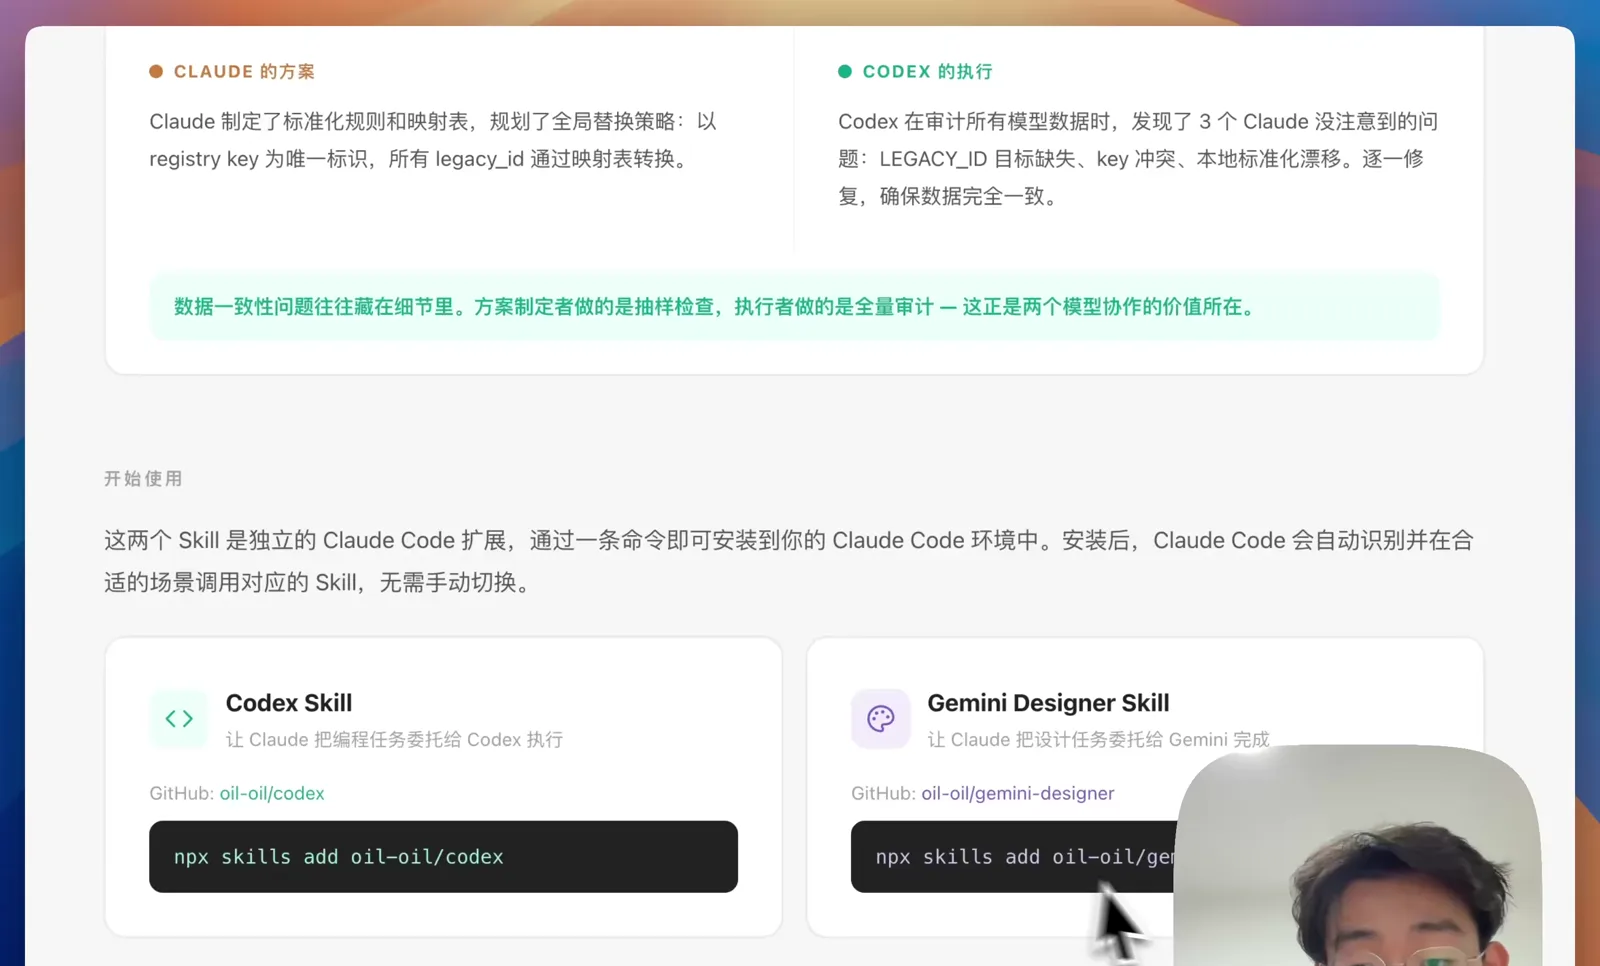
安装之后,在 Claude Code 里面写 /codex 或者 /gemini-designer,或者在任务描述里提到 codex 或 gemini,就会触发这两个外部模型去执行,不需要手动切换。