前两天我准备一场分享,PPT 也由 AI 协助制作。最开始我让 Codex 编写文案,句子本身没有明显错误,但读起来不够自然,还会把普通功能的收益说得很高。这些内容可以继续修改,却不适合直接放进演示文稿。
我两年前开发 TextWell 时研究过如何减少 AI 文案痕迹。两年后,常用模型已经换了一批,原来的判断不能直接沿用,所以我用同一份字幕稿重新做了一次对比。
测试方式
我把自己口述的视频字幕交给不同模型,让它们分别整理成文章。字幕保留了我原本的说话方式,如果模型在这个基础上仍然补出夸张判断、生硬转折或没有依据的主观感受,这些痕迹会比较容易辨认。
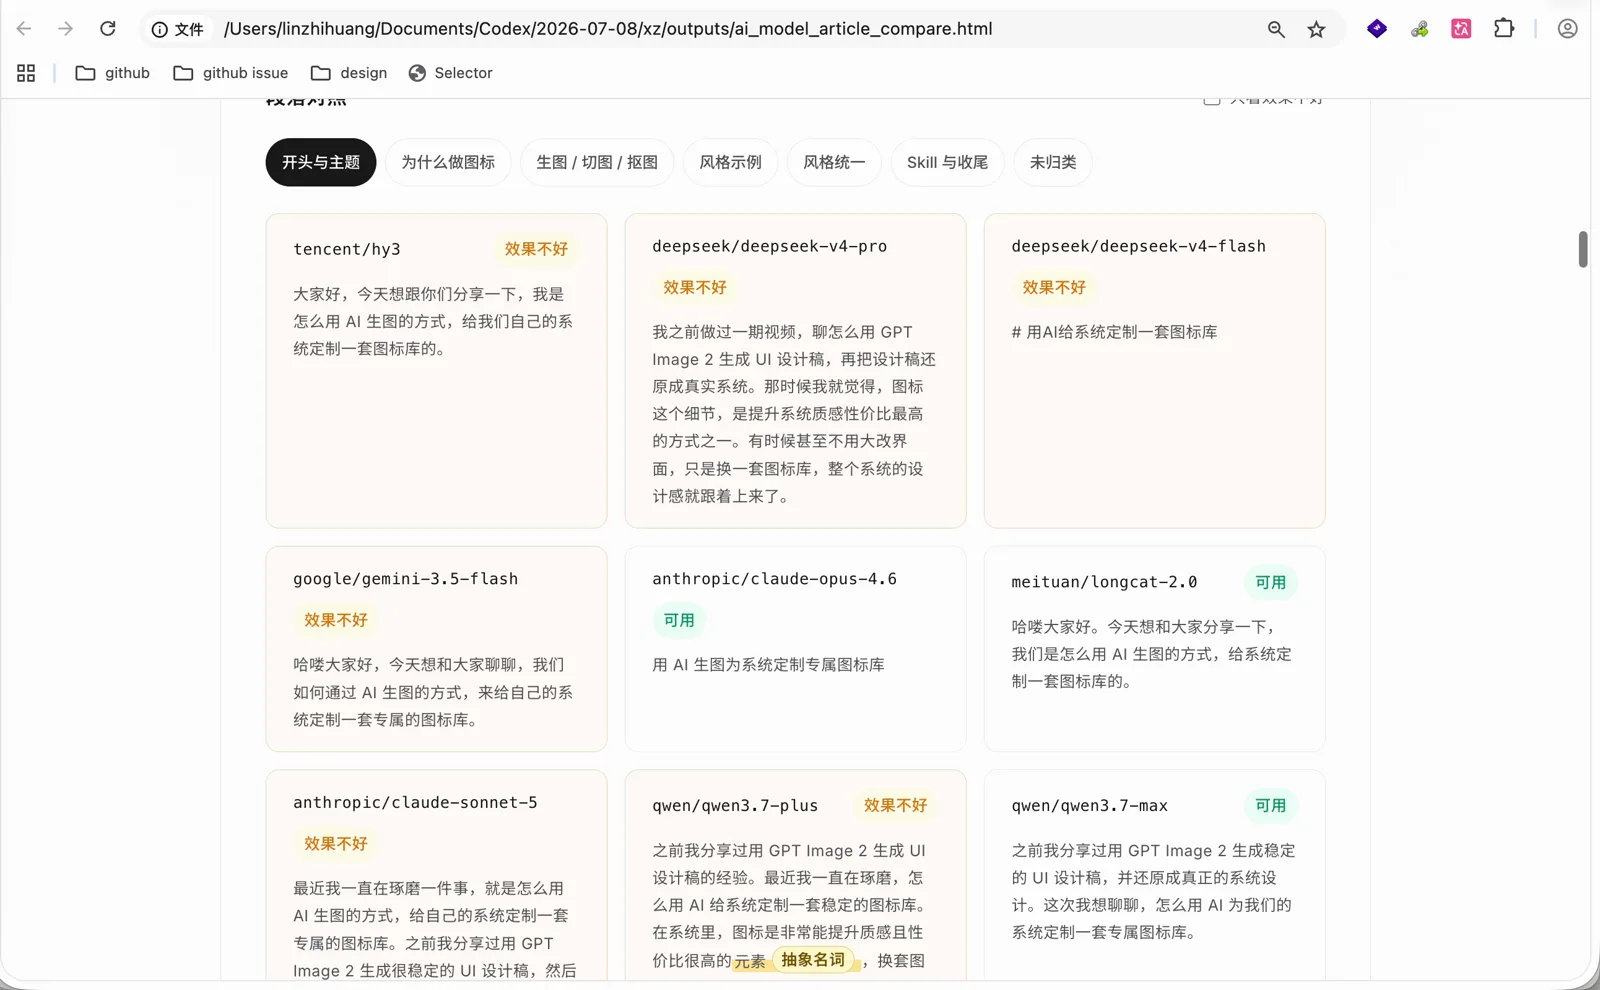
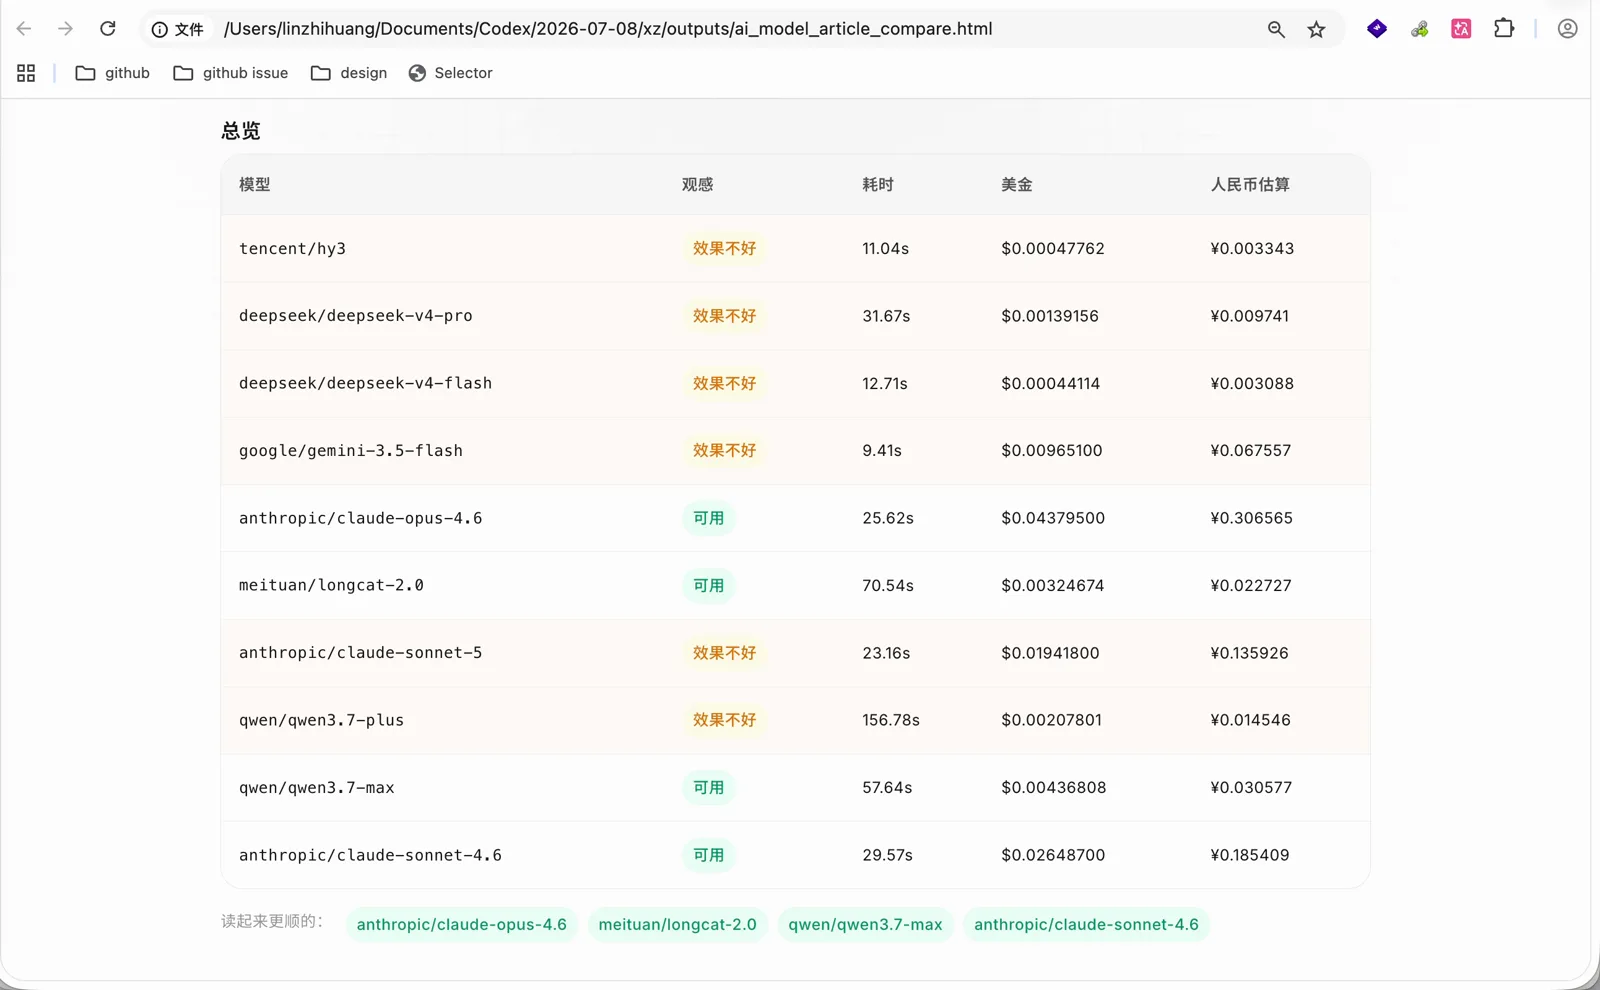
参与对比的有混元 Hy3、DeepSeek V4 Pro 和 V4 Flash、Gemini 3.5 Flash、Claude Opus 4.6、Claude Sonnet 5、Claude Sonnet 4.6、LongCat 2.0、千问 3.7 Plus 和千问 3.7 Max。我选择这些模型,是因为之前使用时觉得它们的文本水平较高;已经明显不符合要求的模型没有进入这次对比。
这不是一项客观评分。输入材料、提示词和我对自然程度的判断都会影响结果。它回答的是一个更具体的问题:同样把我的字幕整理成文章,哪个模型需要我修改的地方更少。
我最终选择的模型
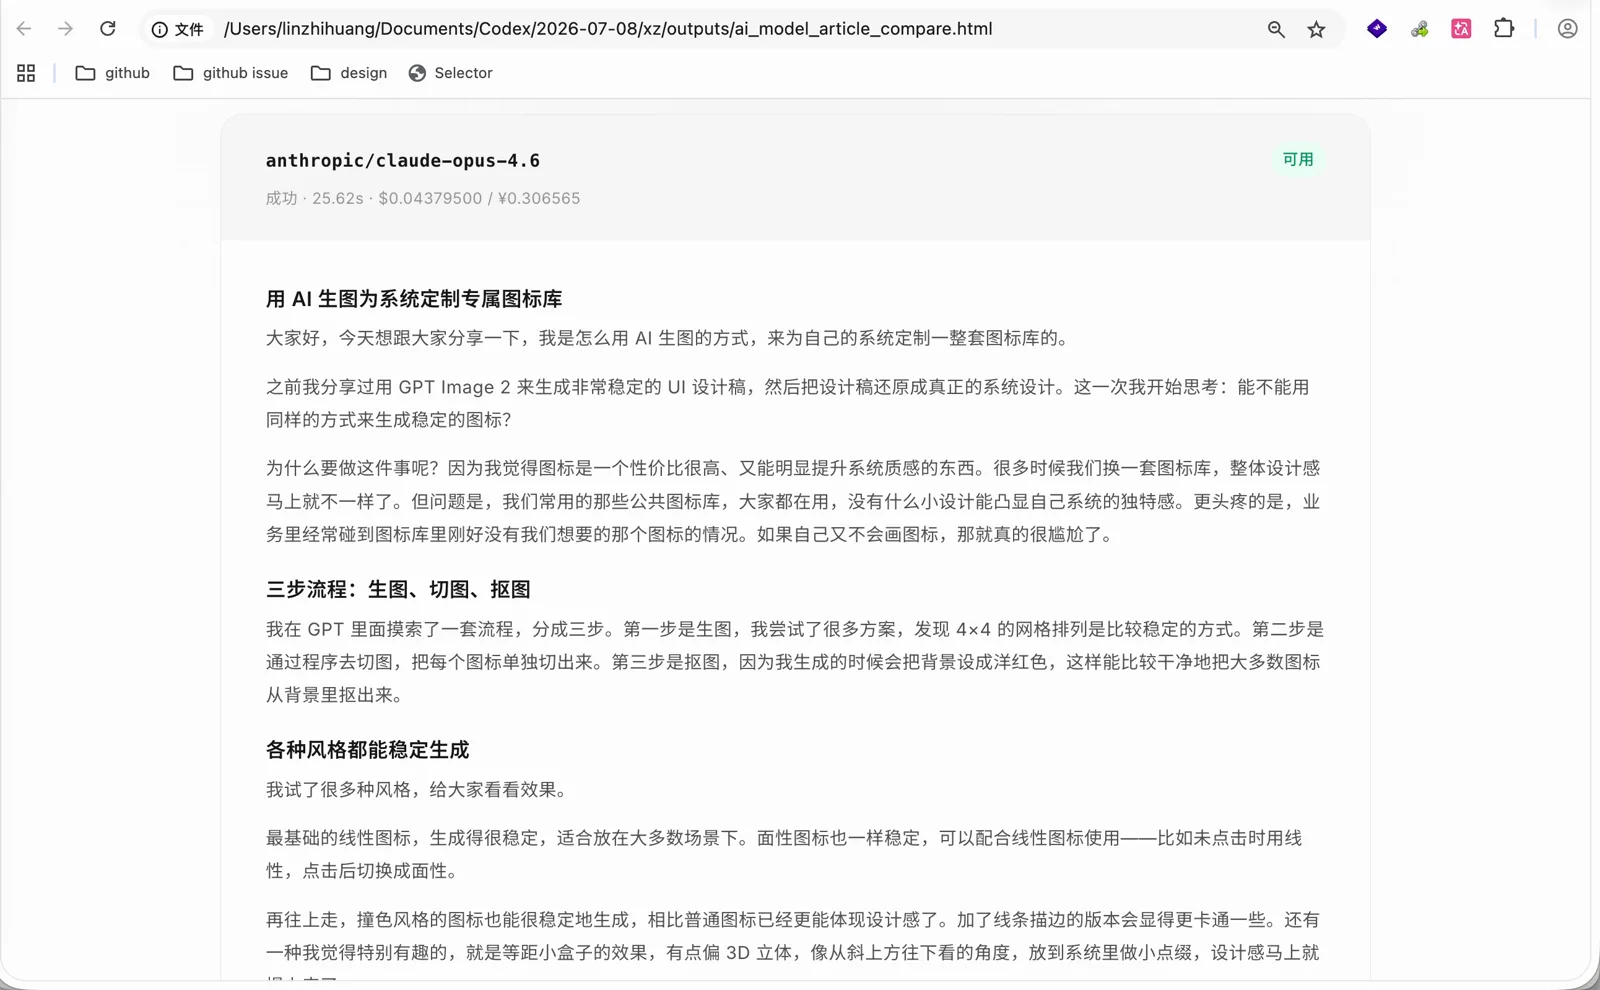
这次对比里,我最满意的是 Claude Opus 4.6。我后来也用它编写那场分享的 PPT 文案,读起来更自然,符合我对演示文稿的要求。
结合这次测试和之前的使用,我对几个模型系列的观察如下:
- Claude 的指令遵循性很强,给清楚文风要求以后,成稿通常更自然。在我用过的几个版本里,Opus 4.6 的文本表现最好,Opus 4.7 最弱,Opus 4.8 有所恢复,但仍然不如 4.6。
- GPT 的内容通常容易读懂,但喜欢使用引号、夸张收益和固定句式。GPT 5.5 比 5.4 好一些,5.6 又比 5.5 好一些,但我目前不会把它们作为中文文案的首选。
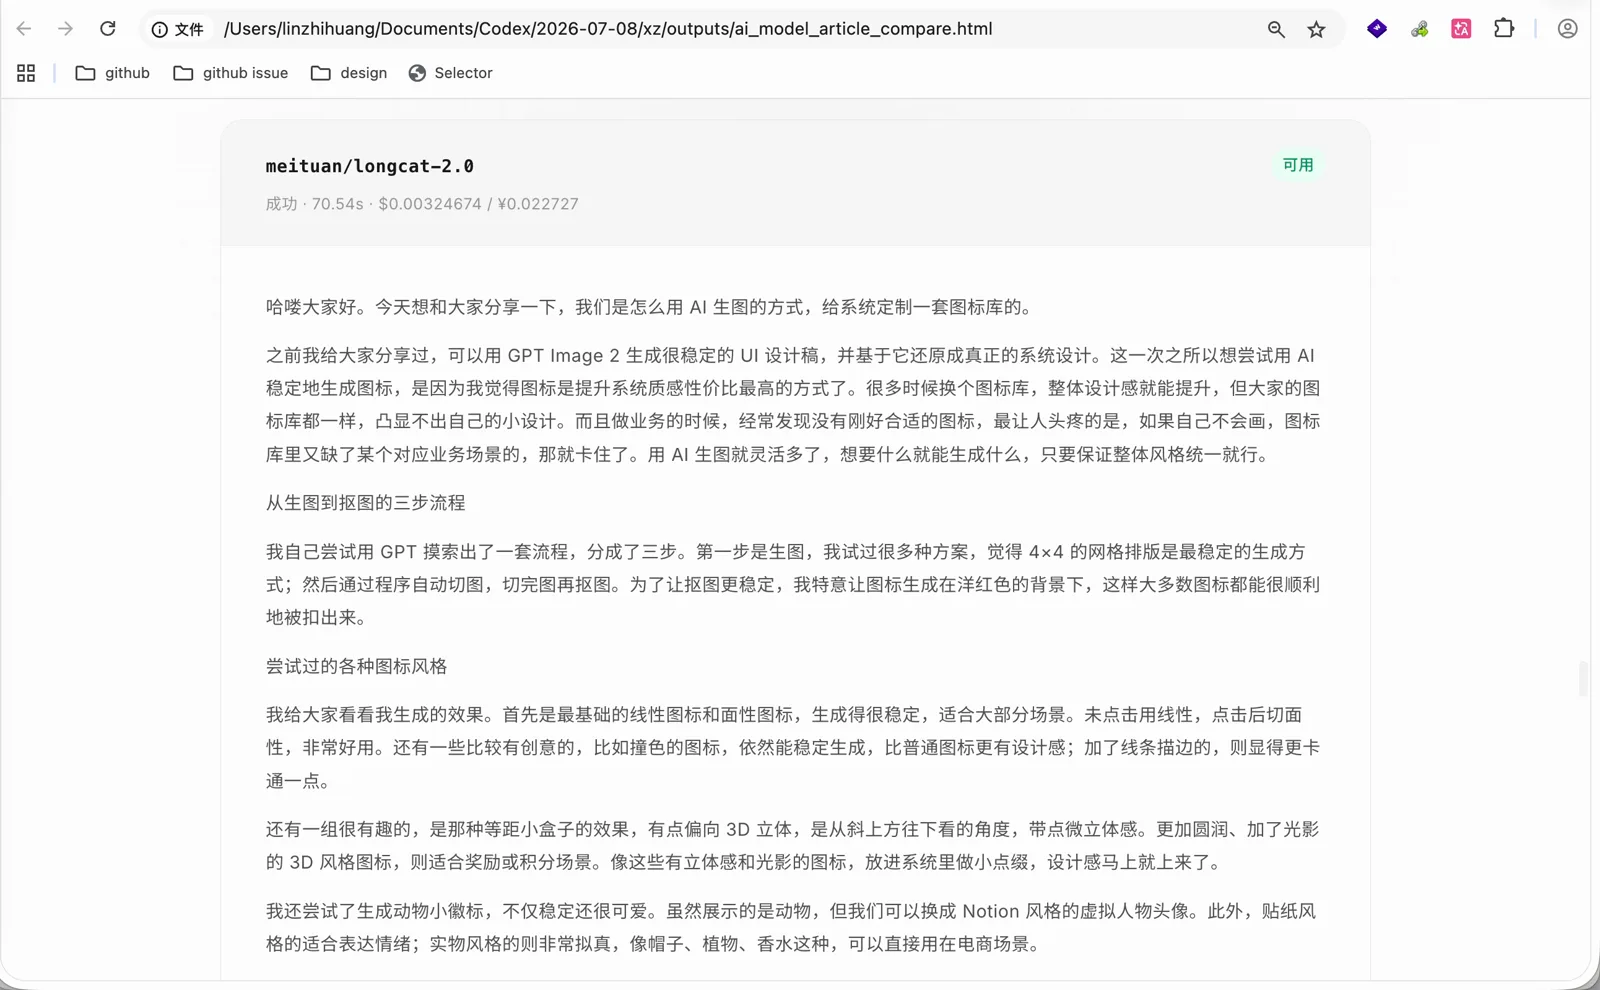
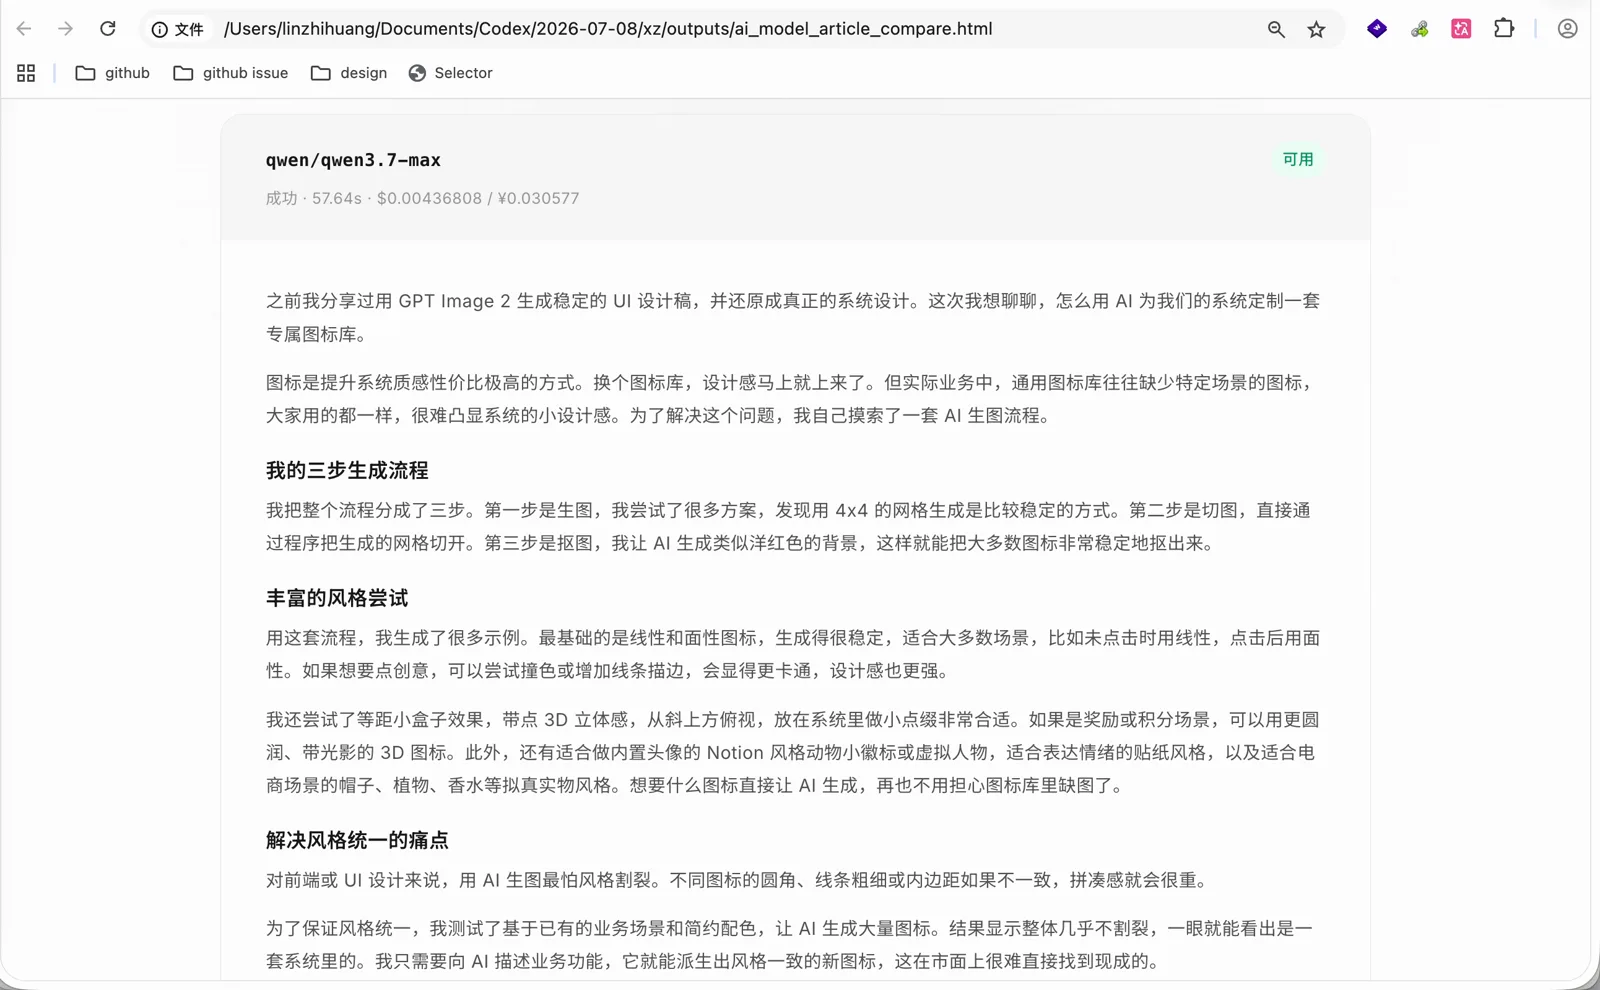
- 国产模型的中文平均表现更好。DeepSeek 早期版本和 MiniMax 都给我留下过比较自然的印象,这次测试里的 LongCat 2.0 和千问 3.7 Max 也可以继续使用。
四个可以继续使用的结果
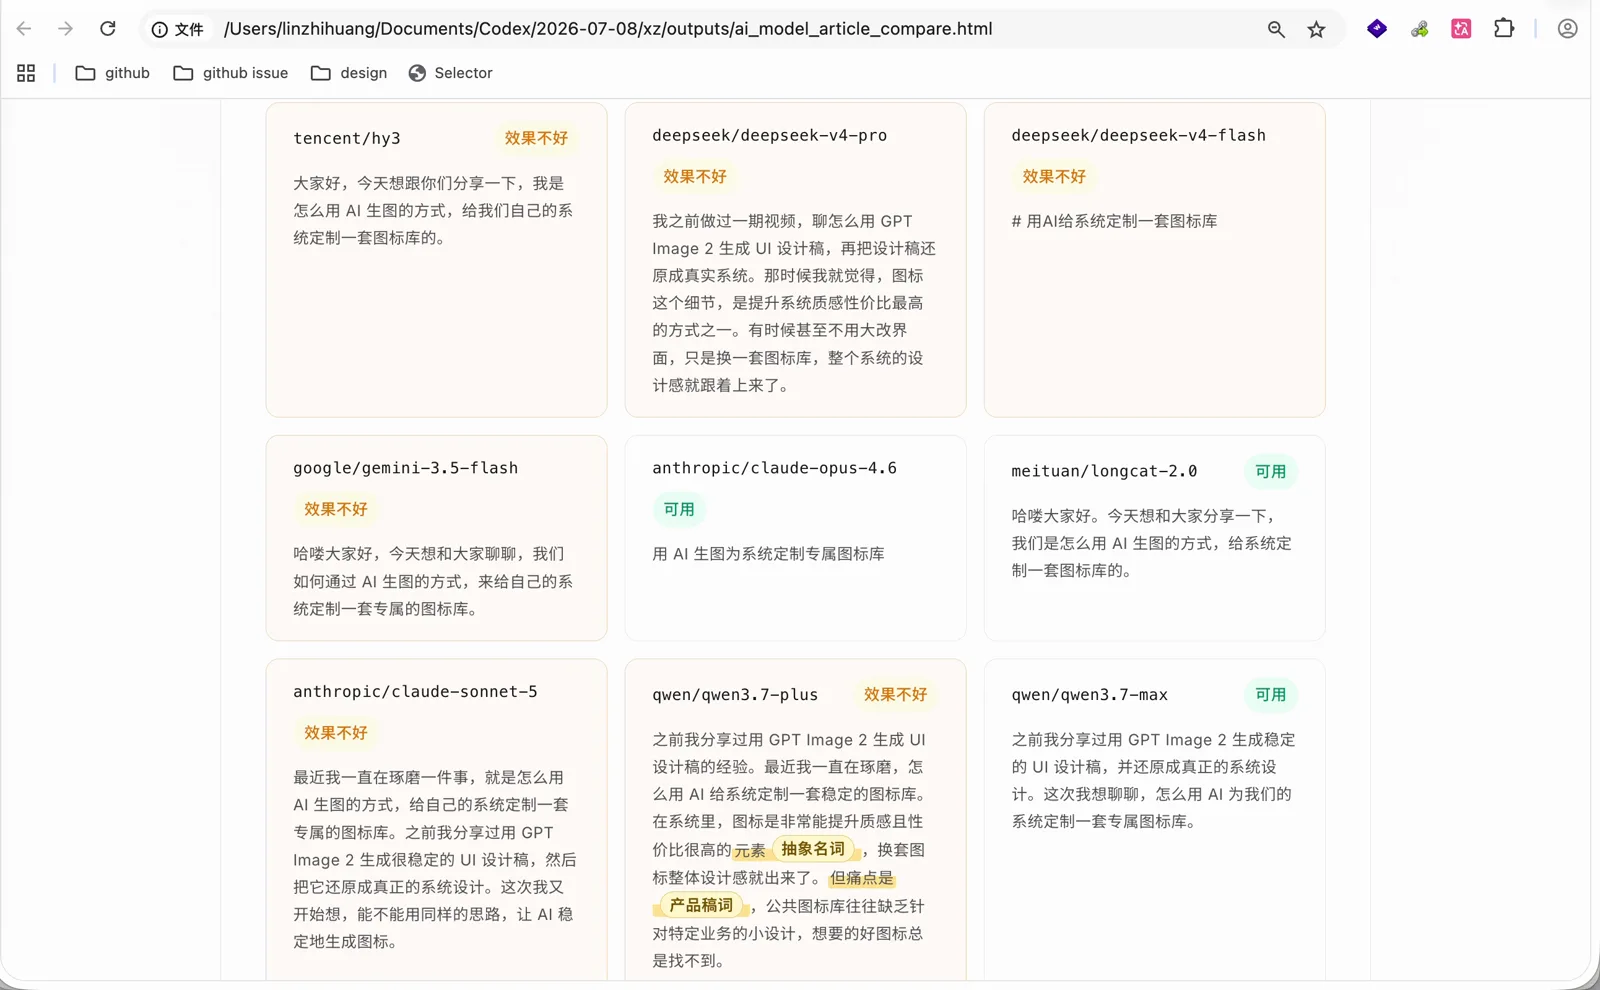
这次我留下了四个结果:Claude Opus 4.6、LongCat 2.0、千问 3.7 Max 和 Claude Sonnet 4.6。它们仍然需要人工检查,但没有频繁加入我不接受的句式和主观补写。千问以前的一些 235B 模型,文案表现也给我留下过不错的印象。
两类明显的文案问题
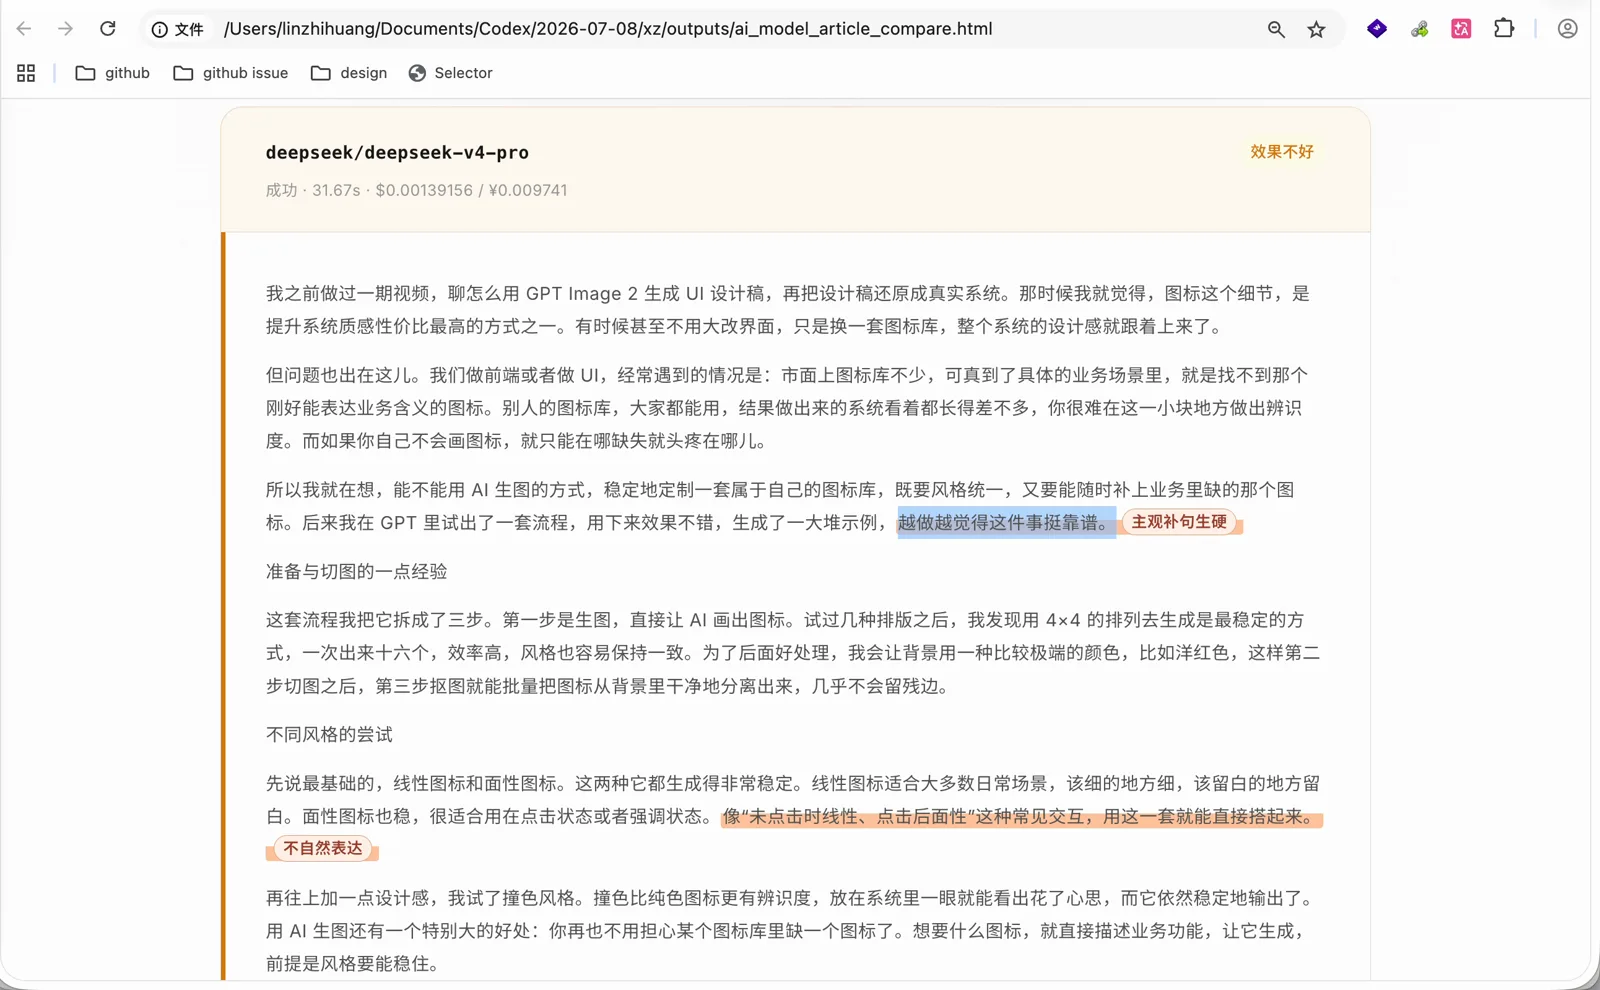
对比里有两类问题反复出现。第一类是模型自行补充感受。DeepSeek V4 Pro 生成的文章里,出现了原字幕没有表达的主观判断。
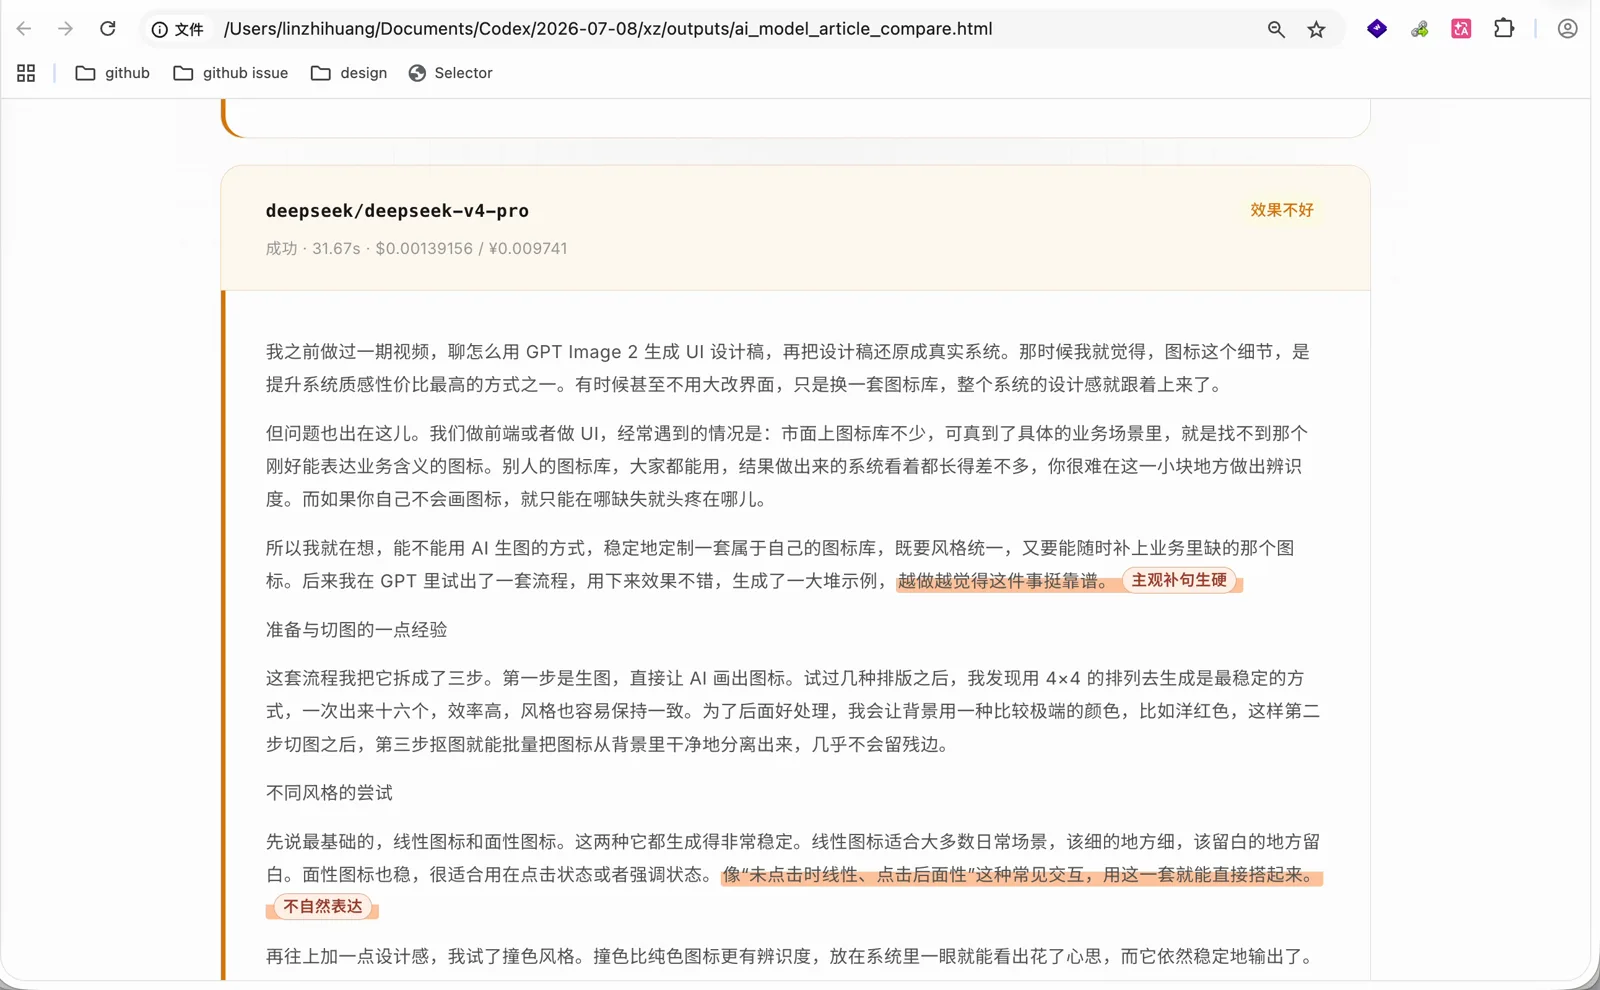
比如「用下来效果不错,生成了一大堆示例,越做越觉得这件事挺靠谱」。这句话替作者增加了感受。另一句「像未点击时线性、点击后面性这种常见交互,用这一套就能直接搭起来」语法没有明显问题,实际朗读时却很生硬。
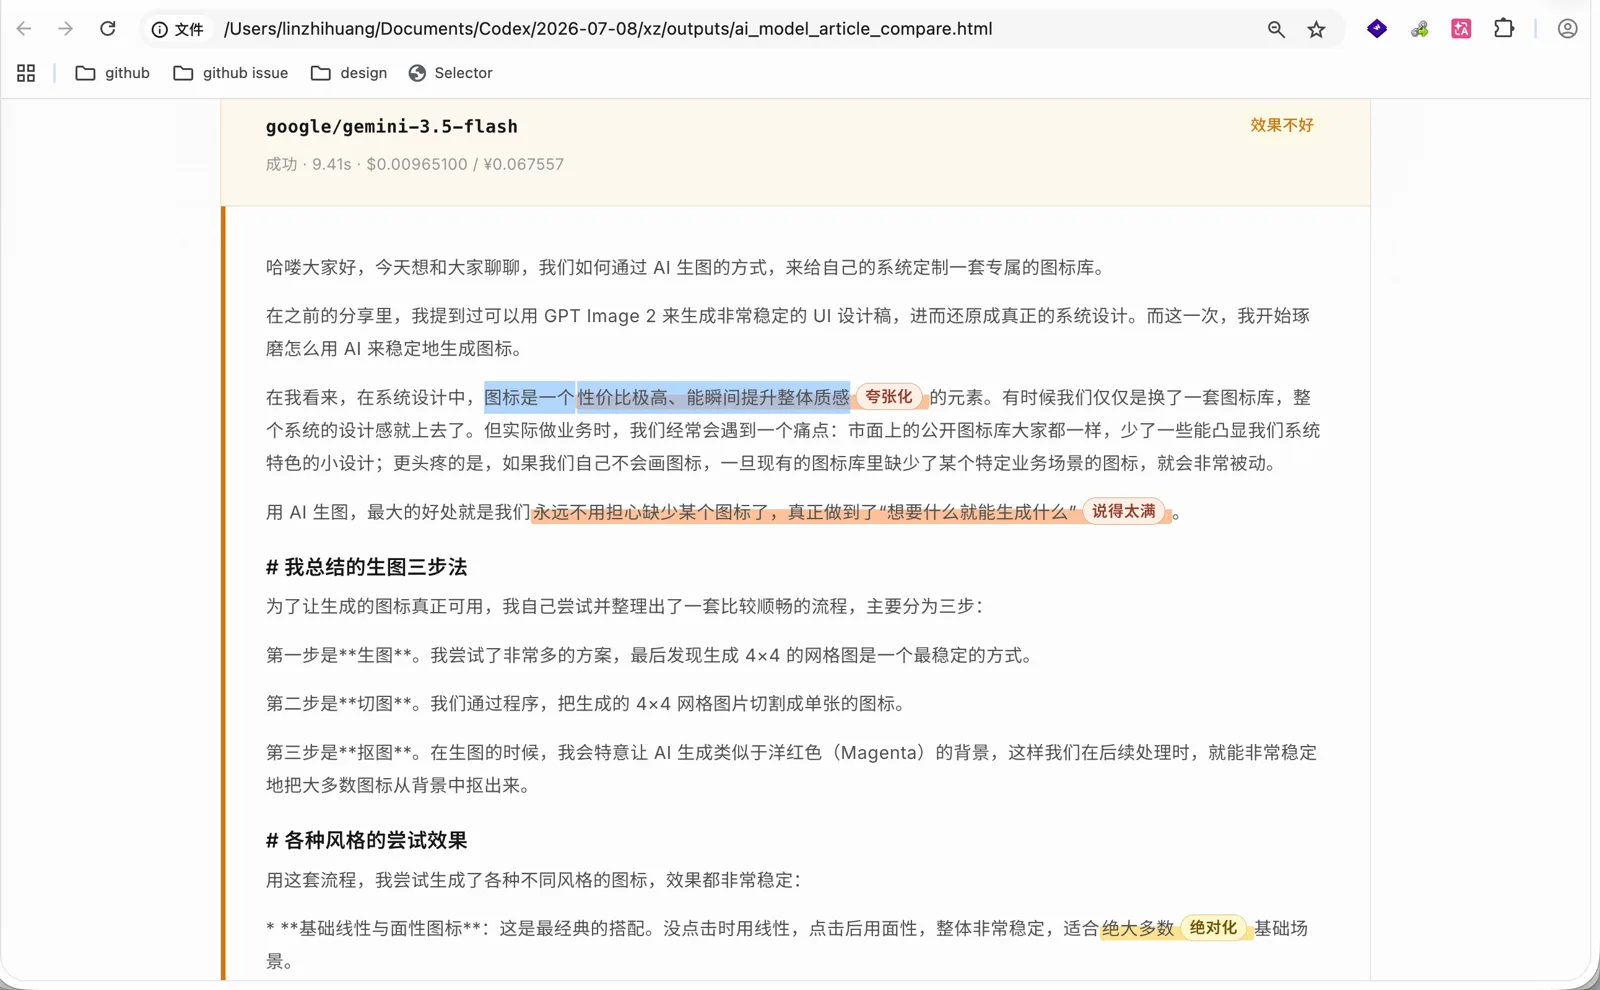
第二类是夸大普通事实。Gemini 3.5 Flash 把图标描述成「性价比极高、能瞬间提升质感的元素」,又写了「永远不担心缺某个图标了」「真正做到了想要什么就能生成什么」。这些表达比原材料提供的结论更强,也让文章显得像宣传文案。
把十个结果放在一起后,最终有四个被我标记为可用。这个总览记录的是我在同一份材料下的选择,不代表模型的通用排名。
把测试结果用到实际写作里
提示词能够约束格式和一部分固定表达,却不能完全补足模型本身的文案能力。对我的工作流来说,先选择一个更接近目标文风的模型,再用规则约束和人工检查完成成稿,比持续修正一份基础问题很多的输出更省时间。
下面依次是 Claude Opus 4.6、LongCat 2.0 和千问 3.7 Max 基于同一份字幕稿生成的文章,可以直接观察它们在段落、句式和主观补写上的差别。我最喜欢的是 Claude Opus 4.6 的结果。