平时写代码和做界面时,我最常用的模型组合是 GPT、Grok 和 Kimi。从工程开发和视觉设计的角度来看,这个搭配分工明确,效率很高。但这个组合有一个共同的短板:它们的中文表达都带着浓重的 AI 味,各自有各自的别扭。
在我的实际工作流里,文字表达的权重非常高。让 AI 编写产品设计方案时,行文必须清晰易读,逻辑不能绕圈子;让 AI 制作演示文稿或者 PPT 时,页面上的说明文字必须自然顺口,不能像机器翻译出来的说明书。此外,我自己还在维护 VibeHub 这个 Vibe Coding 术语库,里面沉淀了大量的概念解析和技术演进路线,单靠一个人很难逐字手写,很多基础文档都需要借助 AI 来协助整理。如果文本满篇都是模板化的套话,读者读起来就会非常吃力。
为了校正这种机器腔调,我之前专门编写过一个规范 Skill 叫 oil-tone,把它挂载到 Codex 里,要求模型在输出中文时保持真实、平实、完整和易读。但如果一个模型本身的表达底色就偏生硬,哪怕在系统提示词里写满规则,它生成出来的文字依然容易透出一股生硬的腔调,常常需要我手动通篇重写。
我一直在寻找中文语感更扎实、更像人自然说话的模型。Claude Opus 4.6 的文字质感确实很出色,但如果要把它接入工作流进行大批量的文件处理,API 的调用成本实在过于高昂。后来在测试不同模型的过程中,我发现 Gemini 3.7 Flash 在保持低廉价格的同时,文本生成能力和轻量 Agent 调度能力都相当稳定。虽然在复杂的长链条编程上它还比不过顶级编程模型,但在文字处理场景下,它的性价比非常突出。
GPT 5.6 Luna 与 Gemini 3.7 Flash 的文风差异
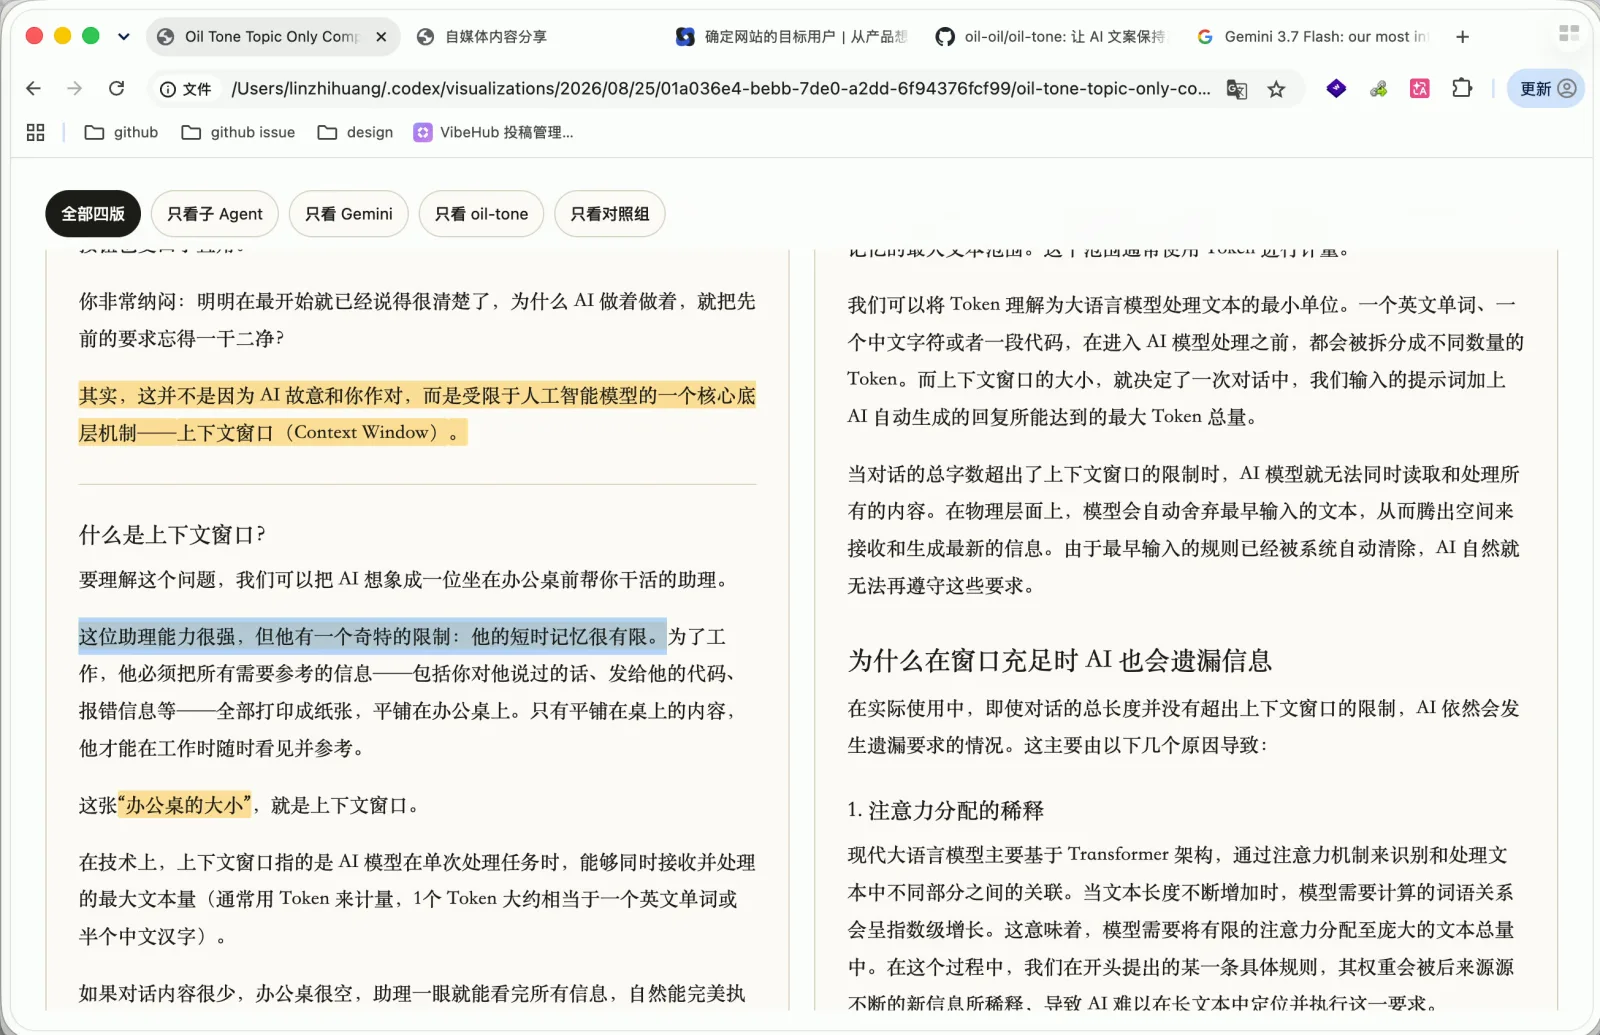
Gemini 在处理长篇文本和文档叙事时一直有它的优势。在不加任何约束的默认状态下,它主要有几个典型毛病:喜欢堆砌形容词、行文容易夸大语气、动不动就给词语加上双引号,还很喜欢使用花哨的比喻。比如它会把模型形容为「坐在办公桌前帮你干活的助理」,把上下文窗口比喻成「办公桌的大小」,或者动辄抛出「受限于人工智能的一个核心底层机制」这种大词。但把这些修辞和标点问题剥离掉之后,Gemini 句子的基本骨架是通顺的,极少出现晦涩的长难句。最关键的是,它的这些习惯很容易通过明确的规范进行纠正。
为了看清它与主流大模型的真实差距,我针对 GPT 5.6 Luna 和 Gemini 3.7 Flash 做了一组对照测试,分别对比它们在使用 oil-tone 规范前后的输出表现。选择 GPT 5.6 Luna,是因为 GPT 5.6 家族中的 Luna、Terra 和 Sol 在文本处理上的特征基本一致,文案层面都容易出现语法残缺或生硬难读的毛病。
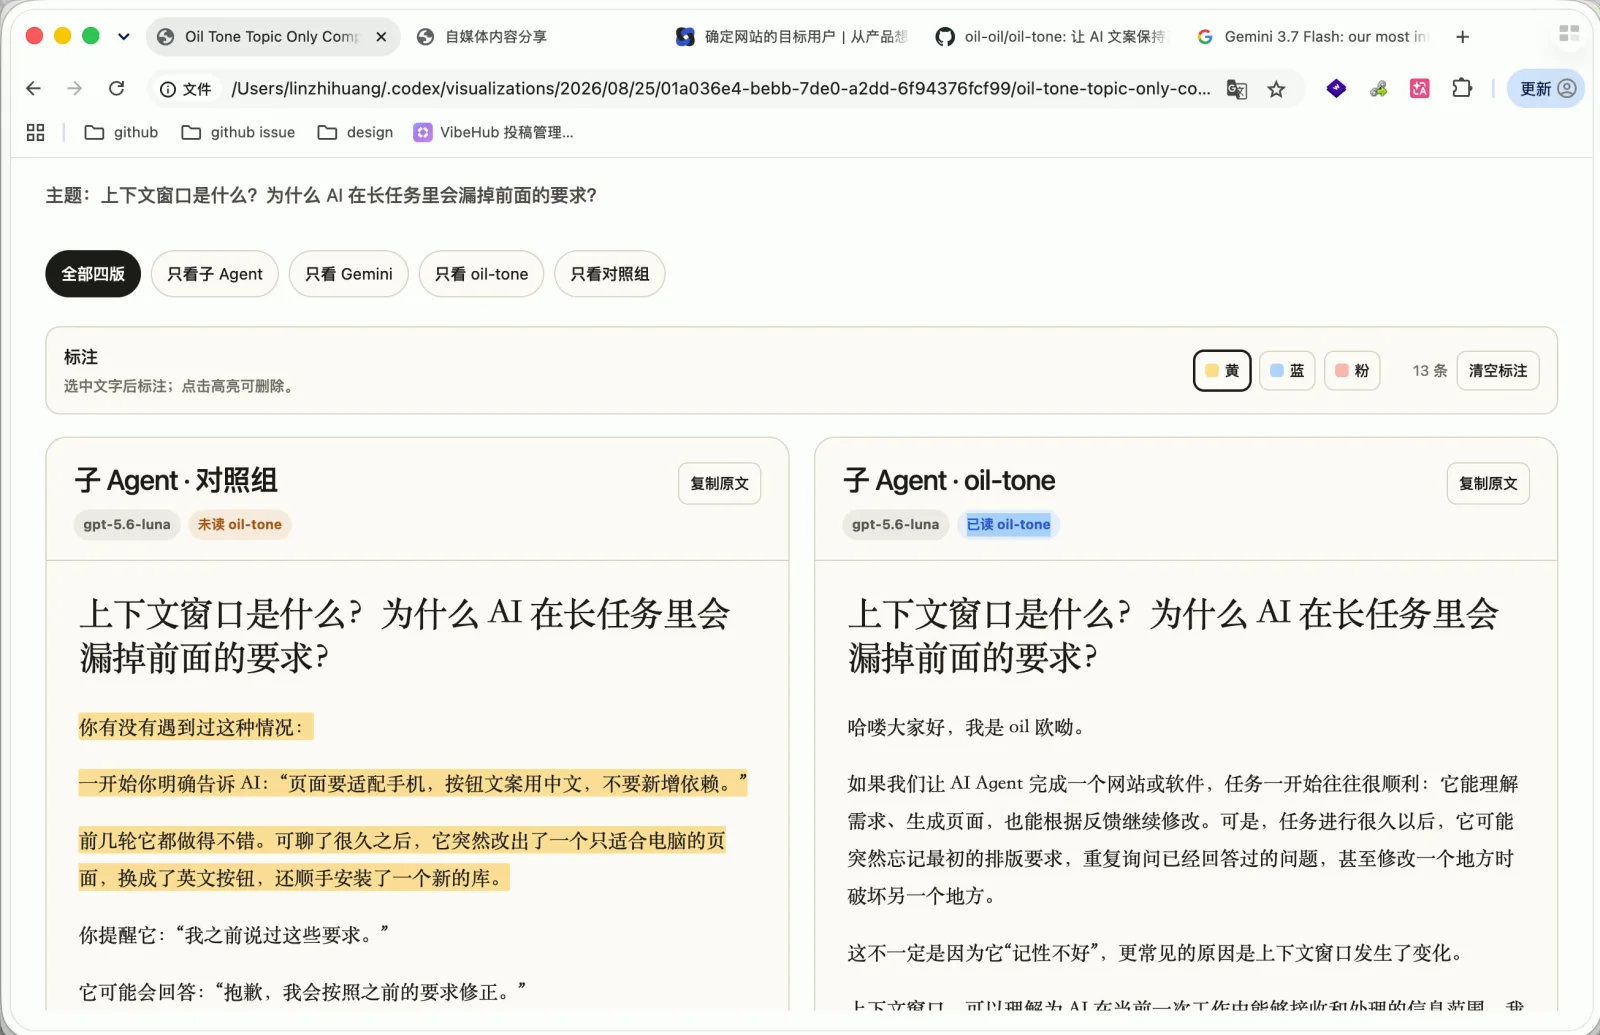
在没有提示词规范约束时,GPT 5.6 Luna 最突出的问题是喜欢自作主张编造生活情境。只要给它一个技术主题,它往往会以这种套路开头:「你有没有遇到过这种情况,一开始你明确告诉 AI 页面要适配手机,按钮文案用中文不要新增依赖……前几轮它都做得不错,可聊了很久之后它突然改出了一个只适合电脑的页面,换成了英文按钮还顺手安装了一个新的库」。这类开头缺乏真实事实支撑,完全是刻意虚构的痛点,还会夹杂像「工作台不是无限大的」这种生造词。
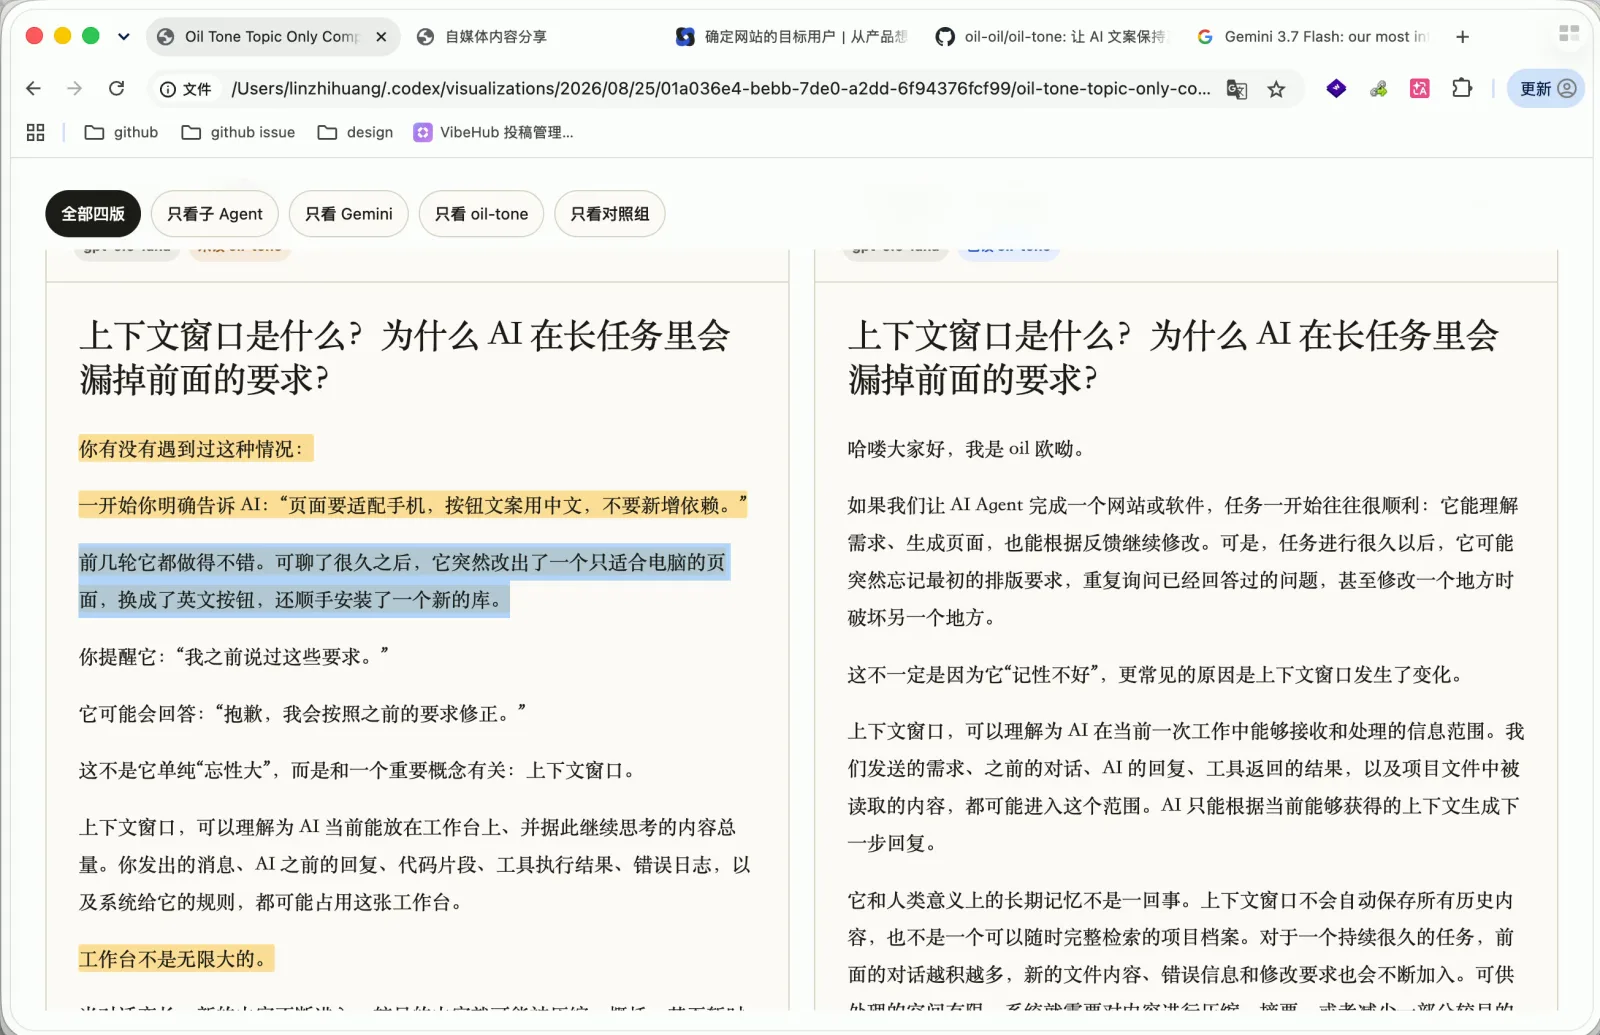
引入 oil-tone 规范之后,GPT 5.6 Luna 确实不再虚构故事,能够按照要求直接进入正题,但它立刻暴露出另一个极端:制造大量结构别扭的长难句。例如它会写出:「越早出现的要求可能已经被大量的新内容隔开,越近的错误和临时修改通常更容易成为当前回复的直接依据」,或者「这也是为什么前面明明说过了,并不能保证 AI 现在依然能够准确使用那条信息,我们需要把重要要求组织成更容易持续使用的形式」。每个单字拆开看都没错,但由于句式嵌套层级过深,整段朗读起来非常拗口。
同时,GPT 极其喜欢机械套用「这样做不是为了增加仪式感,而是帮助双方重新对齐工作状态」这种「不是……而是……」的对仗句式,并且频繁使用「埋、深、排」等含糊的单字动词。在语流连贯上,它会写成「这时可以先暂停整理一份当前状态,再从一个干净的阶段继续」;这种表达因为缺少了必要的虚词和连词,朗读时节奏发紧,远不如「这时我们可以先暂停整理一份当前的状态,然后再从一个干净的阶段继续」来得自然。
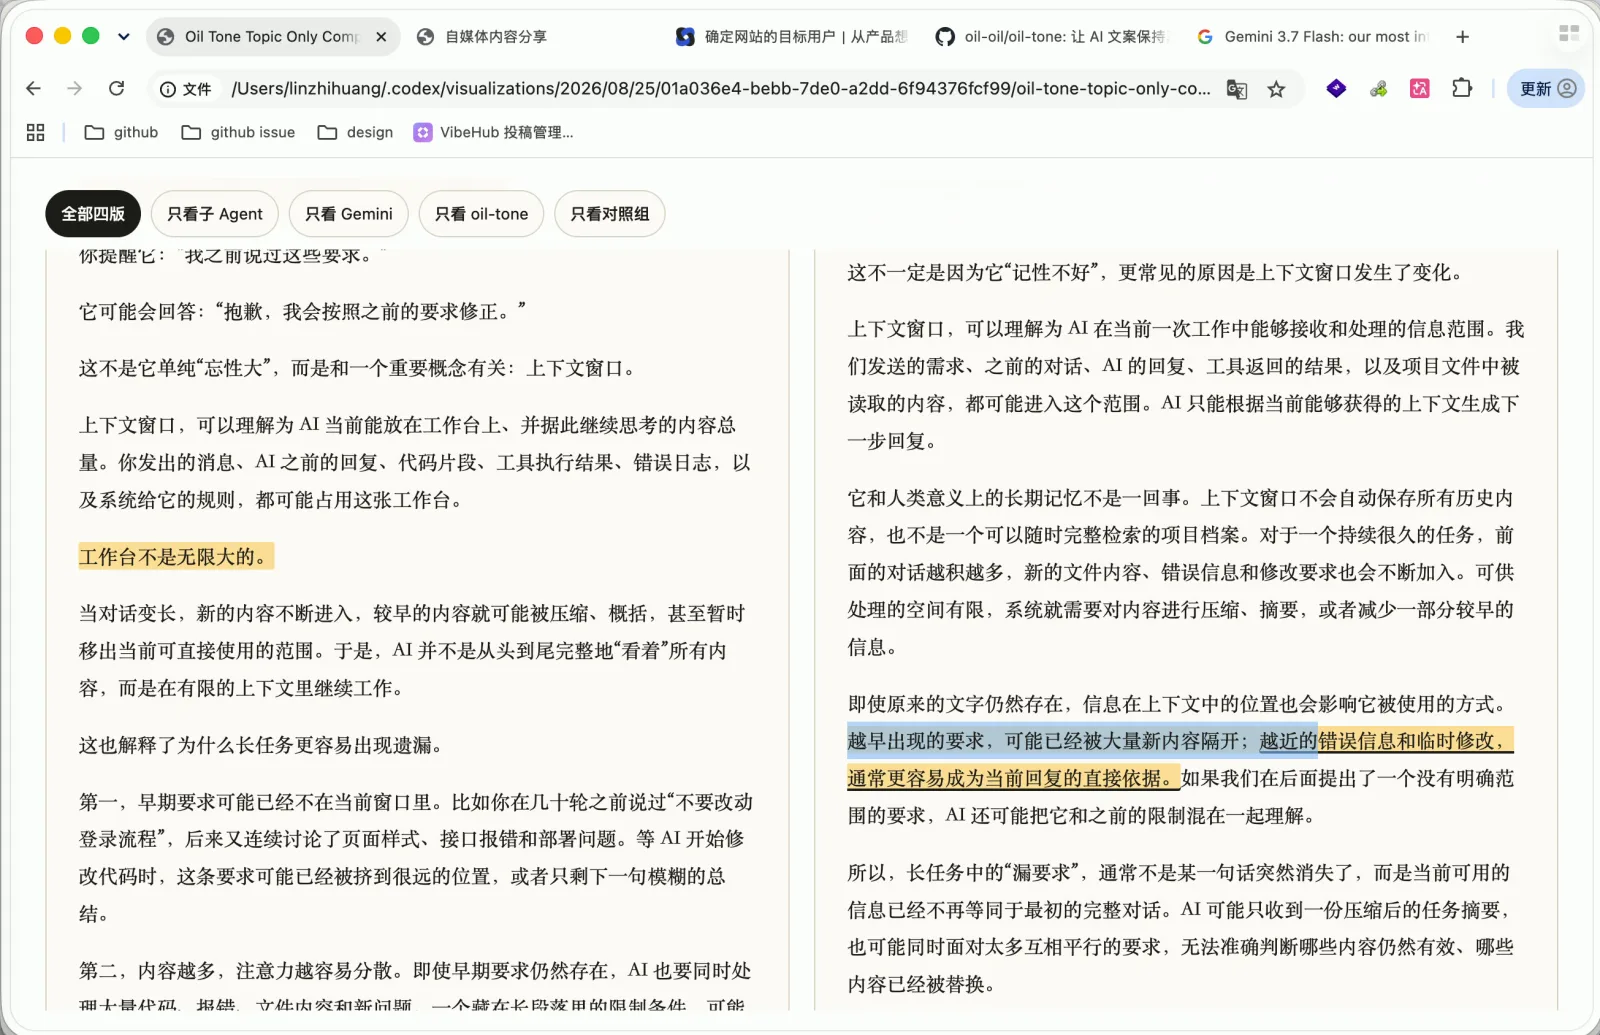
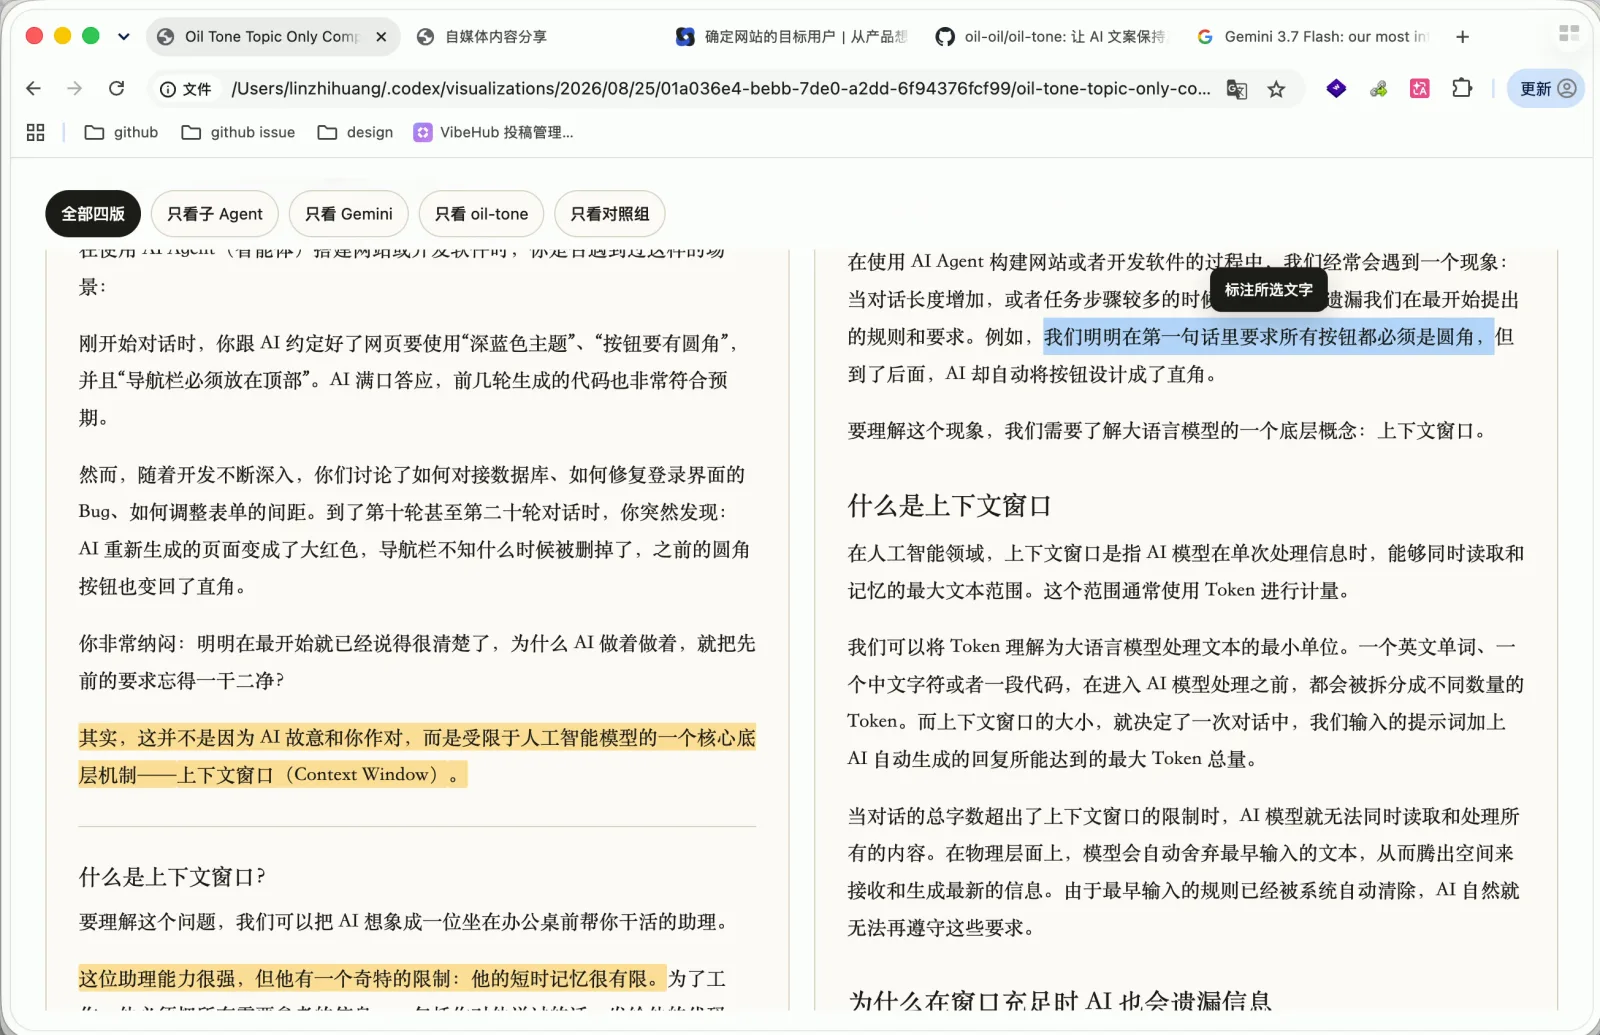
反观 Gemini 3.7 Flash,在原生裸奔状态下,它虽然同样带有 AI 腔调——充斥着不必要的双引号、过度宏大的表述以及「办公桌与短期记忆」的比喻;但一旦加载了 oil-tone 规范,它的多余修饰几乎立刻被收敛住。生成的段落不仅没有生造的长难句,逻辑展开也相当平实。
比如在解释上下文衰减导致规则遗忘时,它写道:「在使用 AI 构建网络或者开发软件的过程中,我们经常会遇到一个现象,当对话长度增加或者任务步骤较多的时候,AI 可能会遗漏我们在最开始提出的规则和要求。例如我们明明在第一句里要求所有按钮都必须是圆角,但到了后面 AI 却自动将按钮设计成了直角」。在解释相对复杂的注意力机制时,它也能够用自然的句子说明:「这意味着模型需要将有限的注意力分配至庞大的文本总量中,在这个过程中我们开头提出一条具体的规则限制,其权重会被后来源源不断的新信息所稀释」。句子完整,事实清楚,阅读负担明显更轻。
在这个过程中还能发现一个明显的特性差异:Gemini 对指令的反应更平缓,不会像 GPT 那样出现偏激的过度矫正。GPT 只要看到规范里禁止某类表达,往往会把句子压缩成极简的语法残缺句;而 Gemini 即使接收到严格的文风约束,也不会把表达逼进死胡同,输出的语气反而更接近正常人说话的分寸。
把 Gemini 接入文案修改工作流
基于这个对比结果,如果项目中需要批量重构或校对大量中文文档,把 Gemini 3.7 Flash 搭配文风约束规则作为独立的文字处理节点,是一个性价比极高的方案。
在我的日常开发环境里,我建立了一个专职调用 Gemini CLI 的 Agent 工具,后端直接指向 Gemini 3.7 Flash 模型。Gemini 的 API 计费低廉,即便进行大量长篇幅的上下文替换也不会带来成本压力。在具体协作上,负责系统架构和复杂编程的主 Agent 并不直接承担大段文案的润色,而是把需要调整的文档路径和改写要求派发给 Gemini Agent;待 Gemini 按照规范完成文字修饰后,再交回给主 Agent 运行测试并提交代码。