上个月 OpenAI 发了一篇文章叫 Harness Engineering,讲他们怎么在智能体里用好 Codex。这个概念的脉络是从提示词工程、上下文工程一路迭代过来的,Harness 是马具的意思,所以我把它称为驾驭工程:本质是如何设计一个让 Agent 能够自主、可靠工作的工程环境。
他们公布的一组数据可以说明这套方法的程度:团队五个月里没有手写任何一行代码,应用逻辑、测试、CI、文档全部由 Codex 生成,仓库累积了约 100 万行代码、大约 1500 个 PR,最初只有 3 个工程师。
网上已经有很多解析这篇文章的内容,我这篇换一个偏落地的角度:把里面讲的实践对应到我们实际的 vibe coding 过程里。示例我用 Claude Code 而不是 Codex,因为我自己用 Claude Code 比较多,原理是相通的。
用久了会遇到的问题
用 AI 编程的时间长了,比较容易遇到几个问题:
- 同一个错误的模式,AI 翻来覆去地改;
- 每次新开一个对话,AI 不记得上次约定的东西,还可能自己发明一套新规范;
- 代码库越大,AI 对整体结构的理解越差;
- 自己更多的时间花在 review 和测试上,而不是在推进功能。
文章里提到的根本原因是:我们每次都在单独给 AI 下指令,没有设计一套能让 AI 持续工作的规则体系。
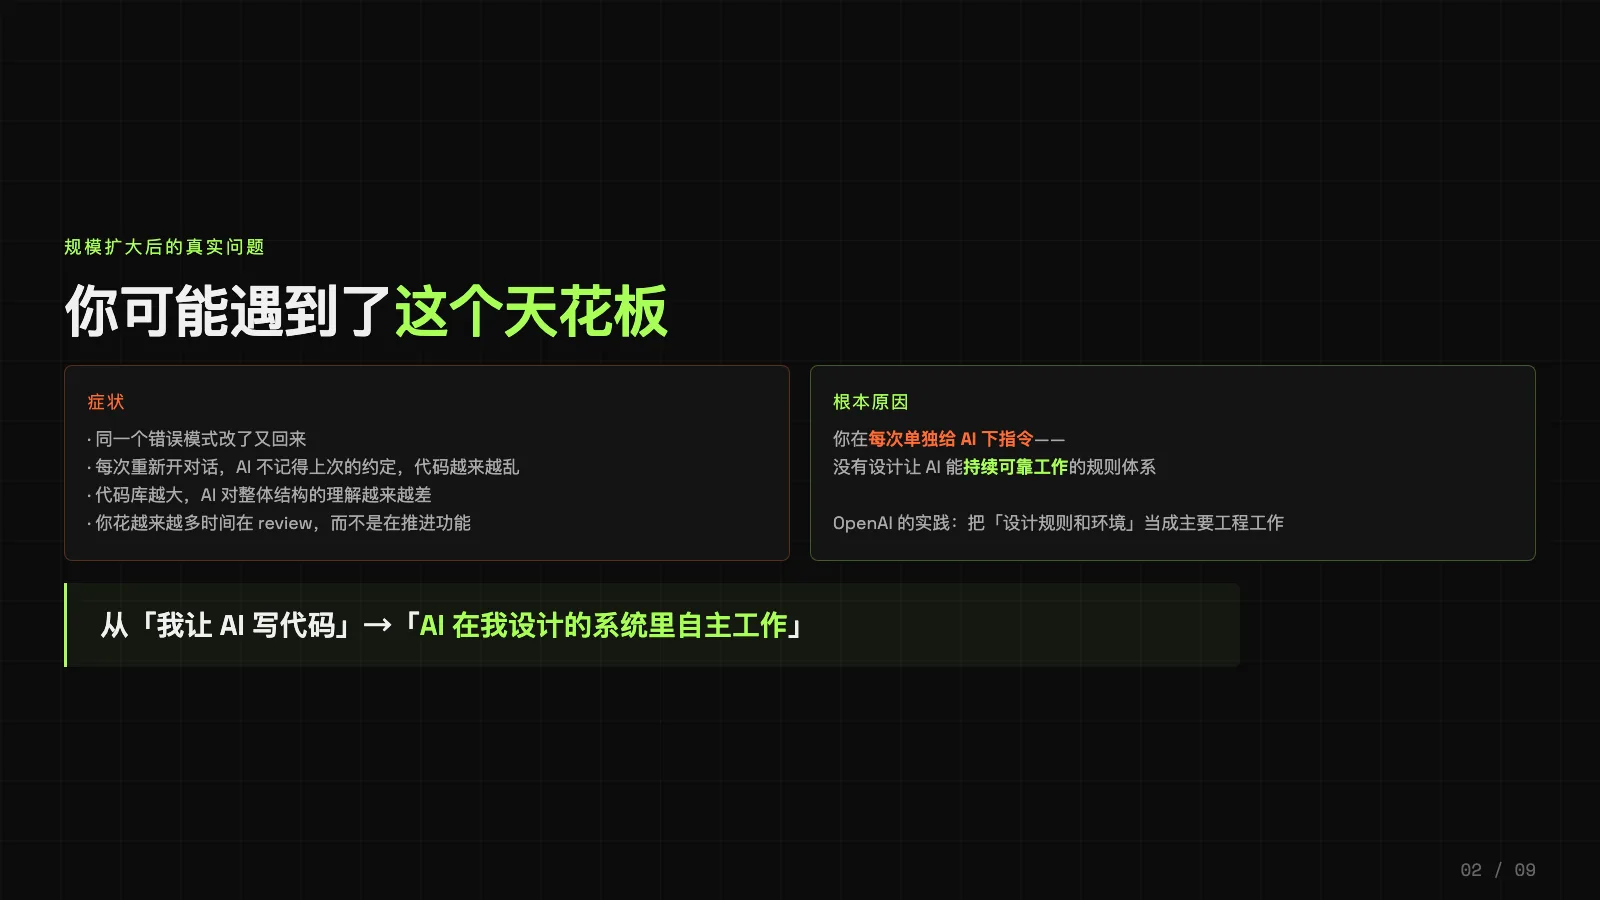
只看这一句话很难想象怎么落地,下面我拆成几个具体的点来讲。
初始化项目:先生成 CLAUDE.md
以 Claude Code 为例,在项目里执行 /init,它会创建 CLAUDE.md。生成的过程里它会读项目依赖、环境变量、前端后端的结构,然后自己整理出一份说明:启动命令、环境变量、技术栈、业务模块、文件位置、用到的接口。
这份文件的作用相当于给 AI 一张项目地图。每次新开对话,AI 读完它就知道这个项目是干什么的、基本目录在哪里,不需要再用非常宽泛的关键词去搜索。针对具体需求,它能快速定位到需要修改的范围。
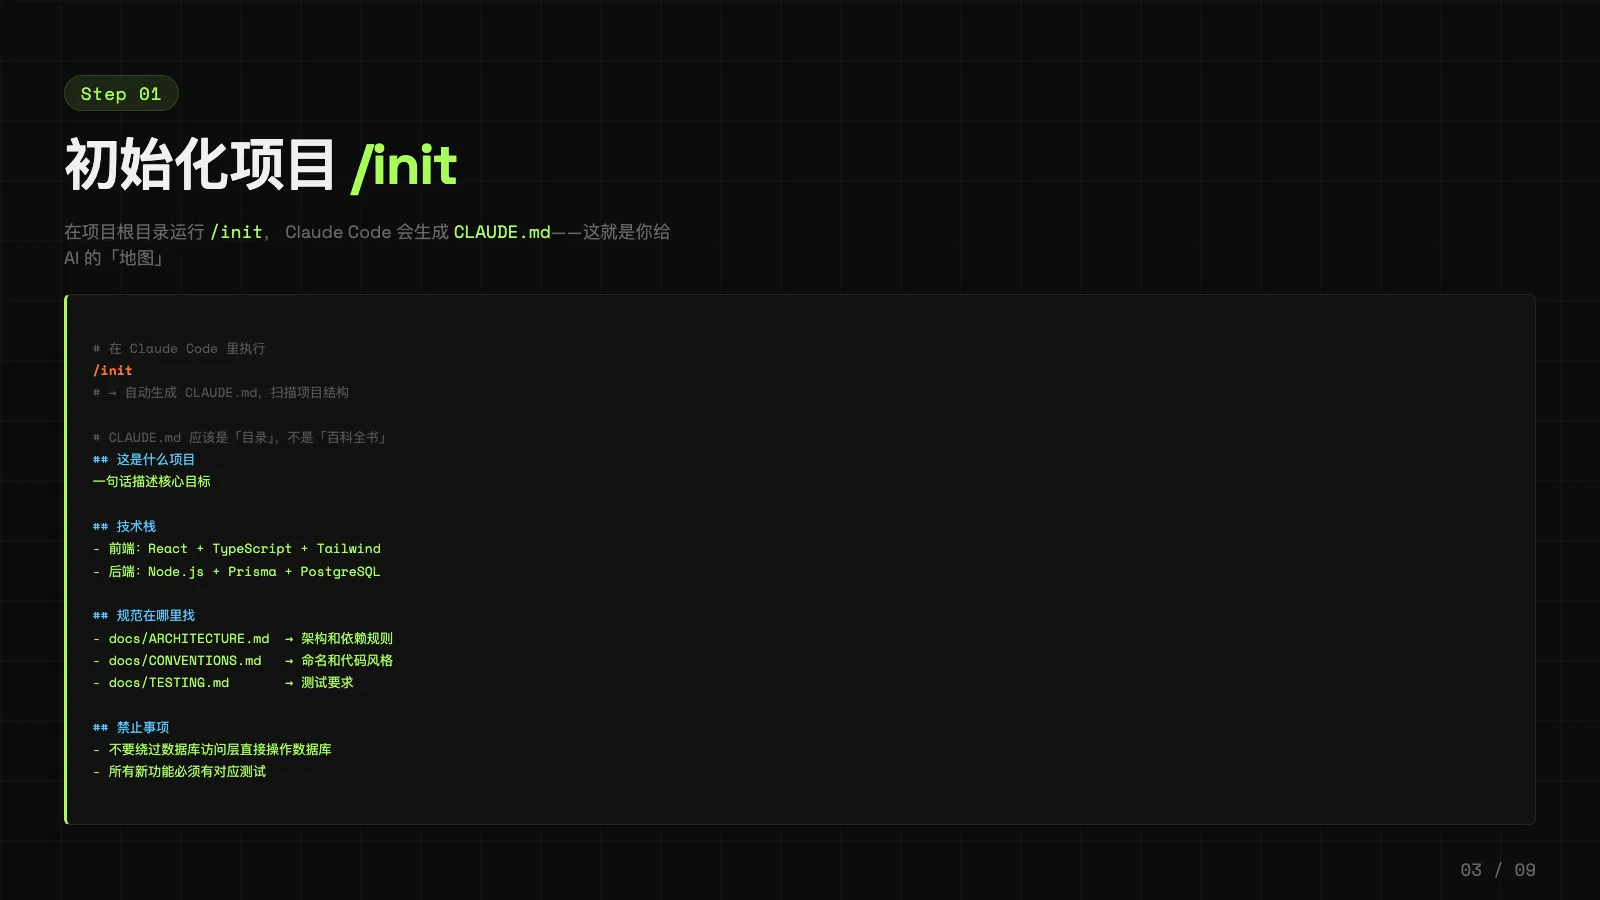
有一点需要注意:CLAUDE.md 应该是导航地图,不是百科全书。OpenAI 的仓库里这份文件只有 100 行左右,更细的内容放到 docs/ 目录里,CLAUDE.md 只负责指路。什么都往里面写,反而会挤占上下文,规则也会很快过期。
把知识塞进仓库
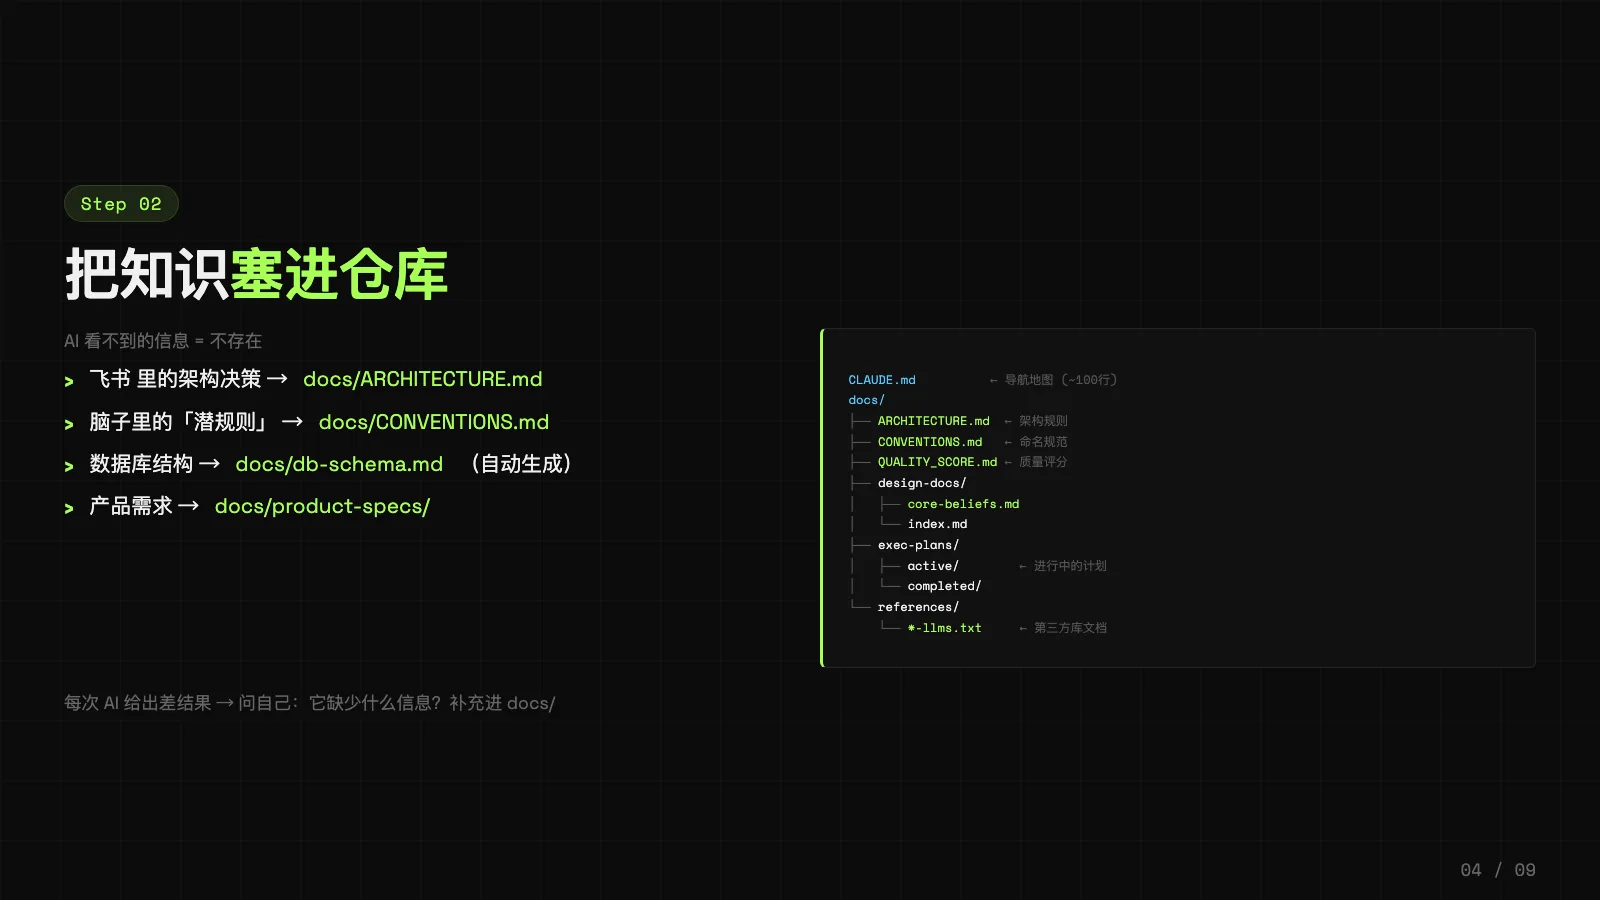
第二点是把知识塞进仓库。我们在飞书里写的架构设计、自己的一些想法、数据库结构、产品需求,AI 默认是拿不到的。AI 看不到的信息,对它来说就等于不存在。
如果每次设计新功能都把整个 PRD 贴进对话,那新开的对话并不知道之前参考的是哪份文档。把文档以文件的形式存进仓库,比如建一个 docs/ 目录,把以前的架构决策、产品需求都放进去,它们就永久成为上下文的一部分,原理和各类 AI 记忆功能差不多。
数据库结构我有一个更推荐的做法:不要把表结构手动导出到文档里,而是让 AI 能直接读到数据库的只读结构。比如用 Supabase 的 CLI,或者接一个 Supabase 的 MCP,它可以实时查到库里具体的表结构和字段类型。这样做实时性最强,也不需要维护文档。AI 要改数据表的时候,有原始结构大概率能改对,它写 SQL 的能力很强;要写后端和数据库的交互时,也可以自己去查模型设计和字段类型。
用工具强制执行规则
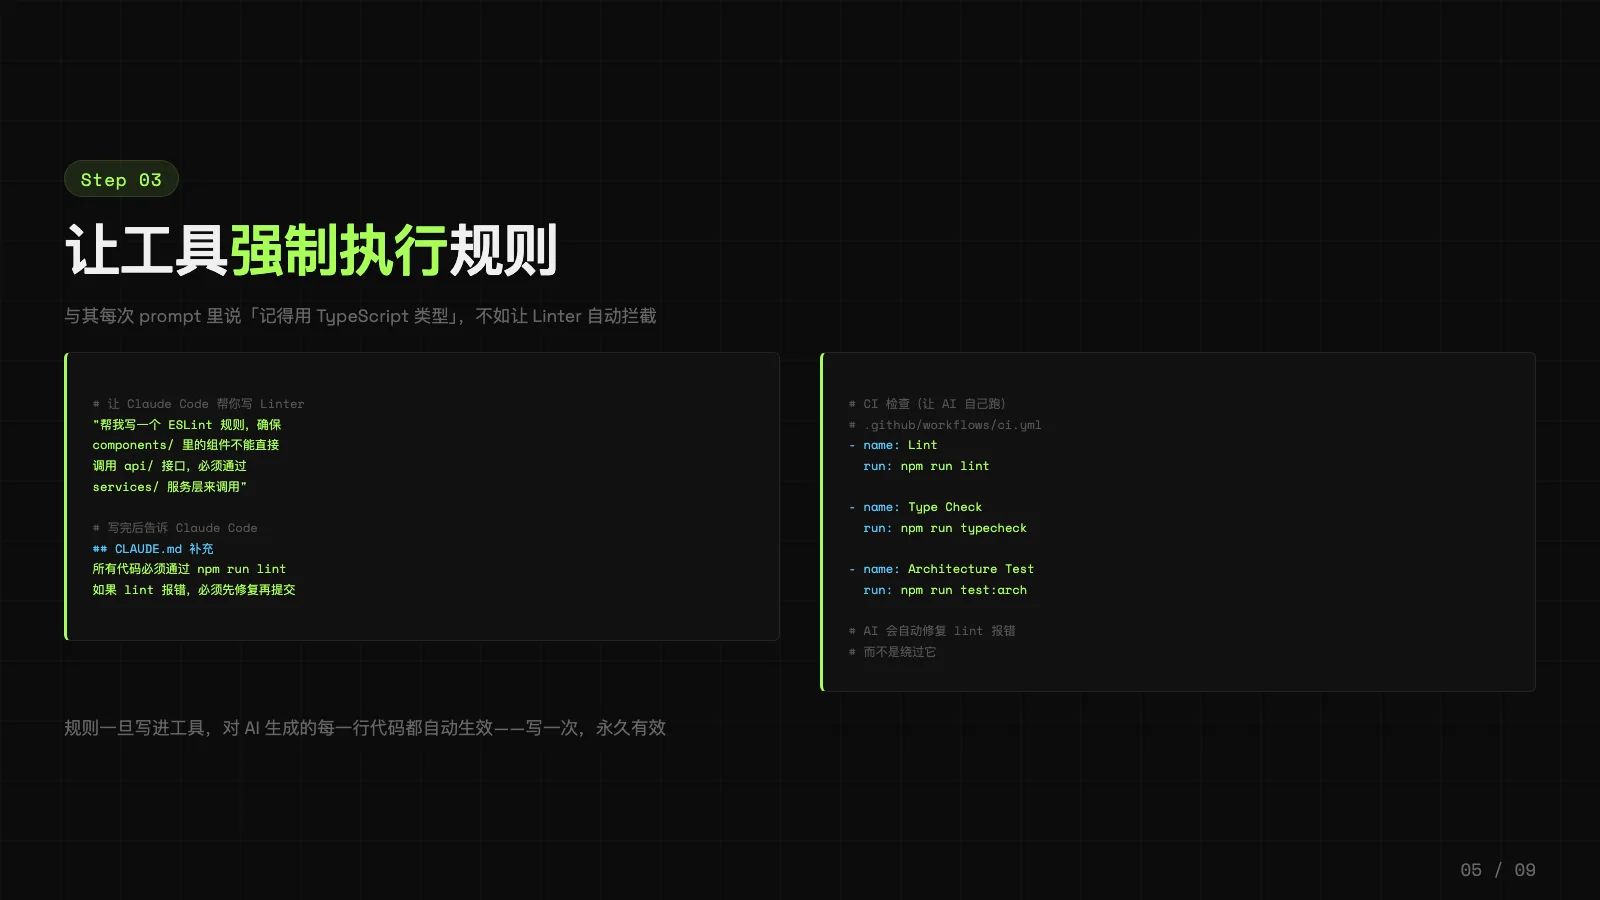
以前我们可能会在提示词里告诉 AI:写完代码要跑 ESLint、要做类型检查。但 AI Agent 是自己规划行动的,上下文短的时候它还记得,上下文一长,这类提示词就被埋没了。
Claude Code 里有 Hook 的概念,可以用程序的方式介入它的行动,而不是靠提示词。比如配置一个 PostToolUse 的 Hook,让它每次执行完修改文件的工具之后,必须跑类型检查和规范检查。配置写在项目的 .claude/settings.json 里:
{
  "hooks": {
    "PostToolUse": [
      {
        "matcher": "Edit|Write",
        "hooks": [
          {
            "type": "command",
            "command": "npm run typecheck && npm run lint"
          }
        ]
      }
    ]
  }
}
Hook 检查失败时,报错信息会直接喂回给 AI,它会自己去修复;没问题就不用修,AI 也不需要自己规划检查这一步。这样既减少了提示词占用的上下文,又把检查变成了程序保证的事情。
现在 Claude Code 大部分时候会主动跑类型检查,但这些规范是为了抹平差距的:不同模型之间、不同上下文长度、不同项目之间,行为不再依赖于模型当时记不记得。
让 AI 能看见运行中的应用
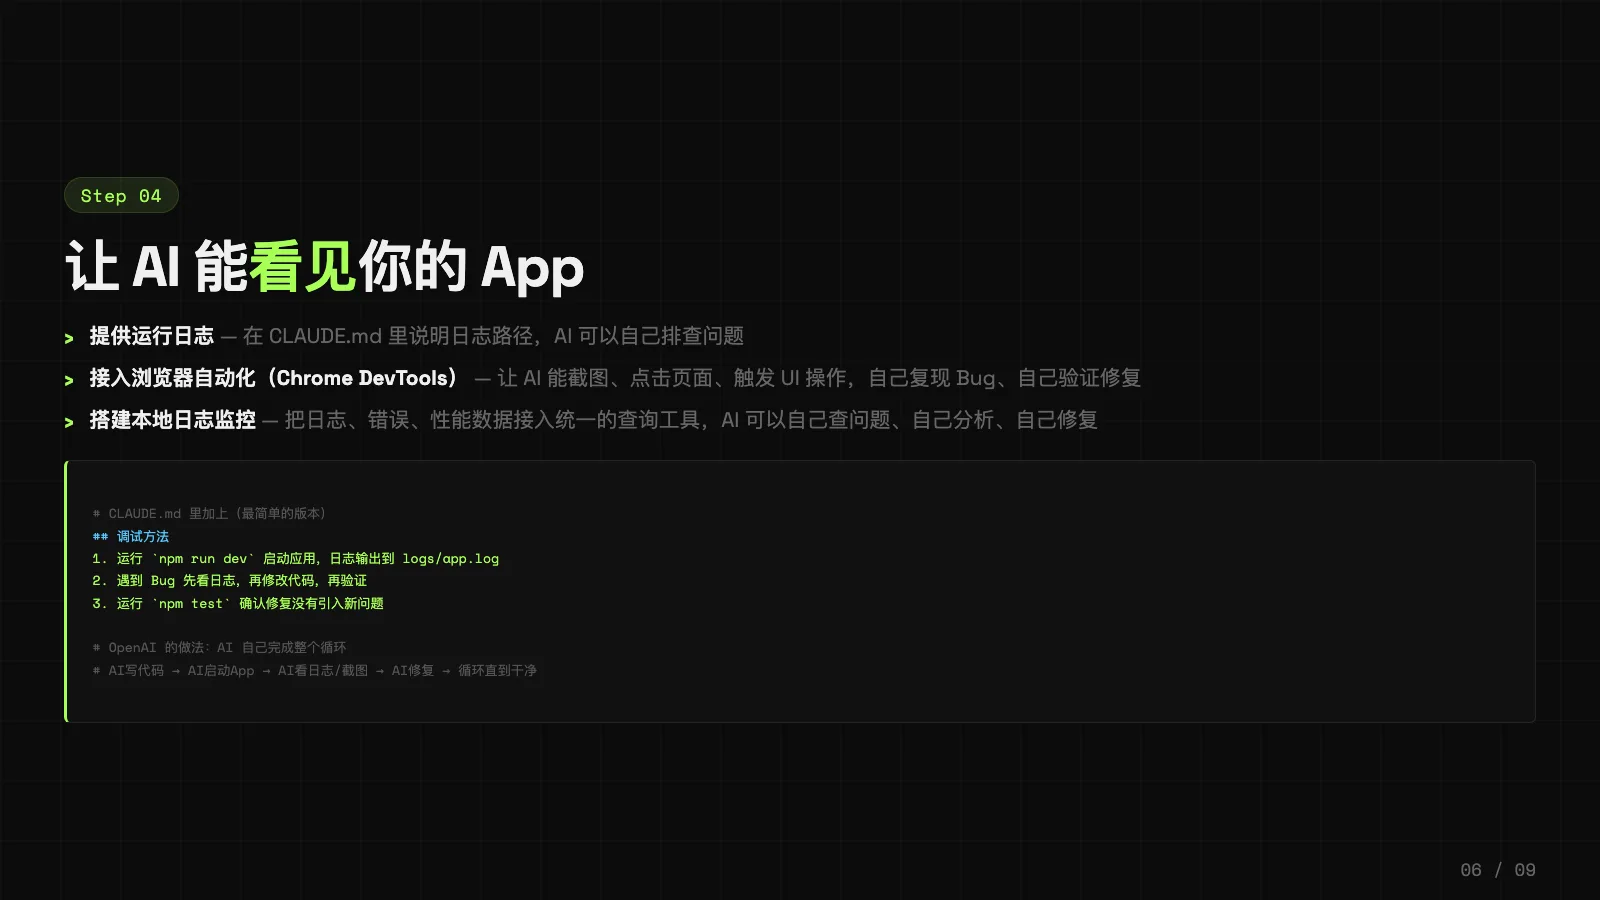
下一点是我很有共鸣的。原文提到他们给 Agent 提供运行日志,并接入了 Chrome DevTools 的 MCP。
我们平时和 AI 配合修 bug,流程是这样的:告诉它问题在哪,它修一版,我们人工去页面上测试;没修好,它问页面表现是什么样,或者插一些日志,然后我们复制日志贴回去,它再修一版。整个循环里,测试和搬运日志都是人在做。
要让 AI 自己长时间稳定运行,就要让它自己具备调试和测试的能力。Chrome DevTools MCP 可以让 AI 自己读控制台日志,接入命令是:
claude mcp add chrome-devtools --scope user npx chrome-devtools-mcp@latest
但光能读日志还不够,AI 没办法自己在页面上点击操作。我自己会用一个叫 Agent Browser 的工具,它可以让 AI Agent 自己在浏览器上操作页面。
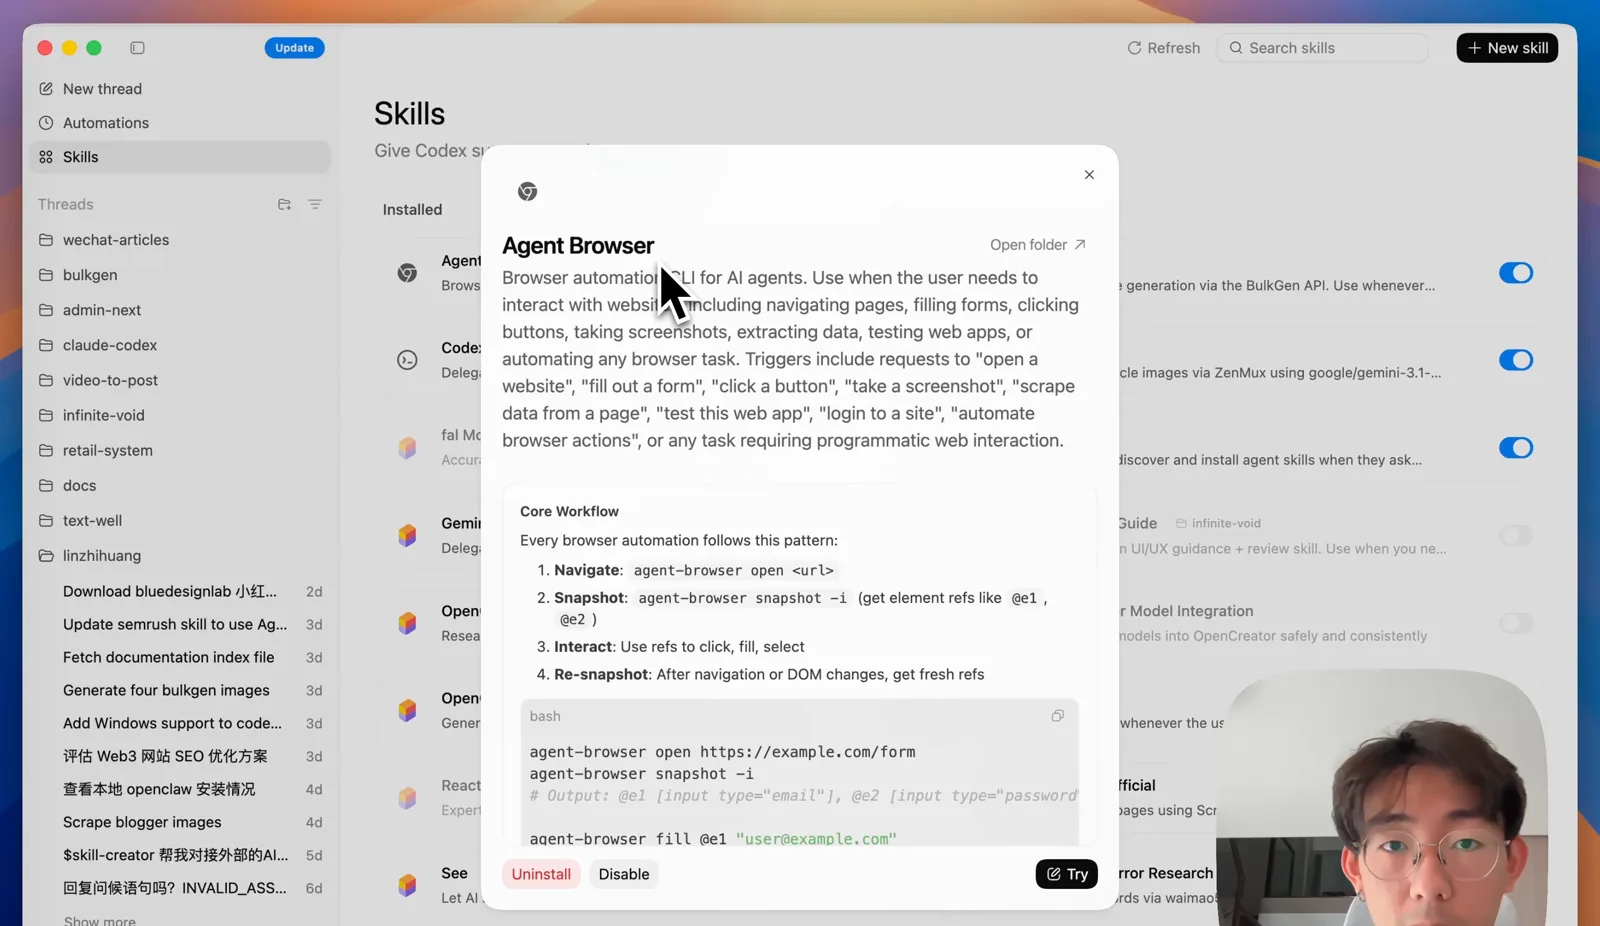
我现在的用法是:AI 写完一个功能,测试案例也是它自己写的,我让它用 Agent Browser 自己去执行这些案例。页面上点击通过了,任务才算完成;不通过就先查代码,查不到就自己插日志,再通过 Chrome DevTools 读控制台拿到日志,分析完继续修,修完再自己跑一遍浏览器验证。整个循环它自己往复,修到完全好才算完。
还有一个之前的实践。我们做过一个狼人杀游戏,Claude 很聪明,能分析游戏对话的上下文有没有问题,但每次都要人把对局历史贴给它,很麻烦。后来我们让 AI 自己在这个游戏里玩:游戏有自动对局模式,不需要人操作就能跑完一整局,过程中打印的日志全部写进文件。Claude 自己开一局游戏,跑完看日志,如果发现某个玩家发言明显有问题,再去代码里查原因。这也是一种让它自己驱动自己的方式。
定期垃圾回收
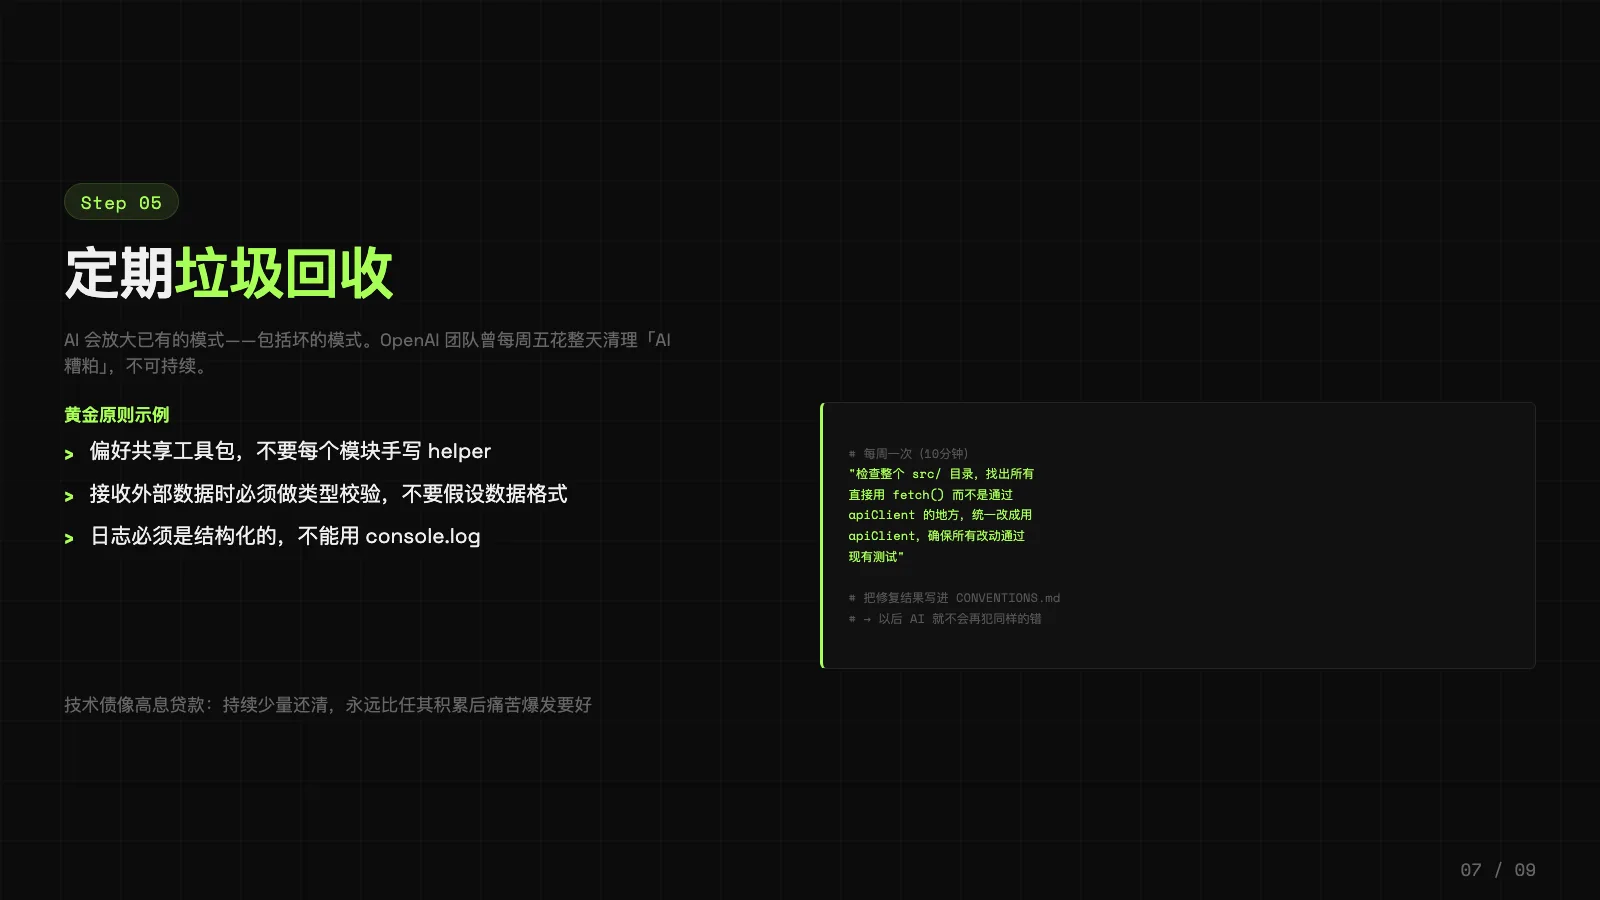
AI 会放大仓库里已有的模式,包括坏的模式,很多时候它自己发现不了。OpenAI 团队的做法是每周五花一整天时间清理 AI 写的垃圾代码,同时把经常出问题的地方写进提示词或者规范文件里,让人介入纠正 AI 常犯的错。
我自己有一个更省事的方法:让 Claude 扫描自己以前所有的对话历史和执行记录,找出之前经常出问题的地方。它自己是可以发现的,发现之后再让它写一份规范文档,或者写进全局的 rules。之后它再有这个上下文,大概率不会再犯。这个过程不需要人去阅读以前的所有对话,也不需要花很多时间统计项目里哪些地方是垃圾。
如果你在使用中已经感觉到 AI 老是在某个地方做不好,也可以直接把这个点整理成一条规则,尽早让它去清理存量、纠正范式。
输出不满意时,先问它缺什么信息
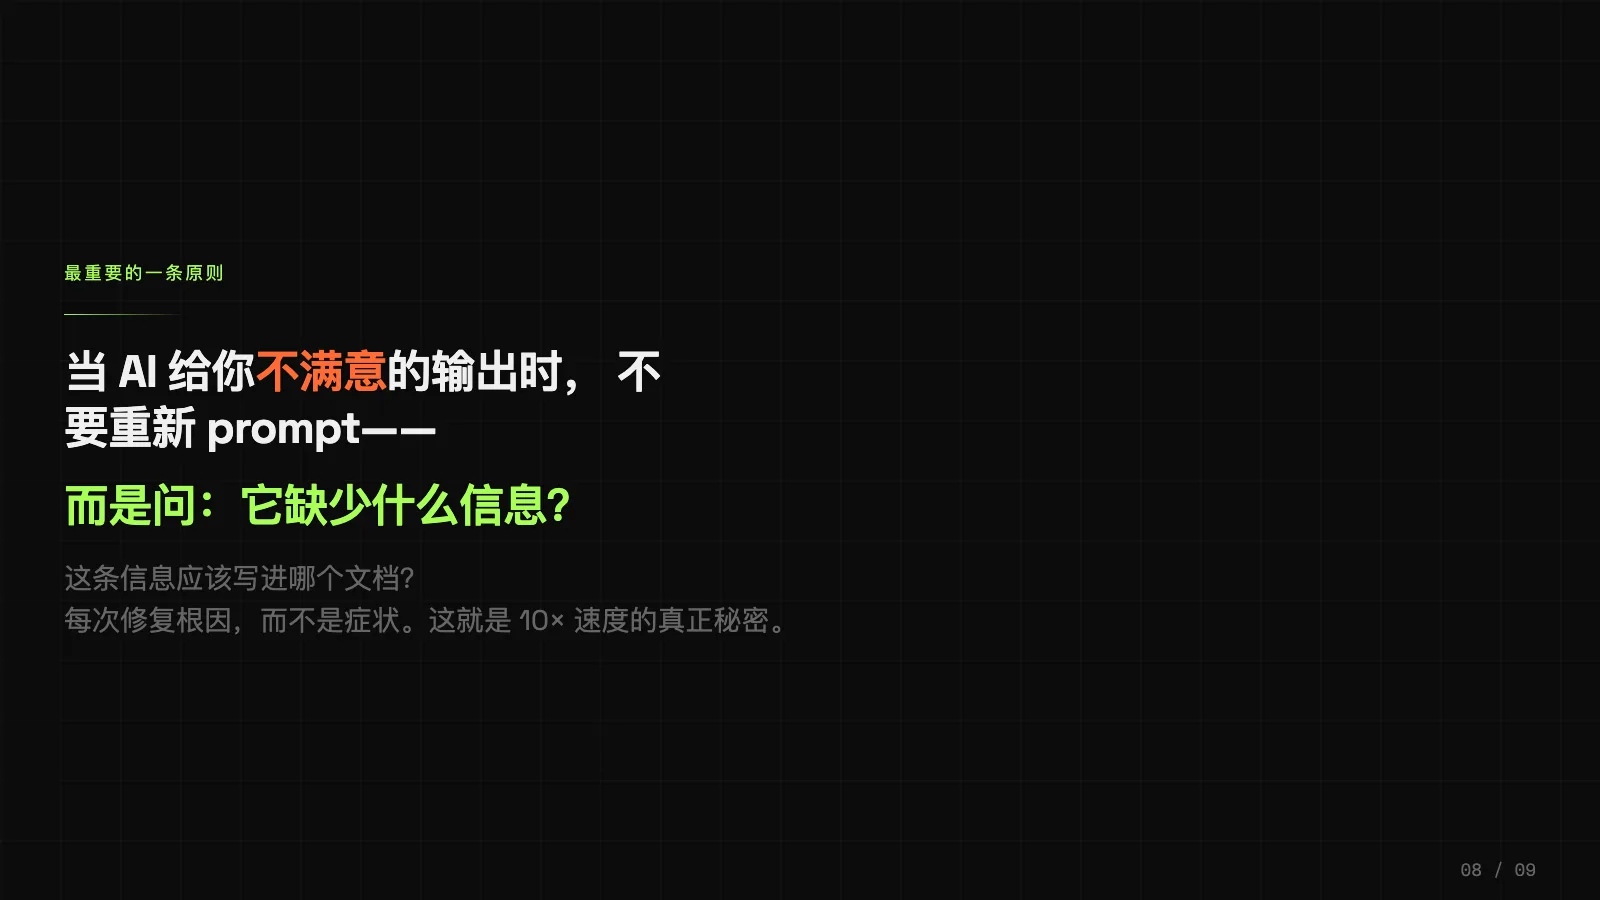
还有一个原则:AI 给出不满意的输出时,不要重新输入一遍需求,而是问它缺少哪些信息。
有了上下文工程的意识之后,很多人已经在这样做了,现在的模型也比较主动,会反过来问我们页面上是什么表现。但上下文很长、它开始钻牛角尖的时候,还是应该主动问它:你少了什么信息?另外上下文太长本身也会让模型变差,杂乱的信息会干扰它对具体问题的判断,这种情况需要主动压缩上下文。
行动清单
最后是可以直接执行的清单:
- 让 Claude Code 执行
/init,把 CLAUDE.md 写出来,保持它是一份精简的导航地图; - 把团队里的决策文档丢进 docs/ 目录,AI 自己写的文档也存档进去;
- 配 Claude Code Hook,让 AI 每次改完文件自动跑类型检查和规范检查,加上简单的 CI 冒烟测试——AI 业务迭代很快,维护稳定的端到端测试很难,更可落地的方式是用 Agent Browser 让 AI 每次实现功能后自己测一遍,能省掉大量人工测试的时间;
- 每周执行一次清理,让 AI 扫冗余代码、多余依赖、重复实现——同一组件该封装的封装,多处重复的函数抽成通用函数,再让它扫一遍自己以前的决策记录,把常犯的问题强调进全局规则。
还有一个原文提到的做法是把长周期的执行计划都存档在仓库里。我自己用得比较少:单个需求用 plan 模式迭代完之后,那份文档的必要性就不大了,我还没有遇到过需要 AI 自己连续迭代好几个月的需求。
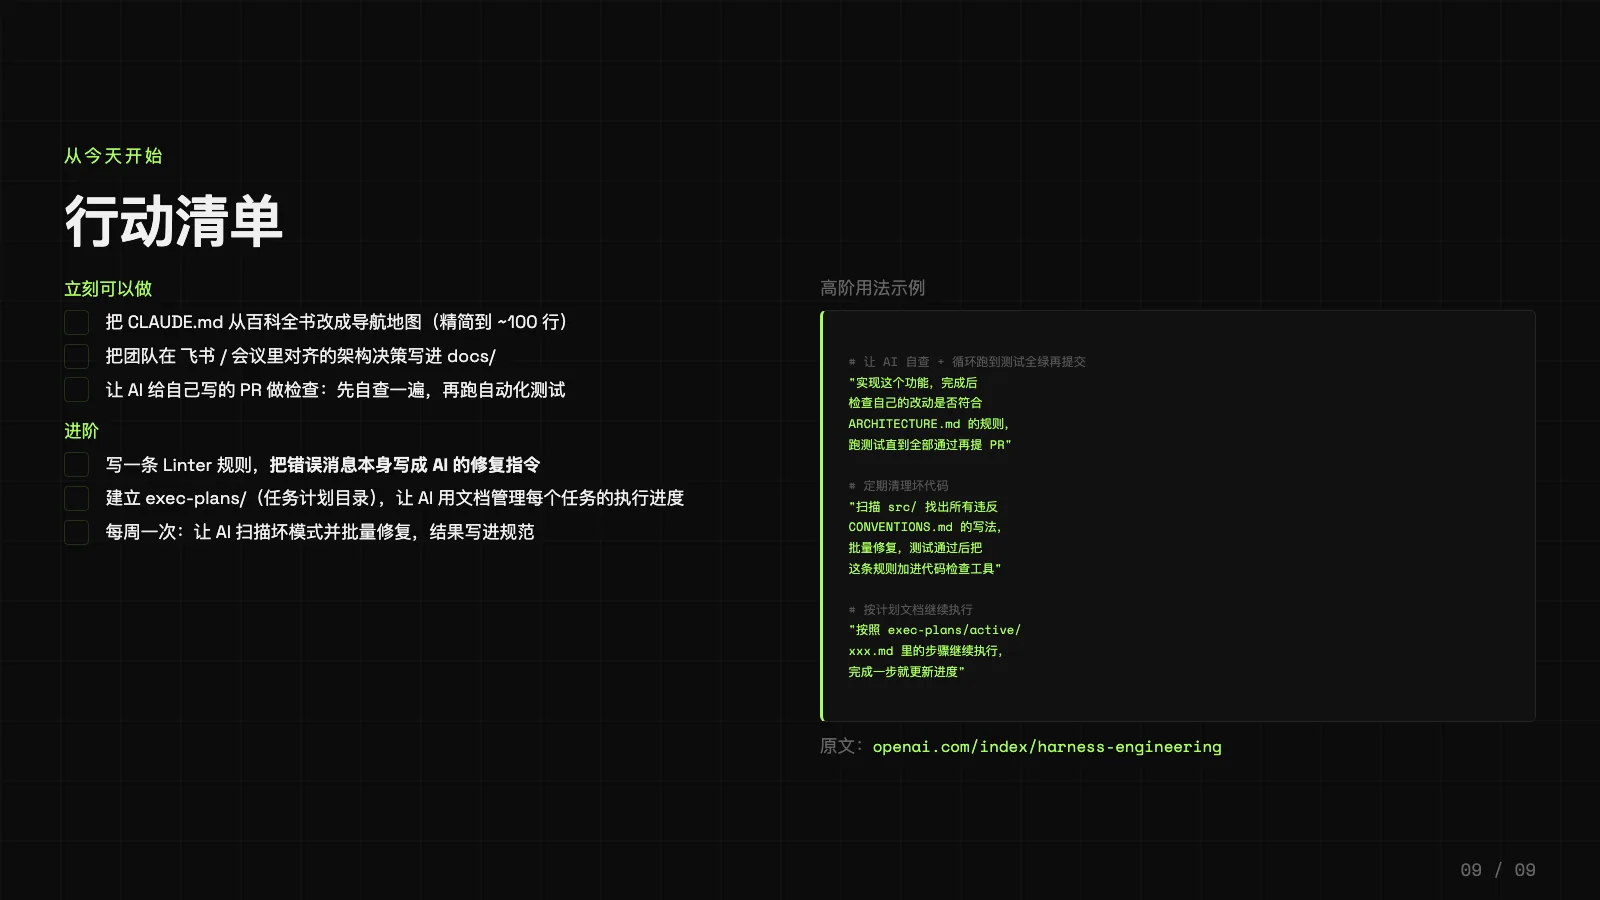
这些行动都是围绕同一件事:把规则、知识和检查能力放进工程环境,AI Agent 自驱工作的能力才会稳定。原文在 openai.com/index/harness-engineering,建议直接读一遍。