Grok 最近的生图表现引起了不少关注,我也给自己的工作流订阅了 Grok 的套餐。在它的订阅权益里,包含了生图模型的调用额度。因为我平时经常用生图模型来制作 PPT、画技术图解和排版视频封面,加上 Grok Image 2 的价格只有 GPT Image 2 的五分之一到七分之一,这笔账算下来非常诱人:如果它能在关键场景打平,很多日常生图的成本就能大幅降低。
为了确认它能不能真正替掉我现有的工作流,我用同一套提示词和参考图,把 Grok Image 2 和 GPT Image 2 拉出来做了 9 个典型场景的横向对比。
日常中文封面:排版与文字精度依然翻车
封面是我平时使用最频繁的场景。这组测试里,两边使用了完全一致的提示词,要求生成一张适合小红书比例的排版封面。
实际生成出来,Grok 出现了明显的中文乱码问题。即使提示词里明确给出了具体的文字内容,它依然把字符拼成了无法辨认的笔画。除了文字识别与渲染不准确,Grok 对复合提示词的遵循度也较弱。例如提示词要求海报画面只露出一部分设备屏幕以形成构图留白,GPT 准确地做出了这种截断排版,而 Grok 依然把整个屏幕机械地塞在画面中间。另外测试中提供的 Claude 风格参考图,Grok 也没有吸收进去。
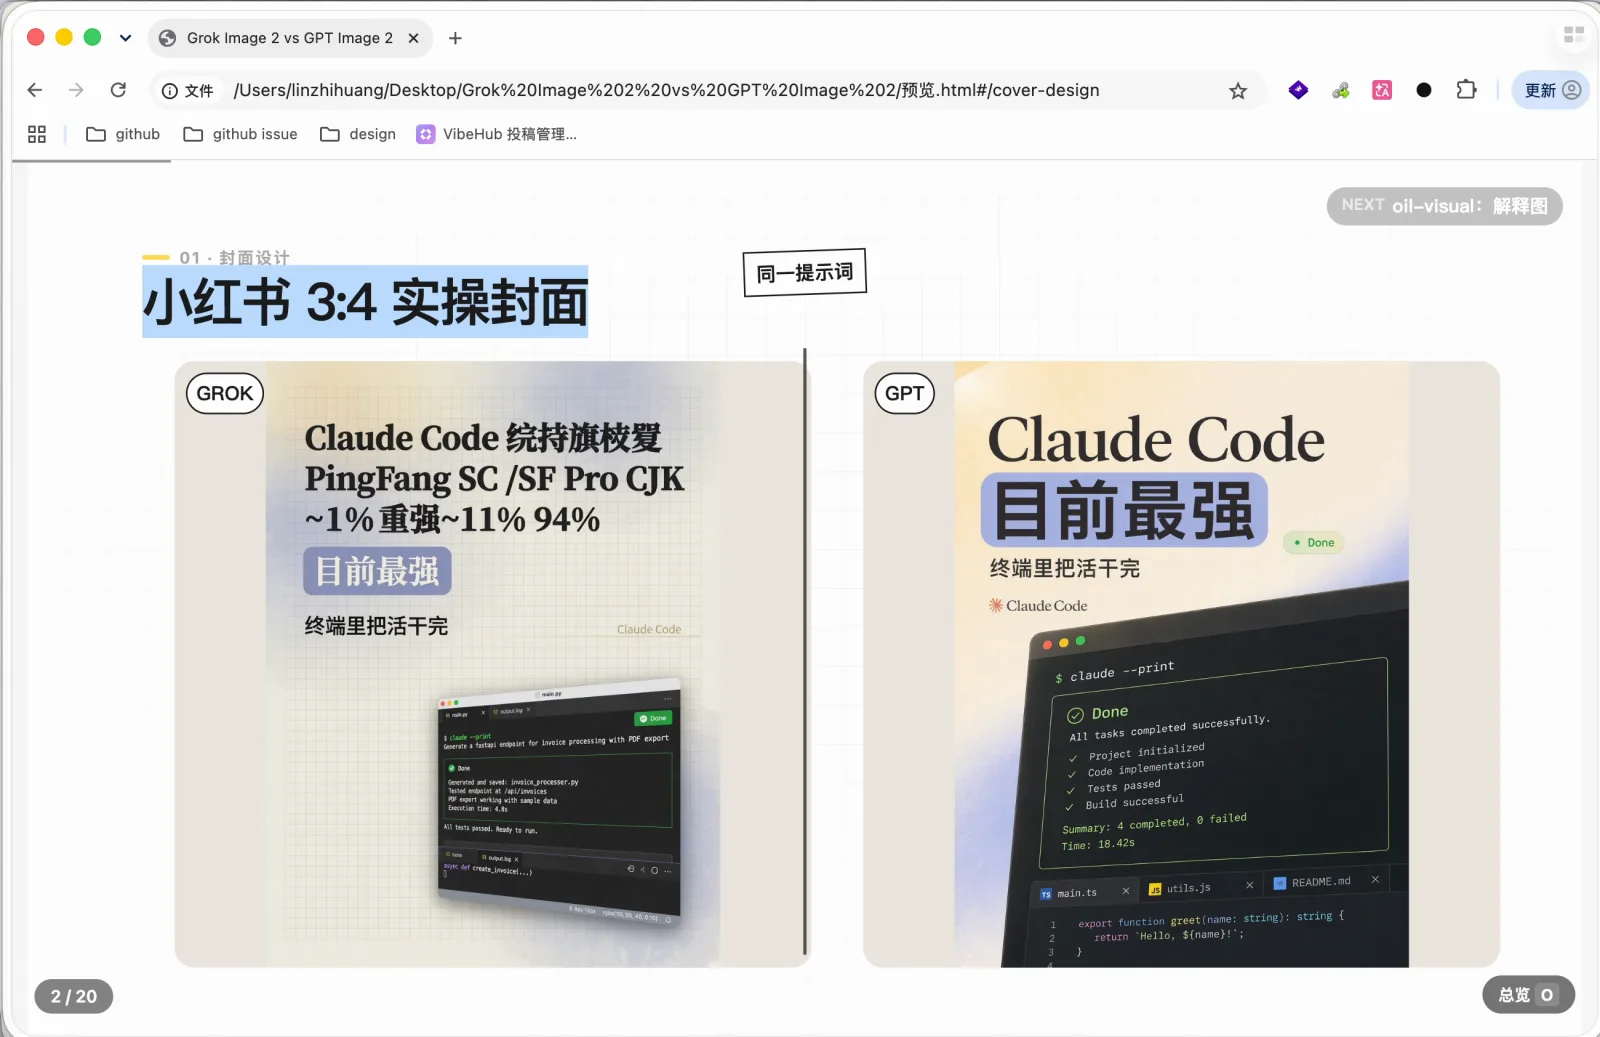
在这种需要中文文字精准、排版结构讲究的封面场景下,Grok 目前完全无法直接使用。
概念解释图:IP 形象还原度不足
第二个场景是我平时用来绘制黑白手绘风格解释图的 oil-visual Skill。
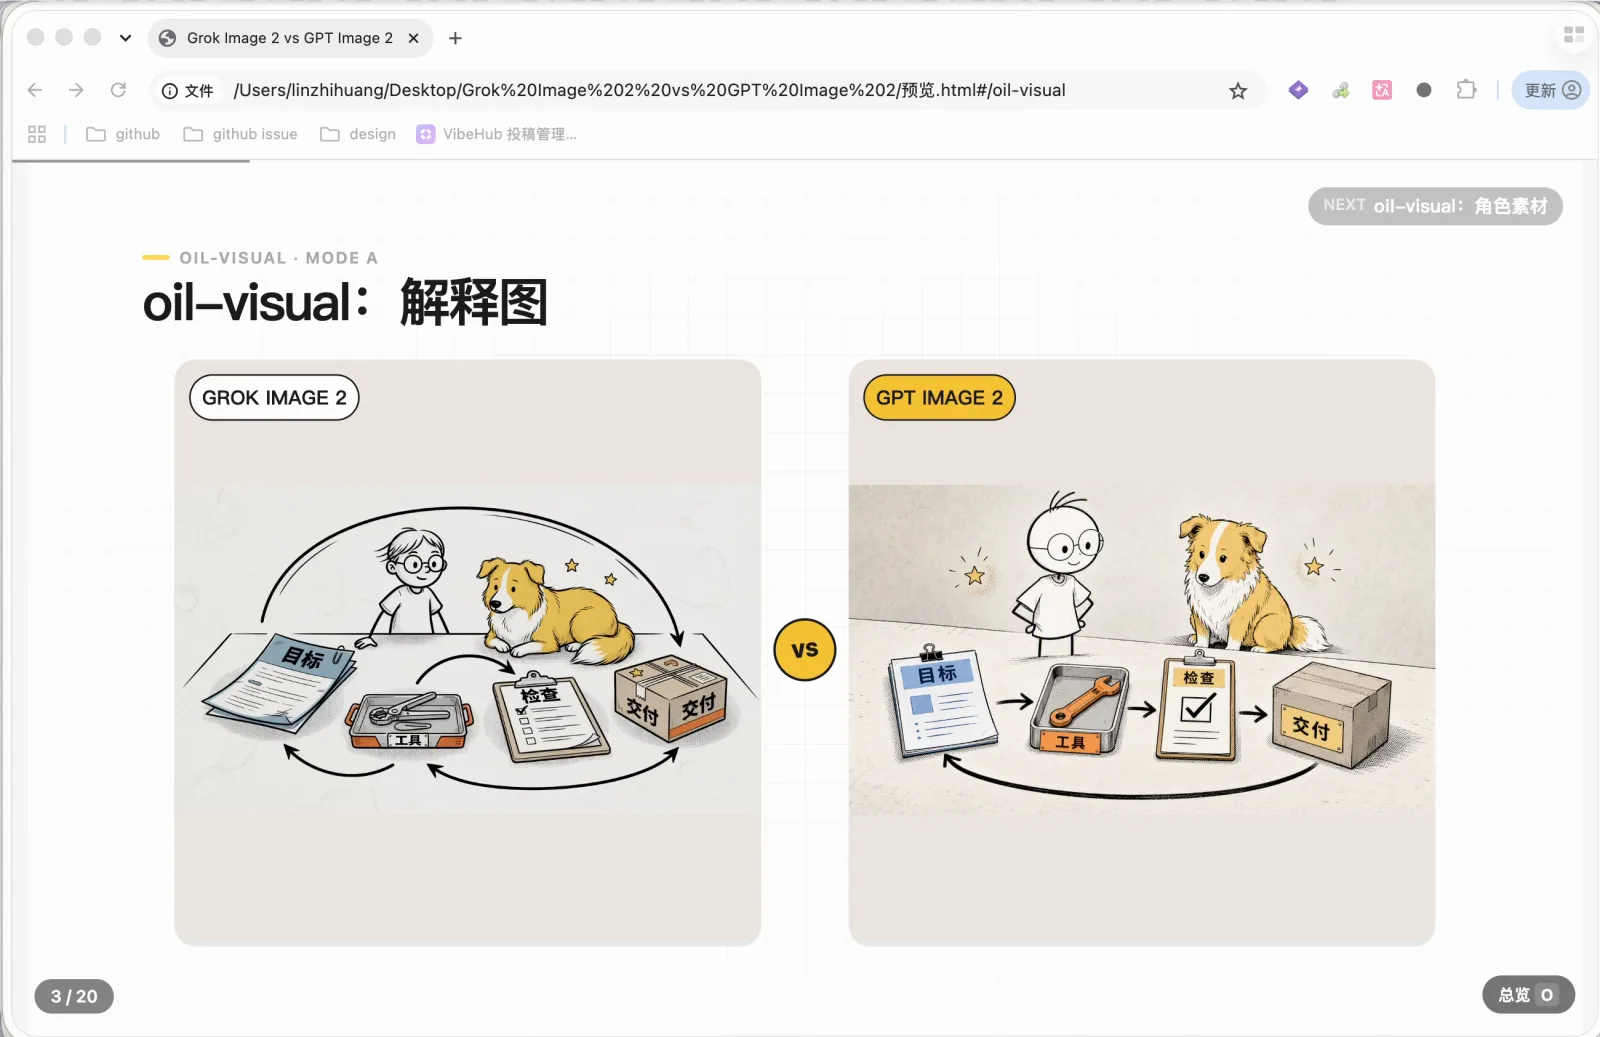
在这组测试里,桌面上出现的英文标签和画面右侧的中文说明,两个模型都能够准确写出。差异出现在画面的核心角色上。
我在日常文章和图解里统一使用同一个 IP 形象:一个头顶长着三根头发、戴着黑框眼镜的小人。这次测试我也上传了标准的参考图。GPT 对参考图特征的捕捉非常稳定,生成出来的小人和身边的小狗还原度很高,手绘线条细腻,整体画面更有设计感;而 Grok 对参考图的遵循明显不足,画出来的小人和小狗完全偏离了原有形象的线条风格,更像随机生成的人物。
绿幕素材与物理理解:抠图不稳定,但空间朝向更合常理
第三个场景是基于给定的线稿风格生成绿色背景,方便后续自动抠图并制作透明底素材。
在绿幕测试中,Grok 甚至没有生成绿色的背景色块。如果后续工作流依赖纯色绿幕来批量抠图提取透明素材,Grok 的表现并不稳定,经常忽略背景颜色的限定,因此在需要稳定透明底的流程里很难直接依赖。
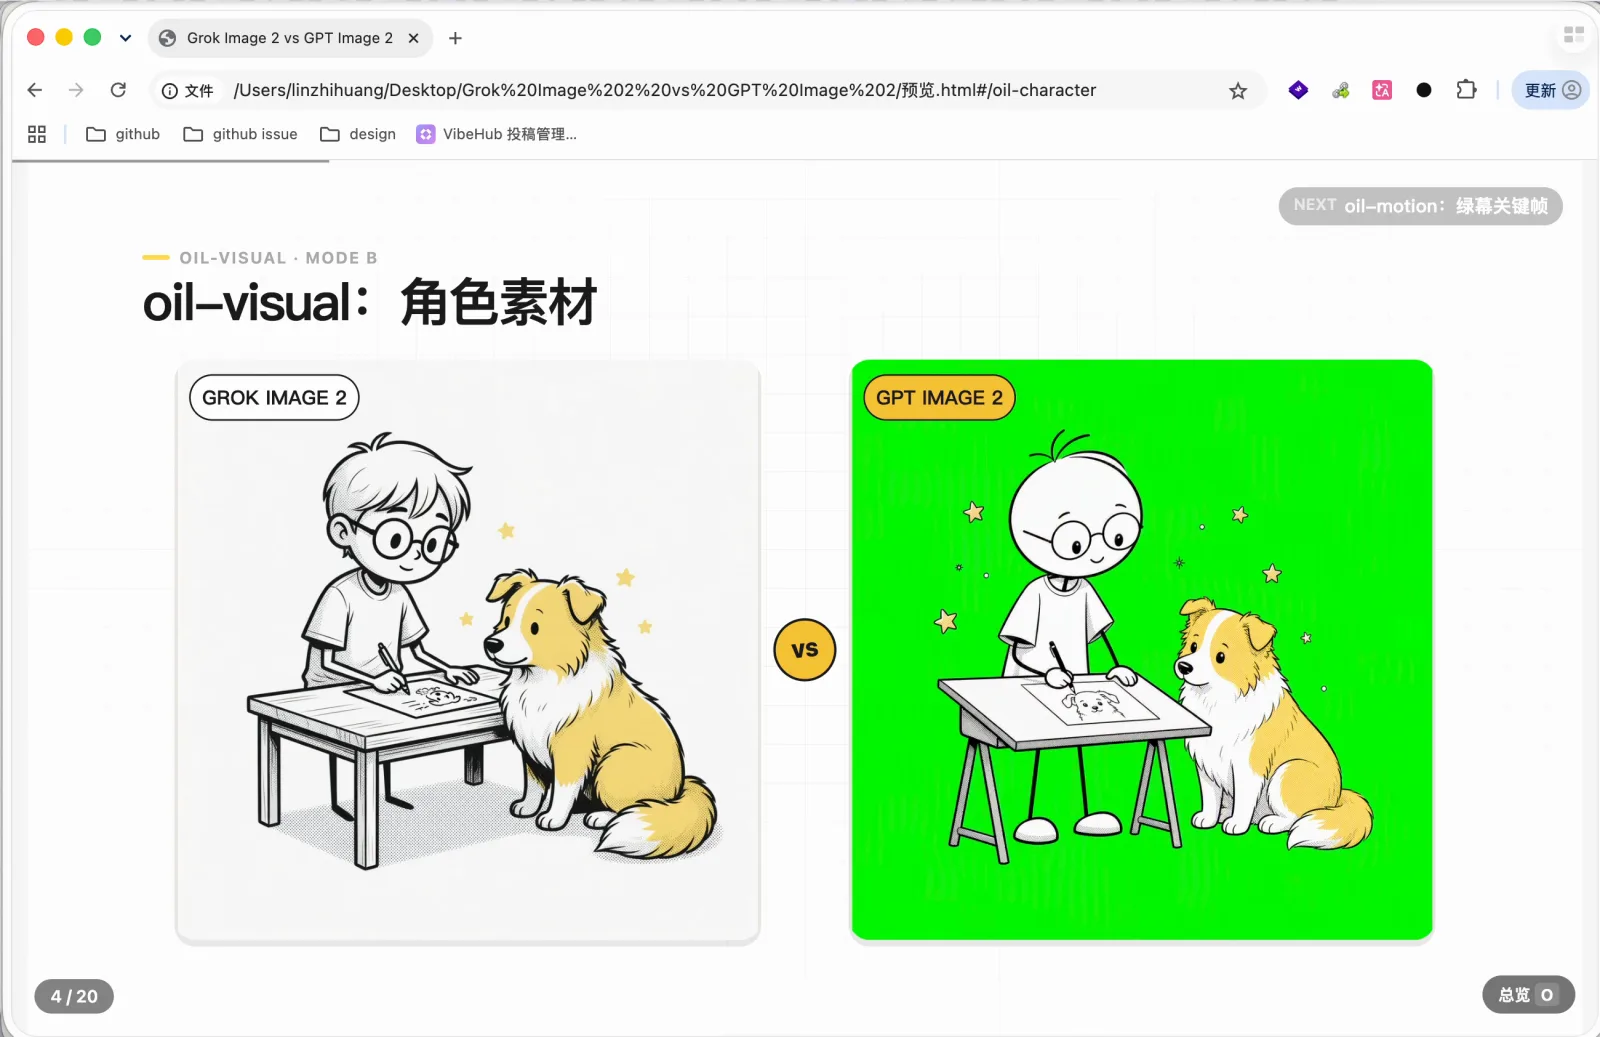
不过在这组测试里,Grok 反而展现出了一个容易被忽略的优势:它对现实物理逻辑和空间朝向的理解更合理。使用 AI 生成人物动作时,GPT 经常会出现反常识的翻转错误,比如人物手里拿着手机,屏幕却反过来对着镜头,或者画画时把画板正面对着观众而不是对着画画的人自己。Grok 在这类画面的肢体与工具朝向理解上表现得更加符合常理。
少文字活动海报:字体层级与画面质感
第四个场景是文字量较少的中文活动海报。
在这个测试里,两个模型对少量中文的处理都很稳定,没有出现缺笔少画的情况。两者的差别主要体现在字体层级和画面干净度上。
Grok 把画面里的所有文字都处理成了同一种有衬线的字体风格,没有主次之分,并且画面暗部偏灰,整体视觉观感偏脏。
GPT 则主动对文字层级做了区分:主标题使用了端庄的有衬线字体,正文描述和底部的补充信息则切换成了现代的无衬线字体。从排版的精致程度来看,GPT 的版面节奏感明显更好。
UI 界面原型:毛边与乱码无法充当参考
第五个场景是用生图模型直接绘制 UI 界面原型。
GPT Image 2 绘制界面的能力非常强。它生成的界面结构非常接近实际写出来的代码,布局规范,各层级组件的逻辑也很清楚,大多数模块可以直接照着还原成真实的前端页面,能给开发提供扎实的视觉参考。
而 Grok 生成的 UI 界面整体显得混乱。在信息结构相对密集的区域,文字边缘发虚带毛边,甚至出现了局部的文字错乱。虽然大体能看出一套网页的轮廓,但细节不够干净,缺少工程参考价值。
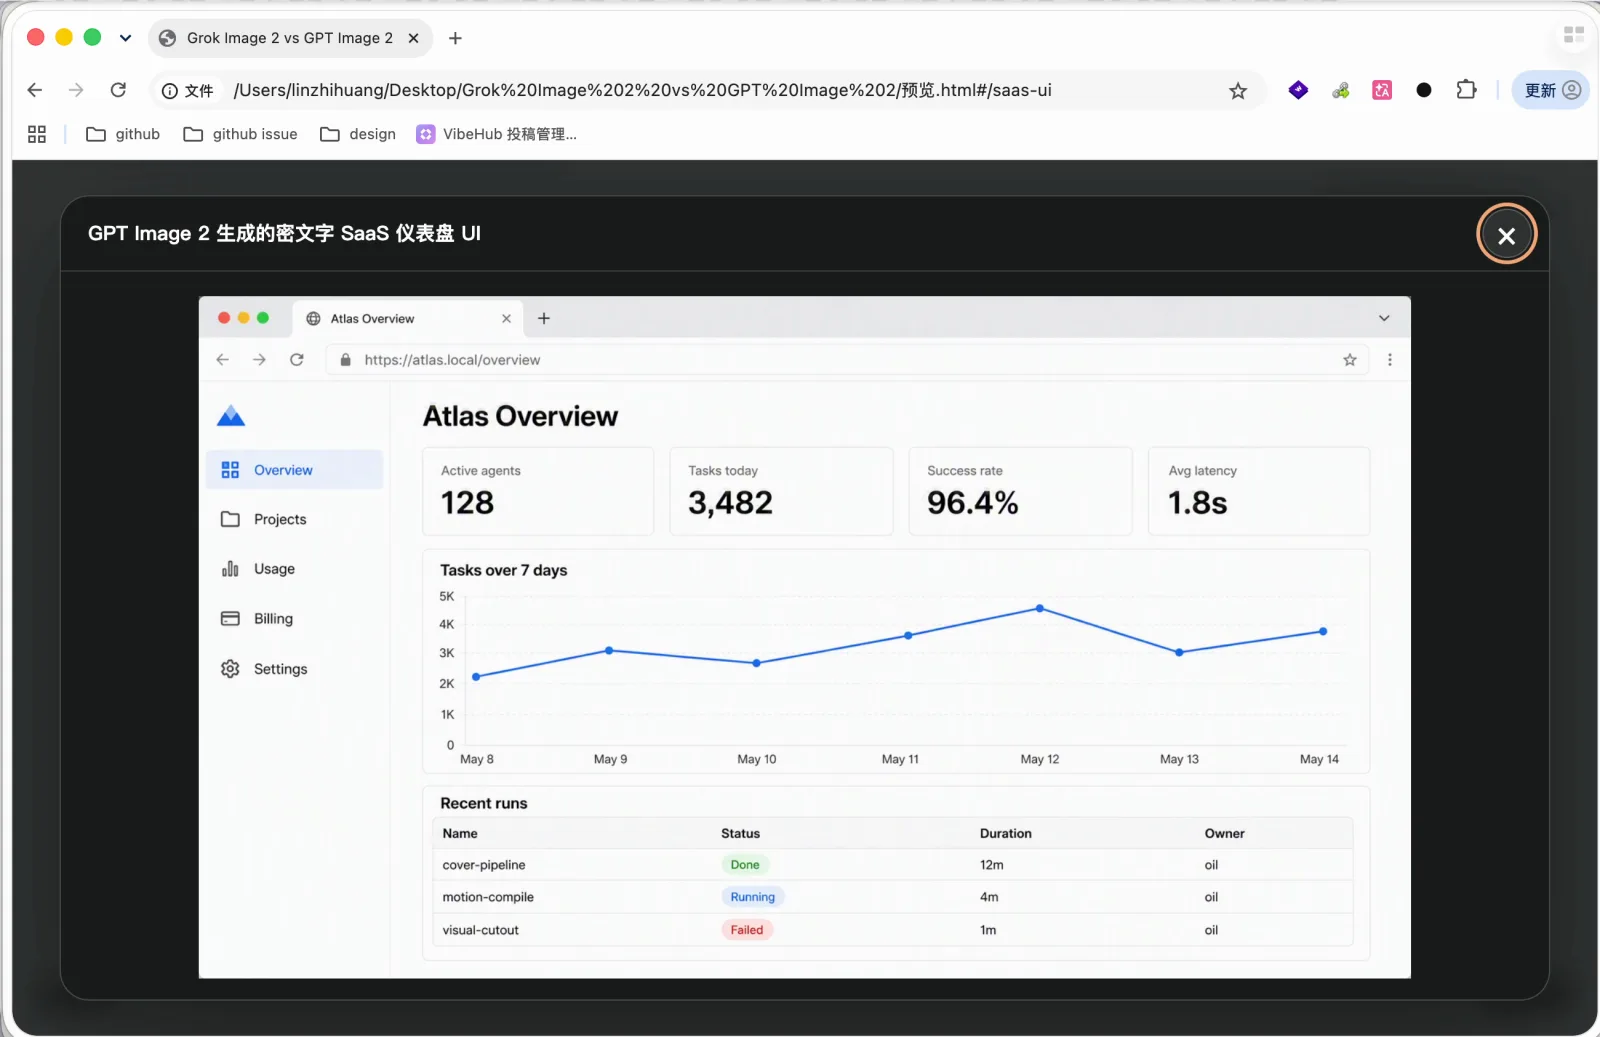
用 AI 生成 UI 图片,核心诉求是获得更高级的视觉审美和布局启发。如果模型生成的图片还不如前端 Agent 直接写出来的原型清晰,那通过生图来探索界面就没有太大实际意义。在 UI 原型这个场景下,GPT Image 2 依然处于领先位置。
传统美术风格与 IP 限制:政策宽松是 Grok 的独特变量
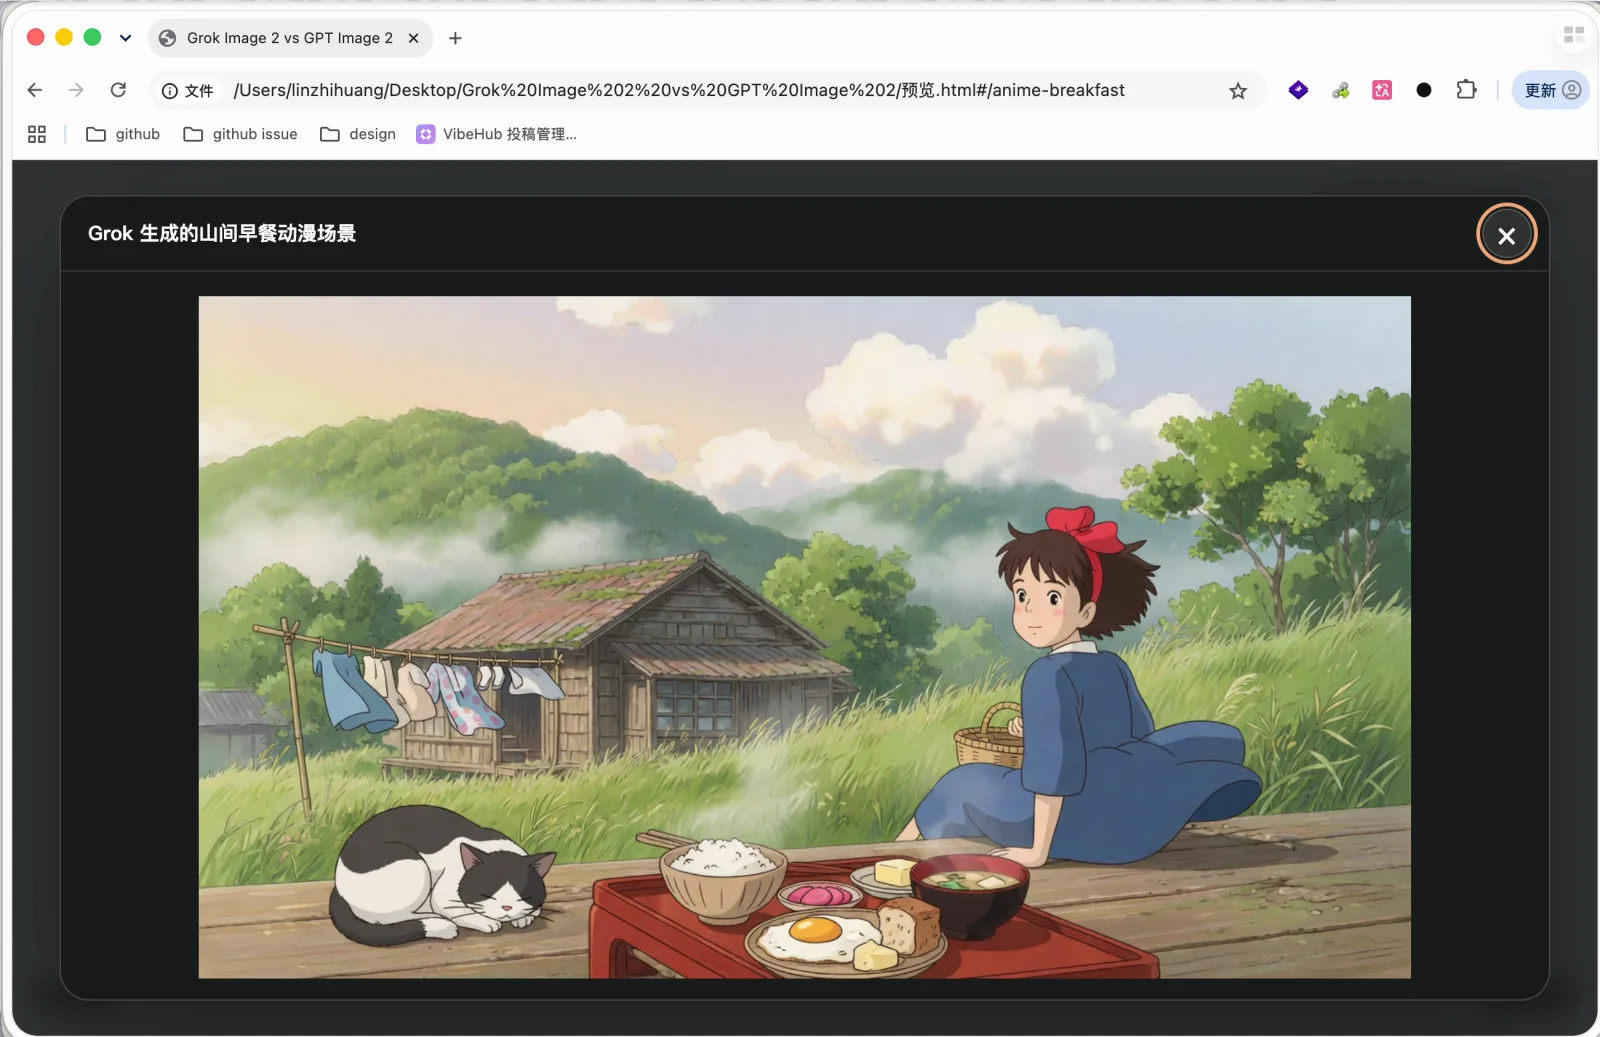
第六个场景是对比一些带有明确艺术流派风格的图像。
在新海诚风格的风景壁纸测试中,GPT 的发挥非常惊艳。画面的对比度、色彩饱和度与锐度都很高,光影层次非常细腻;而 Grok 的画面整体发灰,光影表现较平。
但在测试吉卜力、宫崎骏动画风格时,情况发生了反转。GPT Image 2 目前有着较为严格的合规策略,直接拒绝响应包含此类知名 IP 风格的提示词。而 Grok 侧的政策限制相对宽松,能够顺利生成吉卜力风格的画面,而且画面特征鲜明,水彩质感和怀旧笔触一眼就能认出对应的风格。
局部精准编辑与背景加字:对指令的理解偶有偏差
第七个场景是图像的局部修改与精准加字。
首先是局部增添物体。原图的桌子上摆放着三个物品,我要求模型在桌面的空闲位置放上一只红色的折纸千纸鹤。两个模型都准确地在不破坏原图其他元素的前提下融入了千纸鹤,空间透视和投影都很自然,只是千纸鹤本身的折法细节略有差异。
随后是在一张纯背景图上添加指定中文,测试文字排版能力。我让模型在背景上自然写入「晨间工作台」五个字。GPT 表现得极其稳定,文字清晰锐利,原图背景没有受到任何多余的破坏。而 Grok 对指令的理解出现了偏差:它先在背景上画了一块白色的底色方块,再把文字印在方块里。这种理解上的偏差,会导致在实际出图时需要反复尝试和抽卡。
手机实拍与真实场景:更少油腻感,但败在抓拍生活感
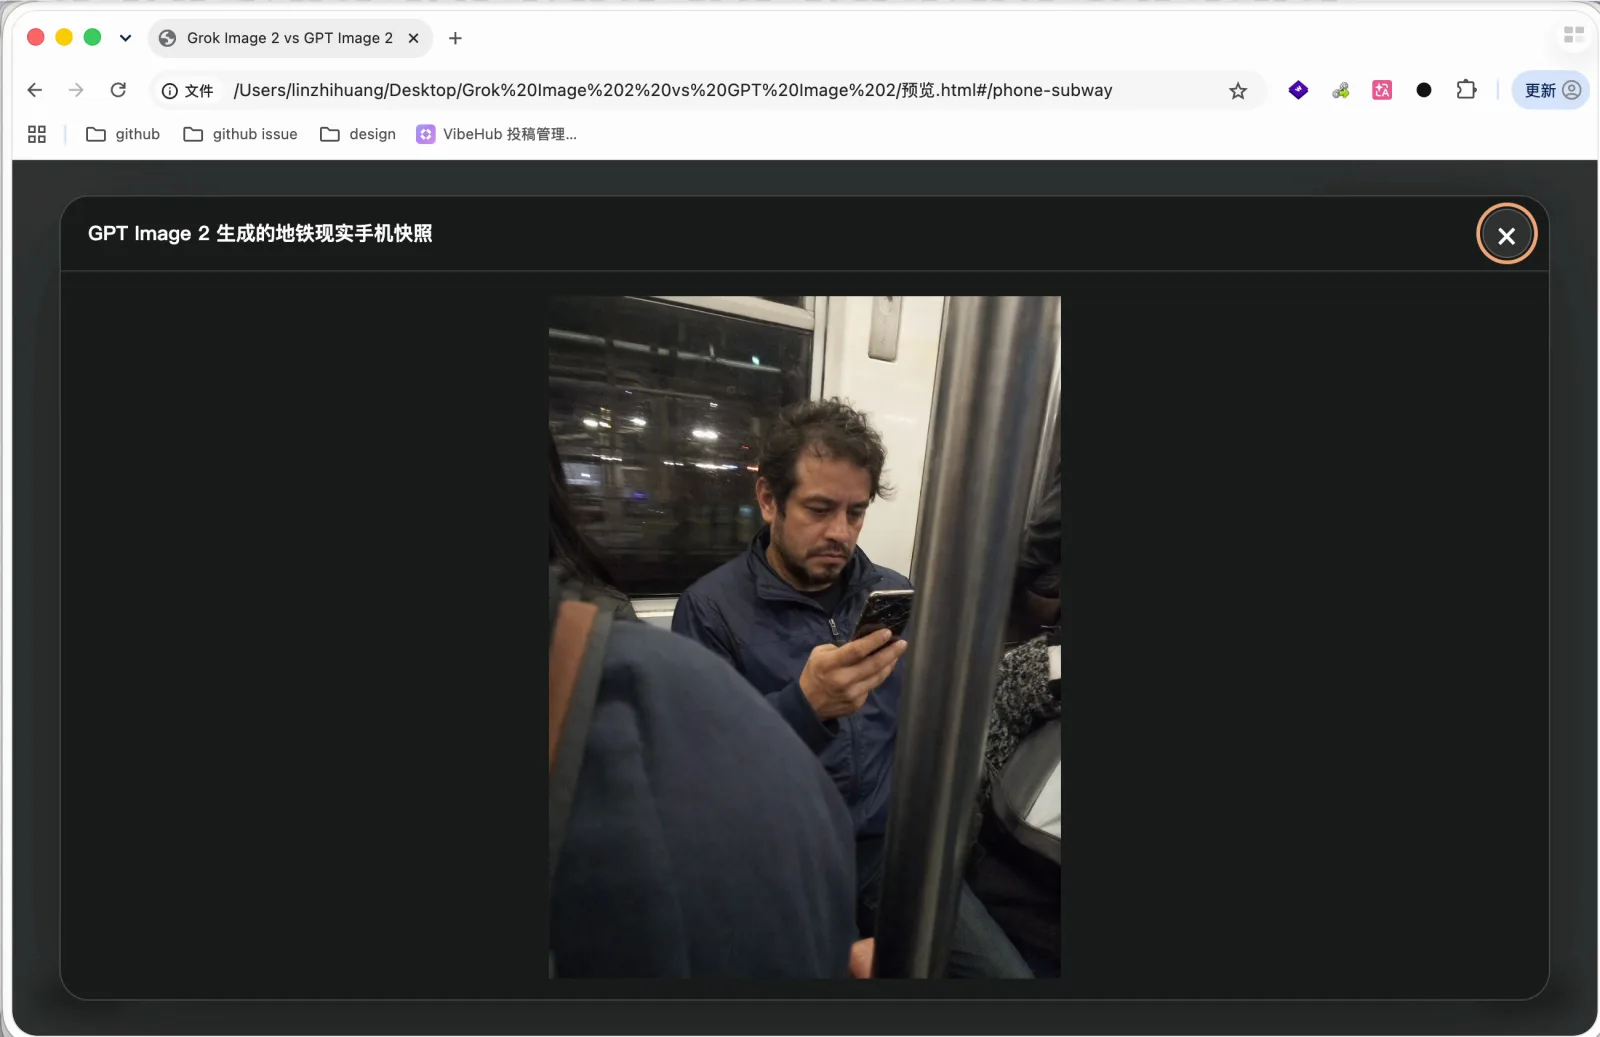
第八个场景是模拟手机随手拍的生活人物与街头纪实。
在白天的真实人物街拍中,两个模型生成的画面整体都比较自然,不放大看很难一眼辨别出 AI 痕迹。GPT 生成的人物偏精致,锐度和噪点控制得更工整;Grok 因为自带对比度偏低、画面微灰的特性,生成的人物反而少了一些塑料感,背后的街道建筑细节也很逼真。不过 Grok 背景里的招牌一旦出现文字,乱码就会迅速暴露它的生成身份。
在夜晚手机摄影风格的测试里,两者的取向差异更加明显。GPT 生成的人物和环境光偏向影棚柔光箱打出来的精致质感,人物面部带有明显的 AI 抛光感和油腻感;Grok 的皮肤质感和环境光则更贴近普通手机的噪点表现。
但是在地铁车厢随手拍的测试里,GPT 呈现出了更好的日常感。GPT 的视角、光影和车厢人物分布非常真实,就像通勤路上掏出手机随手抓拍的瞬间;而 Grok 的画面更接近电影布景,虽然构图工整,但缺少了随手抓拍那种鲜活的生活气息。
角色定妆与连续派生:系列光影与色调容易漂移
第九个场景是先给模型一张人物角色的定妆照,再通过图生图的方式派生一系列不同环境下的主题海报。
在单张定妆照的测试中,Grok 的人物质感自然,GPT 依然存在面部高光过重的油腻问题。
但当我以这张基础定妆照为基准,连续派生后续的多个不同场景时,GPT 的表现明显更加稳定。尽管 GPT 延续了偏油润的画风,但跨场景生成的多个画面在色调、光线冷暖以及人物五官的一致性上维持得很好。
而 Grok 在连续派生时,虽然人物五官基本能够认出,但画面光影和调色在不同场景之间会出现跳跃,每一张图都像使用了独立的光照方案和调色预设。在需要保证系列感的海报制作中,Grok 的风格控制力不如 GPT。
适合大批量铺量,严肃场景依然离不开 GPT
9 轮测试下来,Grok Image 2 的能力边界已经比较清楚:它确实具备了相当不错的写实出图素质,但目前还不适合直接放进要求严格的设计工作流里。
只要任务涉及中文文字排版、精准的 IP 形象还原、需要提取绿幕透明底,或者需要严格保持系列连贯性,Grok 的失误率依然偏高,这些场景我依然只能依靠 GPT Image 2。
但如果你的需求是以下几类,Grok Image 2 的性价比非常突出:
- 官网背景与氛围配图:不需要在画面中嵌入文字,只需要大批高质量图片衬托视觉;
- 写实人物与受限艺术风格:追求更自然的手机写实摄影质感,或者需要生成受 GPT 合规政策限制的特定流派;
- 批量素材与画廊展示:需要短时间内铺设大量图片内容,Grok 出图速度更快,成本只有 GPT 的五分之一到七分之一。