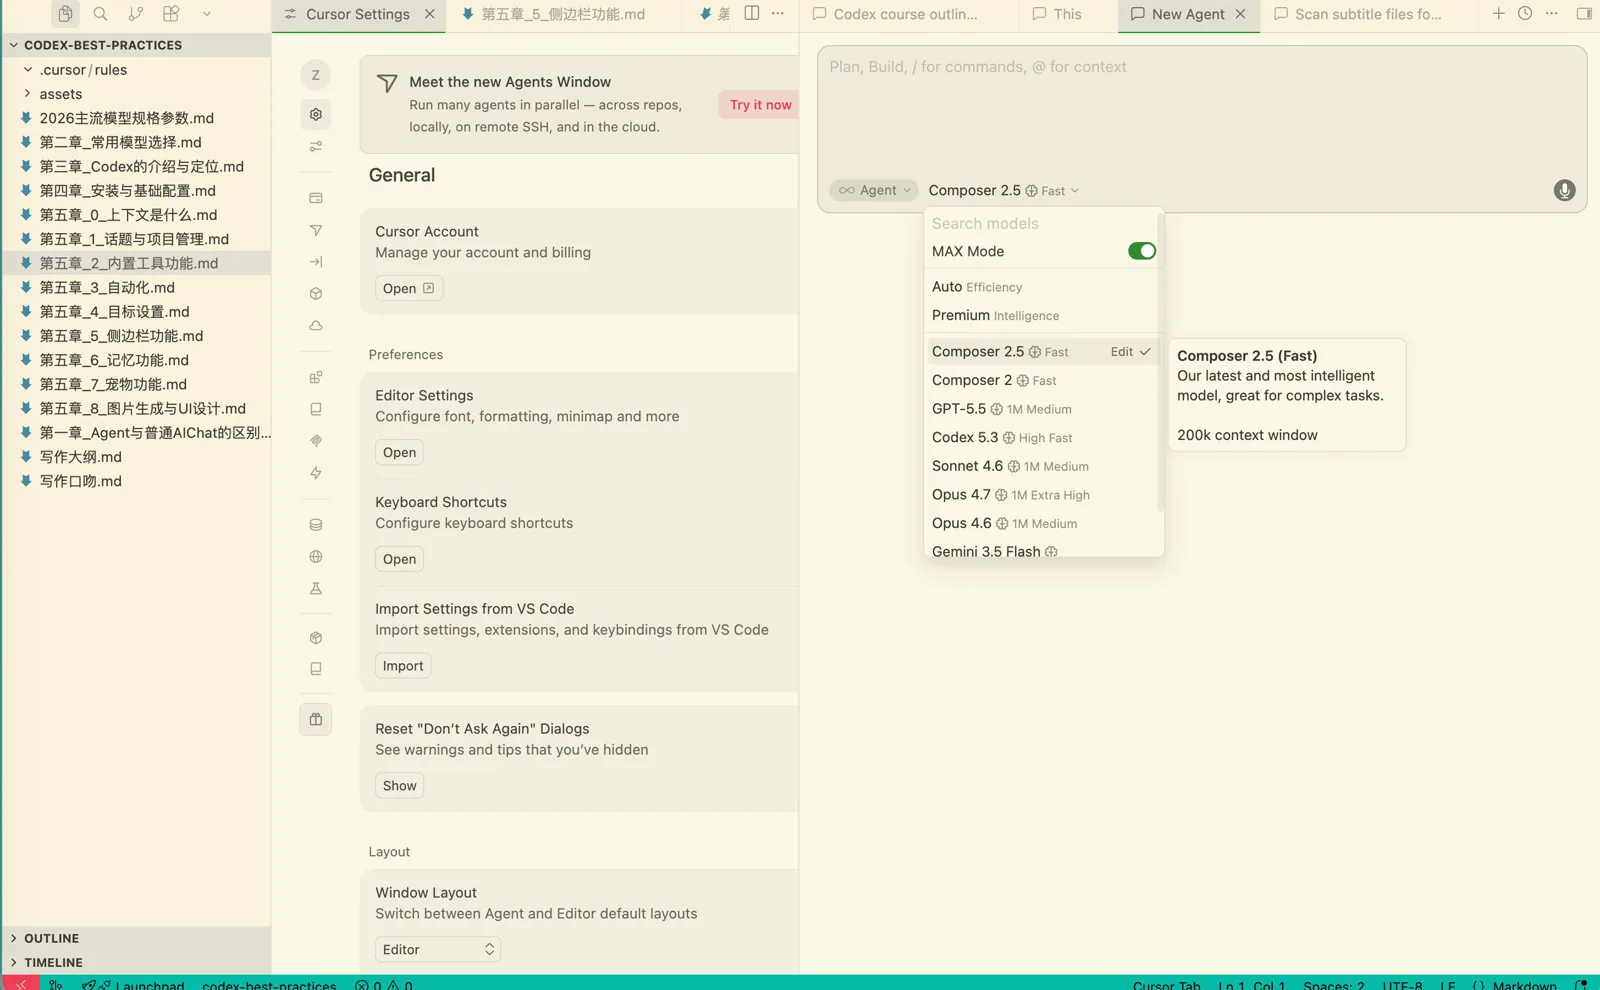
Gemini 3.5 Flash 发布之后,Cursor 第一时间上线了它。这段时间我一直在 Cursor 里使用这个模型,搭配的是一个以前已经用过的 Agent。Agent 不变、只换模型,这样可以在保持相同变量的情况下感受模型本身的差异。
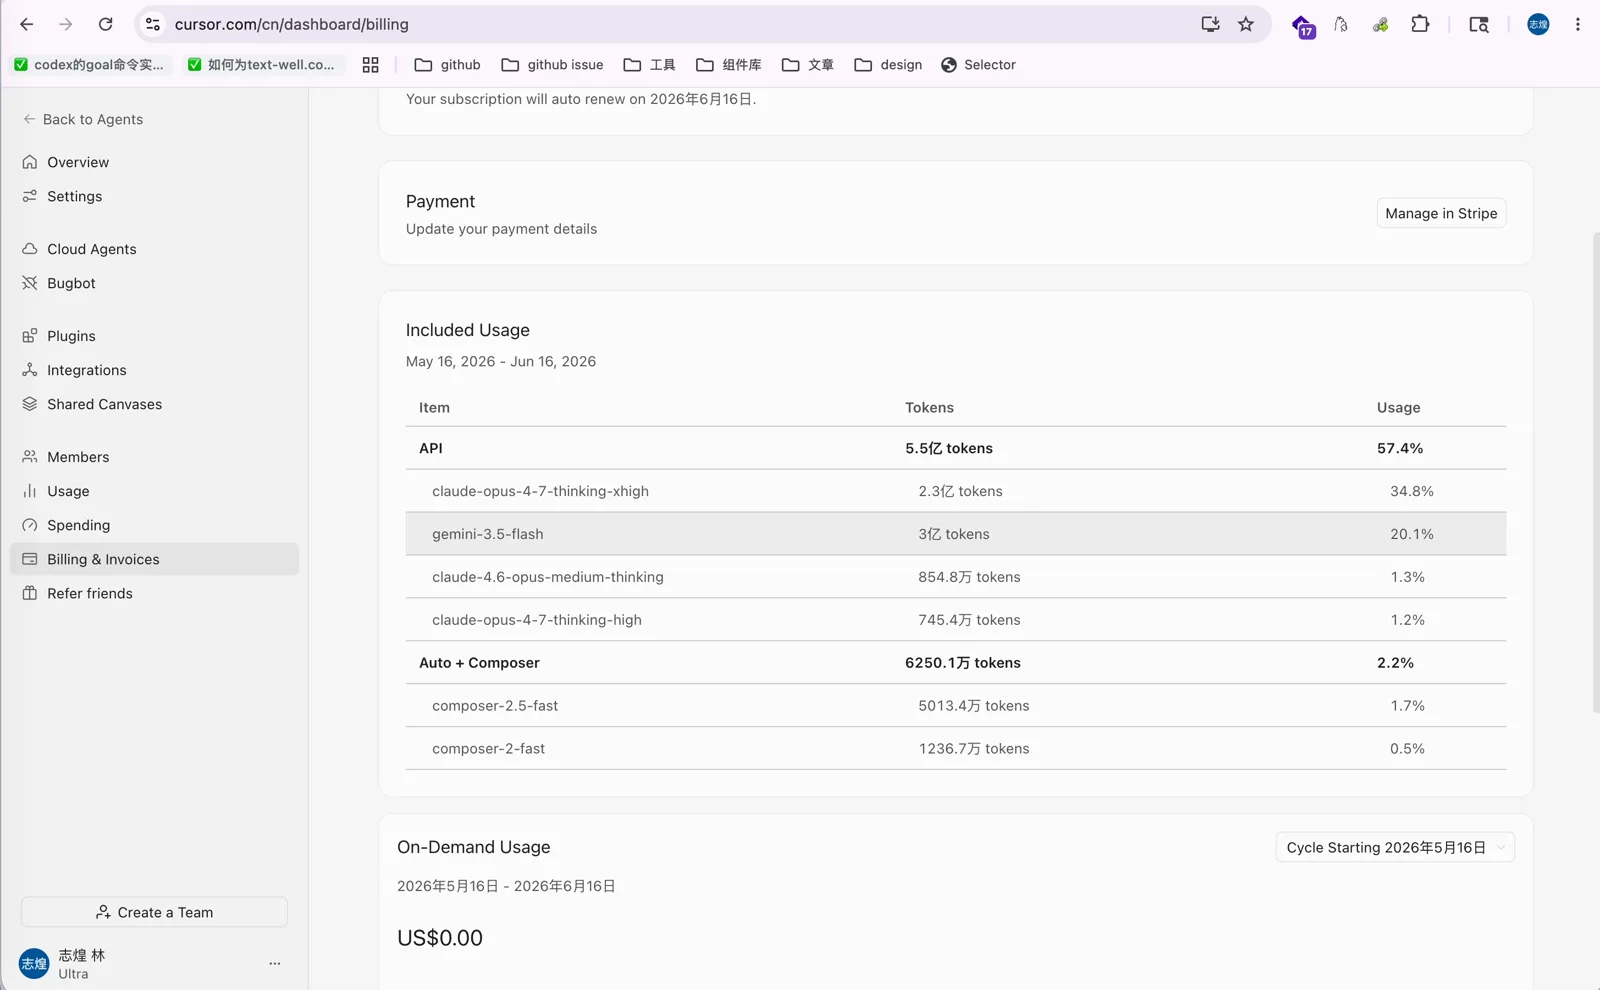
之前的 Gemini 当不了 Agent 基座
在 Gemini 3.1 Pro 和 Gemini 3 Flash 的时代,Gemini 对 Agent 驱动的可用性几乎为零,很少有人会把 Gemini 3.1 Pro 当作编程 Agent 的基座模型。
它虽然有 100 万 token 的上下文,但指令遵循很差。它是唯一一个我在 Cursor 里开启 Plan 模式之后,会无视 Plan 文件、直接去修改代码的模型。Plan 模式应该是注入了一些 Prompt 约束行为,但它没有遵守。另外对话轮数高了之后,它输出的内容经常会变得奇怪,我不清楚具体原因。
价格贵了三倍,应该对标 3.1 Pro
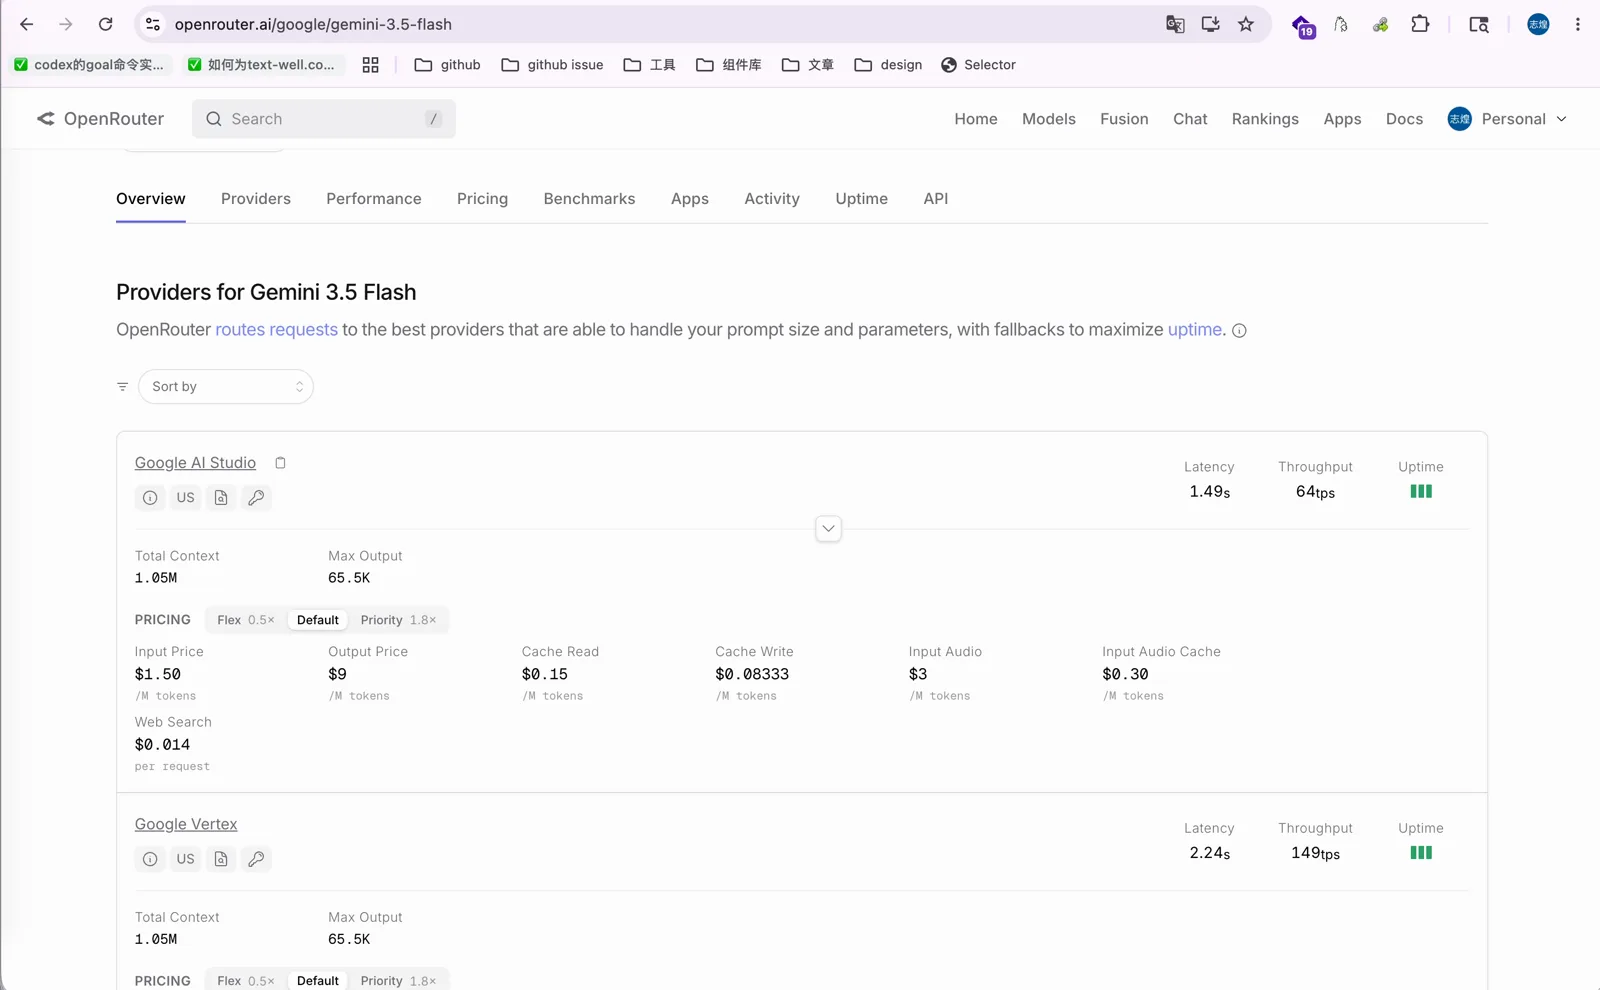
Gemini 3.5 Flash 相比之前的 Gemini 3 Flash,价格贵了整整三倍。OpenRouter 上的价格:
- Gemini 3 Flash:输入 0.5 美金、输出 3 美金,每百万 token;
- Gemini 3.5 Flash:输入 1.5 美金、输出 9 美金,每百万 token。
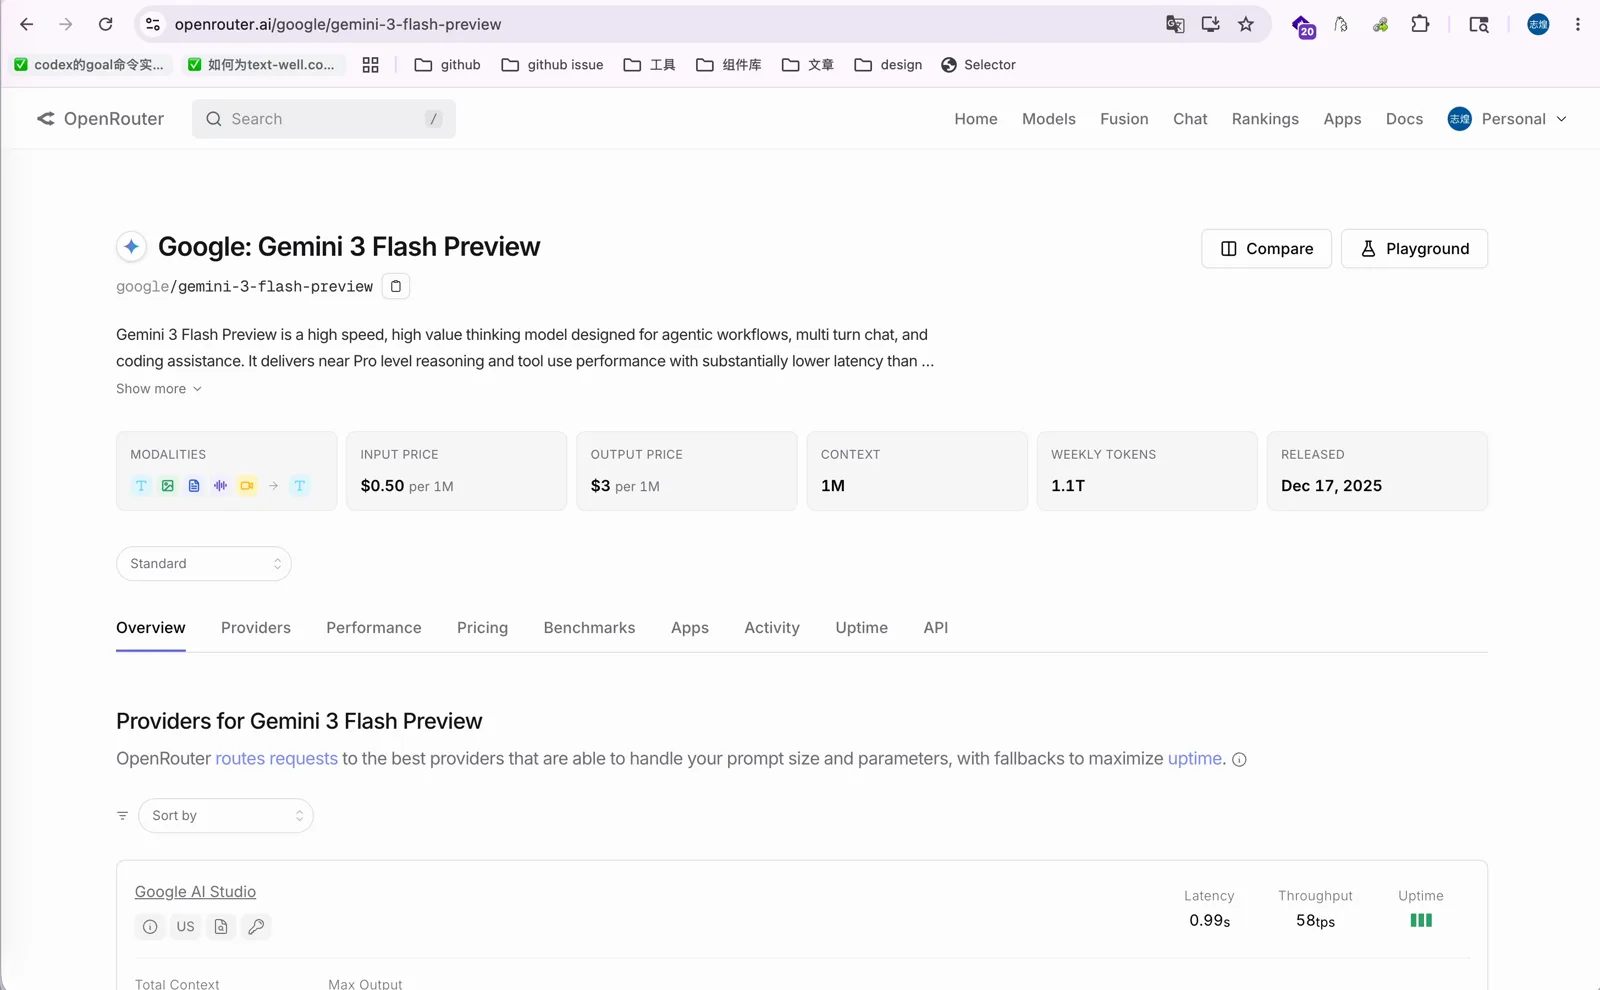
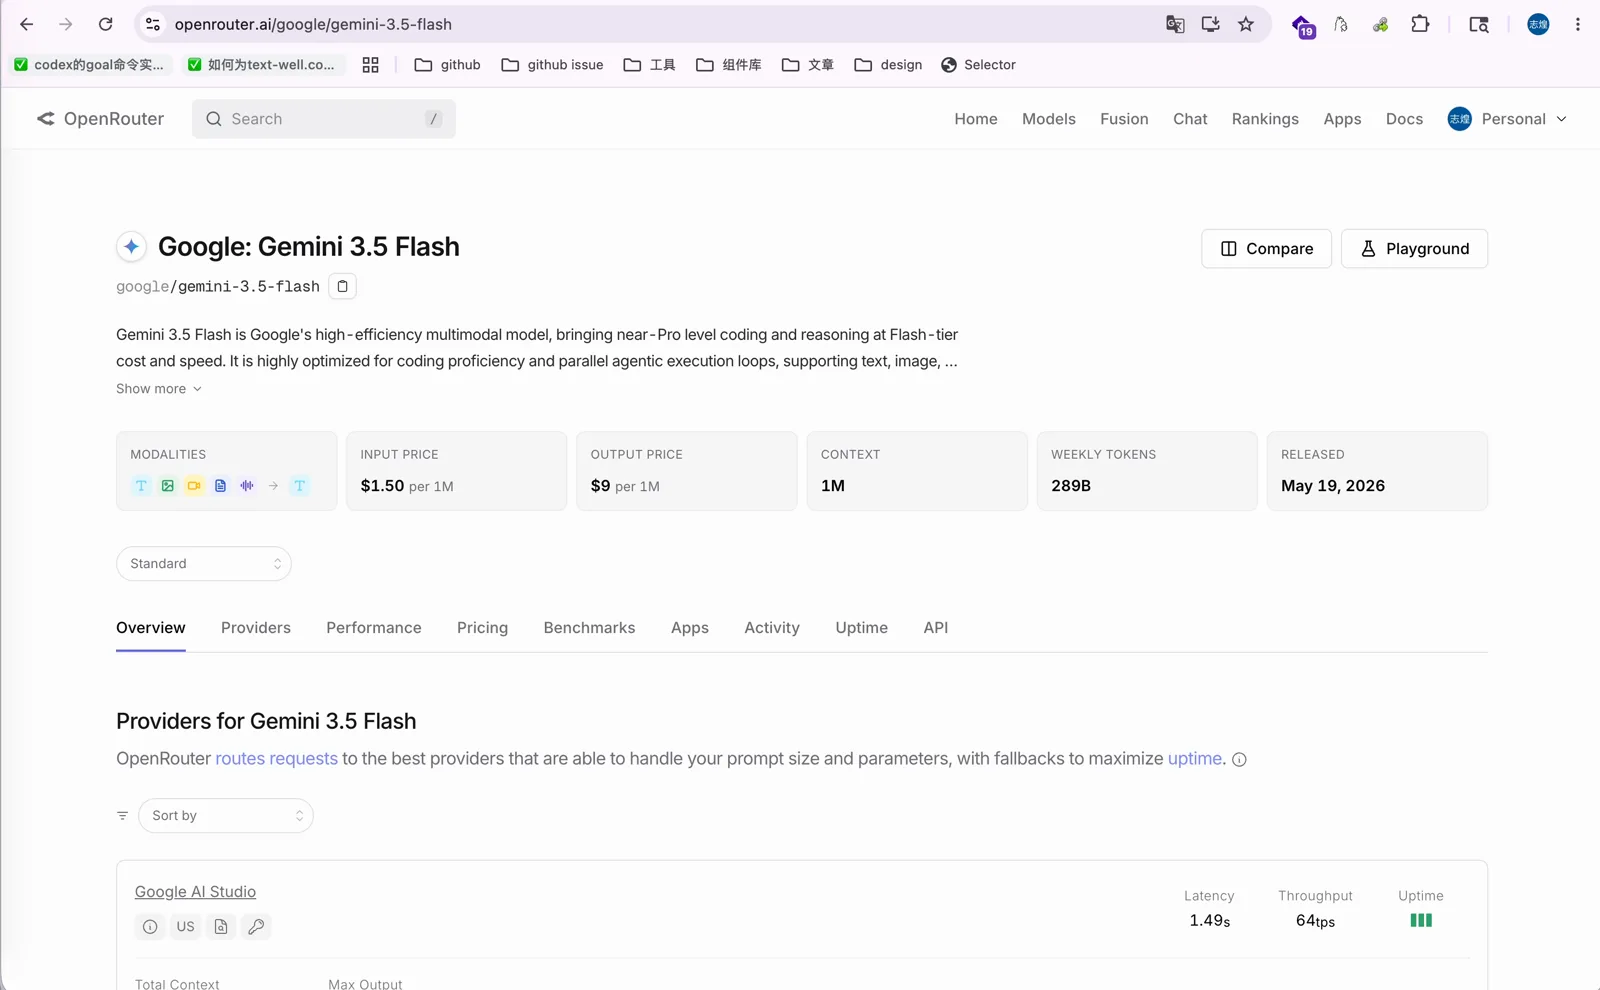
这个价格已经快追上之前 Gemini 3.1 Pro 的 15 美金了。所以我认为它不应该再和 3 Flash 对标,而是应该对标 3.1 Pro。
在 Cursor 里的 Agent 表现
在 Cursor 里搭配 Gemini 3.5 Flash 使用,它基本具备了正常编程 Agent 的基础能力。我让它修改代码、正常对话,执行到五六十万上下文的时候,它大体还是比较准确的。
编程能力本身我觉得只能算凑合,和 GPT 5.5、Claude Sonnet 4.6 这类很强的模型完全比不了,当然它的价格也终究便宜一点。它的好处是输出速度比较快,官方介绍说 TPS 能达到两三百 token 每秒。不过我实际使用时没有感觉非常快:它思考的速度可能很快,但把代码写出来的时候还是需要等一下。Cursor 自带的 Composer 2.5 输出速度更夸张。
整体用下来,我认为 Gemini 3.5 Flash 的编程能力和 Composer 2.5 差不多,胜负不明显,只是取向上有区别:
- Composer 2.5 很像 GPT 这类模型,编程能力强、Agent 能力强,但语言理解能力比较差,写出来的方案、文本可读性不好,GPT 5.5 也有同样的问题;
- Gemini 3.5 Flash 的编程和 Agent 能力弱一些,但文本写得更好。
文本差异不只是体现在写文档上。很多时候我们做网页,页面上会有文案,GPT 5.5 和 Composer 很喜欢把网页的元数据写上去,甚至把我们的原始命令写到页面里。它们分不清网站是面向用户的,还是面向我们开发者的。这是我在实际使用中发现的最大问题之一。
所以在 Agent 方面,Gemini 3.5 Flash 相比 Composer 2.5 没有优势,日常任务我会优先使用 Composer。
Gemini 的 UI 设计能力
Gemini 之前在 Agent 和编程方面比不上 GPT 和 Claude,但它一直有自己的优势:UI 设计特别好。我之前把 Gemini 3.1 Pro 当作一个外置工具,需要做 UI 设计的时候,让 Claude 或者 GPT 单独调用它生成一个 HTML 文件。
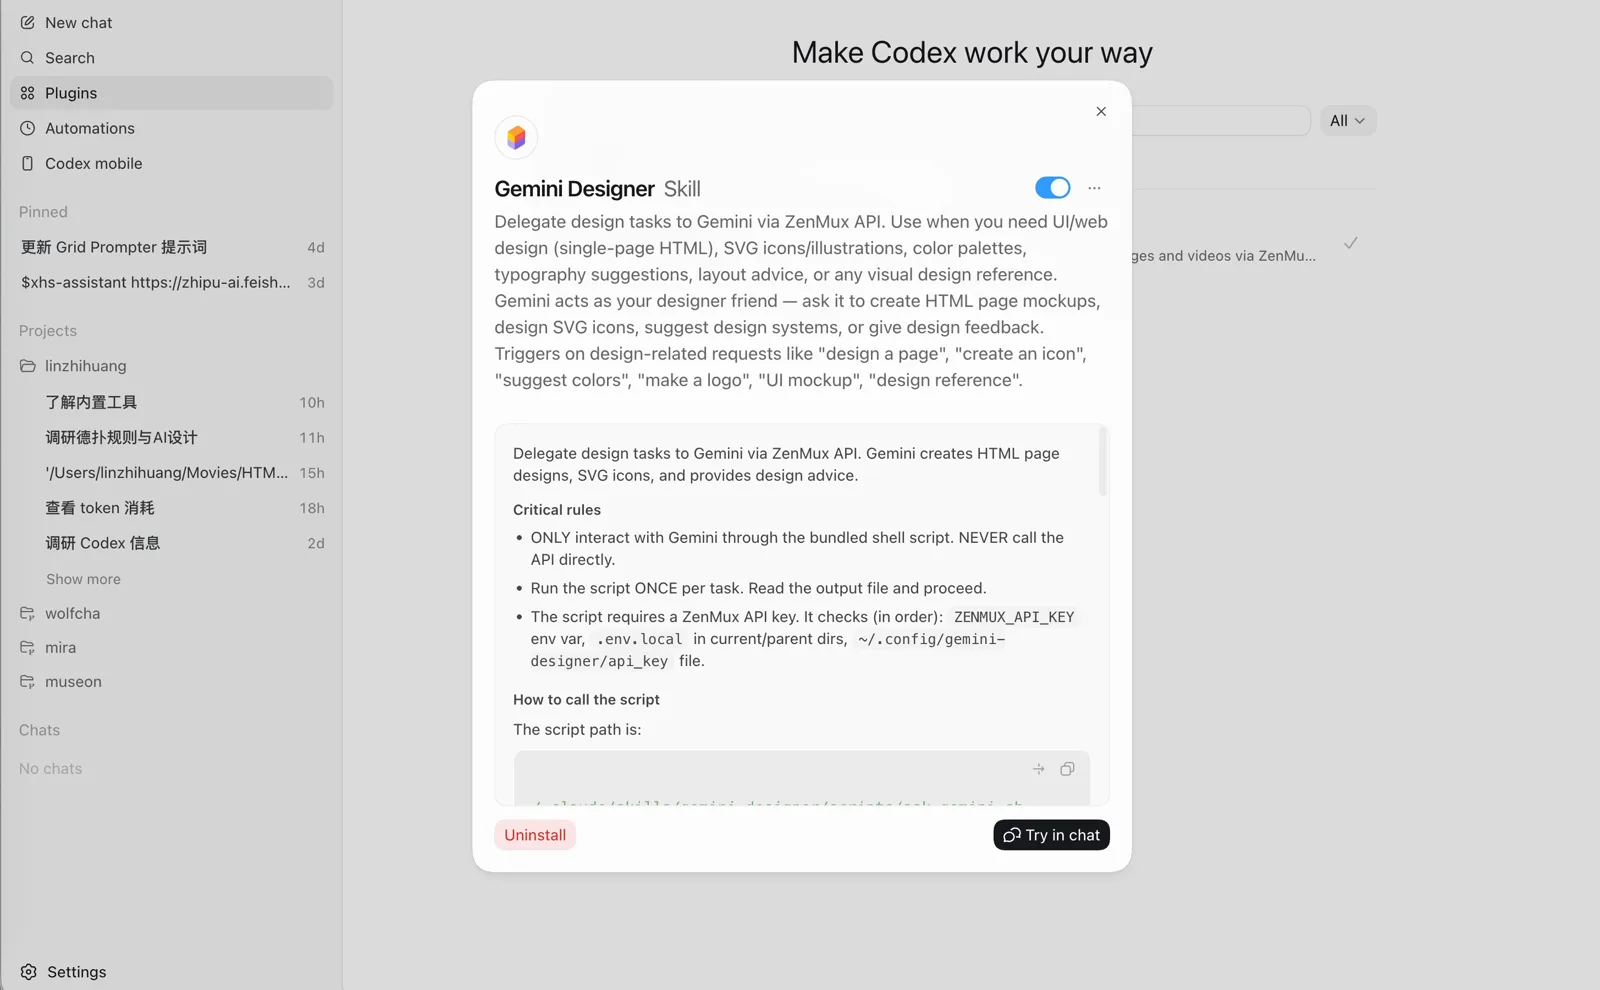
我自己写过一个叫 GeminiDesigner 的 skill,它就是调用我外部连接的 Gemini 模型来做这类设计任务,之前用的是 Gemini 3.1 Pro。
文案能力是它现在的优势
Gemini 3.5 Flash 输出的文本效果不错,AI 味没有那么重。不过 Gemini 本身的文案性格是比较喜欢用形容词、喜欢用比喻、表达偏浮夸,还有很多双引号,需要一些基础的提示词调教。
我现在在写一个课程,会用它来校正我的写作口吻,也会让它帮我做调研,整体的文案水准我觉得很不错。现在的大模型很多都太侧重 Agent 能力和编程能力了,文案方面做得比较好的可能是 Claude 的 Opus 4.6,而 4.7 的文案能力已经明显退步。有一个新模型也能把文案做好,对不用模型编程的人来说是多一个选择。
输出速度和视觉识别的应用场景
Gemini 3.5 Flash 的 token 输出速度变快之后,一些对输出延迟敏感的 AI 应用就有了新的选择。比如我之前做的 AI 狼人杀,我对玩家发言的等待时间要求比较苛刻,希望 AI 在一两秒之内就能说出很长的一段话。这类对 token 输出速度要求很高的应用,现在可以考虑用 Flash 来做。
另外 Gemini 相比 GPT 和 Claude 还有一个优势:原生支持视频识别。虽然我们可以通过抽帧的方式让 Claude 或者 GPT 识别视频内容,但 Gemini 的原生 API 直接支持视频输入,会方便很多。它的视觉识别能力我也认为比 GPT 和 Claude 更好,尤其是一些很细的操作,比如在一张截图里框住具体的某个元素,Gemini 做得很好。
Gemini 一直给我们的价值是多一个选择,但我还是希望它的 Agent 能力能更强一点。等后面 Gemini 3.5 Pro 发布之后,我再分享一下它的实际感受。