这期分享 Codex 里面子 Agent 的使用方式和我自己的一些实践。
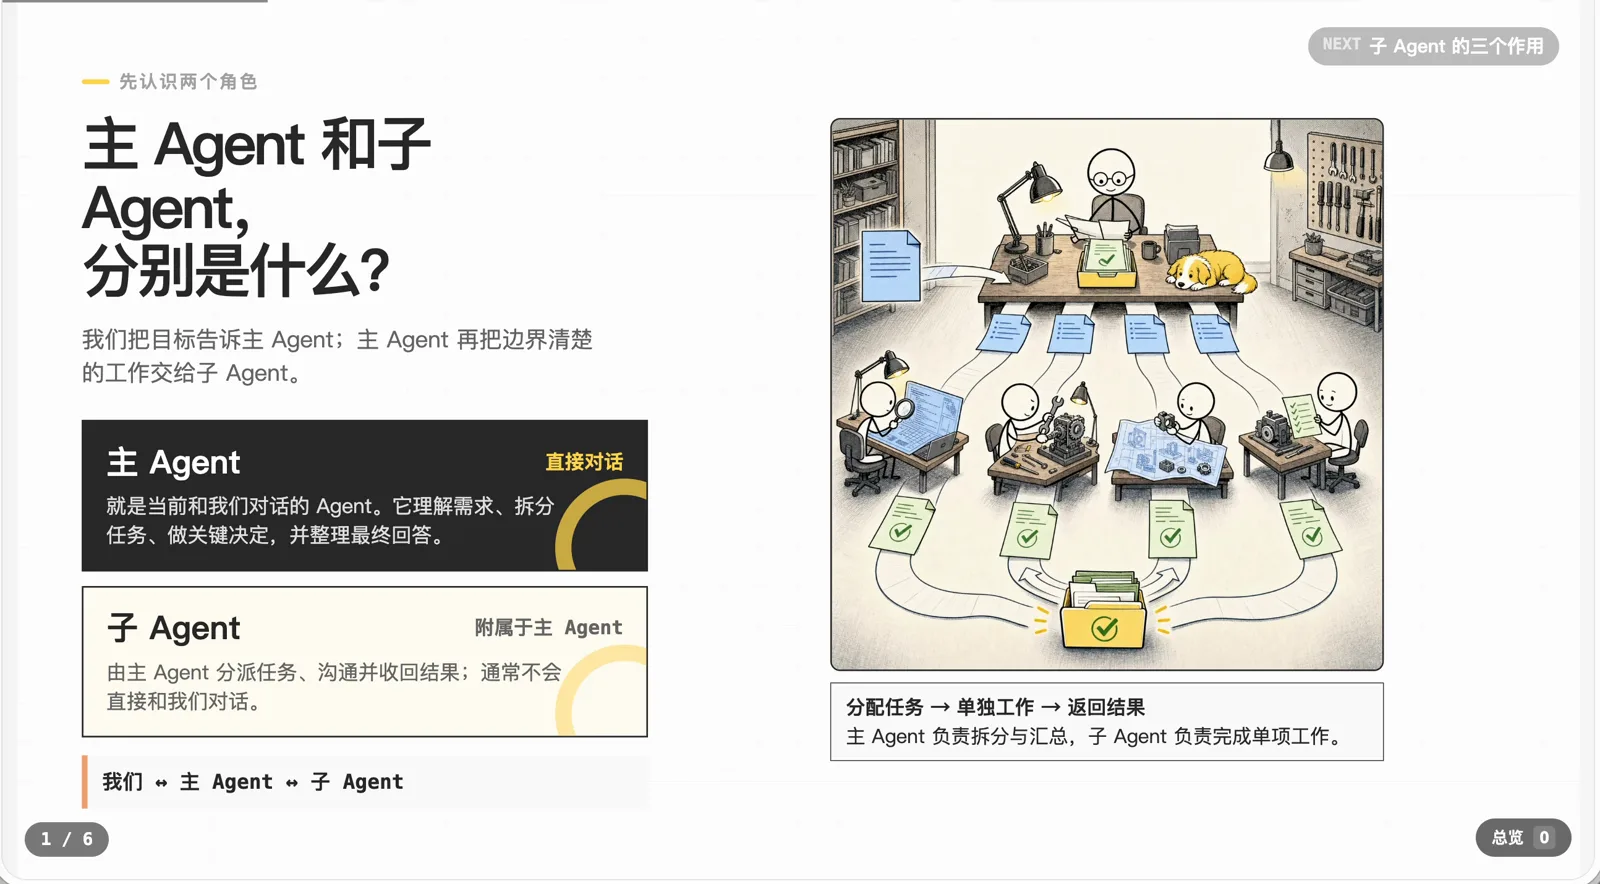
先说一下子 Agent 是什么。我们日常和 Codex 对话时,直接和我们交流、负责执行任务的可以叫主 Agent。子 Agent 是主 Agent 派发的下级,它不和我们交流,只和主 Agent 交流:主 Agent 把任务分配给它,它单独执行,完成之后把结果汇报给主 Agent。
子 Agent 的三个作用
我自己用下来,子 Agent 最核心的作用有三个。
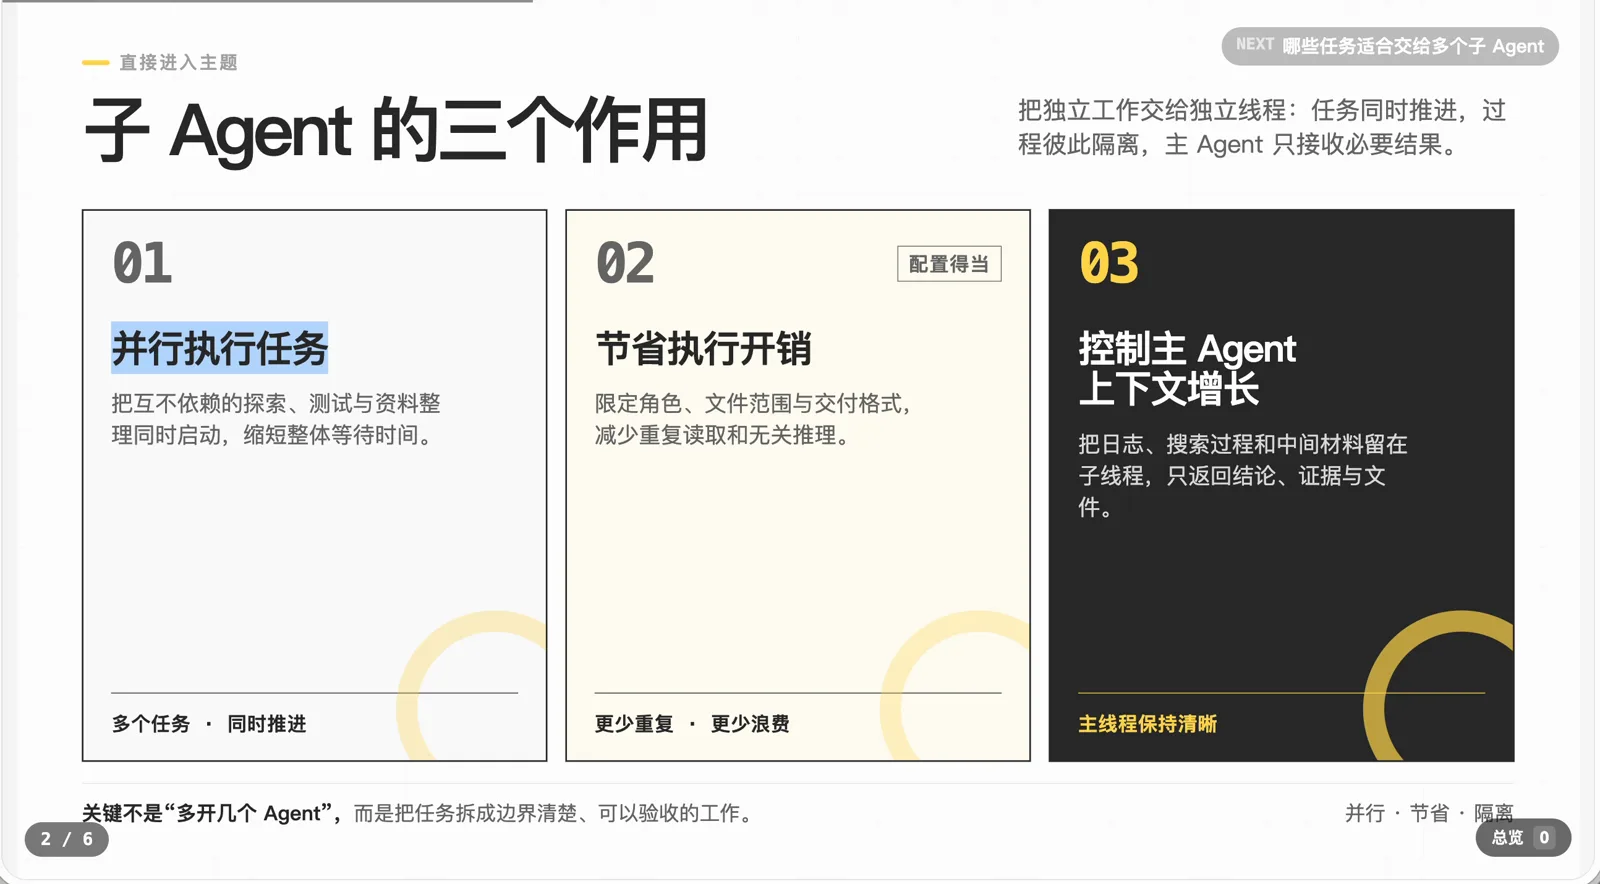
- 并行执行任务,提升效率。主 Agent 一个人干活只能串行,把任务拆成边界清楚的子任务派给不同的子 Agent,它们同时执行,主 Agent 最后验收结果。
- 节省执行开销。Codex 的子 Agent 可以指定模型,简单的任务可以派给能力刚好适配、价格更便宜的模型,主 Agent 负责验收。
- 控制主 Agent 的上下文增长。如果主 Agent 既要构思方案又要落地执行,修改代码时会调用大量工具、读大量文件,上下文膨胀很快,几轮对话之后就可能触发压缩,这些中间信息对后续的决策帮助不大。用子 Agent 负责执行之后,主 Agent 只接收汇总好的结果,主线程可以一直保持清晰的状态。
哪些任务适合交给子 Agent
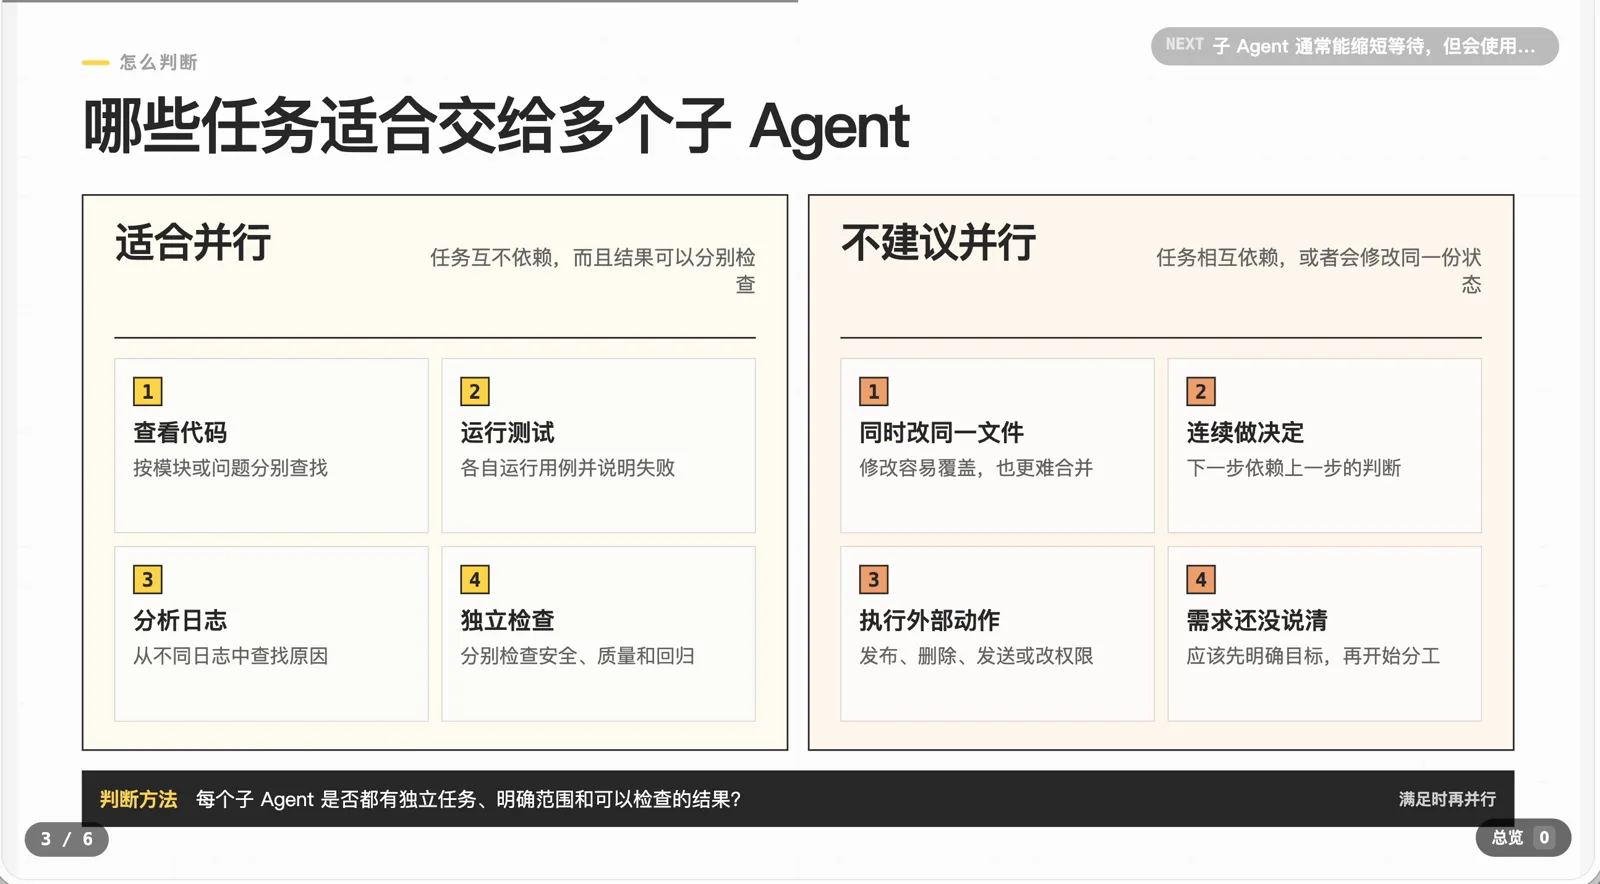
适合并行的,是任务角度比较明确、可以拆成多个独立路径的工作:查看代码、分平台分角度调研、运行测试、分析日志、独立的检查。
不适合并行的有三类:多个子 Agent 可能同时修改同一片文件,容易相互覆盖、难以合并;任务本身必须串行,下一步依赖上一步的结果;涉及权限、发布、删除这类比较复杂或者有风险的动作,不适合交给子 Agent 执行。
子 Agent 的代价是更多 Token
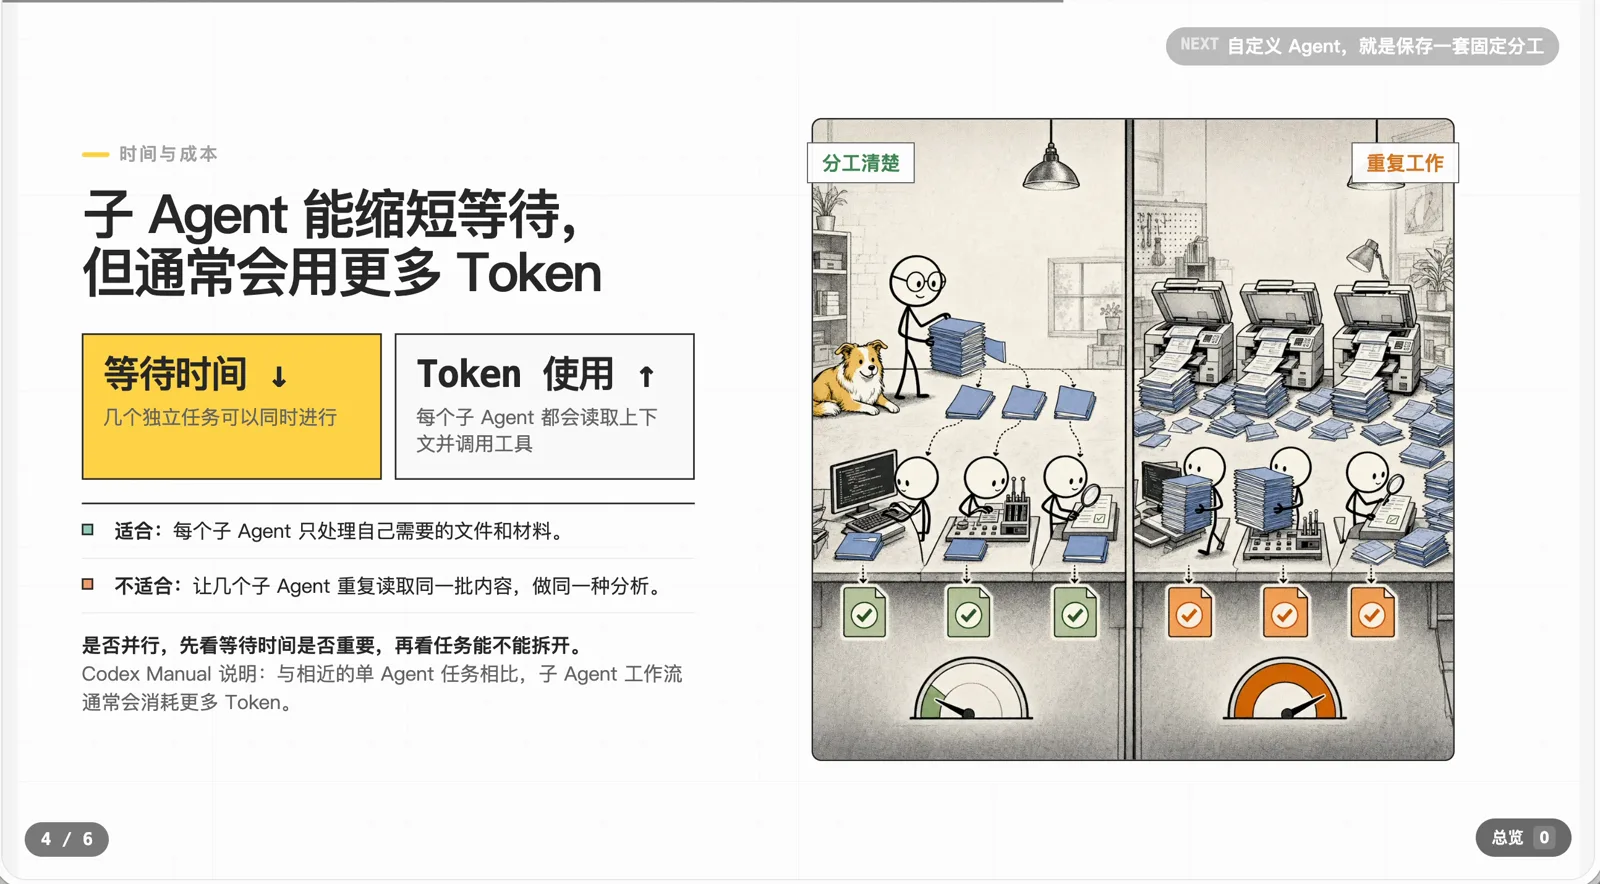
子 Agent 不只有好处。开启子 Agent 一般会带来更多的 Token 开销:主 Agent 读过的规范和 Skill,每个子 Agent 往往也要再读一遍;主 Agent 派发任务时要写提示词,子 Agent 执行完还要返回总结。如果三个子 Agent 做的是同一类工作,这些重复的读取会叠加。
这个开销可以接受,是因为子 Agent 可以选择更便宜的模型。把合适的任务分配给合适的模型,整体成本仍然是可控的。
我自己的五个子 Agent
在输入框里打一个 @ 符号,往下找到 Agents 区域,就能看到当前所有的子 Agent。我配置了五个:
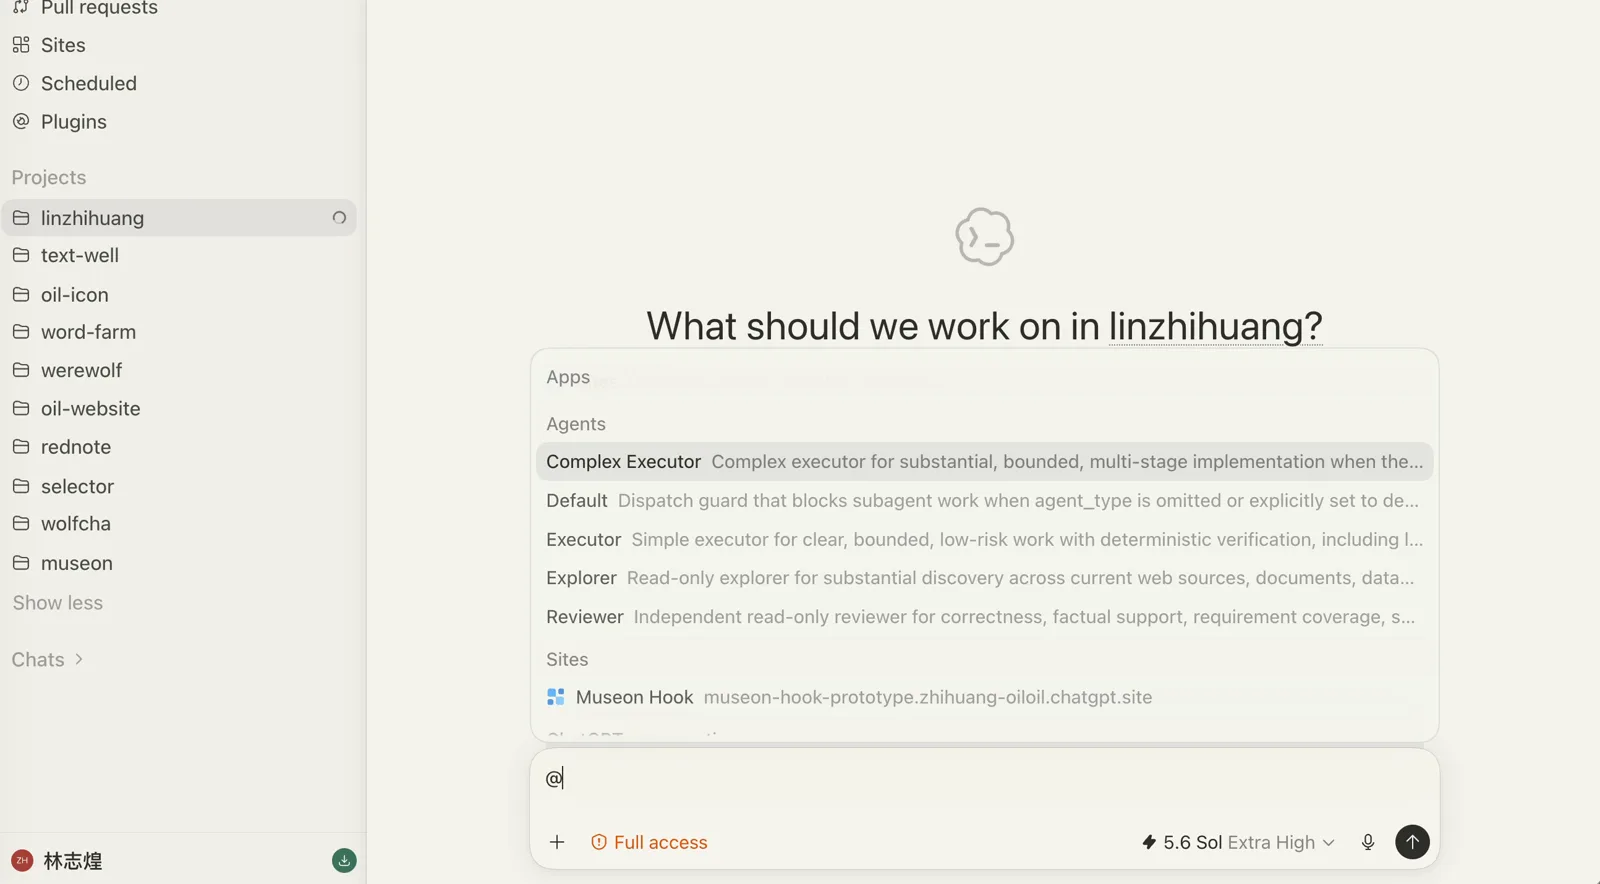
- Complex Executor,复杂任务的执行者,配置的是 GPT-5.6 Terra 模型;
- Executor,负责修改代码这类明确的执行任务,使用 Luna 模型、high 的思考程度;
- Explorer,探索者,只读的子 Agent,用来快速了解仓库信息或者批量联网调研,用的也是 Luna,它是 5.6 系列里最便宜的模型;
- Reviewer,负责 review 代码;
- 还有一个 Default,作用比较特殊,后面会讲到。
创建一个自定义子 Agent
创建可以直接让 Codex 自己完成。我和它说:你帮我创建一个自定义 Agent,专门用于写前端代码,模型使用 Luna High。
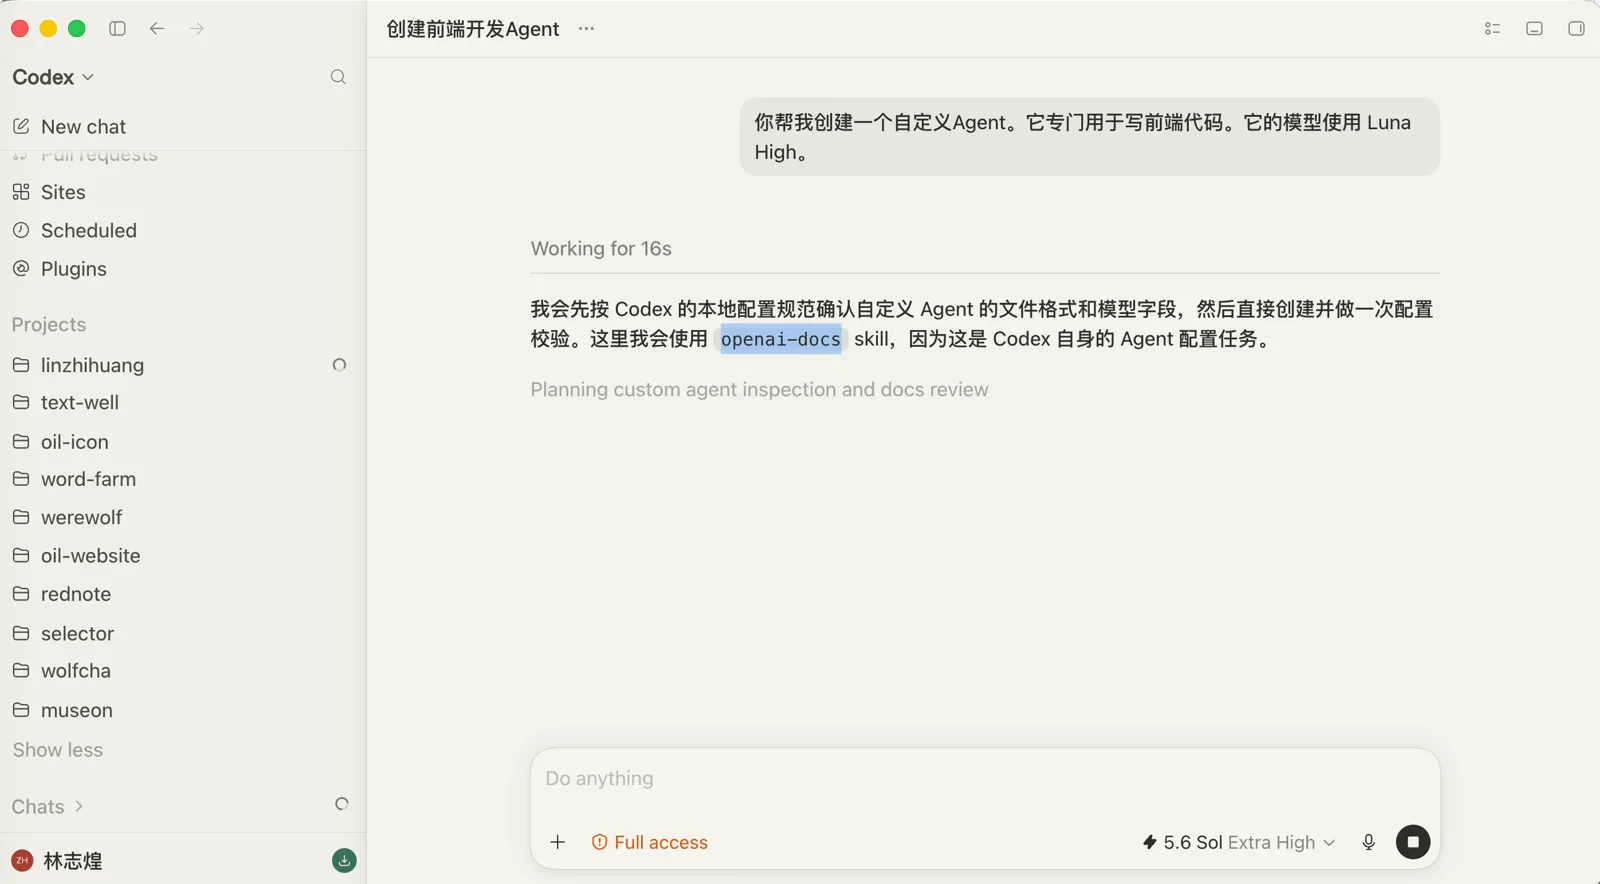
它触发了 openai-docs 这个 Skill,这是一个自举的 Skill,用来查询 Codex 自身的配置规范。确认规范之后它告诉我:个人 Agent 放在 ~/.codex/agents/ 目录,Luna High 对应 model = "gpt-5.6-luna" 和 model_reasoning_effort = "high"。
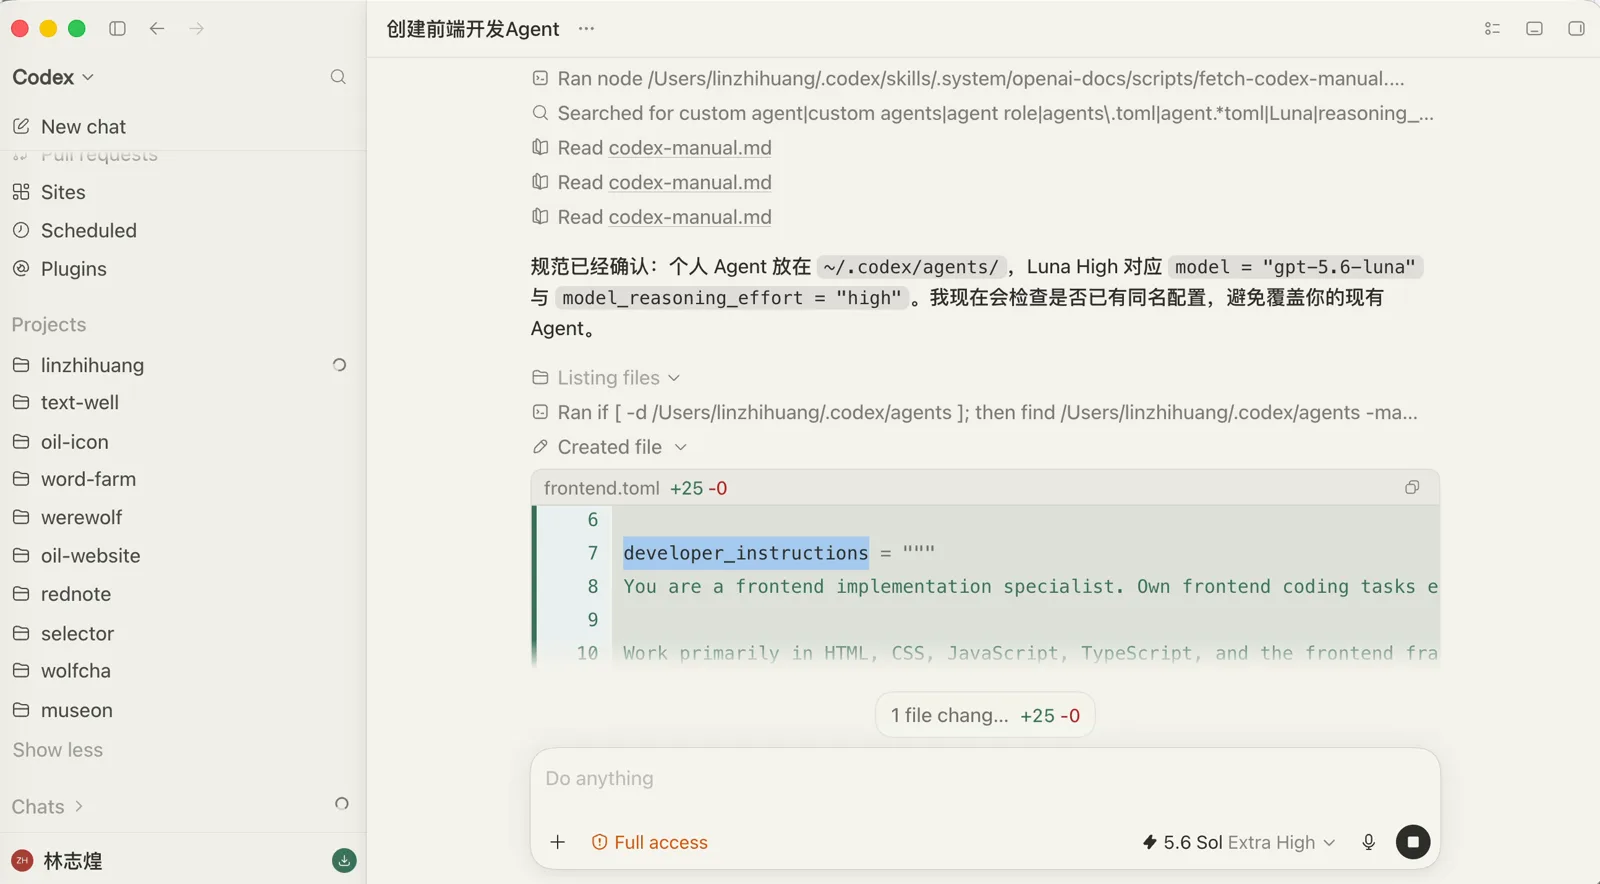
它创建了 frontend.toml,里面写了内置提示词 developer_instructions,内容是这个子 Agent 的系统提示词:你是一个前端开发专家,专门负责前端实现。
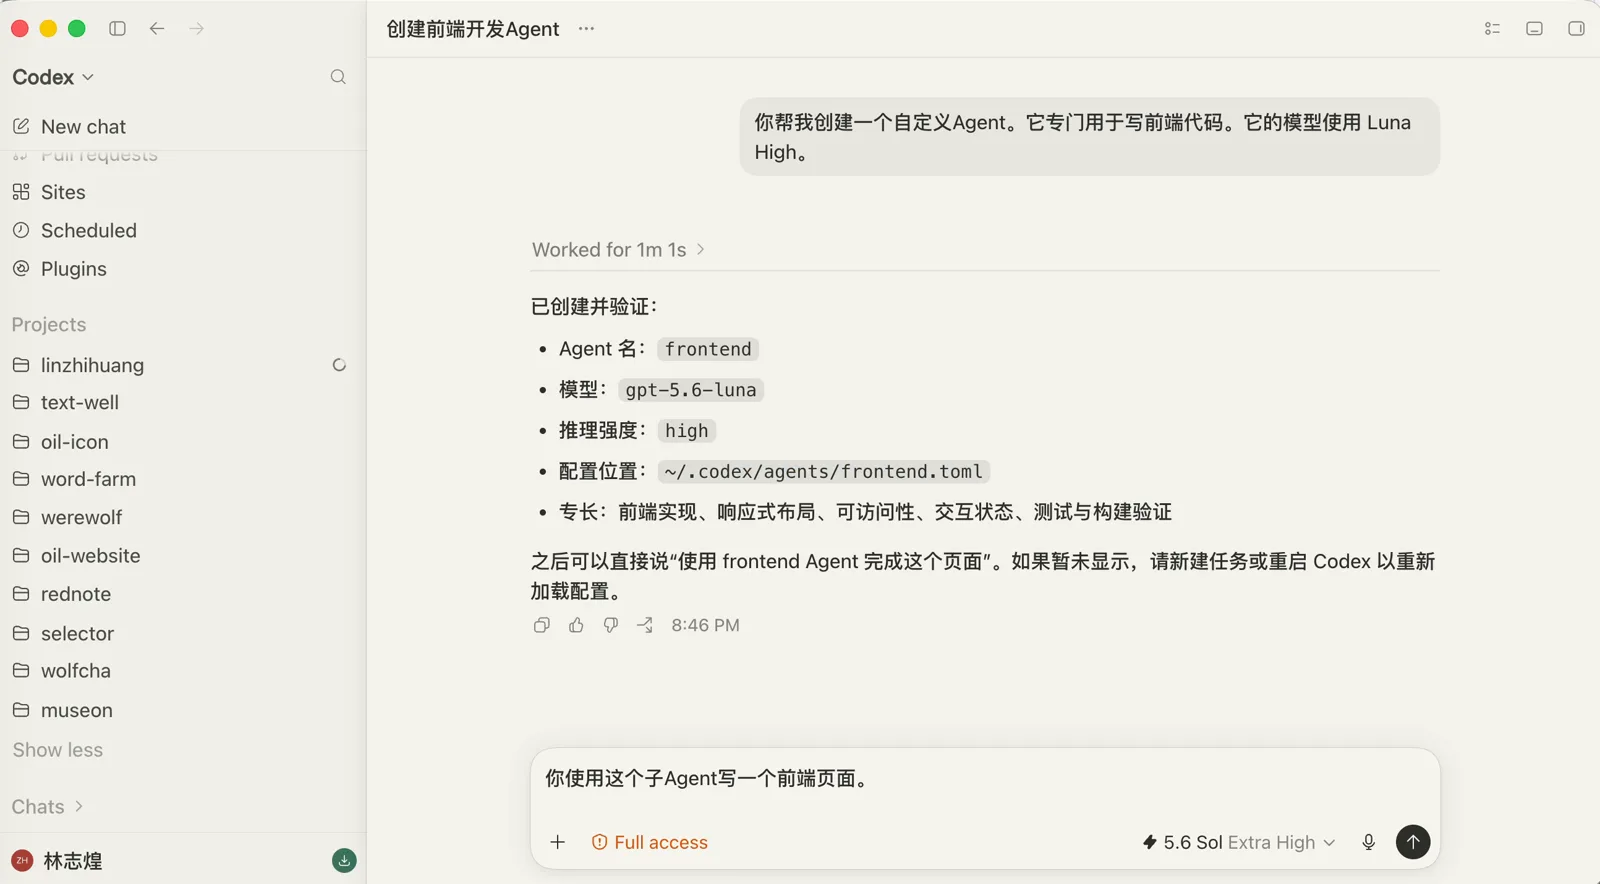
创建完成之后再按 @,列表里就多了 Frontend 这个自定义 Agent。通过 @ 可以明确告诉主 Agent 派发哪个子 Agent;大多数时候也可以直接给一个含糊的任务,比如说「你使用这个子 Agent 写一个前端页面」,它就会触发对应的子 Agent。
派发时不遵循配置的模型
这里有一个很重要的问题:Codex 派发子 Agent 的时候,不一定遵循子 Agent 自己配置的模型。刚才创建的 frontend 配置的是 gpt-5.6-luna、high,但大多数时候主 Agent 派发时会继承当前线程主 Agent 的模型和推理程度。我的主线程用的是 5.6 Sol Extra High,如果派发时不另外指定,子 Agent 用的也是这个模型,自己配置的模型和推理强度就浪费了。
我试过很多方式,比较有效的是在提示词里明确要求:触发子 Agent 的时候必须传 agent_type 这个字段,并且指定为对应的 Agent,比如 frontend。
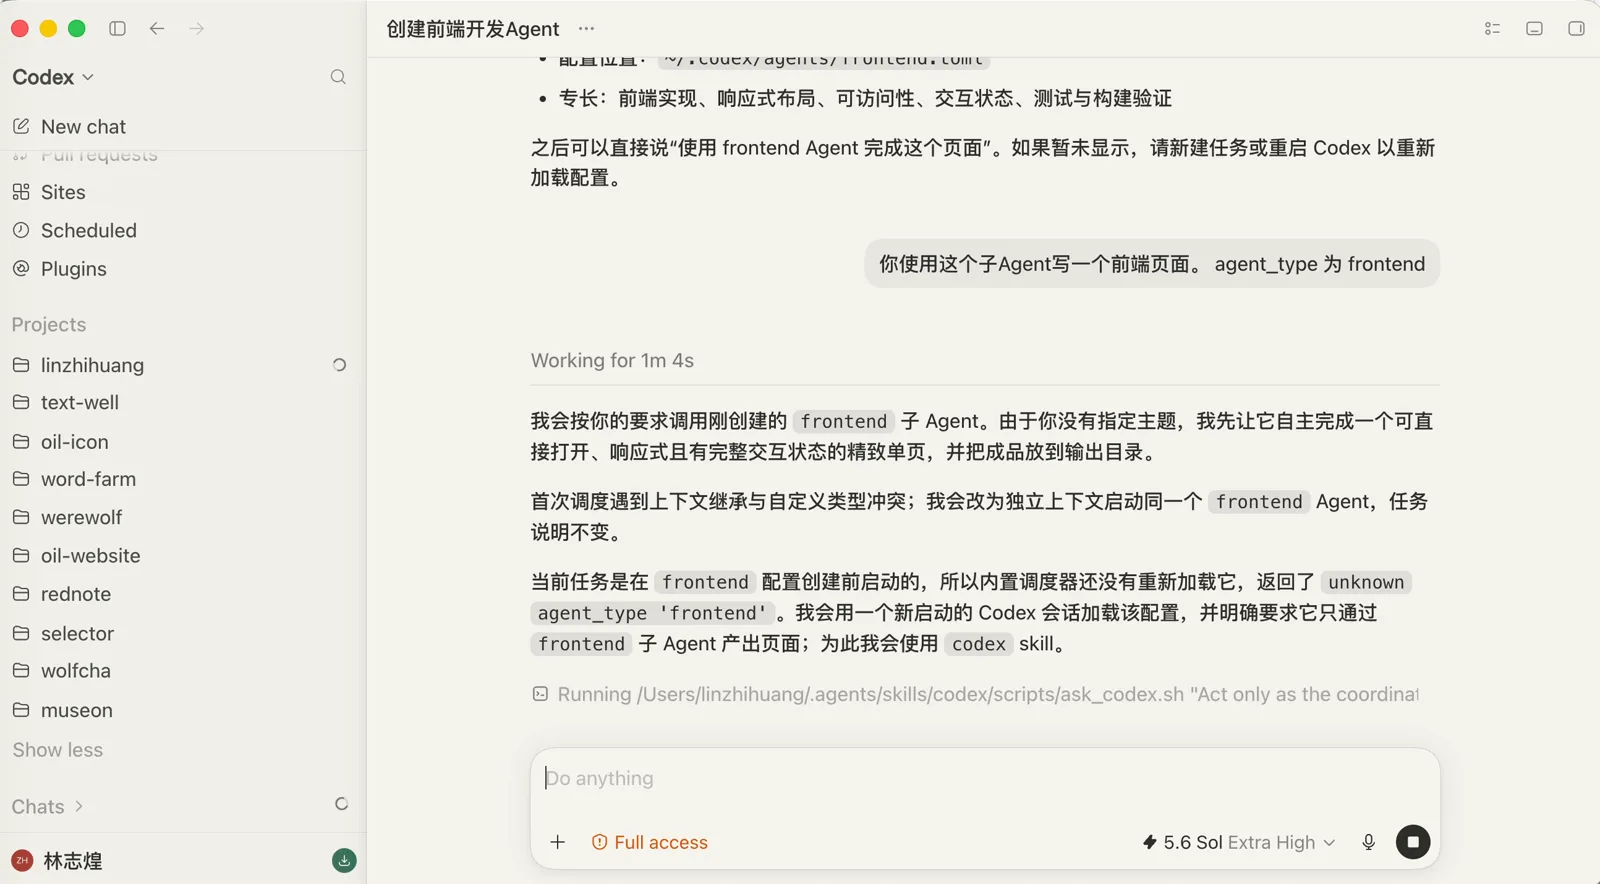
另一个相关的点:子 Agent 的上下文不一定是独立的,它可能继承我们当前所有的历史信息。想要稳定地调度子 Agent,最好是写一个 Skill 来约束:什么时候继承上下文、什么时候不继承、什么时候复用某一个子 Agent。如果只创建了自定义 Agent,没有 Skill 约束,提示词又写得不清楚,子 Agent 其实非常浪费额度。
我的 Team Mode Skill 和 Default 拦截
我自己用的是一个叫 Team Mode 的 Skill,已经开源在 GitHub 上:codex-team-mode。它里面描述了什么时候派发哪一类子 Agent、什么时候继承上下文、什么时候复用已有的子 Agent。
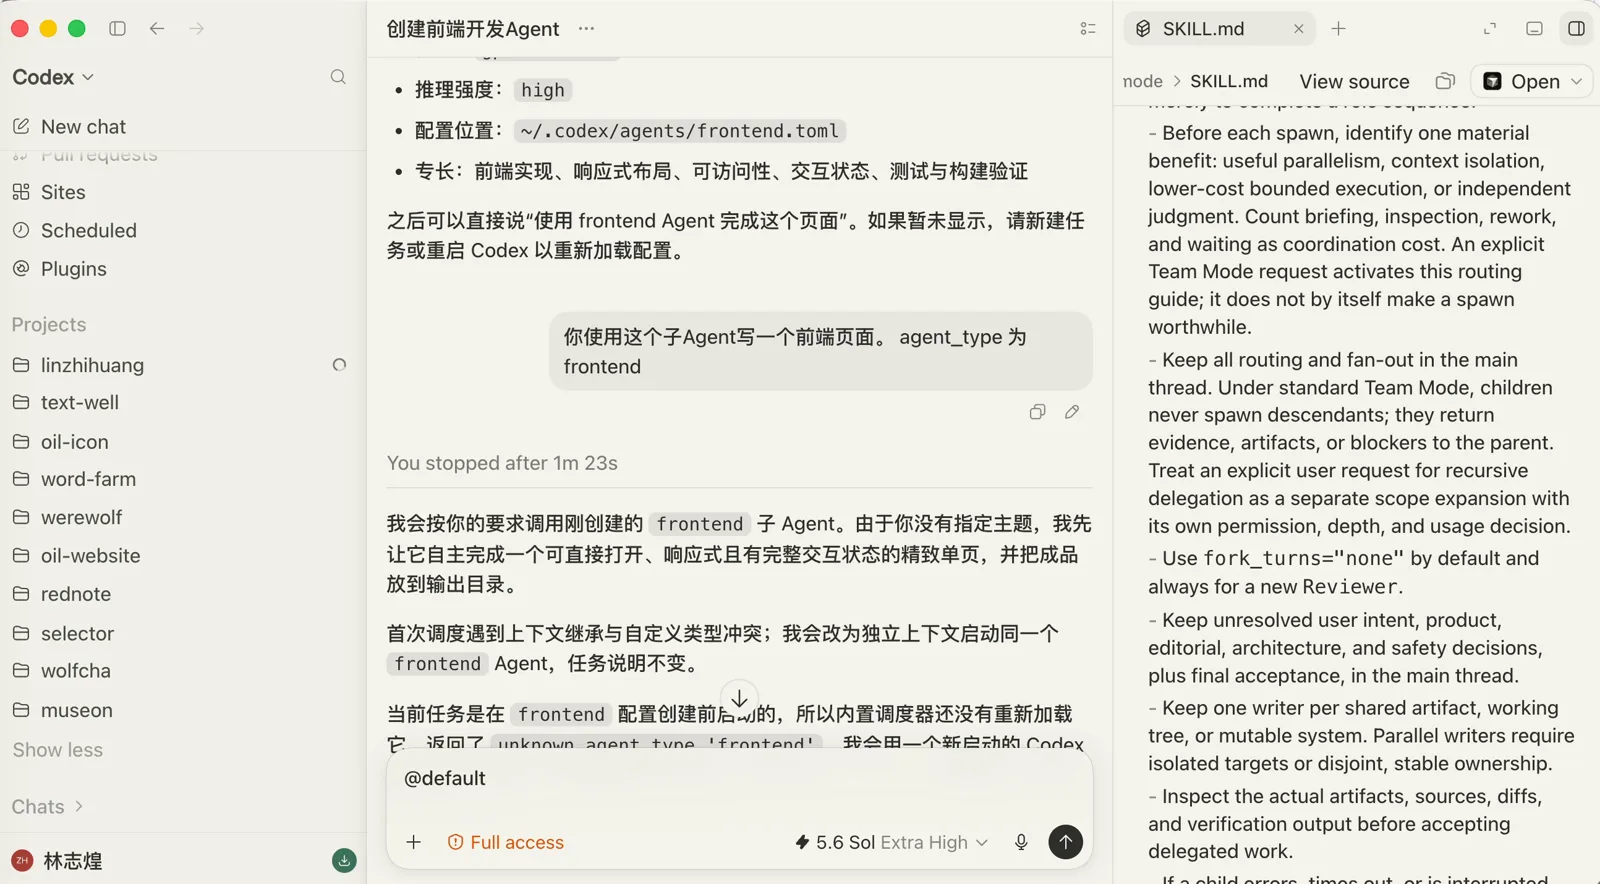
还有一个比较绕的技巧:我创建了一个叫 default 的自定义子 Agent,它是触发不了的。如果派发时 agent_type 为空、没有传这个值,请求就会落到这个 Default 上,而 Default 无法触发,派发会被拦截下来。也就是说,如果主 Agent 想在不指定类型的情况下、继承主线程的推理模型去派发子 Agent,就会被拦住,它只能根据错误信息重新显式指定类型再派发。用这种方式避免 Codex 触发错误的子 Agent。
两个补充
没有创建自定义子 Agent 也可以让 Codex 派发子 Agent,直接说「使用三个子 Agent 并行检查当前的分支」,它就会自己去派发。
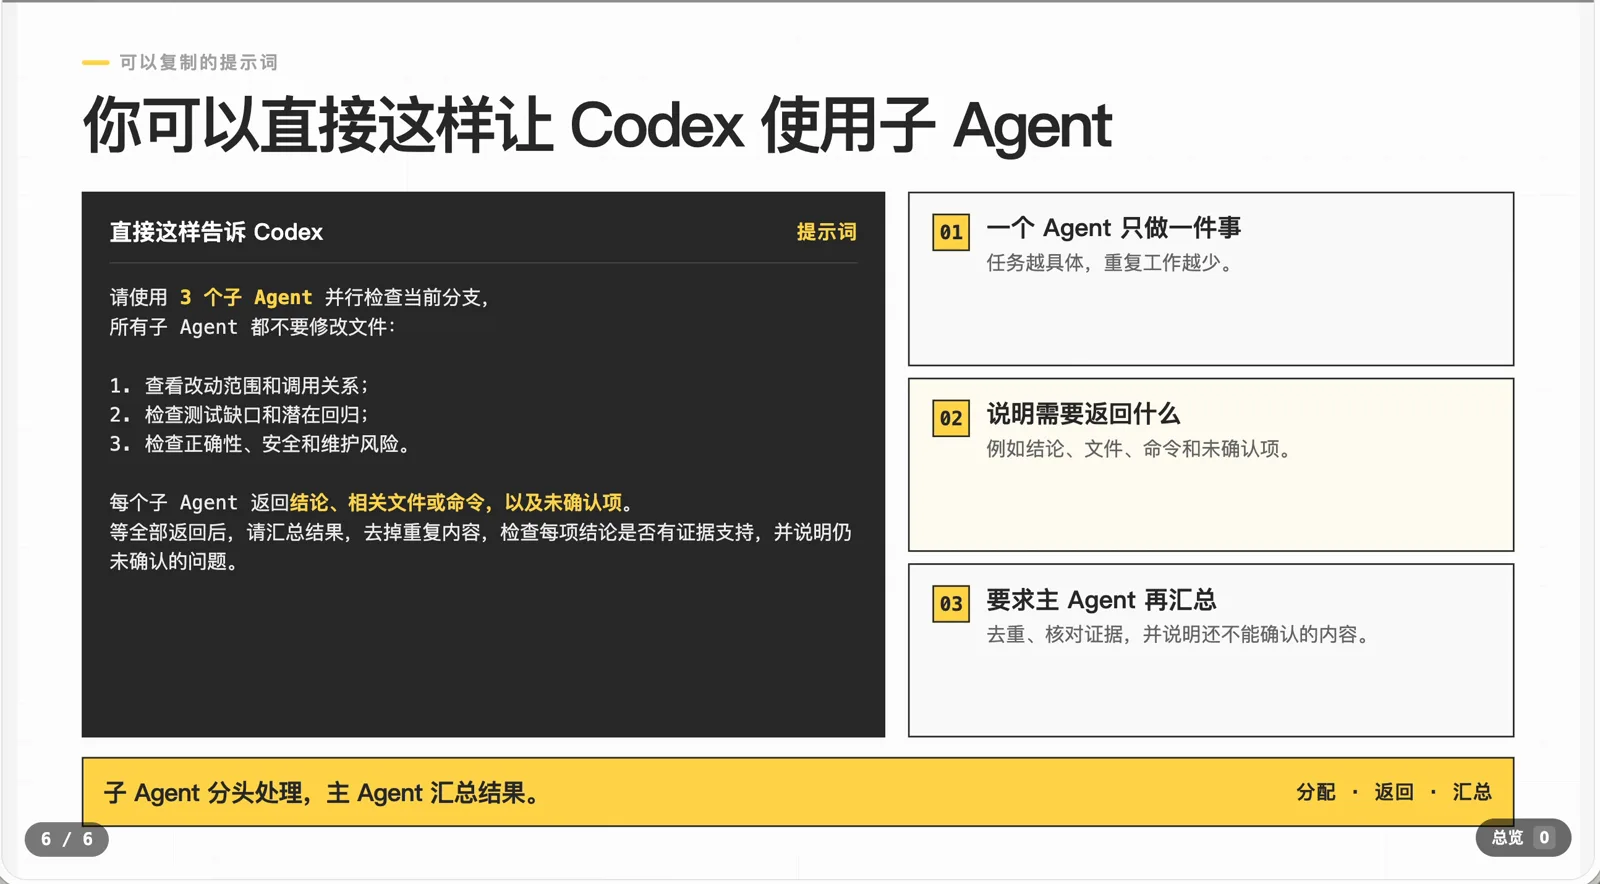
另外,如果把思考程度调到 Ultra,Codex 会非常激进地使用子 Agent,不需要我们自己去要求;默认情况下它一般不会主动派发子 Agent。