这期分享 Codex 里面子 Agent 的机制,以及我自己的使用方式。
子 Agent 主要解决的是上下文问题。Codex 默认的 GPT-5.5 不支持 100 万上下文,输入大约 20 万就会触发压缩。如果代码仓库比较大,读一轮代码可能就有 10 万上下文输入,两次对话之后就开始压缩,压缩之后它的回答会出现一些漂移。
这种情况下可以先用子 Agent 探索代码。子 Agent 负责找到代码的具体位置并详细查看,把结论返回给主 Agent,主 Agent 的上下文输入就会少很多,少走一些弯路。另外一个用法是并行:如果有三个功能要同时执行,可以启动三个互不相关的子 Agent 分别处理,不会冲突。
这里有一个判断标准:如果一个任务会产生大量的中间信息,但最终只需要一个摘要,那它就适合交给子 Agent。
Codex 不会主动启动子 Agent
Codex 内置了一组管理子 Agent 的工具:启动子 Agent、等待子 Agent 返回、给运行中的子 Agent 追加指令、关闭已经完成的子 Agent,以及复用某一个子 Agent。
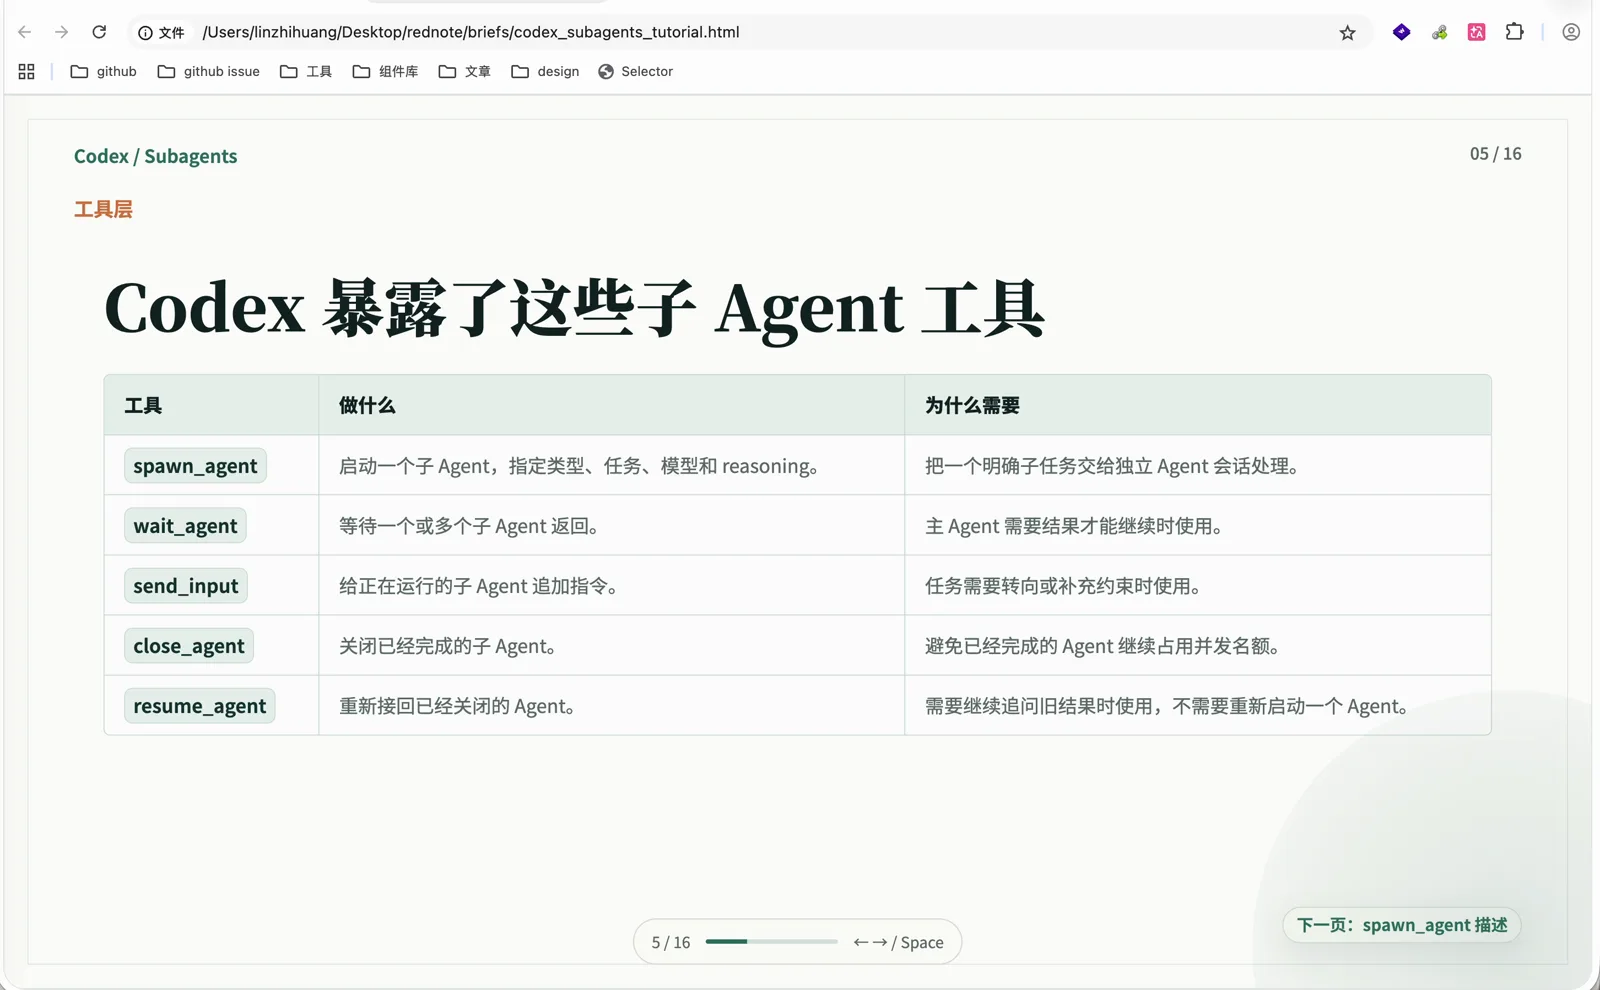
需要注意的是,Codex 默认不会启动子 Agent,这一点写在它的工具调用提示词里面。只有用户明确说「你必须调用子 Agent 做什么事情」,它才会调用,它不会根据任务情况自己判断。这和 Claude Code 很不一样,Claude Code 会比较激进地调用探索代码这一类的子 Agent。
启动一个子 Agent 的实际过程
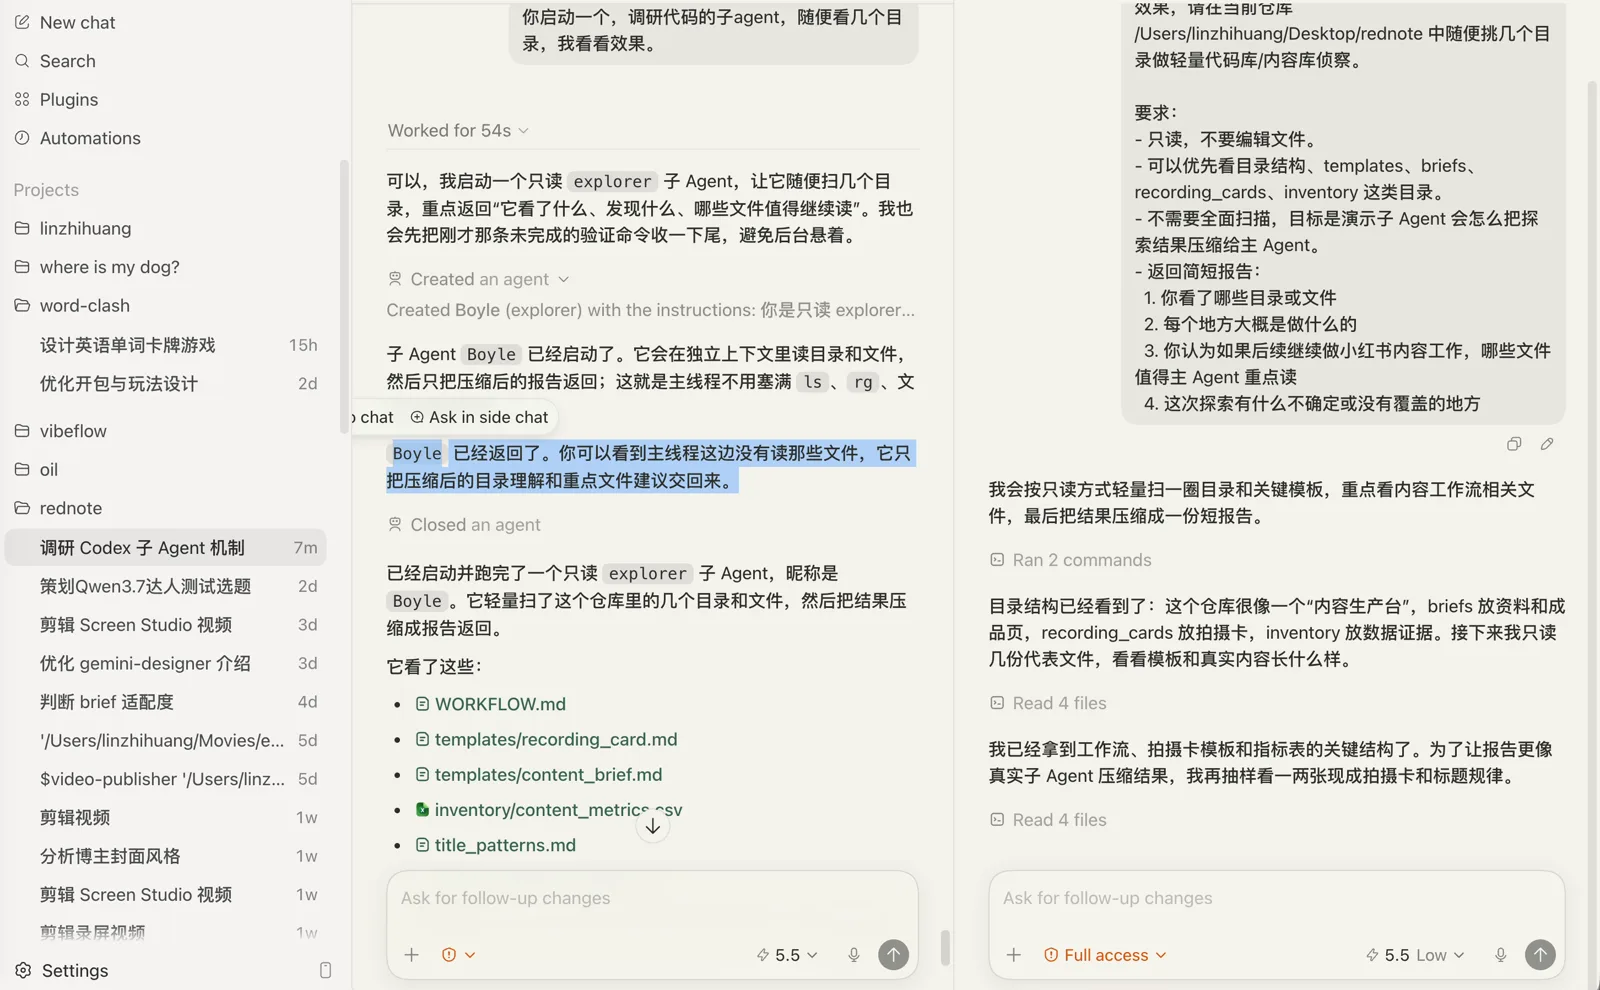
我给 Codex 输入「你启动一个调研代码的子 Agent,随便看几个目录」,它就会调用工具创建一个子 Agent。
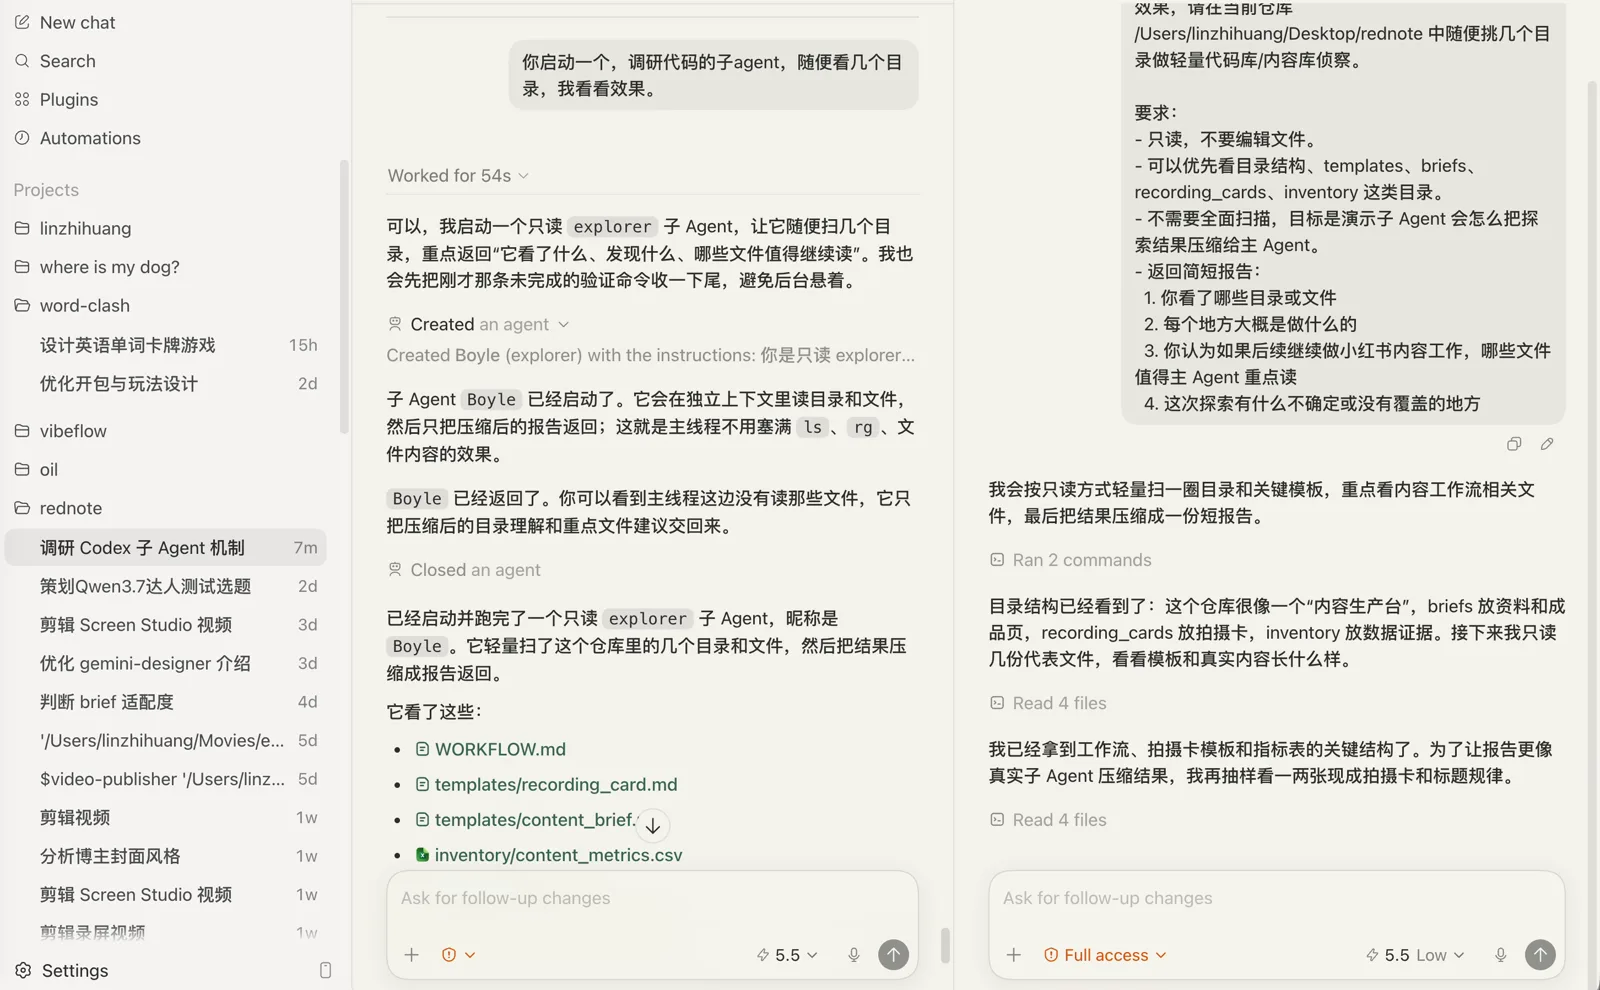
创建之后,点击主线程里灰色的子 Agent 名字,可以看到它使用的模型和子 Agent 类型,这里用的是 GPT-5.5,类型是探索代码的 explorer。点击之后右侧会打开一个侧边栏,侧边栏的第一段提示词是 Codex 写给子 Agent 的,我们不直接和子 Agent 交流。
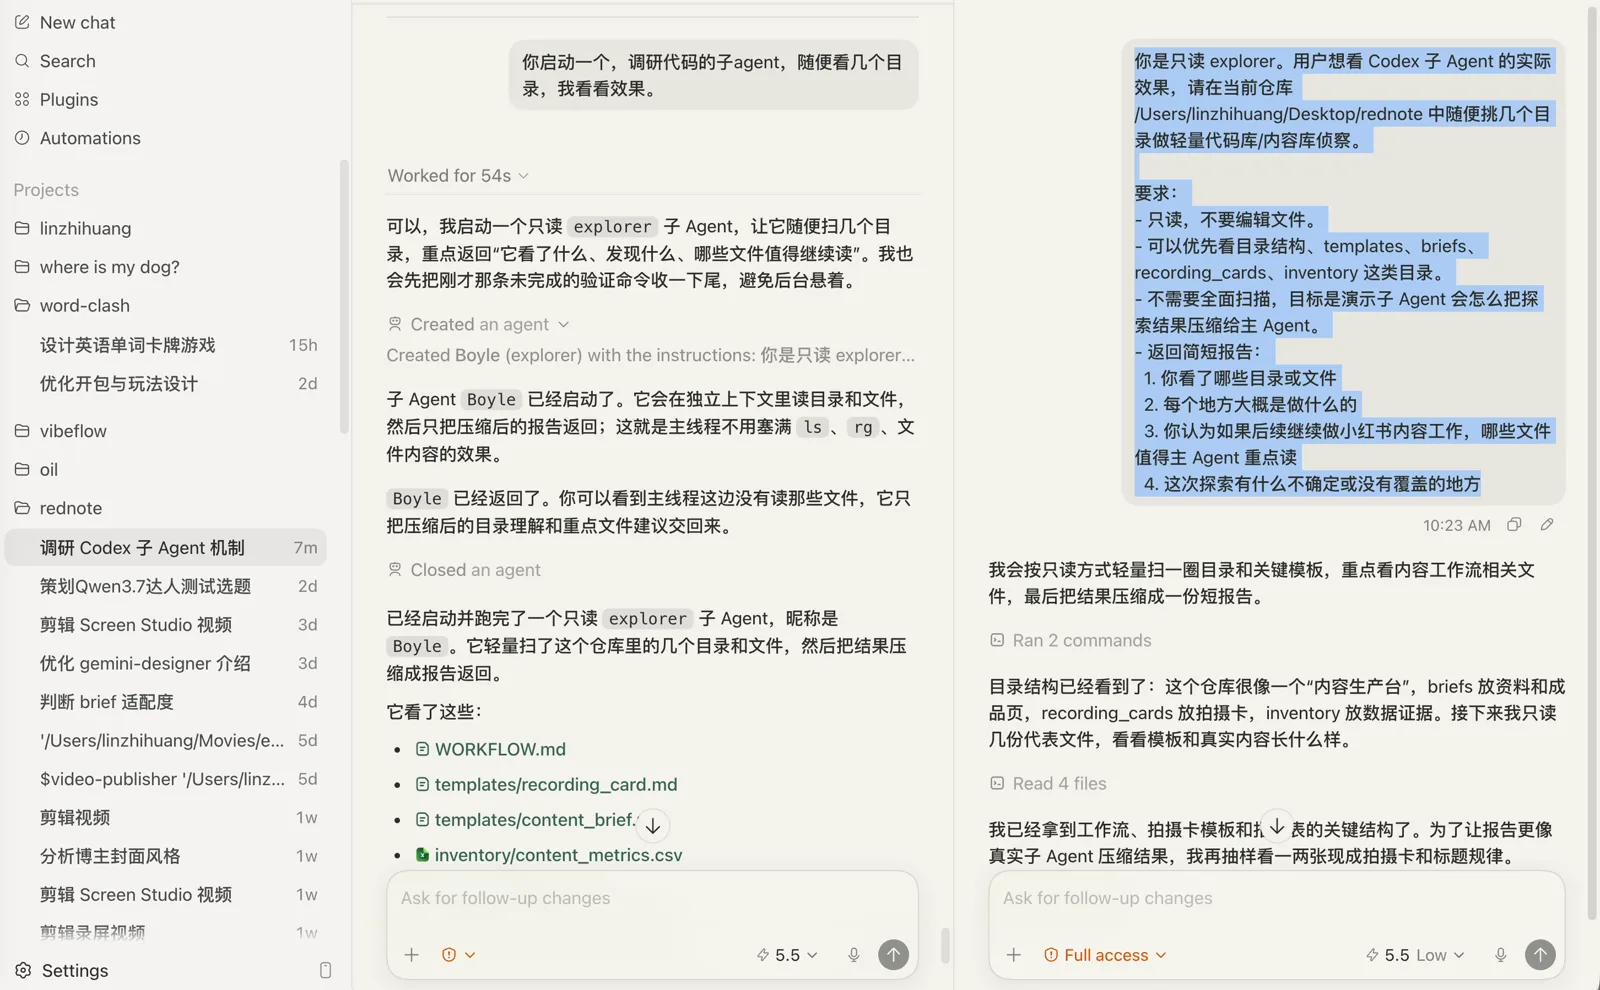
子 Agent 扫描完代码仓库之后,会把结果返回给主线程。从界面上可以看到,主线程这边没有读那些文件,它只拿到了子 Agent 压缩后的目录理解和重点文件建议。
创建子 Agent 时可以指定的参数
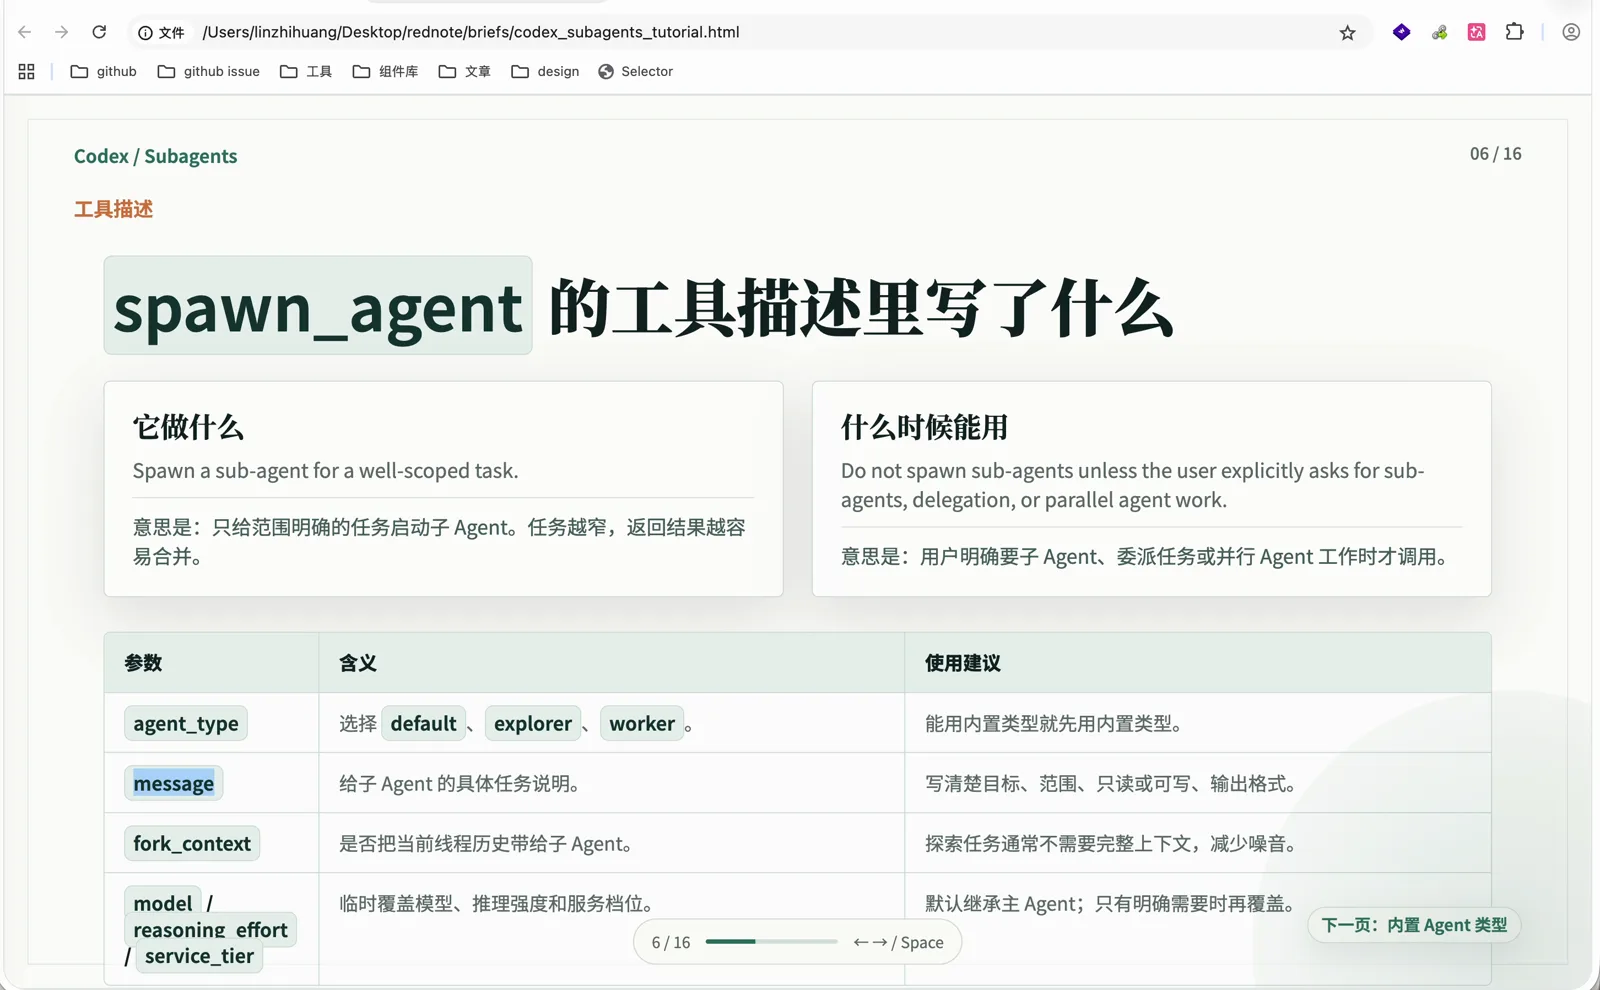
创建子 Agent 的工具支持几个参数:
- 子 Agent 的类型,内置的有 default、explorer、worker;
- 发给子 Agent 的第一条消息,也就是任务说明;
- 是否把当前线程的对话历史带给子 Agent;
- 子 Agent 使用的模型、思考程度和服务档位,默认继承主 Agent。
如果主 Agent 前面已经有一部分对话信息,调用子 Agent 时可以把这些上下文一起带过去,这样就不用在提示词里重复写很多内容。
配置分几层
Codex 的子 Agent 有对应的配置文件,分几层管理。
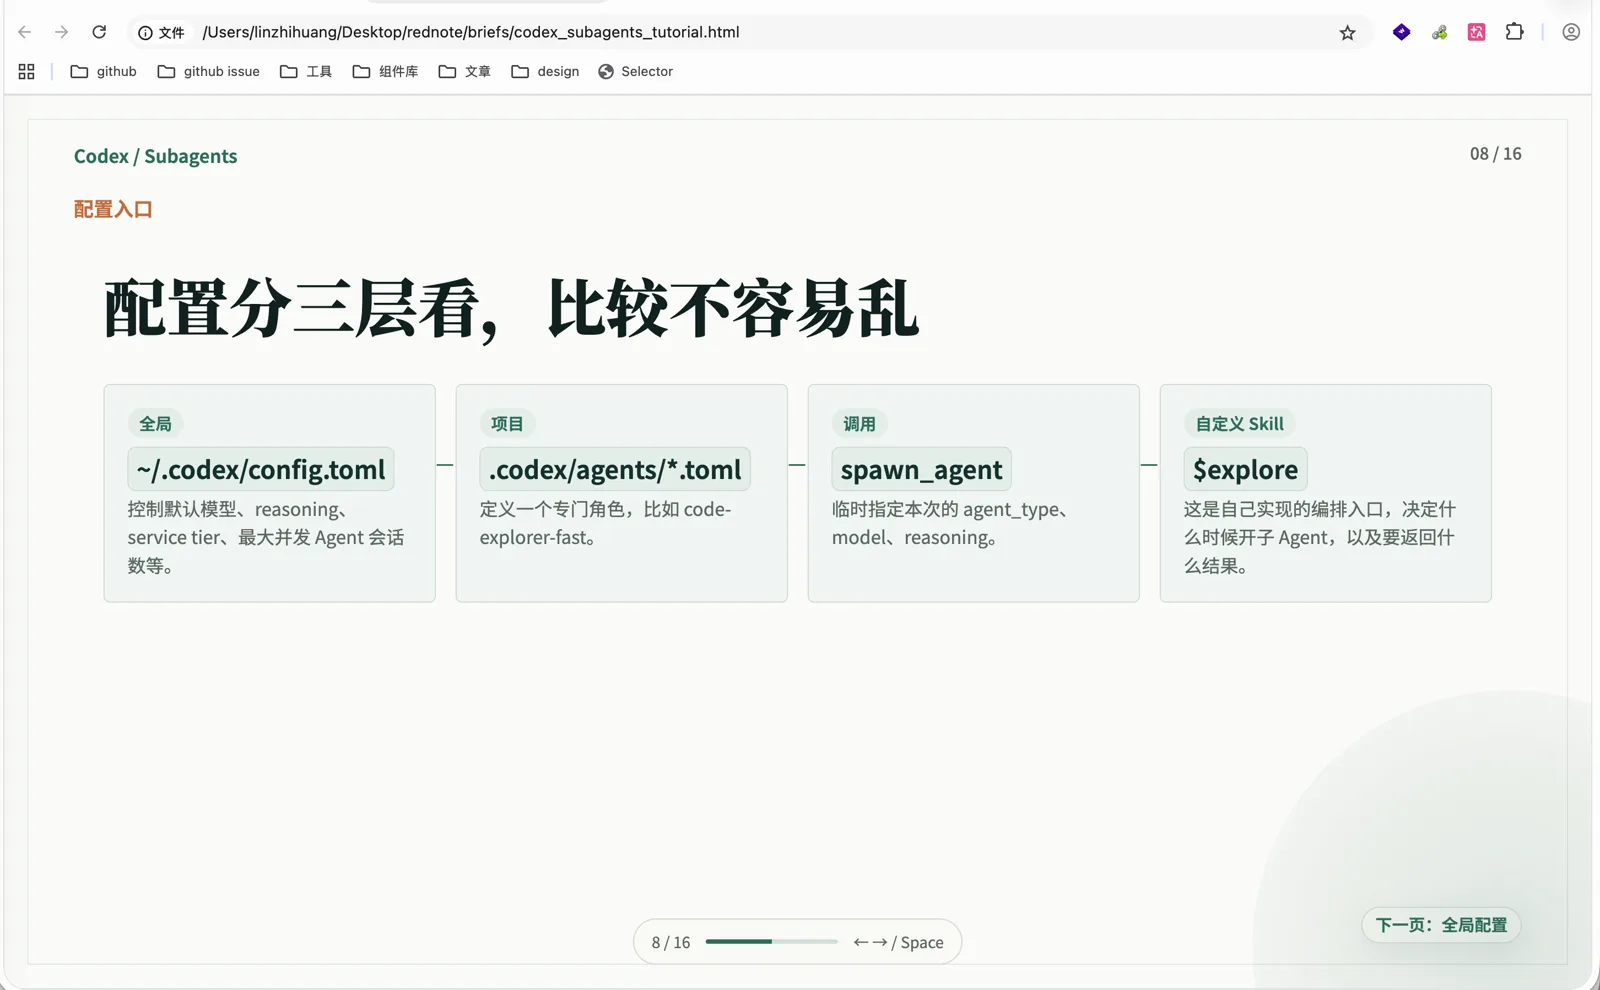
最外面一层是全局配置,控制子 Agent 的默认模型、思考程度和最大并发数量。这个配置可以在 Codex 的设置里找到:点击设置,进入 Settings,再进入 Configuration,就可以查看配置文件。修改配置文件这件事也可以交给 Codex 自己完成,不需要手动编辑。
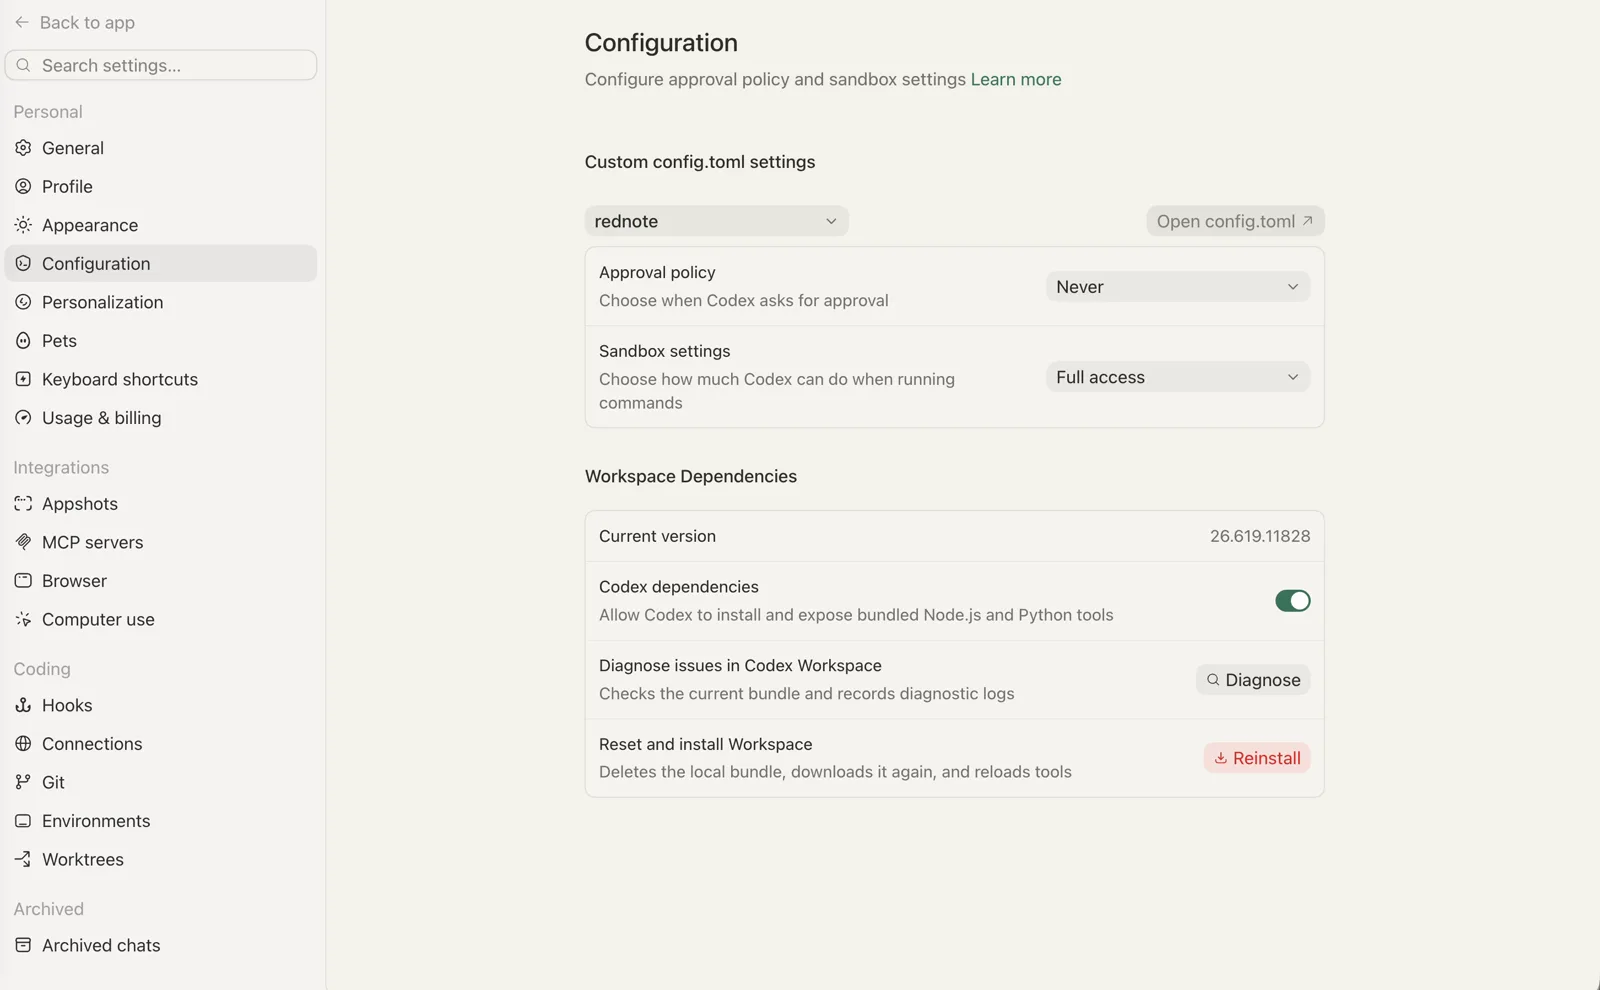
全局配置里还有两个和边界相关的项。一个是最大子 Agent 并发数量,默认是 6 个;另一个是嵌套层级,也就是子 Agent 还能不能继续套娃调用下一层子 Agent。我自己保持默认配置没有改,最多嵌套一层,层数再多实际效果不会更好。
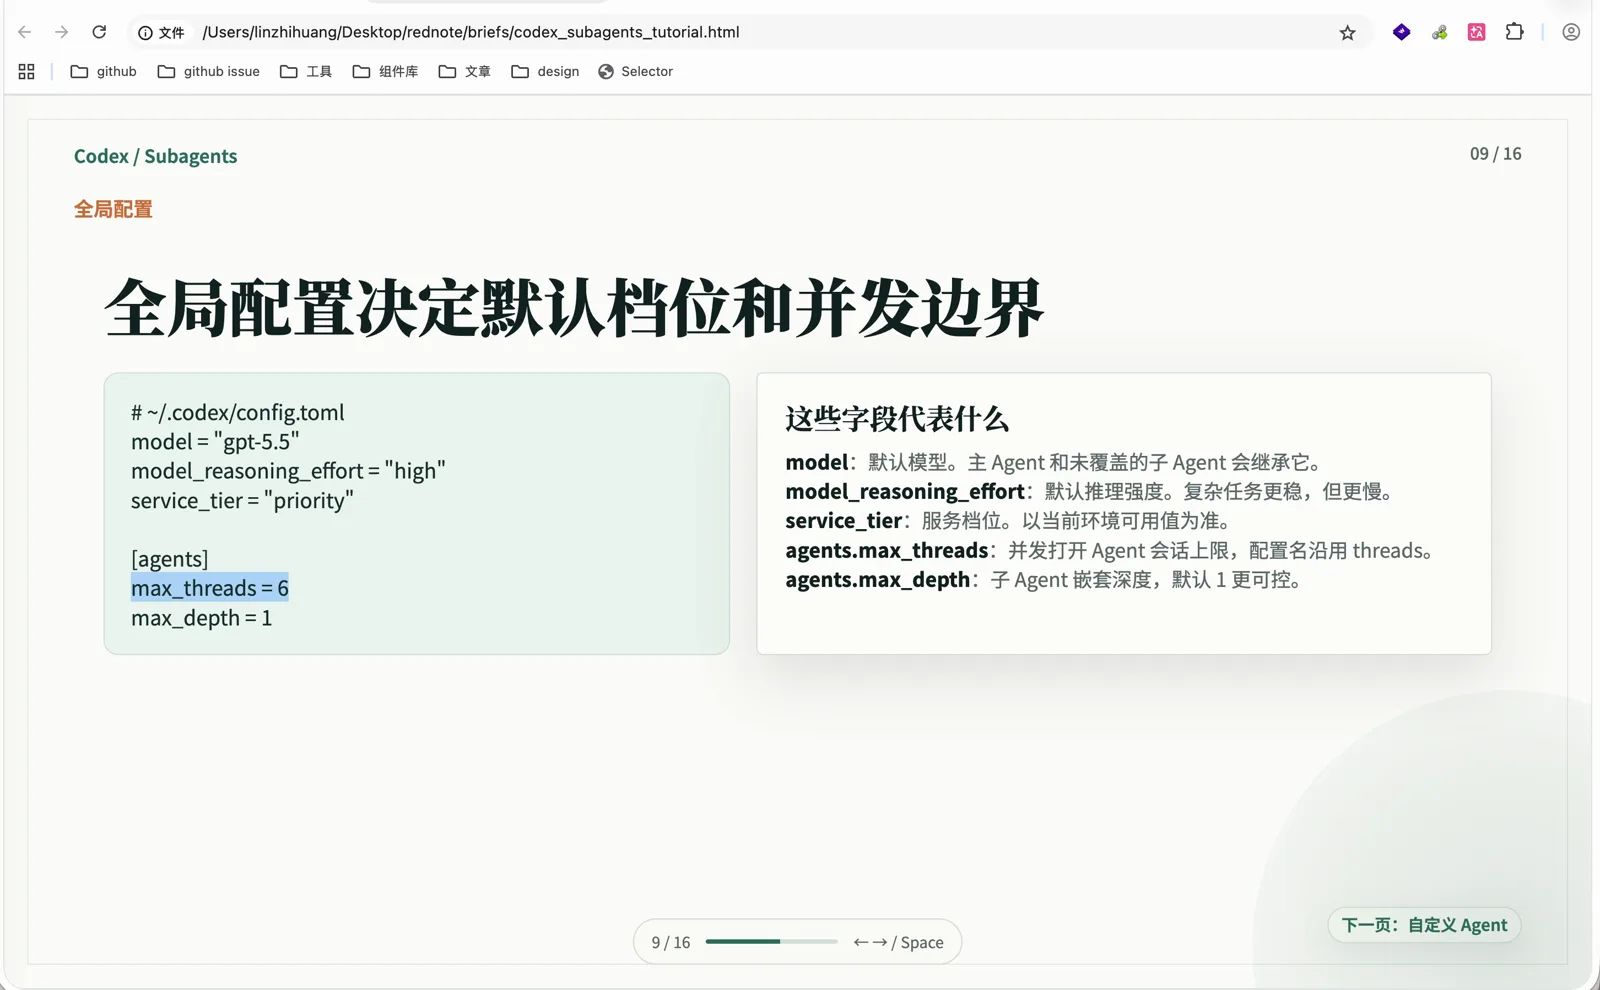
再往里一层是自定义 Agent 的配置文件,每个文件定义一个我们自己写好规范的子 Agent。Codex 内置了探索代码、review 代码、执行工作这几类子 Agent,我们也可以根据自己的项目创建专门的子 Agent,比如专门调研某个平台话题的,或者分别负责前端和后端的。
自定义子 Agent 适合放角色知识
自定义 Agent 文件适合放角色相关的知识。比如我有一个前端的子 Agent,我希望它每次执行任务前都去查看系统里前端相关的规范;后端的子 Agent 只读后端的规范。这样它们都不用阅读很冗长的通用规范。
我自己配置了一个用来探索代码的 Explorer,和系统内置的不一样。它的模型是 GPT-5.4,思考程度是 low,服务档位开了 fast。这个任务对它来说比较简单:生成关键词,找到代码位置,把具体代码的位置和行号响应给主 Agent。比如我要修改某个文件,它找到相关配置并把行号返回,最终还是主 Agent 自己去执行修改。所以它的模型配置可以相对低一些,速度快、开销低。
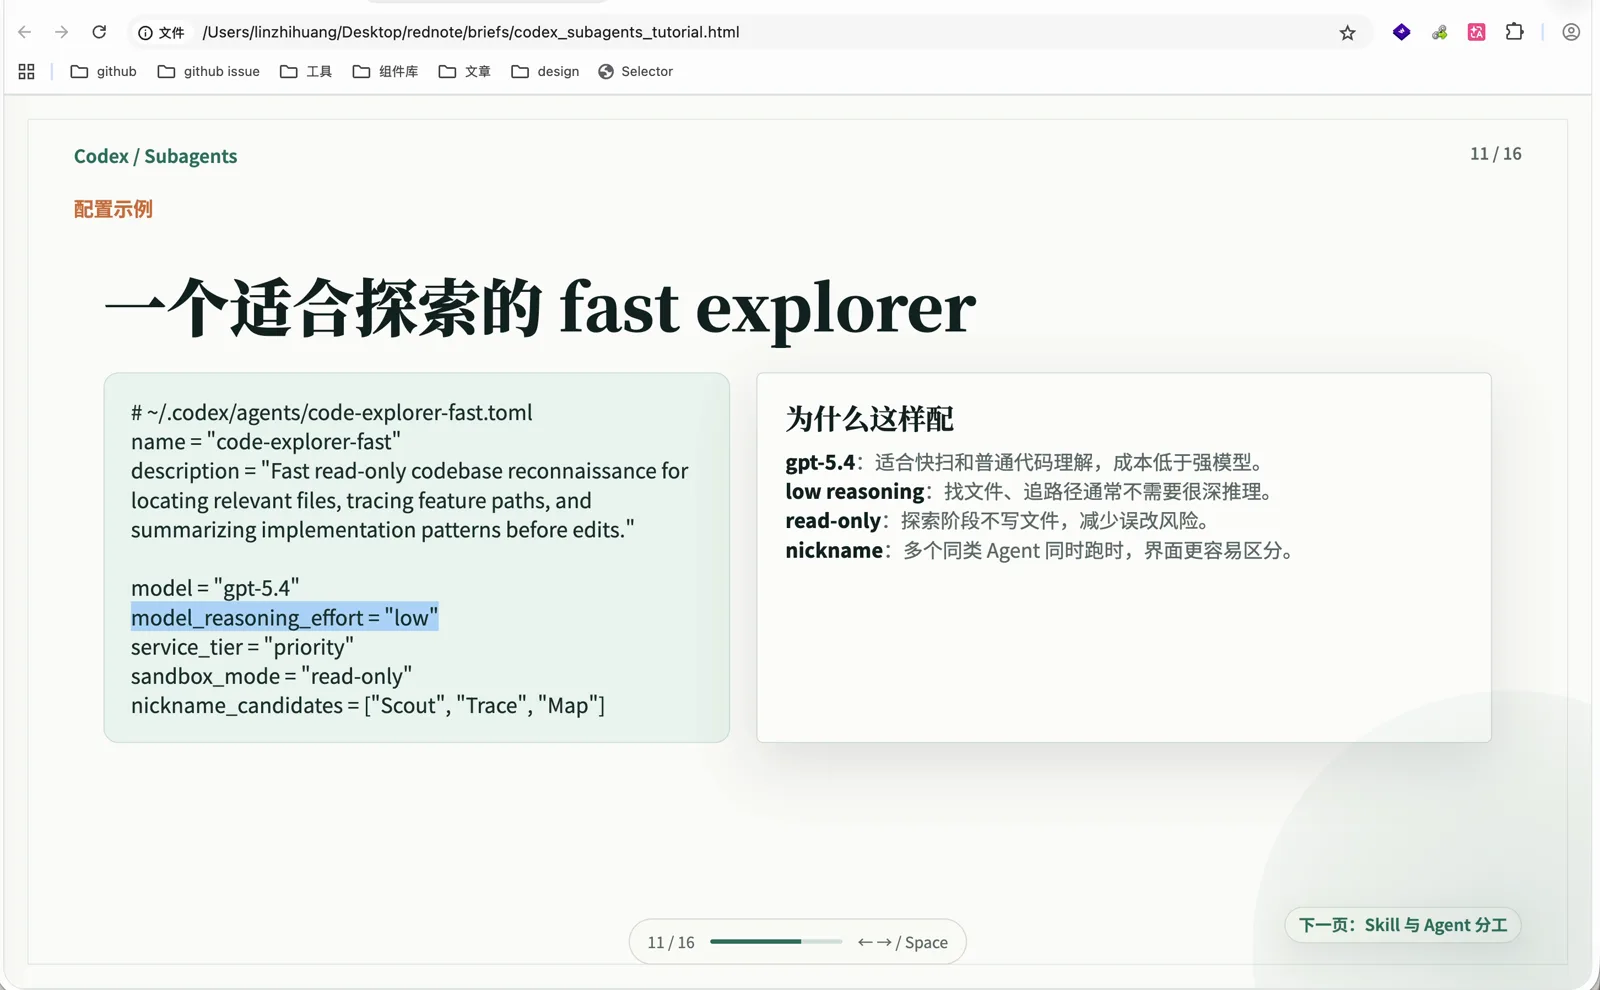
还有一个点:如果想通过 Skill 触发子 Agent,最好把执行相关的规范写在 Agent 的配置文件里,而不是写在 Skill 里。Skill 是主 Agent 读的,写在 Skill 里意味着主 Agent 要把很多提示词发给子 Agent,主 Agent 的输出会变多,占用的上下文也会变大。规范写在子 Agent 里面之后,主 Agent 只需要简单地说「你去看一下某个位置相关的代码」,子 Agent 内置的提示词会指导它怎么工作。
我自己用得最多的 explore Skill
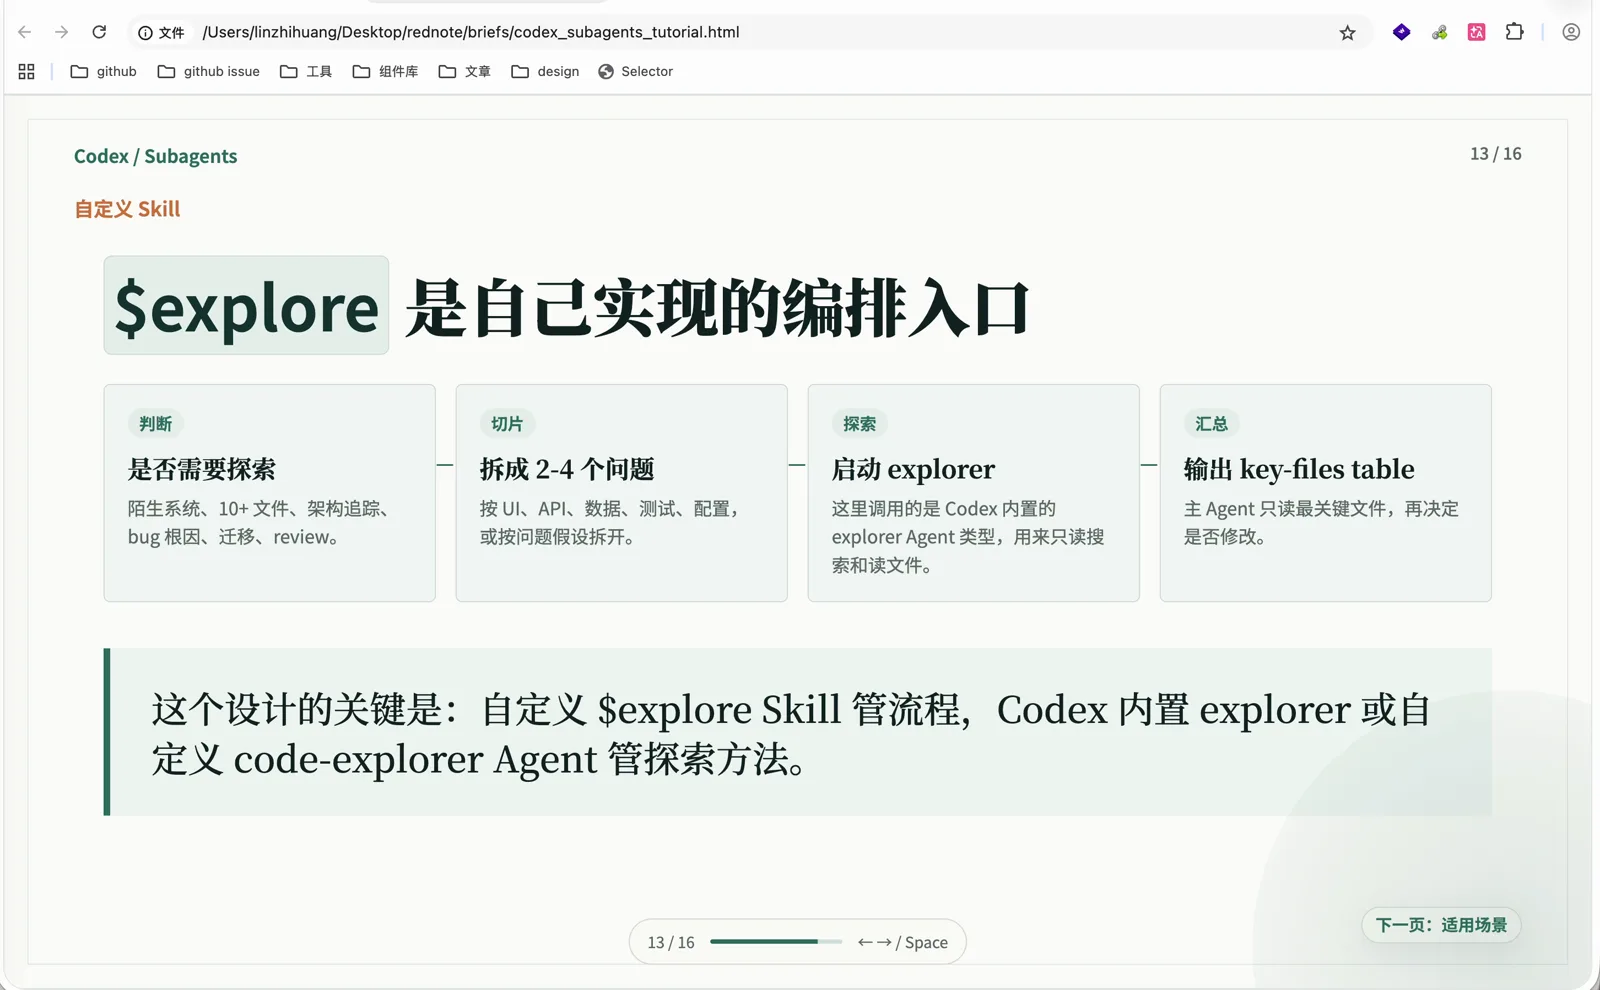
分享一个我日常使用频率最高的 Skill,叫 explore。每次对话开始之前,如果想探索代码,我就会调用它。这个 Skill 已经在 GitHub 开源:codex-explore-skill。
它的作用类似 Claude Code 或者 Cursor 默认探索代码时会启动的子 Agent,但 Codex 不会主动做这件事,所以我写了一个 Skill。调用之后它会并行启动多个子 Agent 去查看相关的代码位置,再把结论汇总给主 Agent。
安装方式是把仓库克隆到 Codex 的 skills 目录:
git clone https://github.com/oil-oil/codex-explore-skill.git ~/.codex/skills/explore
适合交给子 Agent 的场景
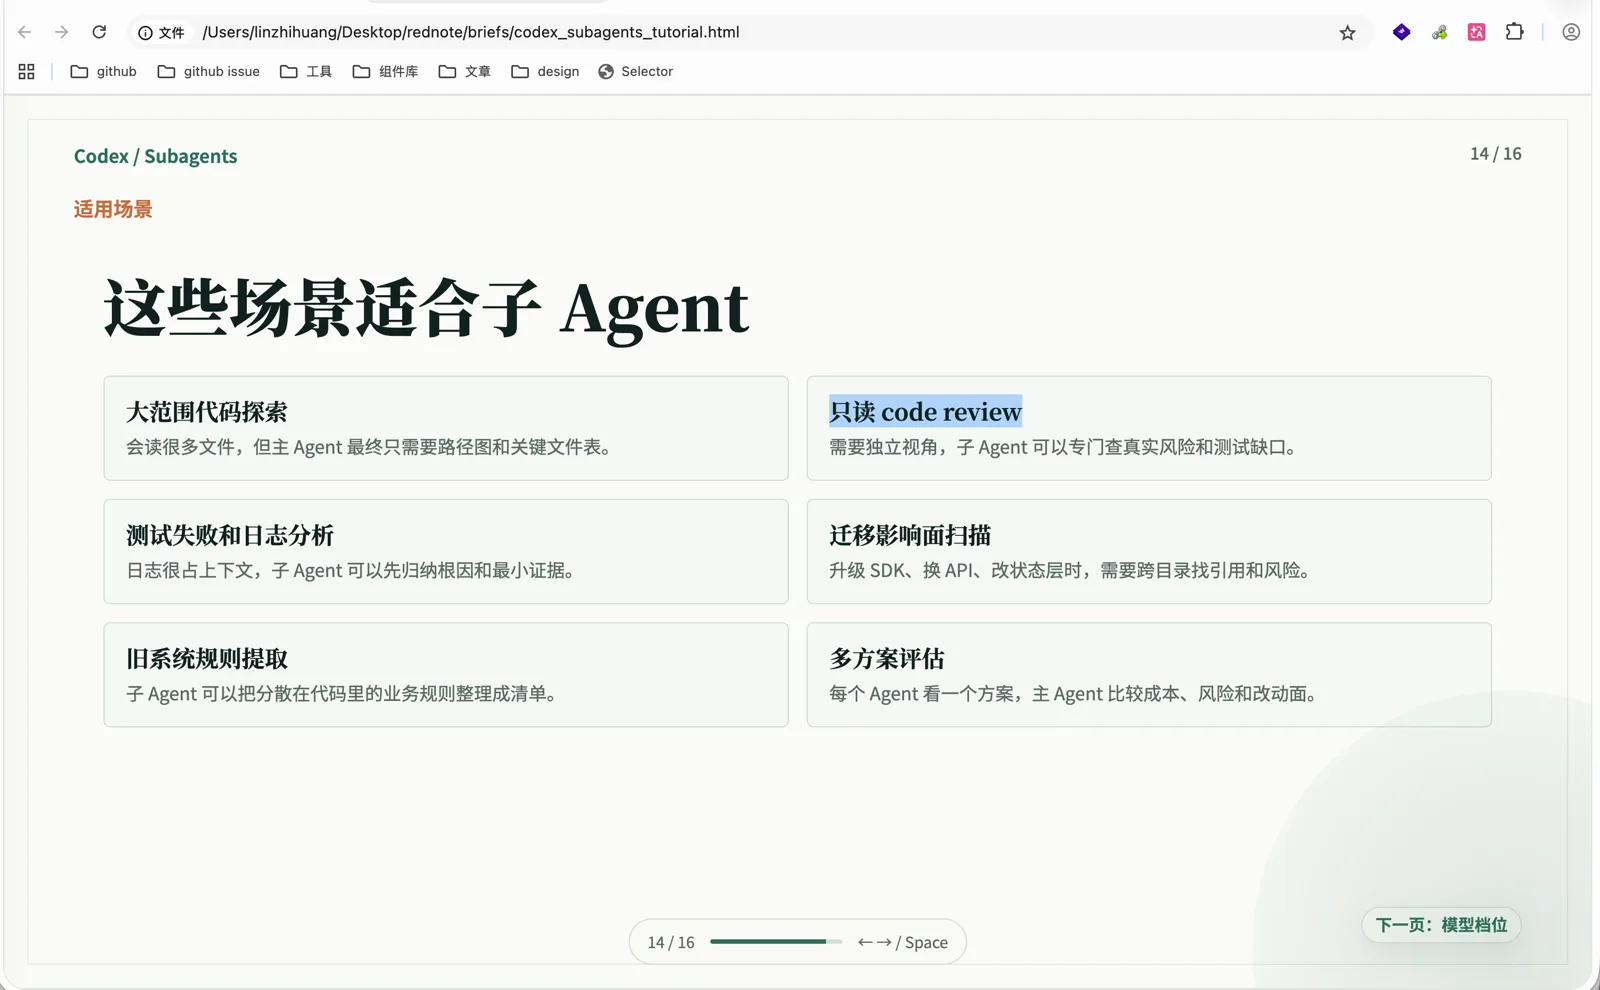
总结一下哪些场景适合子 Agent:
- 大范围代码搜索,这个是最适合的;
- 只读的 code review。子 Agent 没有主 Agent 之前的上下文,视角更干净,判断不会受之前上下文的影响;
- 测试失败和日志分析。日志非常占上下文,一个子 Agent 读两三个日志文件可能就读满了,让它先定位到核心问题返回给主 Agent,再针对性地查看代码,效率更高;
- 迁移影响面扫描和旧系统规则提取,同样是大量读取、返回摘要的模式;
- 多方案评估。每个子 Agent 的上下文很干净,注意力全部集中在某一个方案上,视角更聚焦。
最后是模型档位的选择。子 Agent 可以自定义模型和思考程度,可以结合效率和最终实现效果按需配置:简单的事情选思考程度低、速度快的档位;执行具体工作或者高风险任务的子 Agent,比如写前端、写后端的,可以配置最强的模型和最高的思考程度。这些子 Agent 的配置都可以让 Codex 自己去写,我们只要告诉它需要什么样的子 Agent 就可以了。