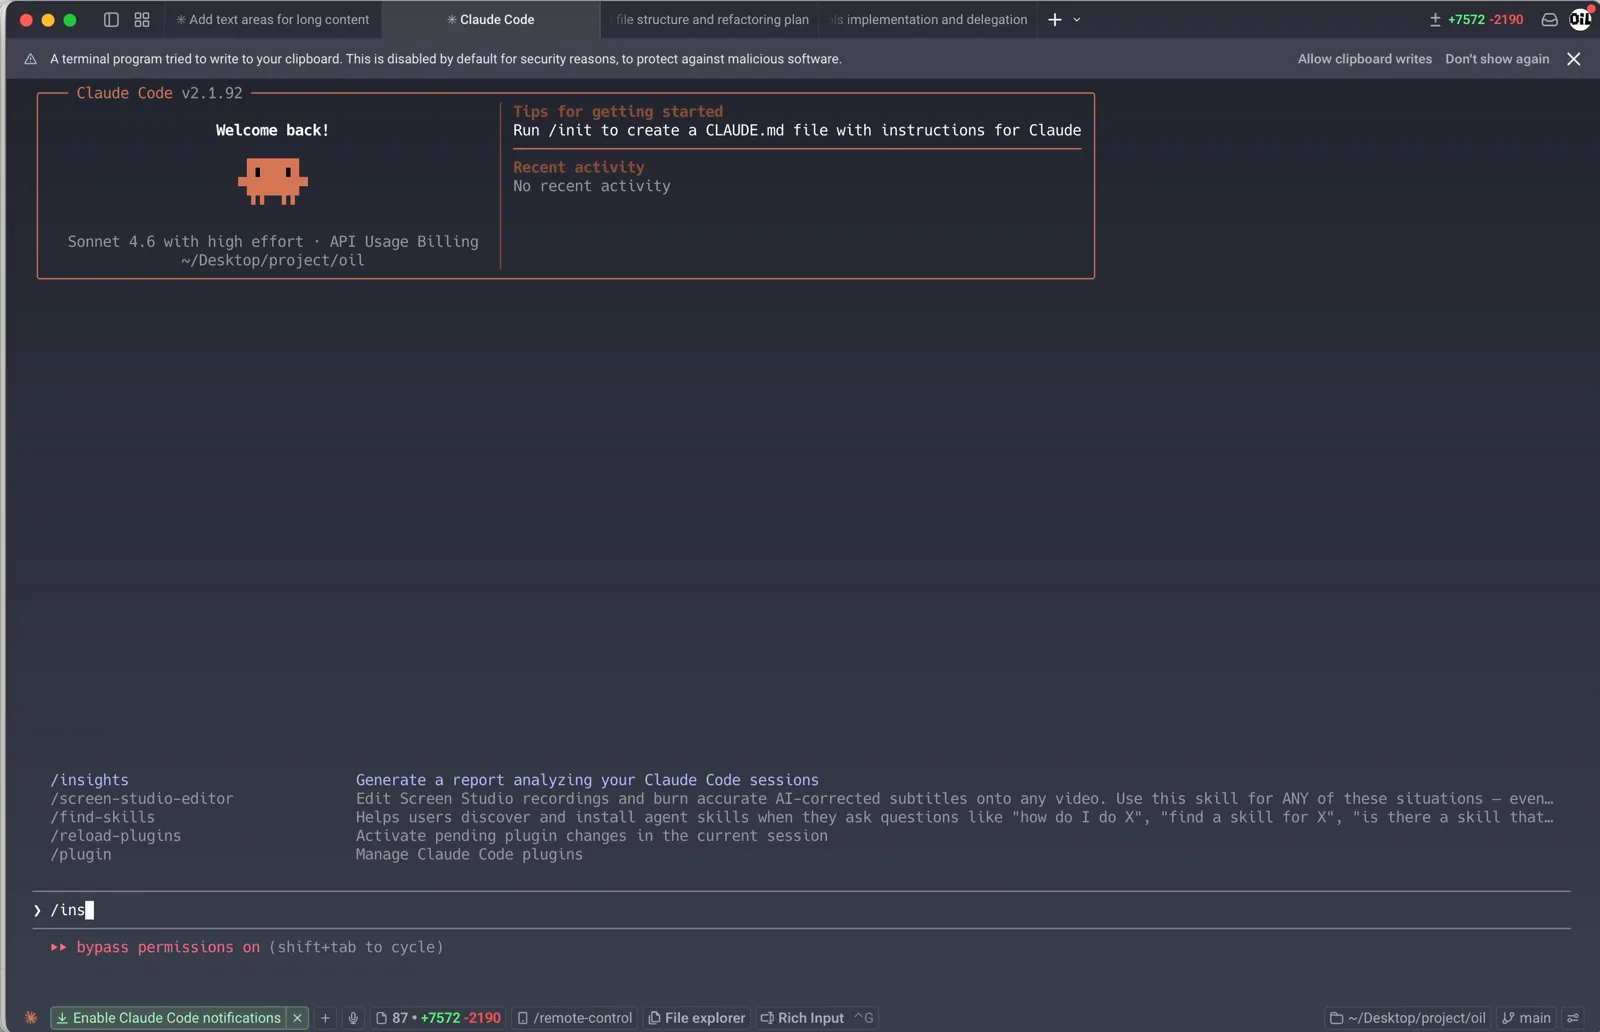
分享一个使用 Codex 的技巧,其实任何 AI Agent 都可以参考:让 Agent 扫描我们之前跟它的对话,把反复出现的流程封装成 Skill,把经常发送的短指令封装成提示词。
Codex 的提示词资源
Codex 除了 Skill 之外还有一个提示词(Prompt)的概念,可以把一两句经常发送的话抽离成一个提示词资源。在输入框输入 /,就能列出并选择已有的提示词。
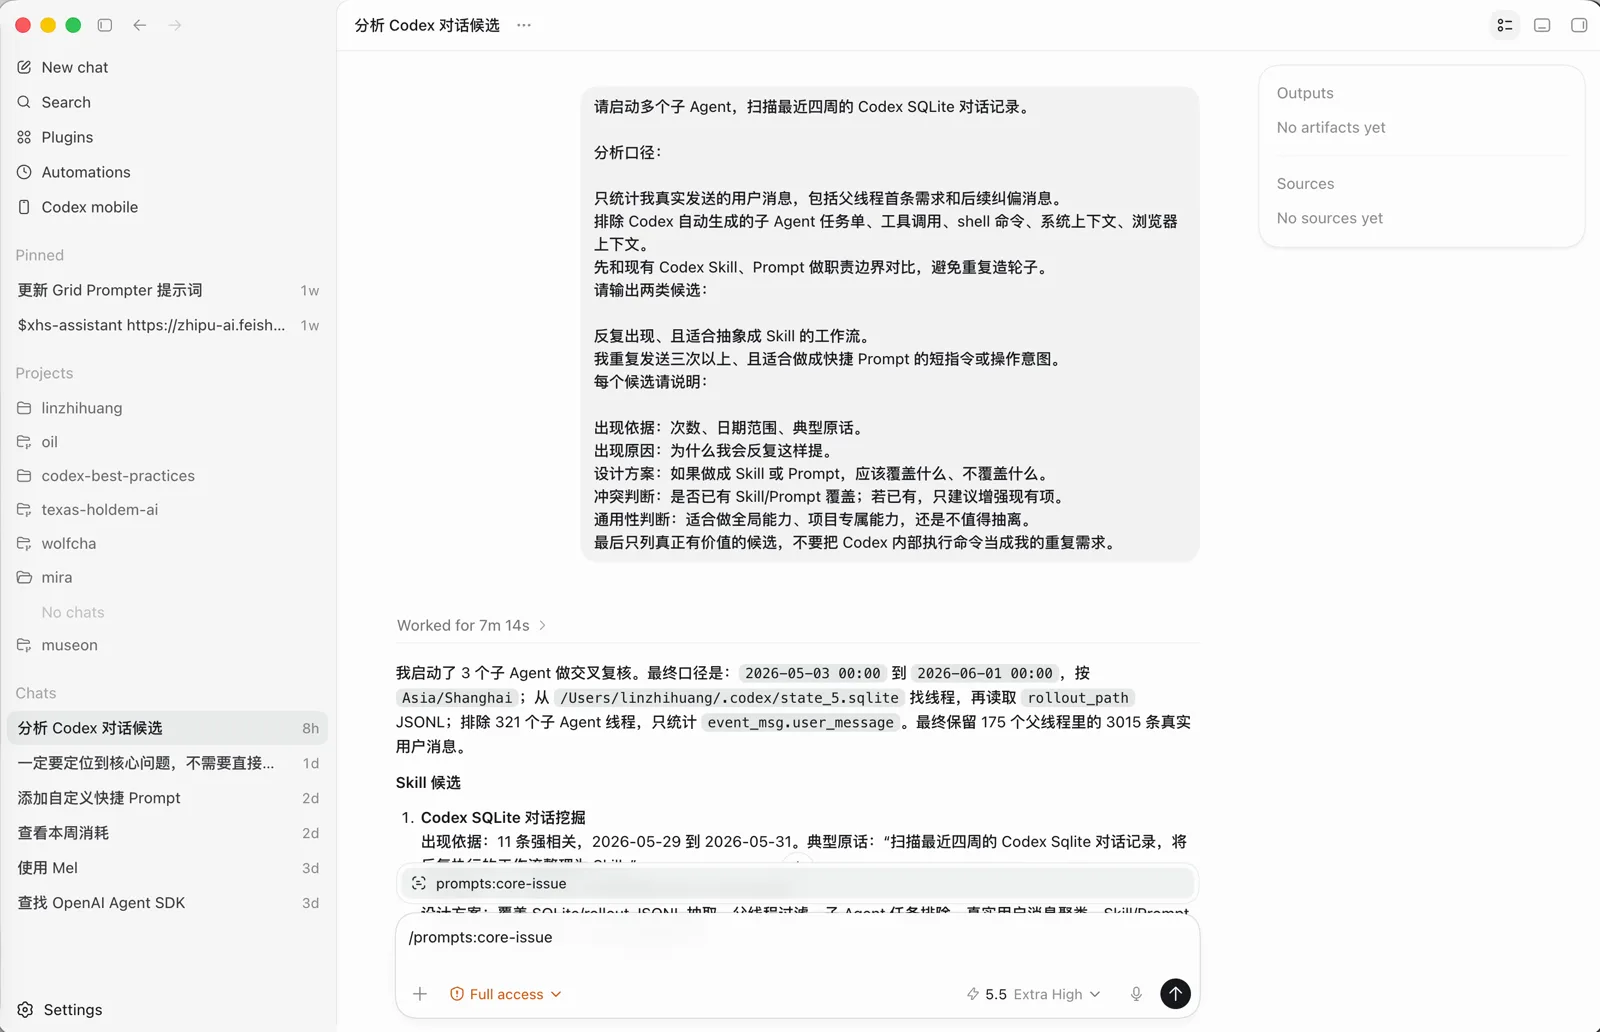
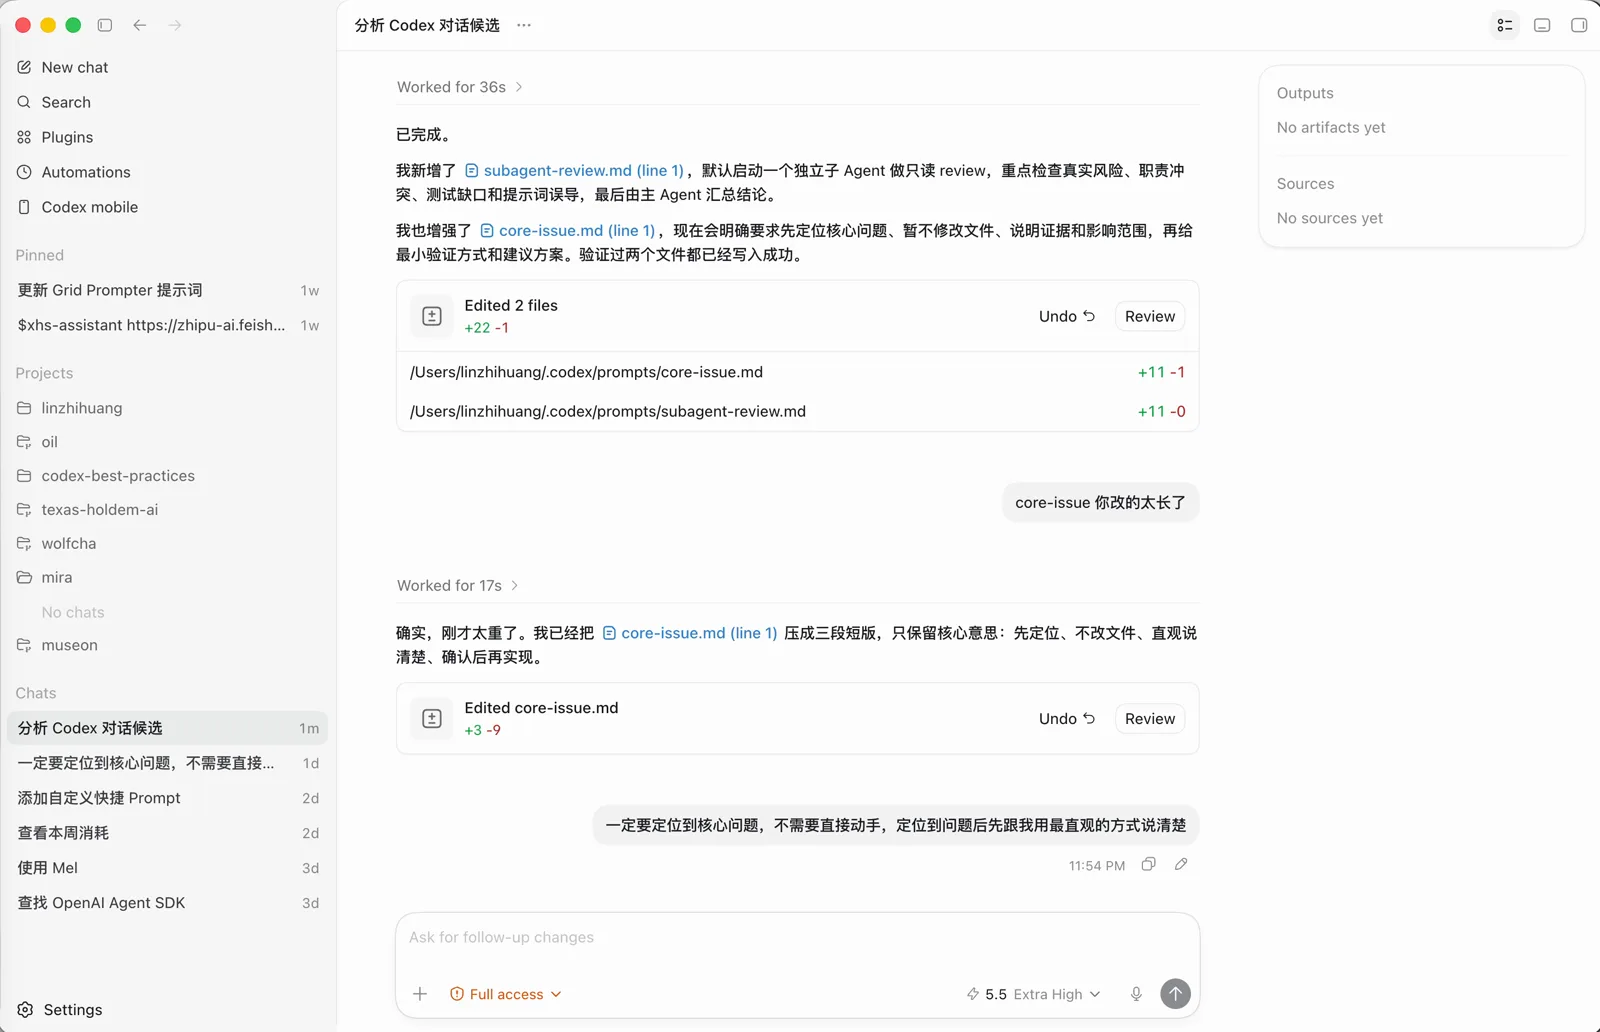
我有一个 prompts:core-issue 提示词,内容是「一定要定位到核心问题,不需要直接动手,定位到问题后先跟我用最直观的方式说清楚」。起因是:我给 Codex 一个含糊的描述让它排查问题时,它有时定位得并不准确就直接开始修改,所以我经常要提醒它先定位、不要动手。这种一句话的指令做成 Skill 没有必要,封装成提示词正合适。提示词本身是一个 markdown 文件,保存在 ~/.codex/prompts/ 目录下,发送时 / 标识会被解析成完整的提示词文本。
让 Agent 扫描历史对话
更进一步,可以让 Codex 自己扫描历史对话,分析哪些任务值得写成 Skill、哪些值得写成提示词。Codex 的对话记录保存在本地的 SQLite 数据库里,我使用的提示词完整内容如下:
请启动多个子 Agent,扫描最近四周的 Codex SQLite 对话记录。

分析口径:

只统计我真实发送的用户消息,包括父线程首条需求和后续纠偏消息。排除 Codex 自动生成的子 Agent 任务单、工具调用、shell 命令、系统上下文、浏览器上下文。

先和现有 Codex Skill、Prompt 做职责边界对比,避免重复造轮子。

请输出两类候选:
反复出现、且适合抽象成 Skill 的工作流。
我重复发送三次以上、且适合做成快捷 Prompt 的短指令或操作意图。

每个候选请说明:
出现依据:次数、日期范围、典型原话。
出现原因:为什么我会反复这样提。
设计方案:如果做成 Skill 或 Prompt,应该覆盖什么、不覆盖什么。
冲突判断:是否已有 Skill/Prompt 覆盖;若已有,只建议增强现有项。
通用性判断:适合做全局能力、项目专属能力,还是不值得抽离。

最后只列真正有价值的候选,不要把 Codex 内部执行命令当成我的重复需求。
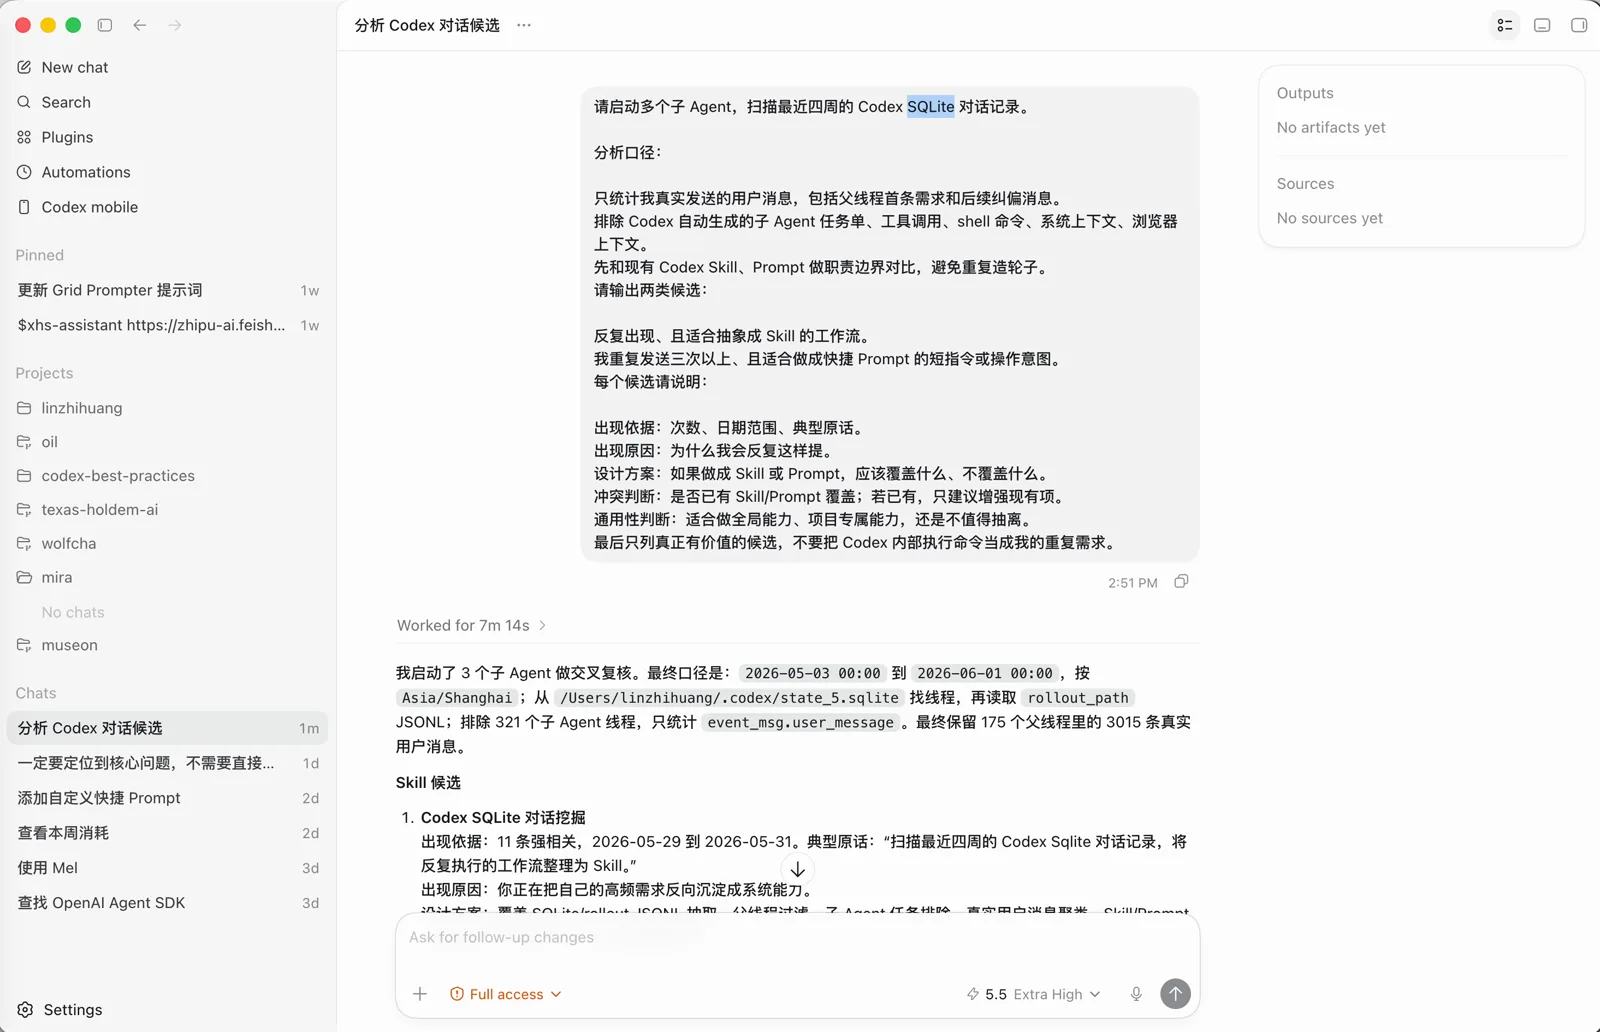
其中有几个口径需要说明:
- 只统计真实发送的用户消息。Codex 自动生成的子 Agent 任务单、工具调用等内容,在数据层面上也属于用户消息的一部分,不排除掉会干扰统计。
- 先和现有的 Skill、提示词做职责边界对比。已有的资源不重复创建,只建议增强。
- 只输出候选清单,不直接创建资源。我需要人工确认一遍,不希望 Skill 和提示词过度泛滥,保持可控。
用 DeepSeek 完成扫描
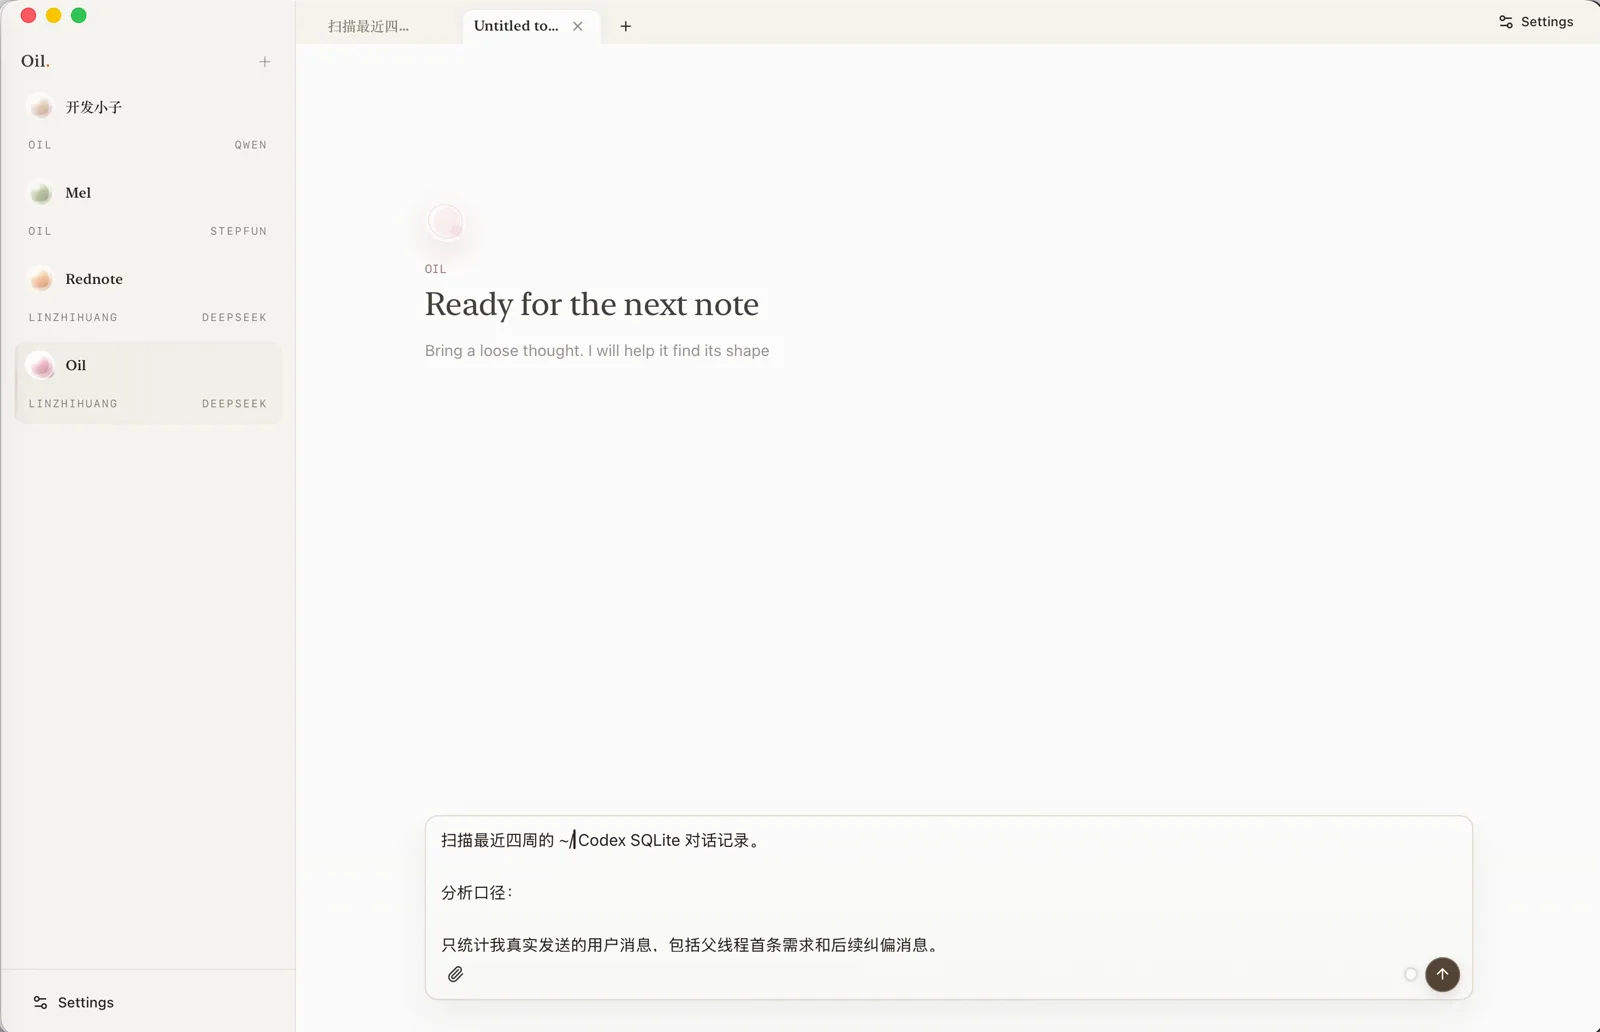
演示时我没有消耗 Codex 的额度,而是把提示词粘贴给 DeepSeek,并告诉它 ~/.codex 的路径。这个任务相对简单,DeepSeek 在这类对话分析上的表现不比 GPT 差,交流感更强,价格也便宜。
扫描结果
扫描完成后,DeepSeek 生成了一份 markdown 报告。它先统计了口径:从 ~/.codex/sessions/2026/05/ 目录的 rollout 文件中提取真实用户消息,四周共 3155 条,然后梳理了我现有的全局 Skill 和项目里的 Skill,避免重复造轮子。
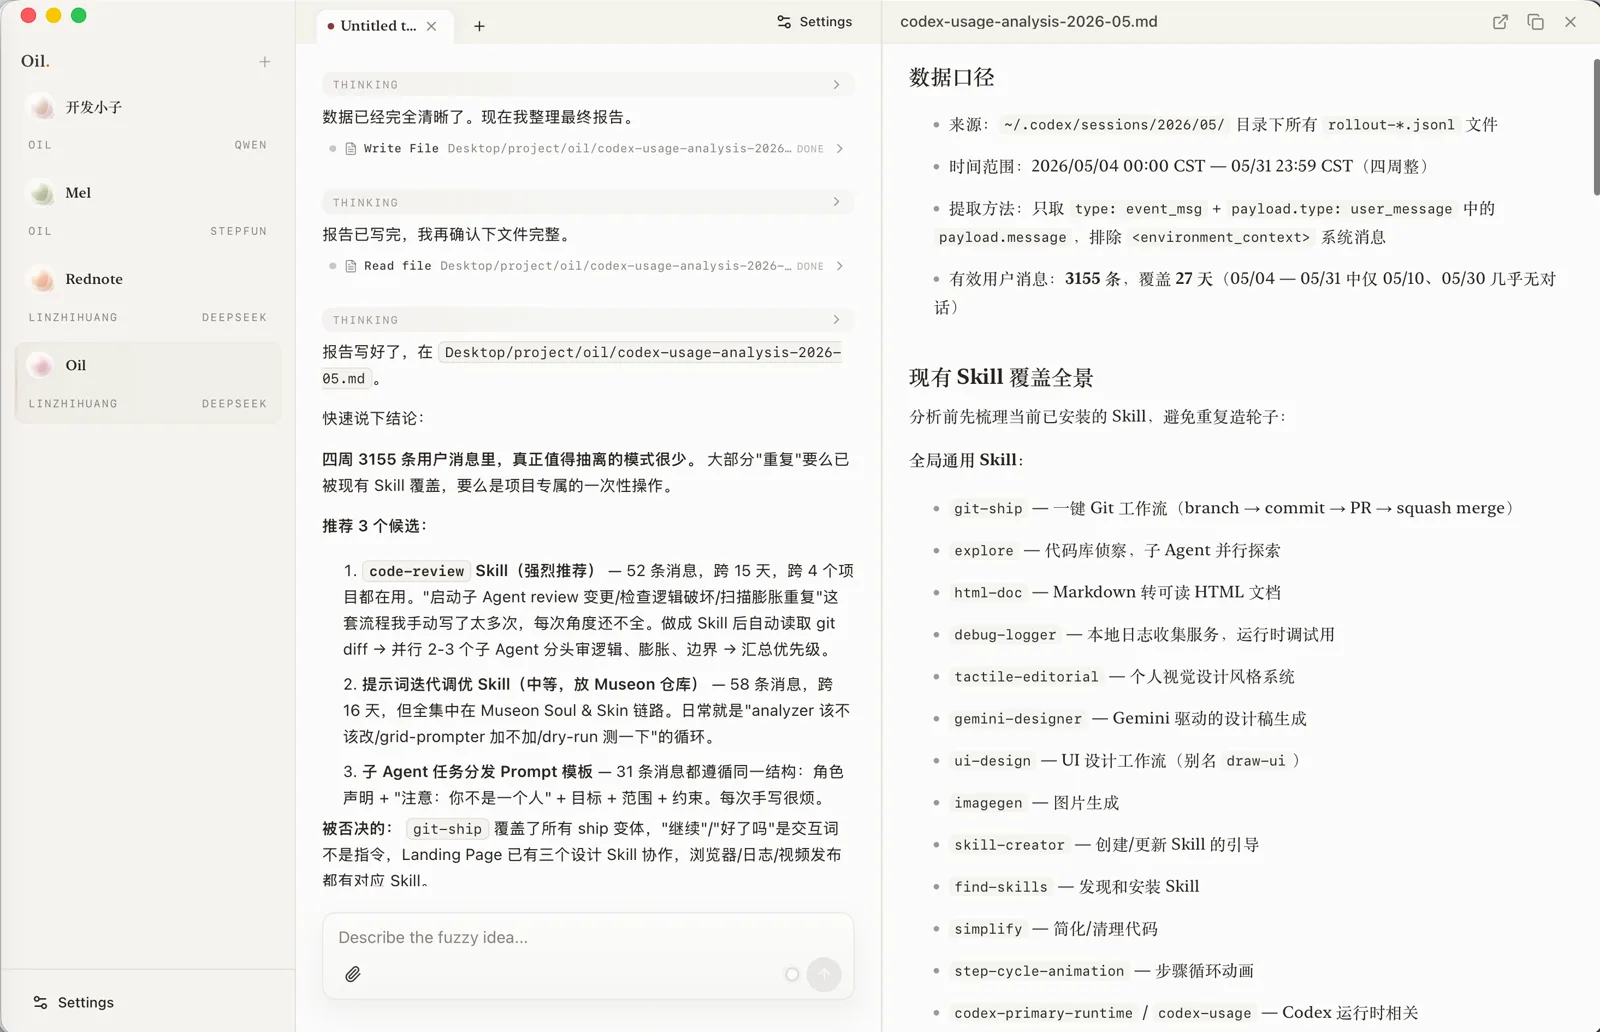
报告推荐做成 Skill 的候选有两个。
第一个是子 Agent Code Review 工作流:52 条相关消息、跨 15 天,典型原话是「启动子 Agent 进行 review」「把所有问题修复之后启动多个 Agent review 所有变更」。让子 Agent 做 review 的原因是子 Agent 的上下文是干净的,可以从一个全新的视角重新审视代码实现。
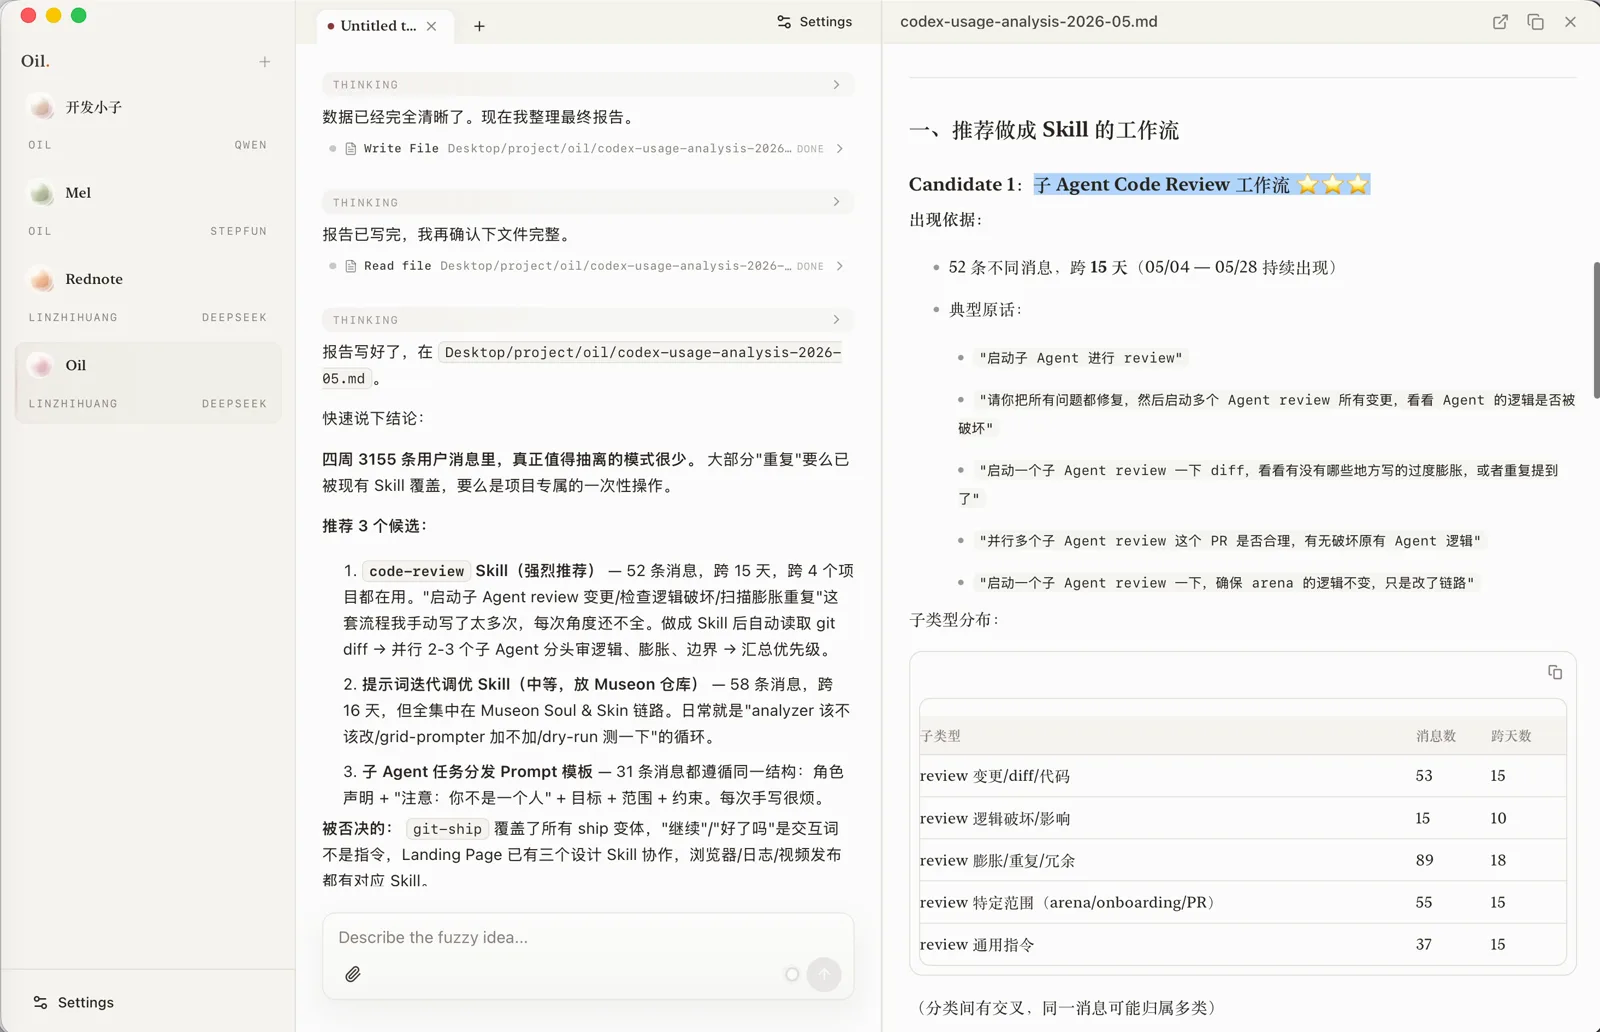
报告给出的设计方案是:自动读取 git diff 确定变更范围,并行启动两到三个子 Agent,分别检查逻辑正确性、膨胀冗余和边界异常,最后把结果汇总给主 Agent。不过 Codex 自带的 review 命令已经覆盖了类似的场景,只是不是 Skill 的形式,DeepSeek 没有扫描到,所以这个候选我没有创建。
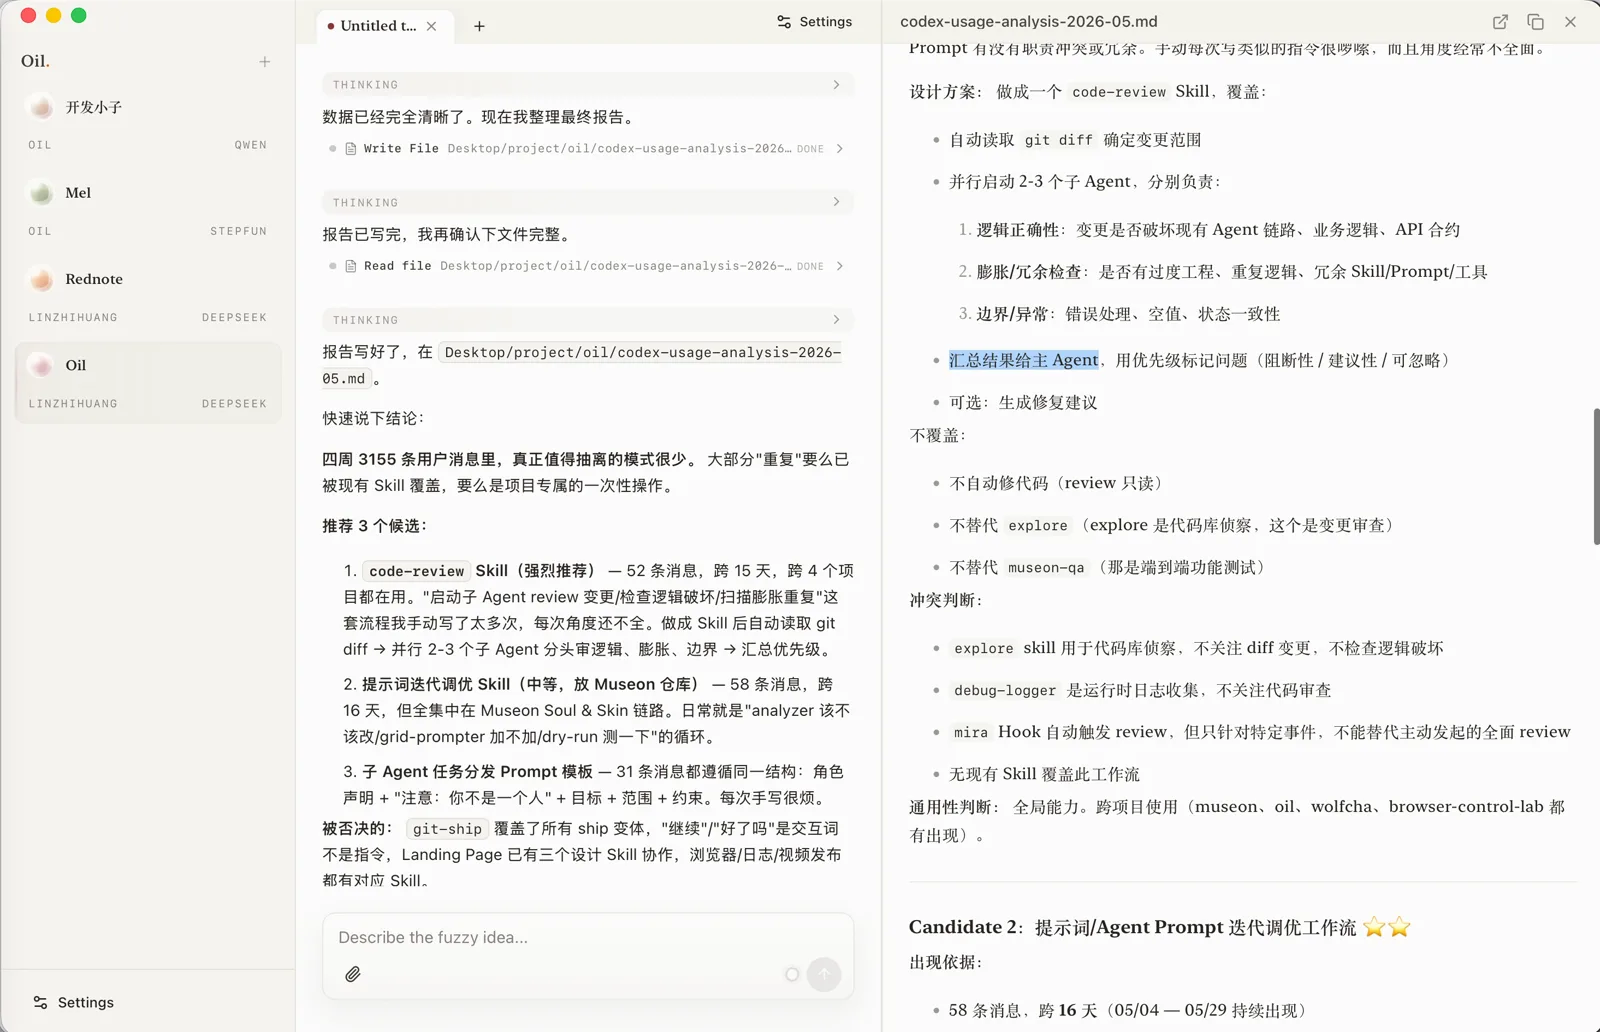
第二个是提示词迭代调优工作流:58 条消息、跨 16 天,但全部集中在一个项目的链路里,太偏业务。如果最近针对某个项目做了很多工作,更适合给这个项目单独创建一个 Skill,而不是抽成全局能力。
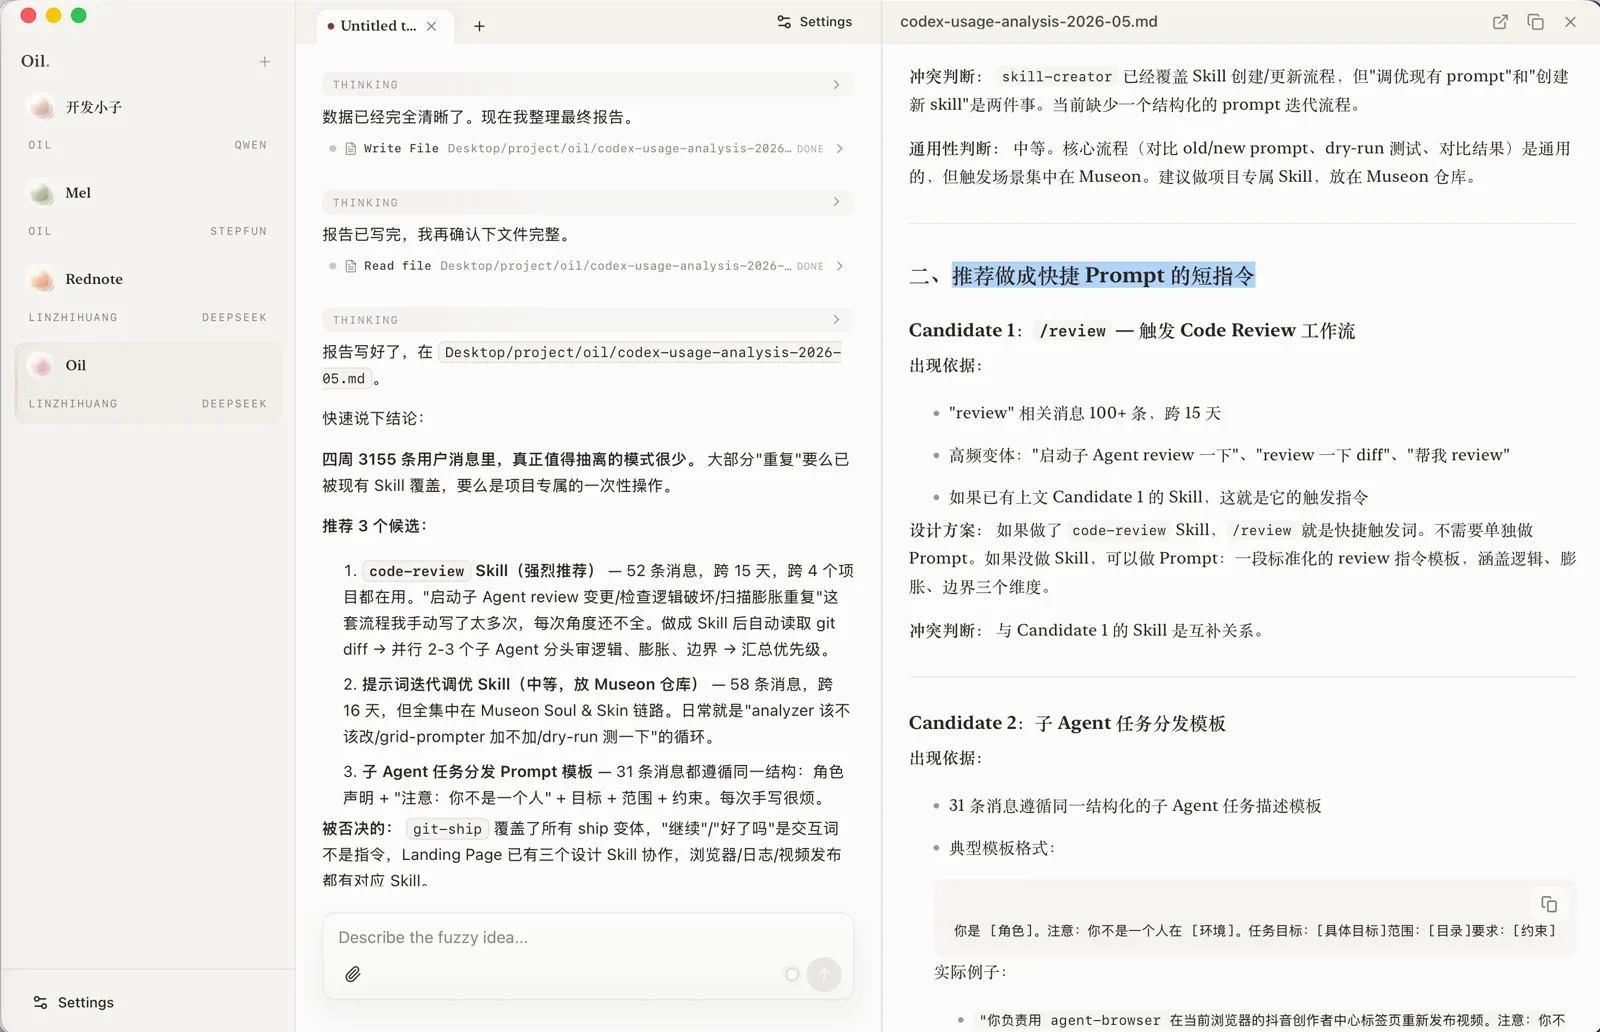
报告还推荐了两个做成快捷提示词的短指令:
/review:review 相关消息超过 100 条。如果做了上面的 Code Review Skill,/review就是它的触发词;没做 Skill 的话,也可以做成一段标准化的 review 指令模板。- 子 Agent 任务分发模板:31 条消息遵循同一个结构(角色声明 + 目标 + 范围 + 约束)。我觉得必要性不大,每次手写也不麻烦。
报告最后列出了已有覆盖、不需要新增的部分:git-ship 已经覆盖了「推一下代码」「继续 ship 吧」这些自然语言变体——我经常口头说推一下代码,其实也是让它触发这个 Skill,这一点 DeepSeek 没有判断准确;Landing Page 设计已有三个 Skill 协作;浏览器控制已有 my-browser 和 agent-browser 两个 Skill。
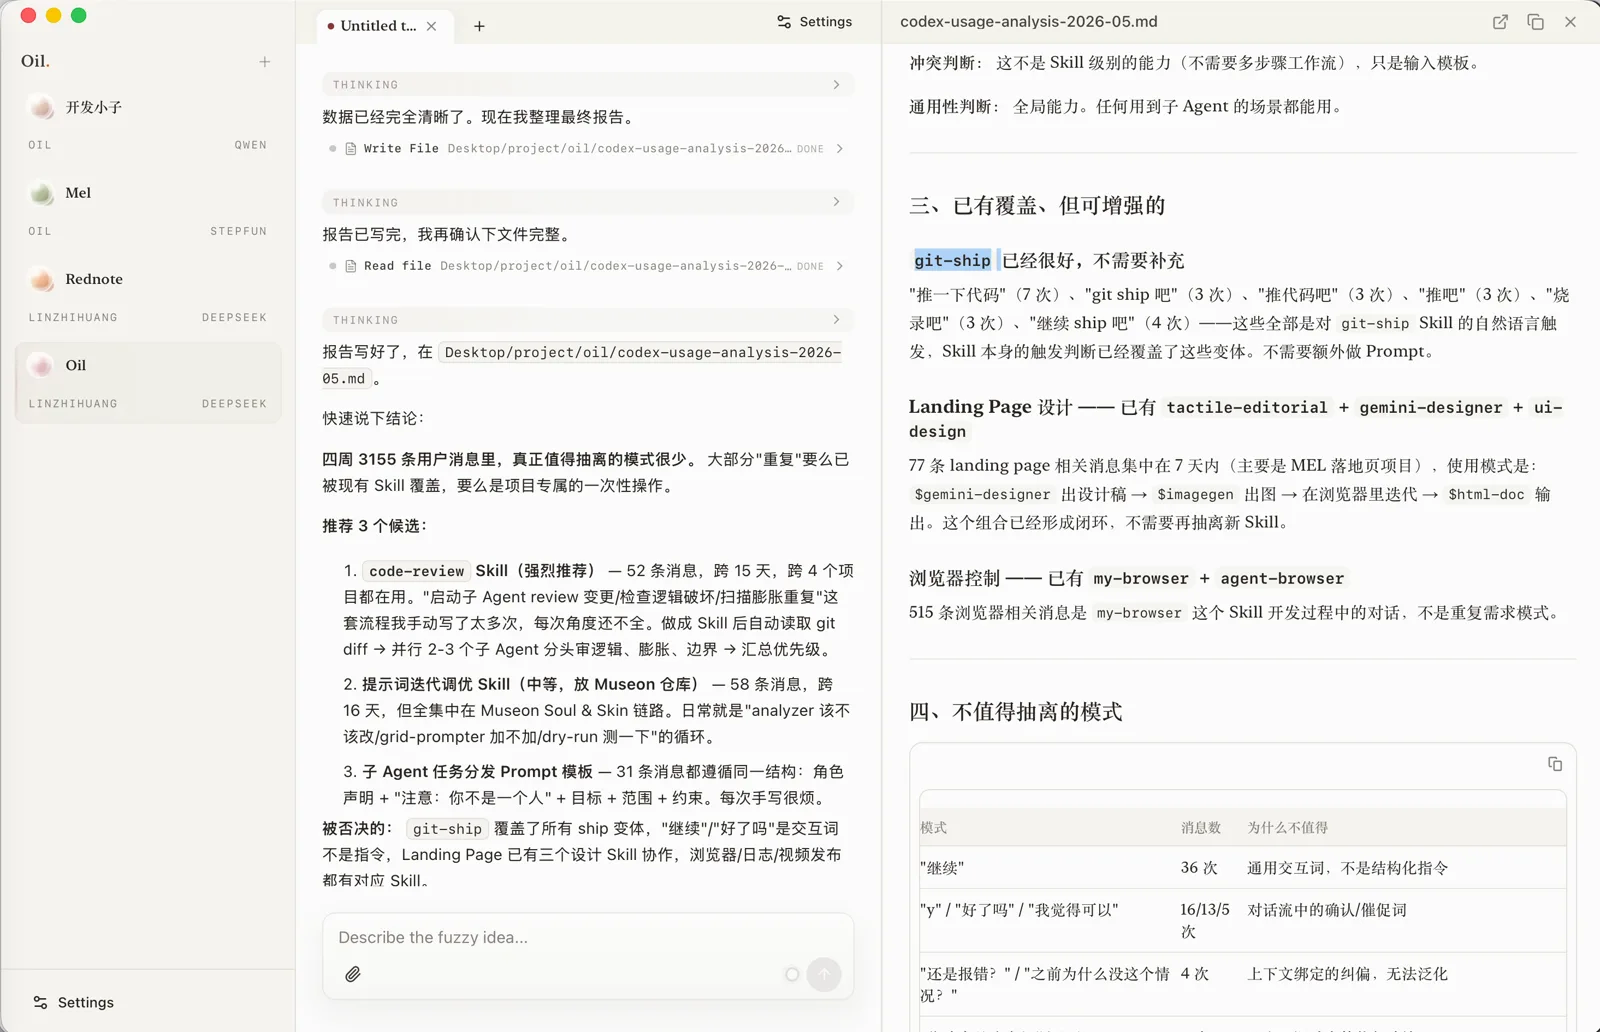
这次的结论是:3000 多条消息里真正重复、适合抽离的模式很少,因为我之前已经把常用的流程做成了 Skill。反过来说,如果扫描之后发现大量建议,说明之前使用 AI Agent 的流程还有优化的空间。
Claude Code 的 /insights 命令
Claude Code 里有一个 /insights 命令,执行后会生成一份深度报告,分析我们的 Claude Code 会话,指出哪些描述写得不好、哪些功能值得做成 hook、提示词或 Skill。在这样反复迭代的过程中,我们的 SOP 会越来越完善,使用 AI Agent 的效率也会越来越高。