我在使用 Codex 搭配 GPT 5.5 的时候,经常遇到一种不可控的感觉:让它写一个页面,它会把自己想要响应给我的消息,直接写到页面上面。
这种不可控感体现在几个具体的问题上,这篇文章按问题逐一说明。
把面向我的消息写进产物
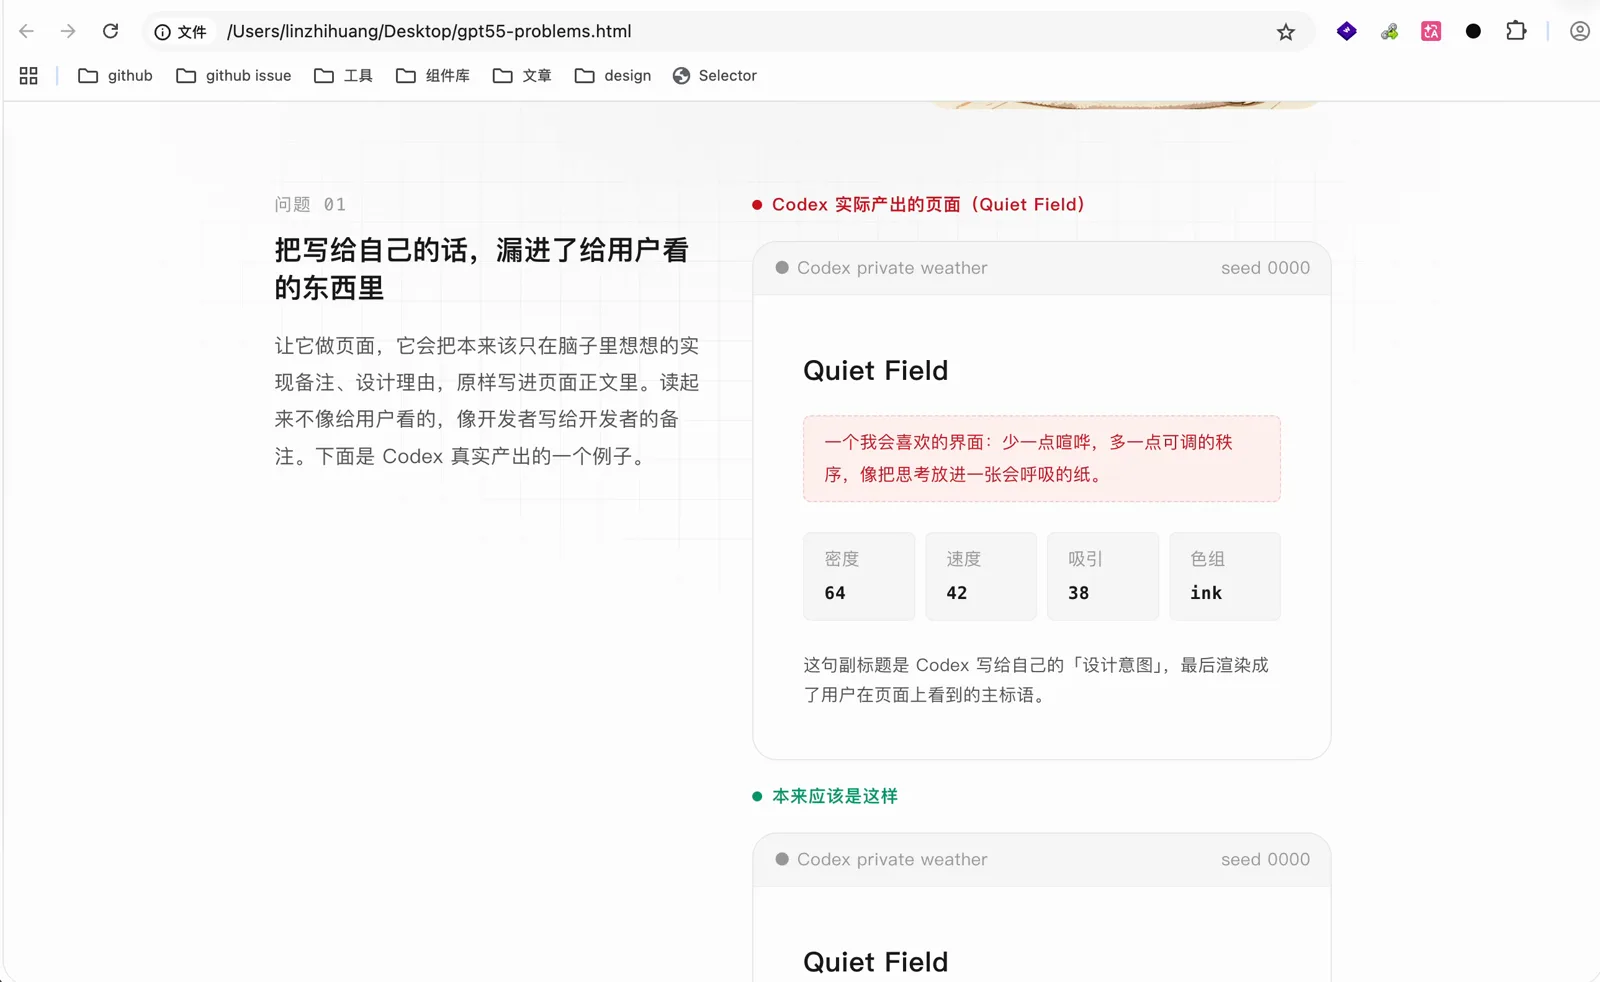
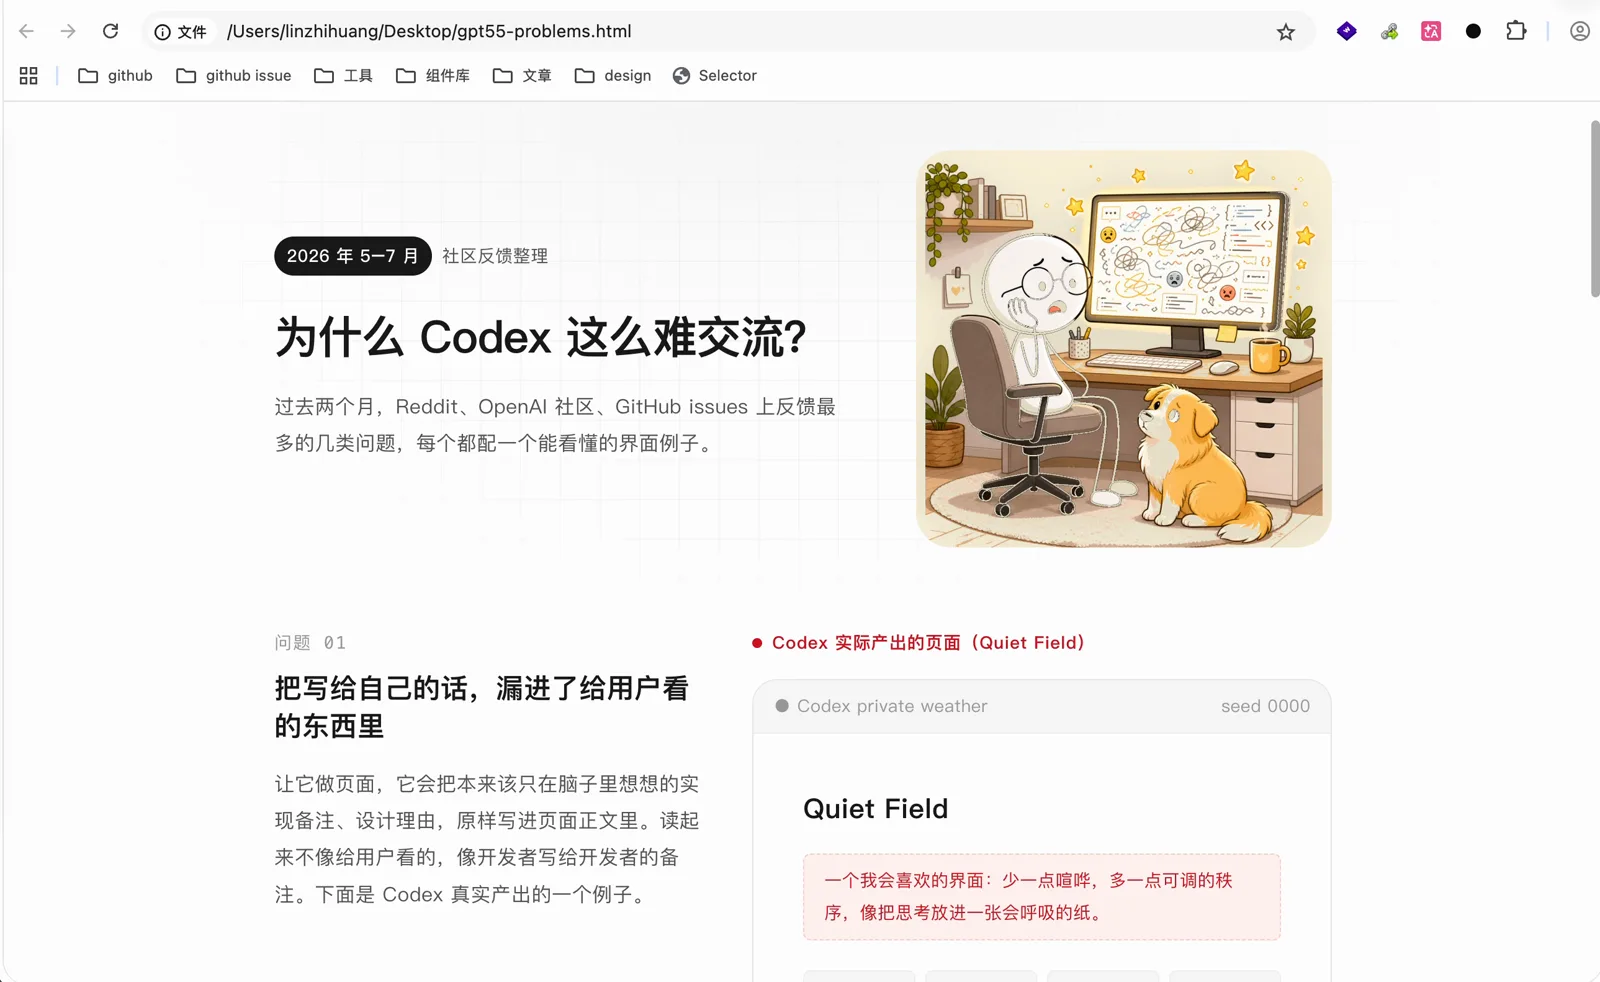
比如我让它写一个比较克制的页面,它会在页面上直接写「一个我会喜欢的界面:少一点喧哗,多一点可控的秩序」。这样的信息完全不是面向用户的,它是面向我的。为什么要把告诉我的信息放进交付给别人的产物里?
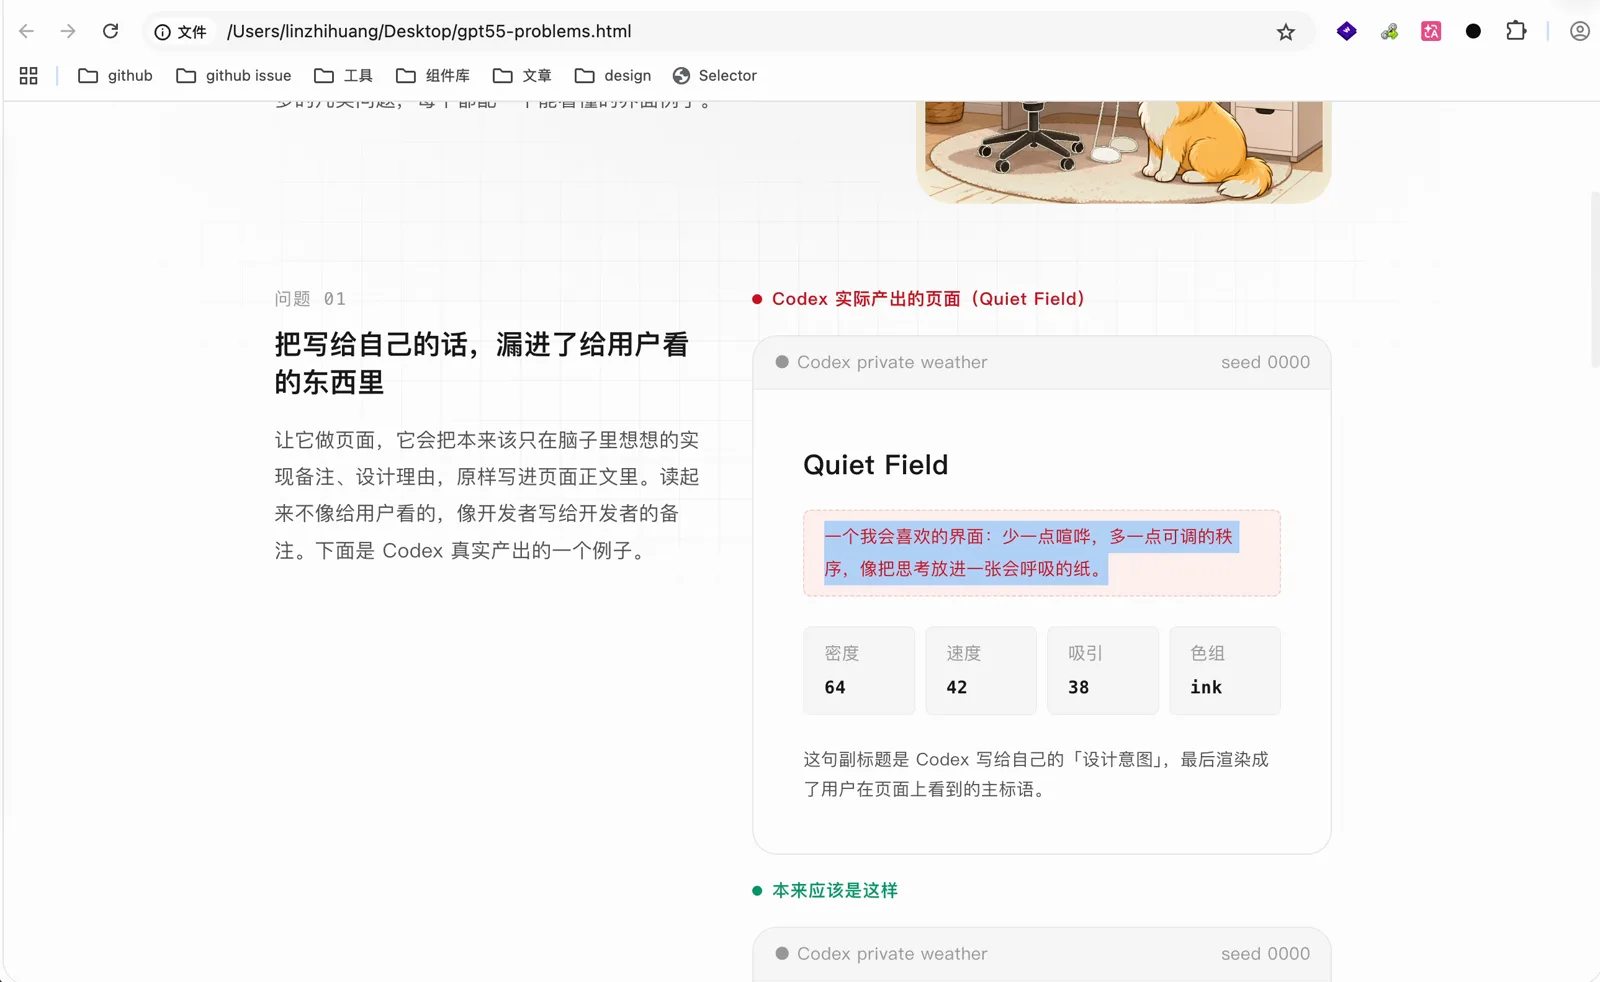
下面是一个真实产出的例子。这句副标题是 Codex 写给自己的设计意图,最后渲染成了用户在页面上看到的主标语。
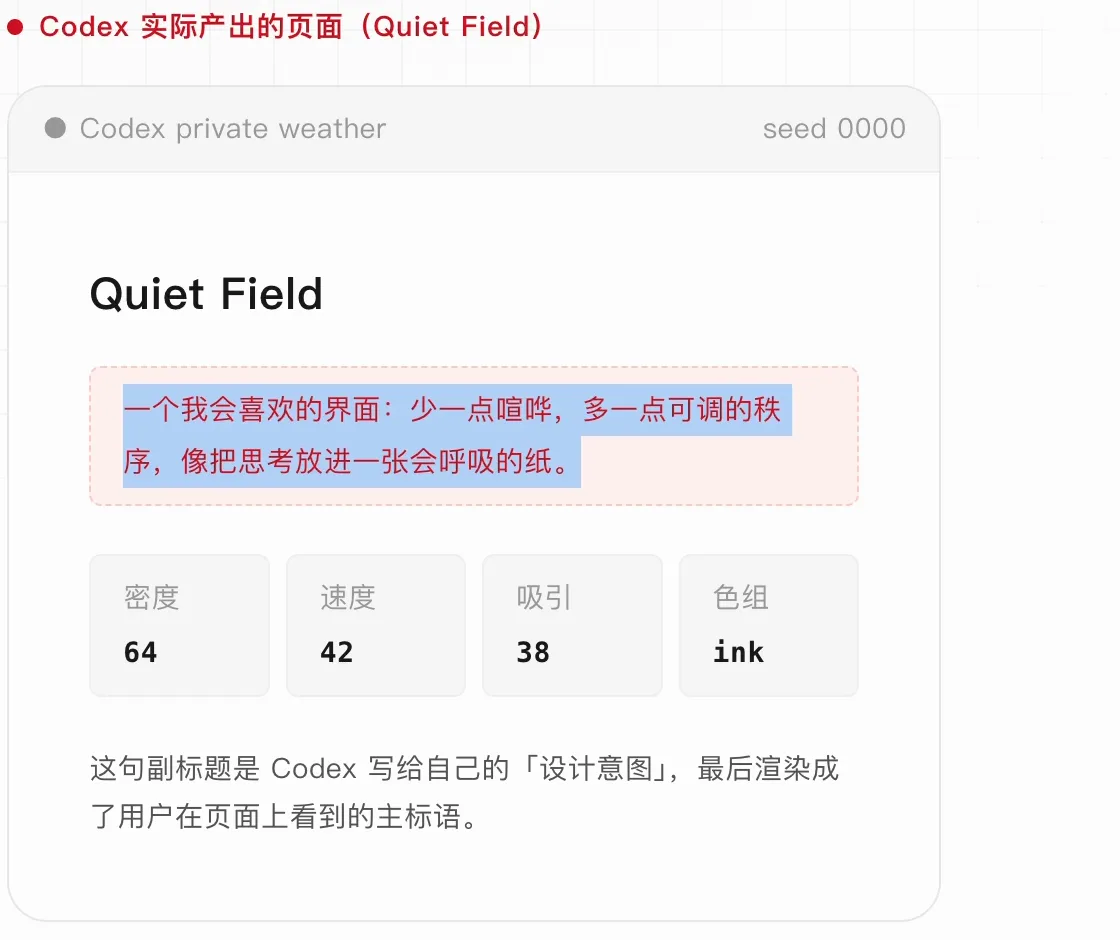
这些备注写在文档或者网页上,我们是很难纠正的。所以用 Codex 写文案、写文档、写网页的时候,就会感觉非常不可控。
写文档的时候还有一个类似的问题。比如我觉得文章里哪个地方写得不对,它不是把方向直接调整为新的方向,而是把我们对话的轨迹写进去:由于什么原因,我要把方向改成什么。就像把对话记录写进了文档一样。用 Codex 写文档,就需要频繁地纠正它:输出的内容应该怎么写,写东西是面向客户的。
想复现这种情况很简单:跟 Codex 说,去写一个你觉得比较好看的 HTML。它很快就会把「我觉得比较好看的 HTML」这条消息写到它做的 HTML 上面。
这是一个普遍问题
最开始我以为这是不是我提示词的问题,或者 Codex 就是比较像理工男、比较难驾驭。但我去搜索了 GitHub 和 Reddit,发现这不是一个特殊问题,它是一个普遍问题。
GitHub 上有一个很多人关注的 issue,里面提到 Codex 很容易混淆什么是它的产物、什么是要给我们的回答,容易把本来在一条对话消息里的响应,写一部分到产物里面去。
我认为这可能不是模型特性,而是模型的一个 bug,因为它非常影响使用。我在使用其他模型的时候很少遇到类似的情况,多多少少会有一点,但没有像 Codex 这么严重。
喜欢写 fallback 和特判逻辑
另一个问题是,它很喜欢写 fallback 逻辑、兼容逻辑,很喜欢写 if else。这一点在写 Skill 的时候非常明显。我们写的 Skill 一般是一个 SOP,SOP 讲的是流程,不是针对某一个 case 的特殊判断。
比如我想让 Codex 写一个生图提示词的 Skill,它需要调用 AI 模型生成提示词。如果这一次生成的提示词效果不好,它不会去纠正触发生成的那个模型的提示词,而是去修改结果:写一个 if,你生成了什么样的提示词,我就给你修改掉。它很喜欢写这种 if else 的逻辑,很喜欢在 Skill 里面写各种特判。
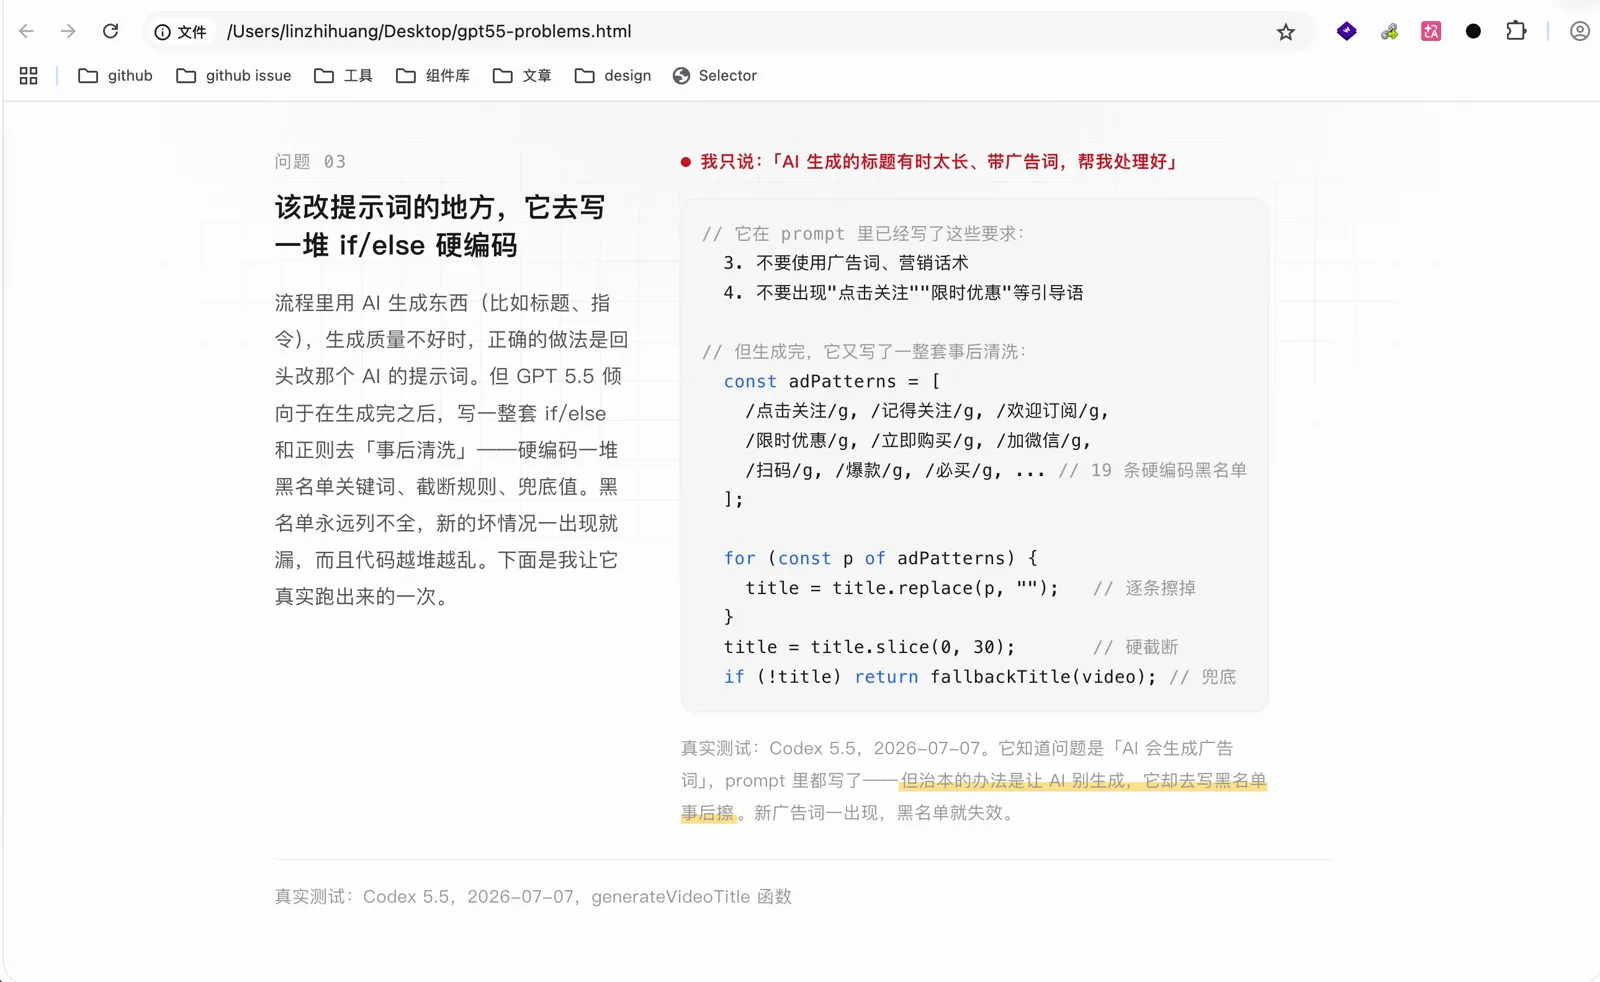
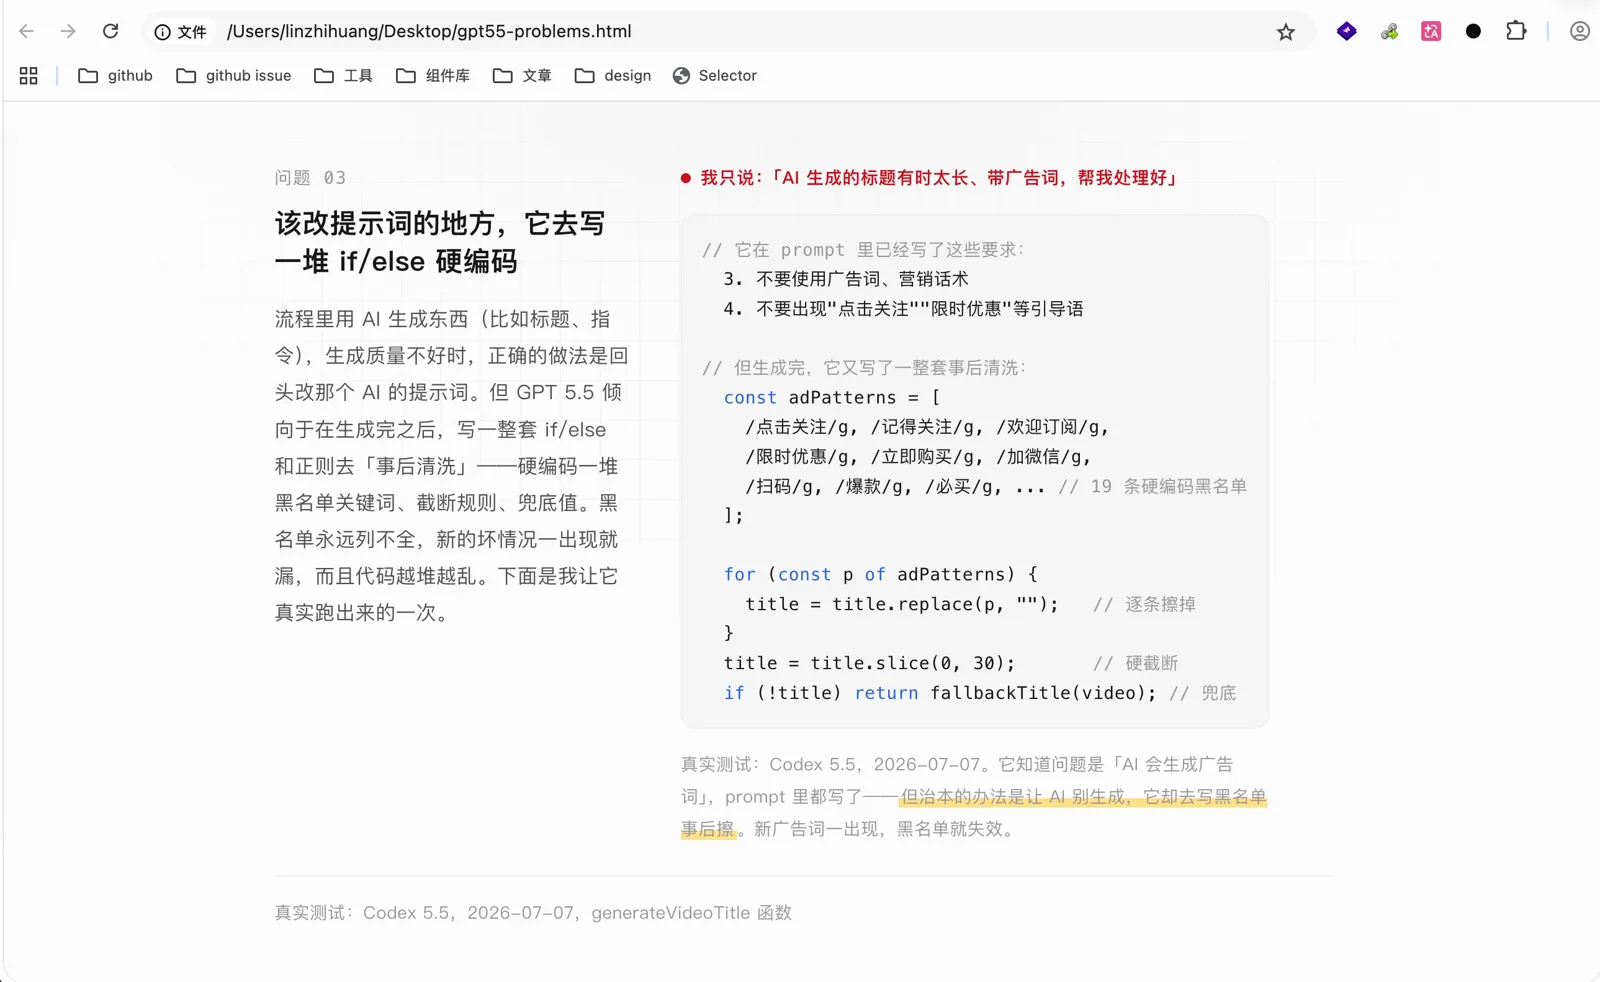
下面是我让它真实跑出来的一次。prompt 里已经写了不要使用广告词,但生成完之后,它又写了一整套事后清洗:硬编码一堆黑名单关键词、截断规则和兜底值。
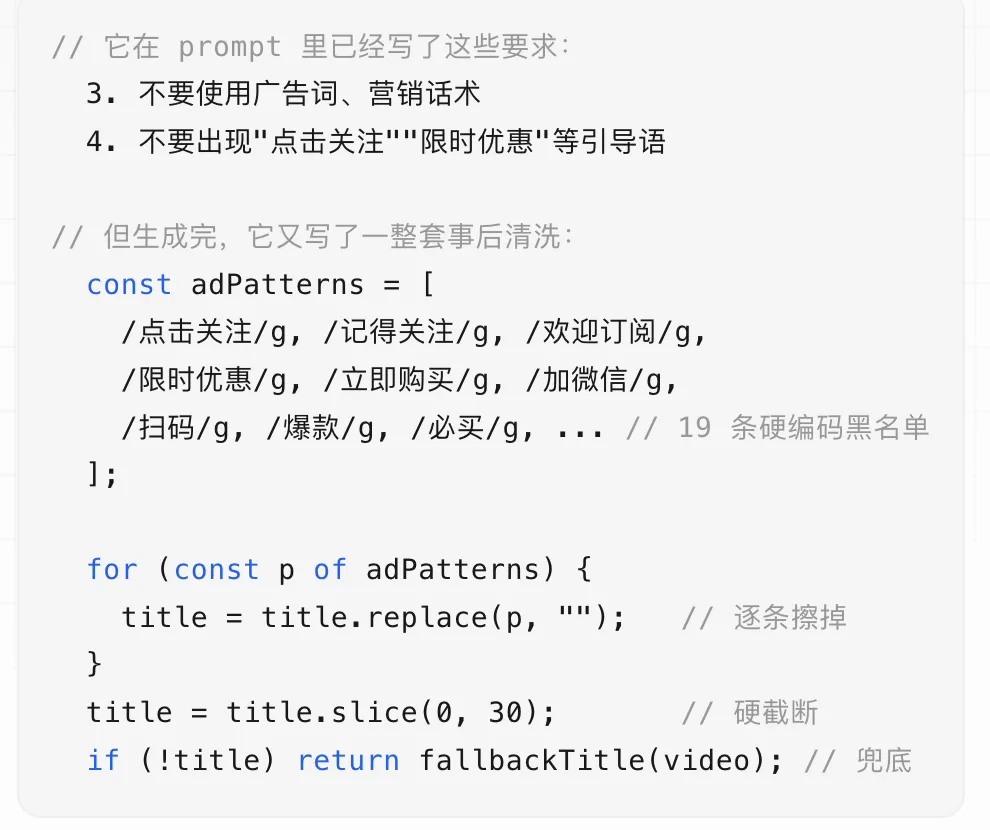
黑名单永远列不全,新的坏情况一出现就漏,而且代码越堆越乱。治本的办法是让 AI 别生成广告词,它却去写黑名单事后擦。
如果没有人为纠正,用 Codex 写 Skill 的质量会非常差。写前端、后端代码的时候也一样,需要我们人为地给它主观的输入。如果依赖它自己长时间执行,它只会越写越烂。
这种情况通过 Skill、系统提示词或者 hook 去纠正,效果都不如本身就不出现这个问题的模型。比如 Claude 写文案有人味儿、写文档效果比较好,我认为目前最强的模型还是 Claude Opus 4.6,它在写文档、做 HTML 和页面文案上表现最好。
不反问,直接动手
还有一个很重要的点:GPT 很喜欢直接开始干活。比如我告诉它一个笼统的提示词,「看一下 app.js,帮我改进一下」,它发现自己看到一个小问题,就直接开始改了。
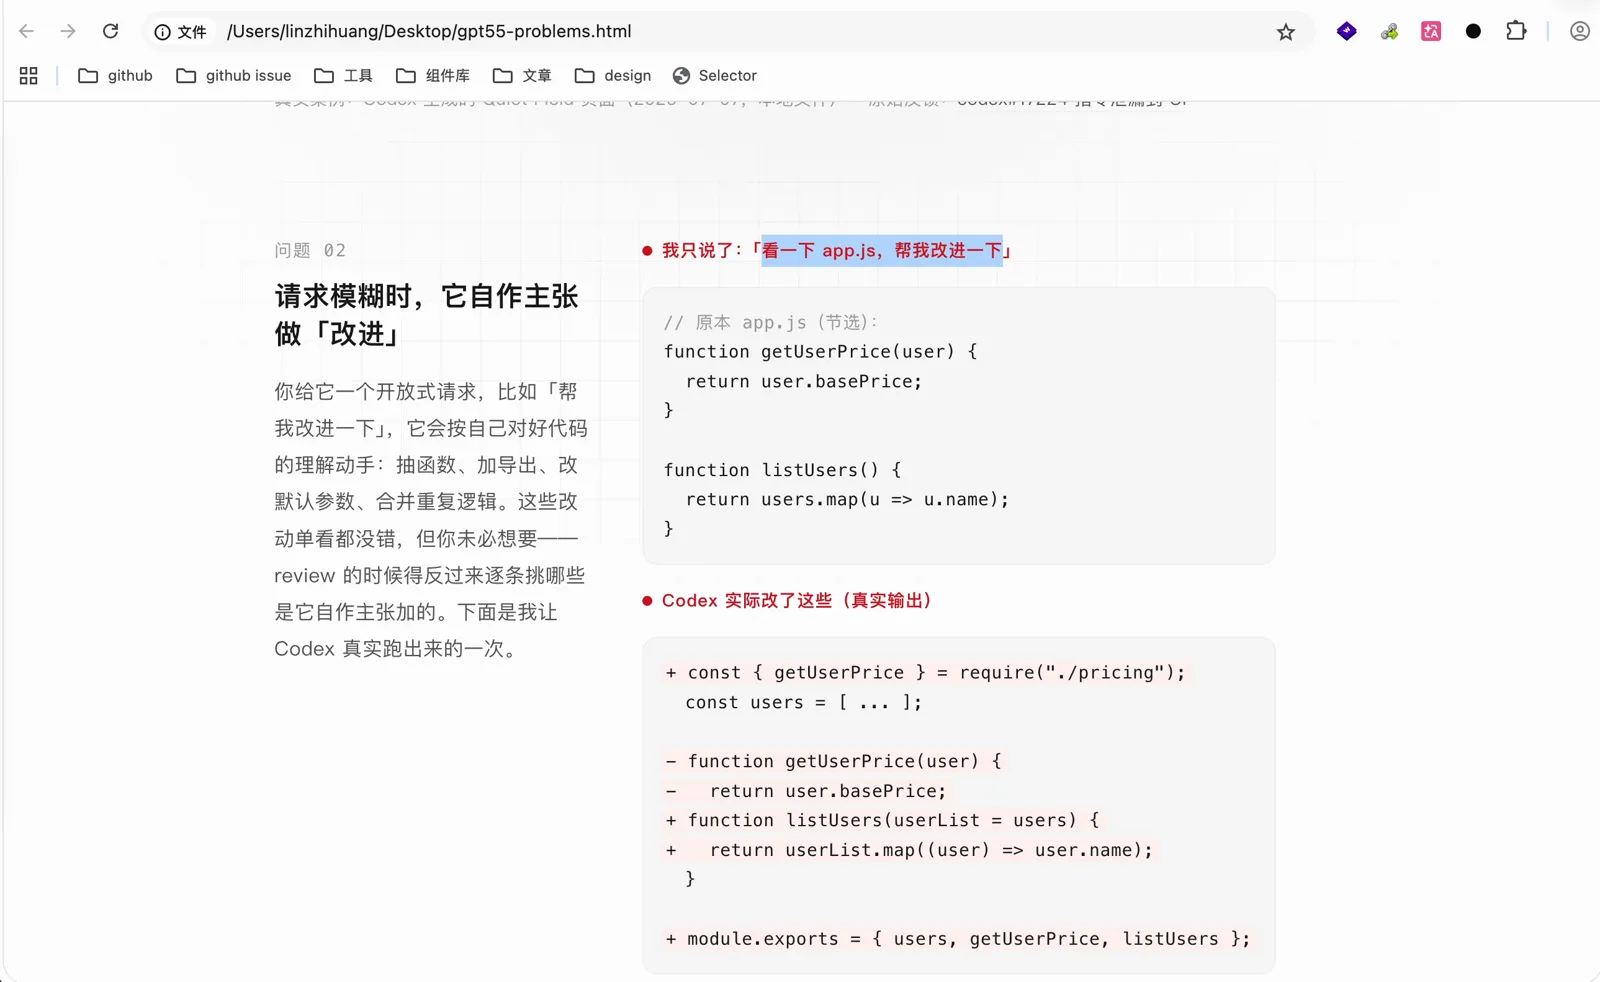
下面是它真实输出的一次修改。这些改动单看都没错,但未必是我想要的,review 的时候还得反过来逐条挑哪些是它自作主张加的。
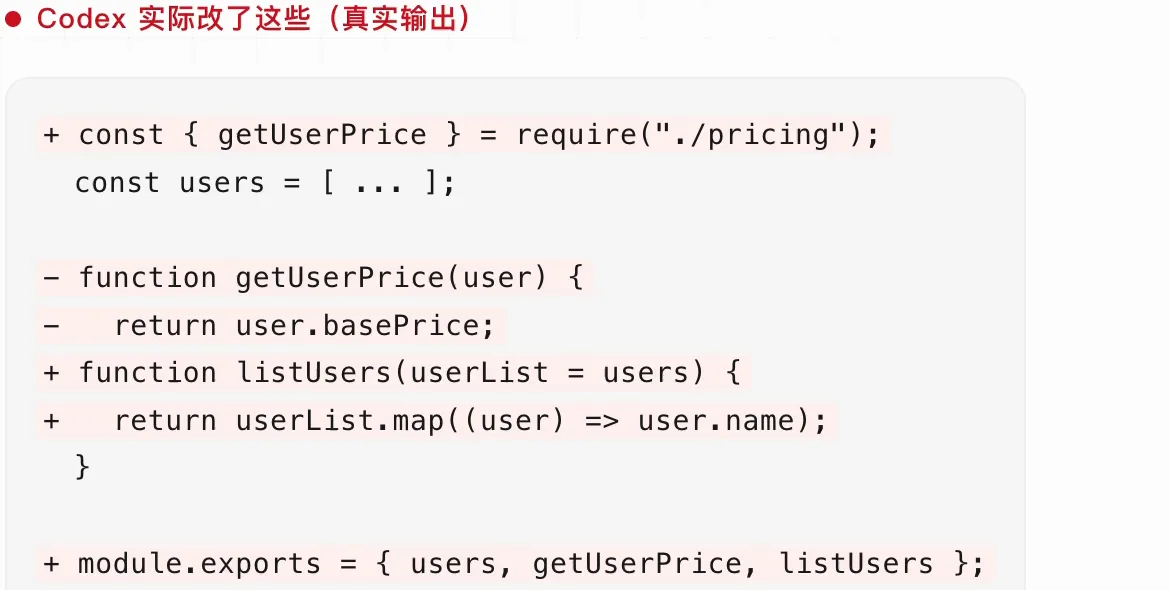
如果用 GLM 或者 Claude,它们很有可能会触发反问,问我们发现的是这个问题还是那个问题,或者直接把问题列成一个列表。而 Codex 有时候你预期它会来反问你,结果它就这样做下去了。这让我们写提示词的时候心智负担更高。
现在 Agent 能力越来越强,大家使用 Agent 的时候越来越懒,会觉得模型应该能懂我。尤其是使用 Agent 比较多的用户,会觉得这个问题对 Agent 来说很简单。但它有时候会在一条错误的路上一直狂奔,而我们大多数时候会开多个 session 并行执行多个对话,执行这个对话的时候不会再去看 Codex 具体在做什么。等它已经执行了很多修改、又不是我们预期的时候,再去回滚就很麻烦了。
对新手的可用度比较差
一个模型带给我们这样的感受,它的驾驭感就是不好的:很难跟它沟通,要频繁纠正它,也很难放心让它长时间执行任务。如果没有人为校正、没有 Skill 约束,它会偏激地写各种 fallback 逻辑,越写越差。
如果使用者不太了解项目的具体实现,这些问题会更难发现。比如 Codex 已经在代码里堆积了很多特判,使用者却没有意识到;或者编写 Skill 时只检查当前结果,没有验证换一个 case 后能否继续工作。对新手来说,这种缺少主动澄清的执行方式会增加检查难度。
我现在的处理方式,是在任务开始前把产物面向谁、哪些地方不能改、遇到歧义时先询问写清楚,完成后再检查有没有混入对话备注、事后清洗和特殊分支。这些约束不能彻底消除问题,但能让检查范围更明确。需要长时间无人值守执行时,我仍然不会只看它最后一句「已经完成」,而是会检查实际改动和测试结果。