前两天 DeepSeek V4 Flash 正式版发布了。这个模型用很低的价格给出了很强的能力,并且完整支持 Responses API——Codex 正是通过这个格式与模型交互的,所以 DeepSeek V4 Flash 很适合配到 Codex 上使用。DeepSeek 官方目前还没有第一方的 Agent 工具,而 Codex 本身的产品功能做得比较完善,两者搭配是一个不错的选择。
这篇分享两件事:怎么在 Codex 里配置 DeepSeek V4 Flash,以及怎么补上它的一个短板——这是一个纯文本模型,不支持多模态,也不支持视觉识别。
在 Codex 里配置 DeepSeek V4 Flash
创建 API key
- 访问 DeepSeek 官网,首页有「开始对话」和「API 开放平台」两个入口,点「API 开放平台」。
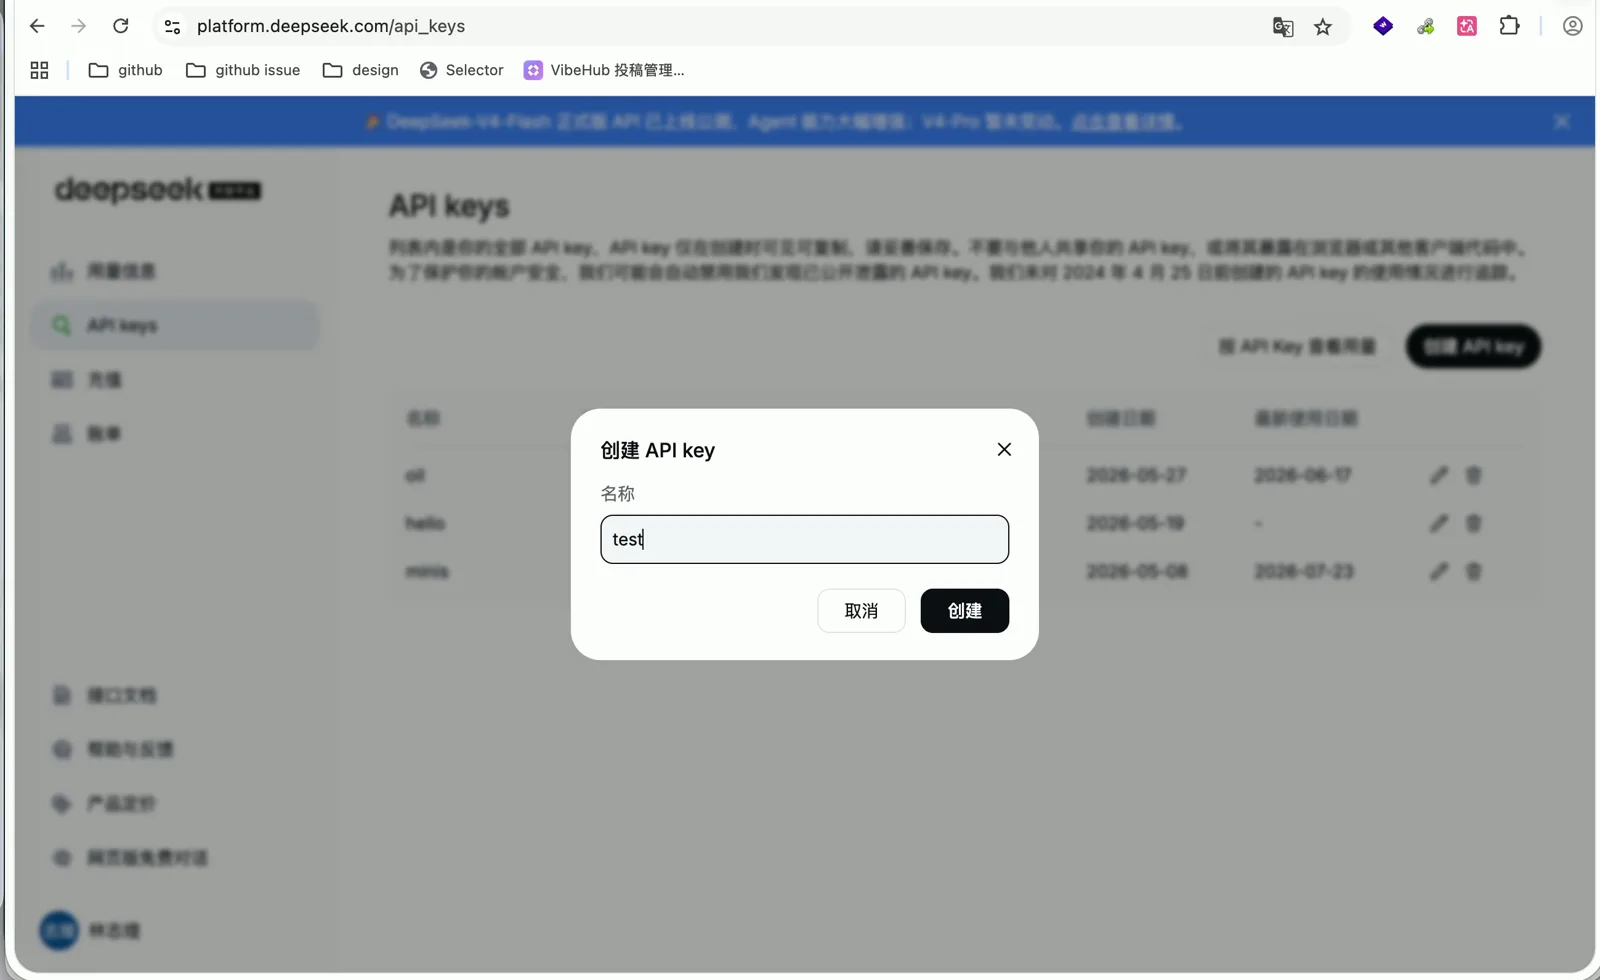
- 点击「创建 API key」,随便输入一个名字,比如我这里输入 test,然后点击创建。
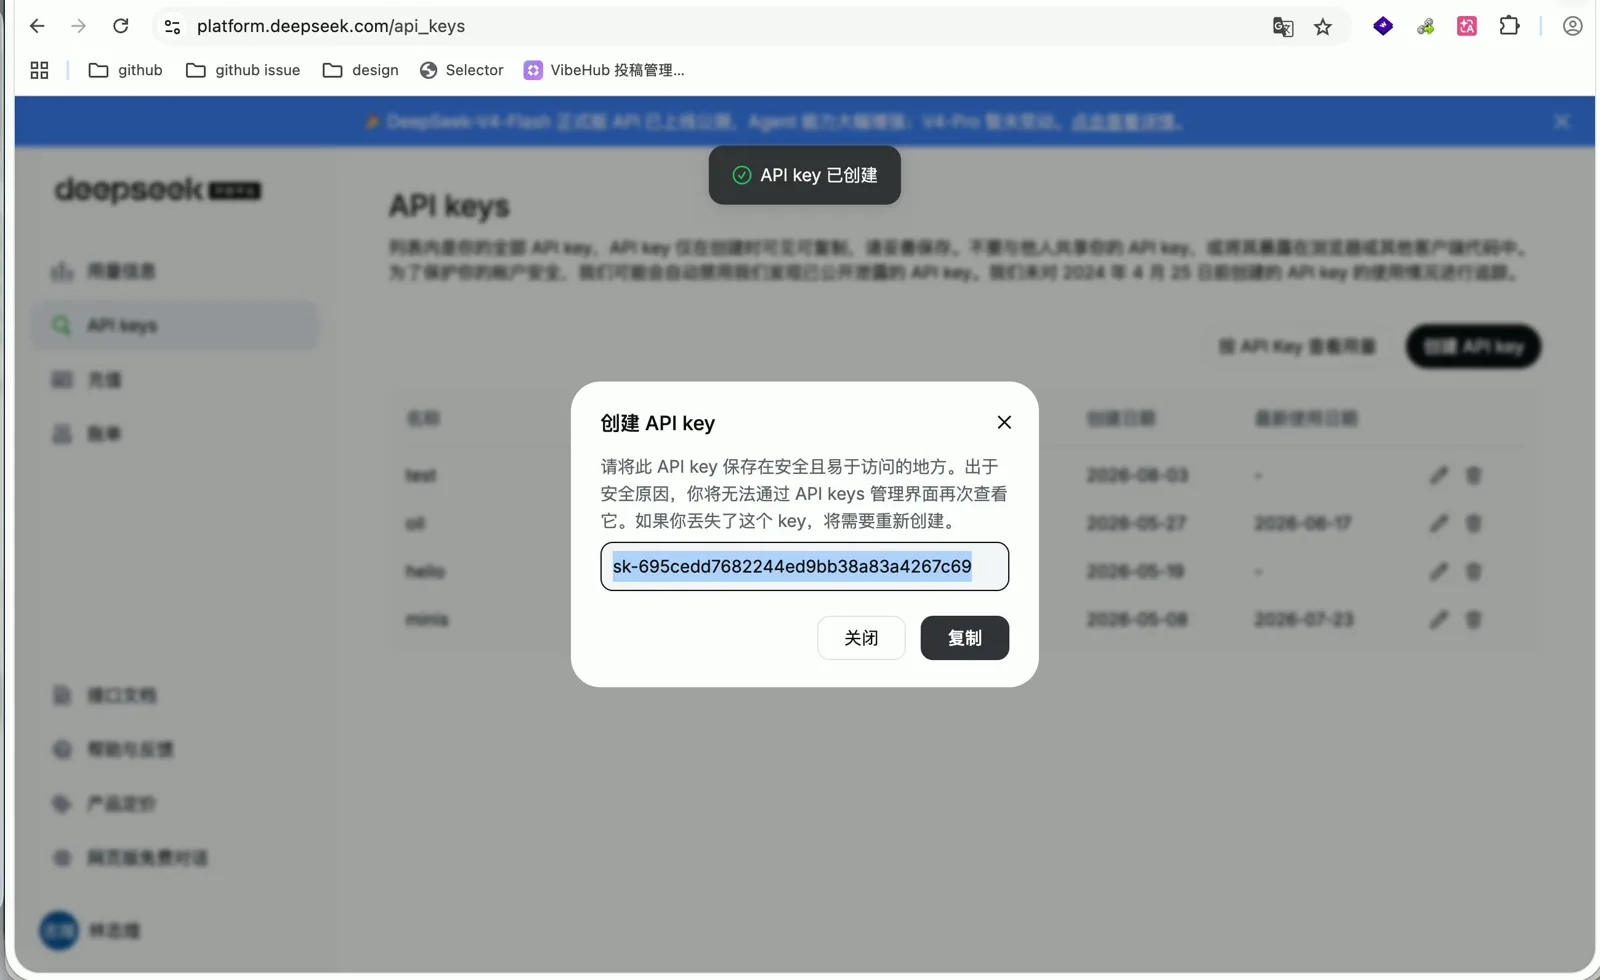
- 创建成功后弹窗会显示这串 key,点击复制之后再关闭弹窗。key 只在创建时显示一次,关闭之后就没有办法在管理界面重新查看了,要自己保存好。
运行一键配置脚本
点击左下角的「接口文档」,在左侧找到「接入 Agent 工具」,点进 Codex 的条目。可以看到目前仅 DeepSeek V4 Flash 支持接入 Codex,V4 Pro 预计 2026 年 8 月初才支持。我要用的本来就是 V4 Flash,所以没有影响。
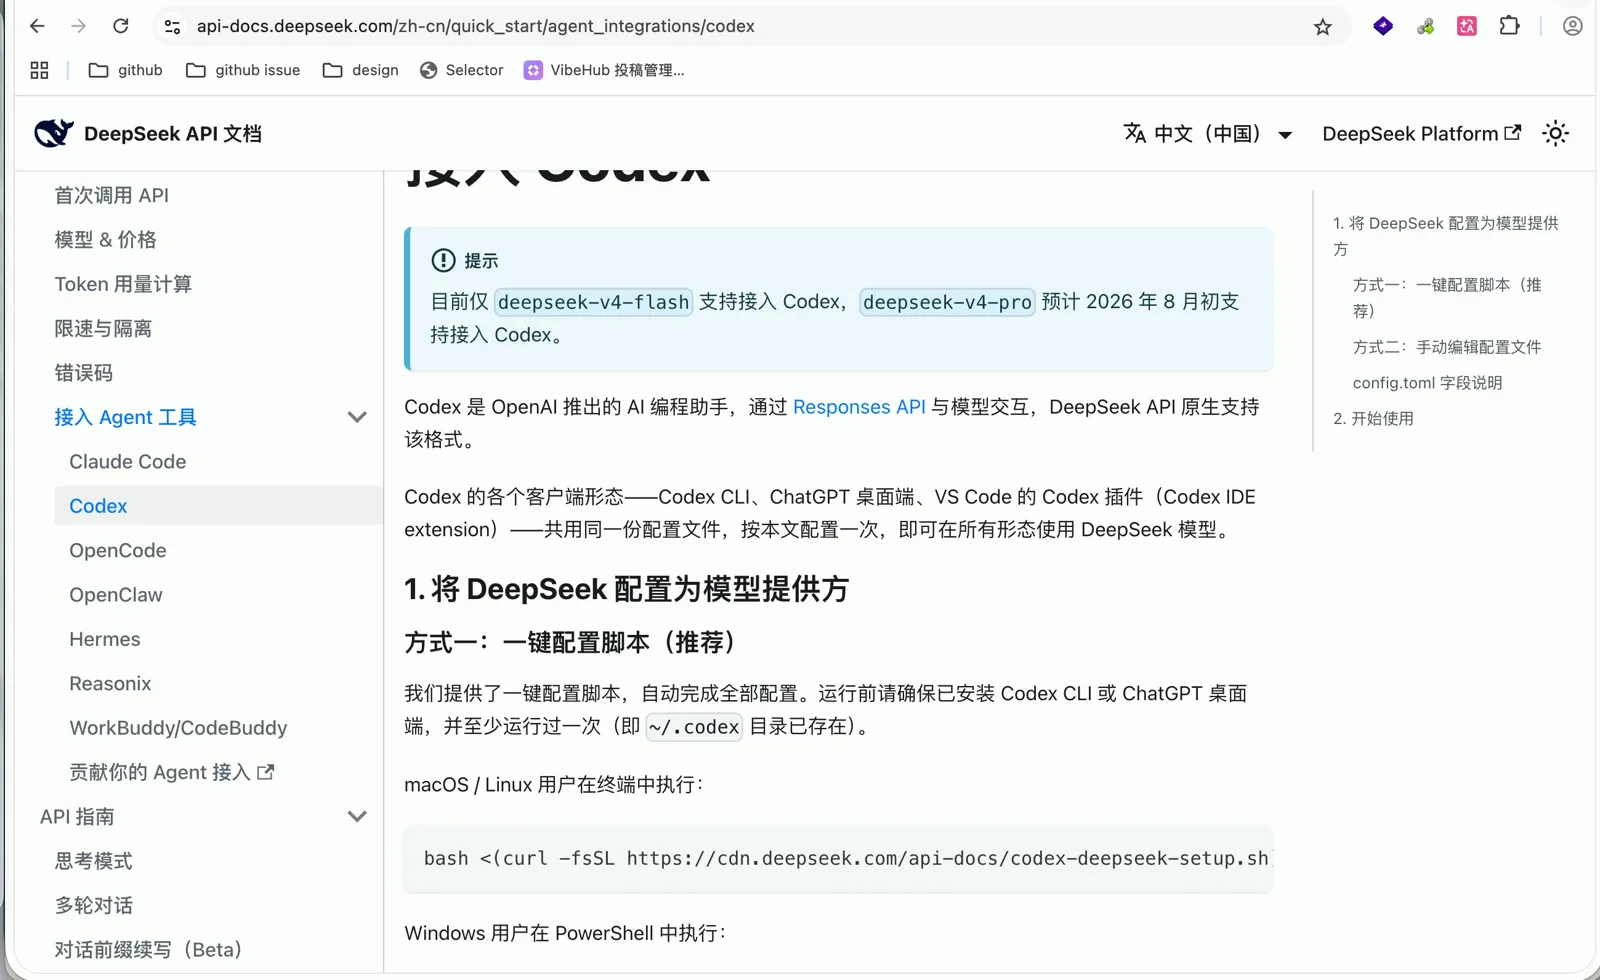
文档提供了一个一键配置脚本,直接复制对应系统的命令就可以。macOS 或 Linux 在终端里执行:
bash <(curl -fsSL https://cdn.deepseek.com/api-docs/codex-deepseek-setup.sh)
Windows 在 PowerShell 里执行:
irm https://cdn.deepseek.com/api-docs/codex-deepseek-setup-en.ps1 | iex
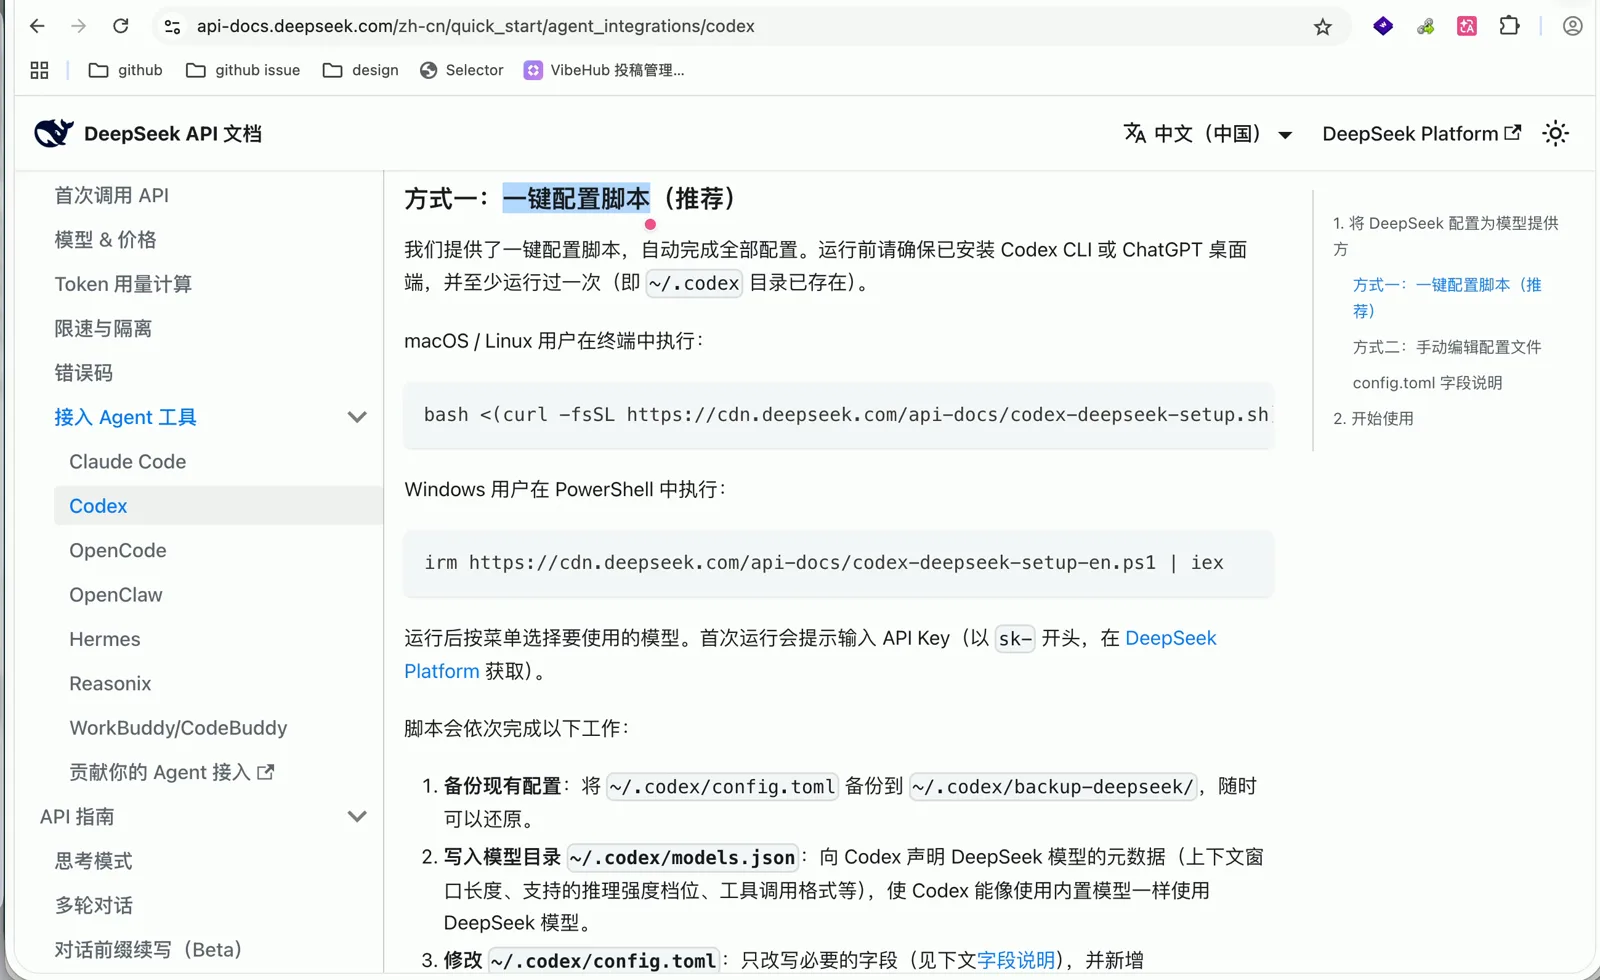
我在终端里粘贴执行,脚本会依次完成这些事:
- 提示选择要使用的模型:选 1 就可以,选项 2 的 V4 Pro 还不支持;
- 要求输入 API key:粘贴刚才复制的那串 DeepSeek API key;
- 自动备份原配置到
~/.codex/backup-deepseek/,然后写入 DeepSeek 模型的元数据,并改写~/.codex/config.toml里的必要字段。
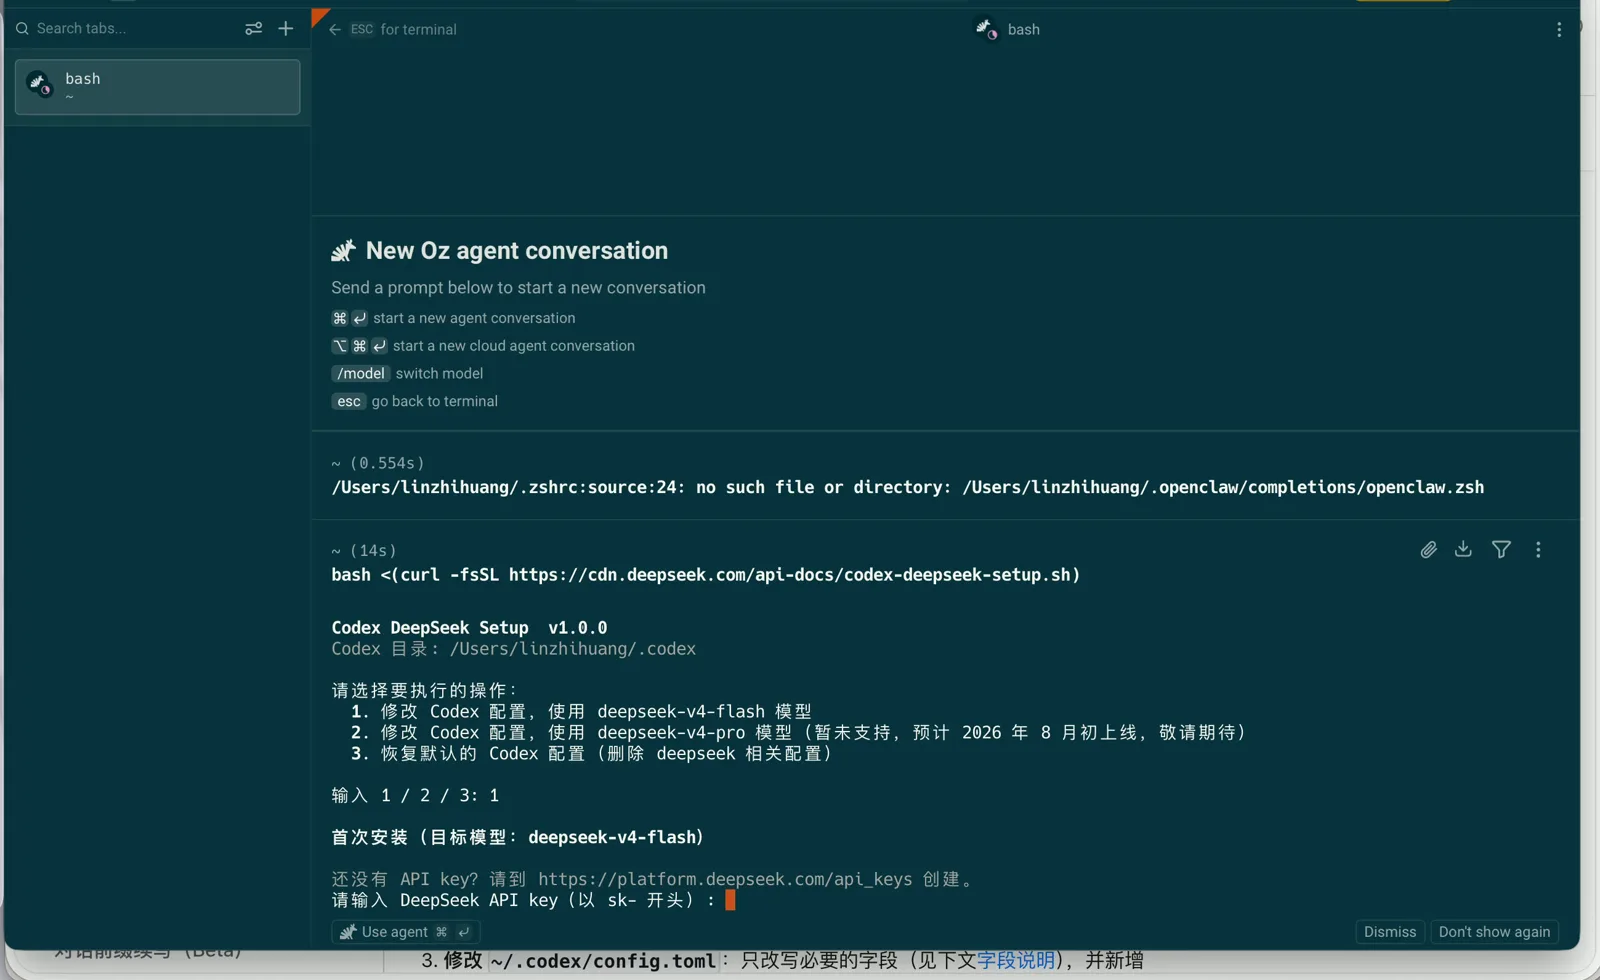
如果之后想还原回之前的 GPT 订阅配置,再次运行同一个脚本,在菜单里选第 3 项,就可以恢复到安装前的配置。脚本不适用的情况,也可以参考文档里的方式二,手动编辑 ~/.codex/config.toml,里面有完整的字段说明。
验证配置结果
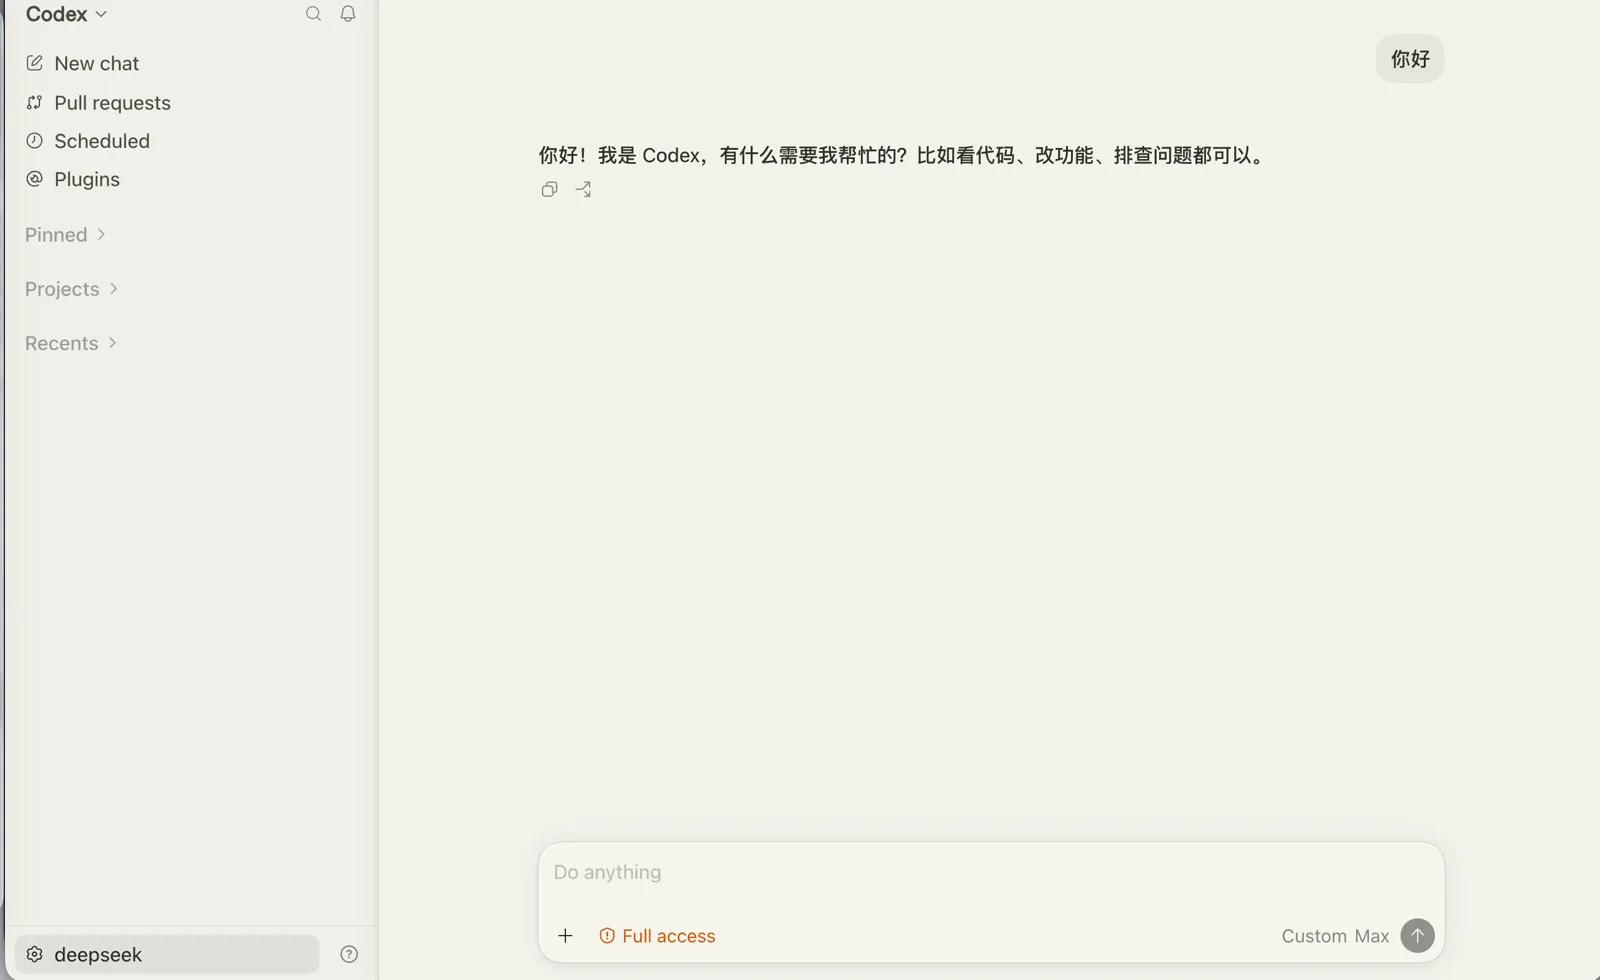
这时候再打开 Codex,右下角的模型标识变成了 Custom,其实它就已经是 DeepSeek 模型了。我发送一句「你好」,它正常响应,左下角显示 DeepSeek,说明配置成功。界面里原本 Codex 的一些功能展示也会跟着变化。
用 see Skill 补上视觉识别
DeepSeek V4 Flash 是纯文本模型,本身不能看图。要让它在 Agent 里具备多模态识别的能力,需要接入另外一个模型。这里用我自己写的一个 Skill,叫 see Skill(github.com/oil-oil/see-skill),它可以帮助纯文本模型在使用 Agent 的时候获得查看图片的能力:
- 支持 OpenRouter、ZenMux、TokenDance 等聚合平台,这些平台的 API key 都可以直接用,配置好之后识别默认走 Qwen3.7 Plus 模型;
- 即使不配置任何第三方模型,它也会主动调用电脑原生的 OCR 能力,比如 macOS 自己的视觉识别、Windows 自己的视觉识别。
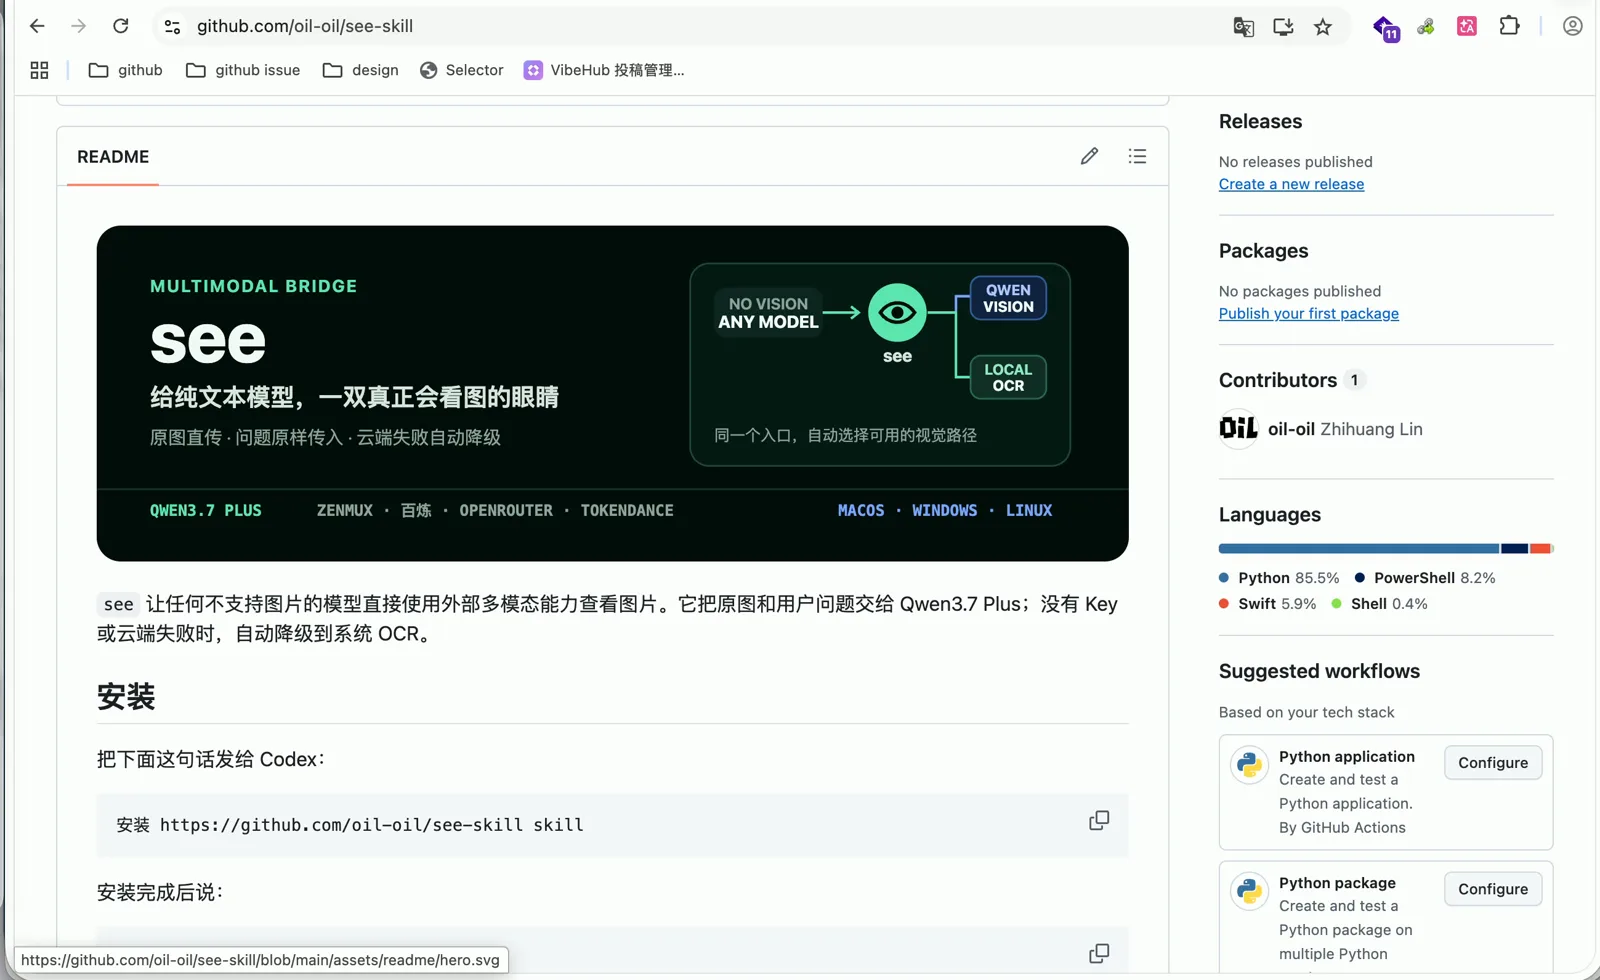
安装方法很简单,把下面这句话复制下来,粘贴到 Codex 里发送给它,它会自己完成安装:
安装 https://github.com/oil-oil/see-skill skill
实际识别效果
安装完成后试一下。输入斜杠 see,即使不输入斜杠也没关系,然后随便截一张图发给它。
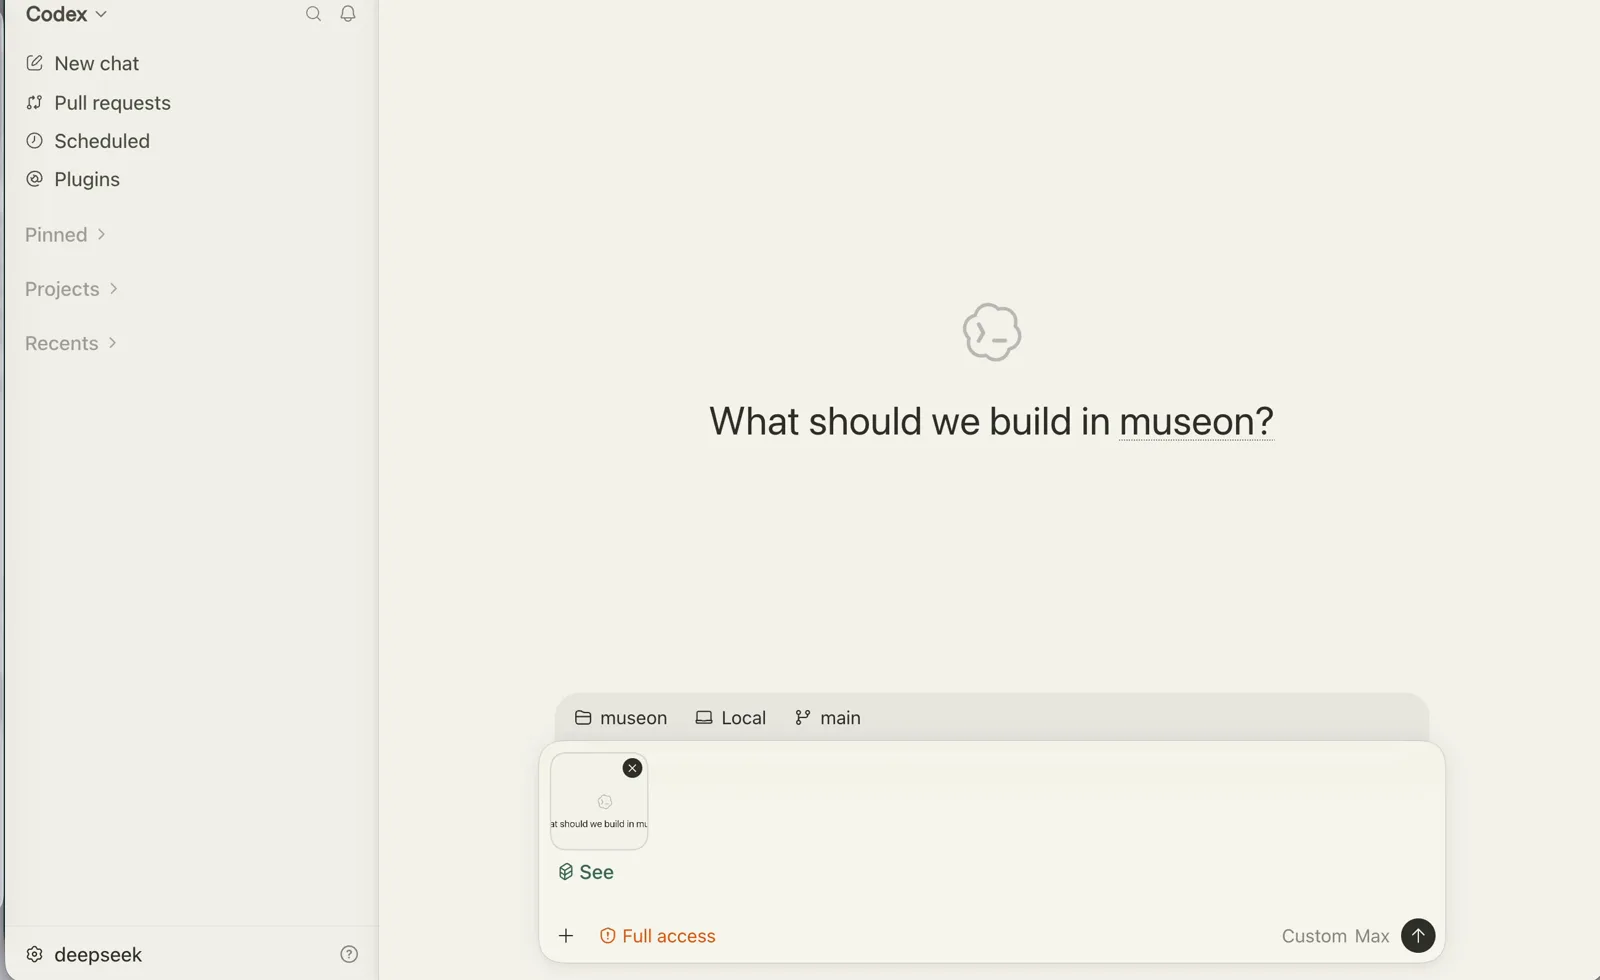
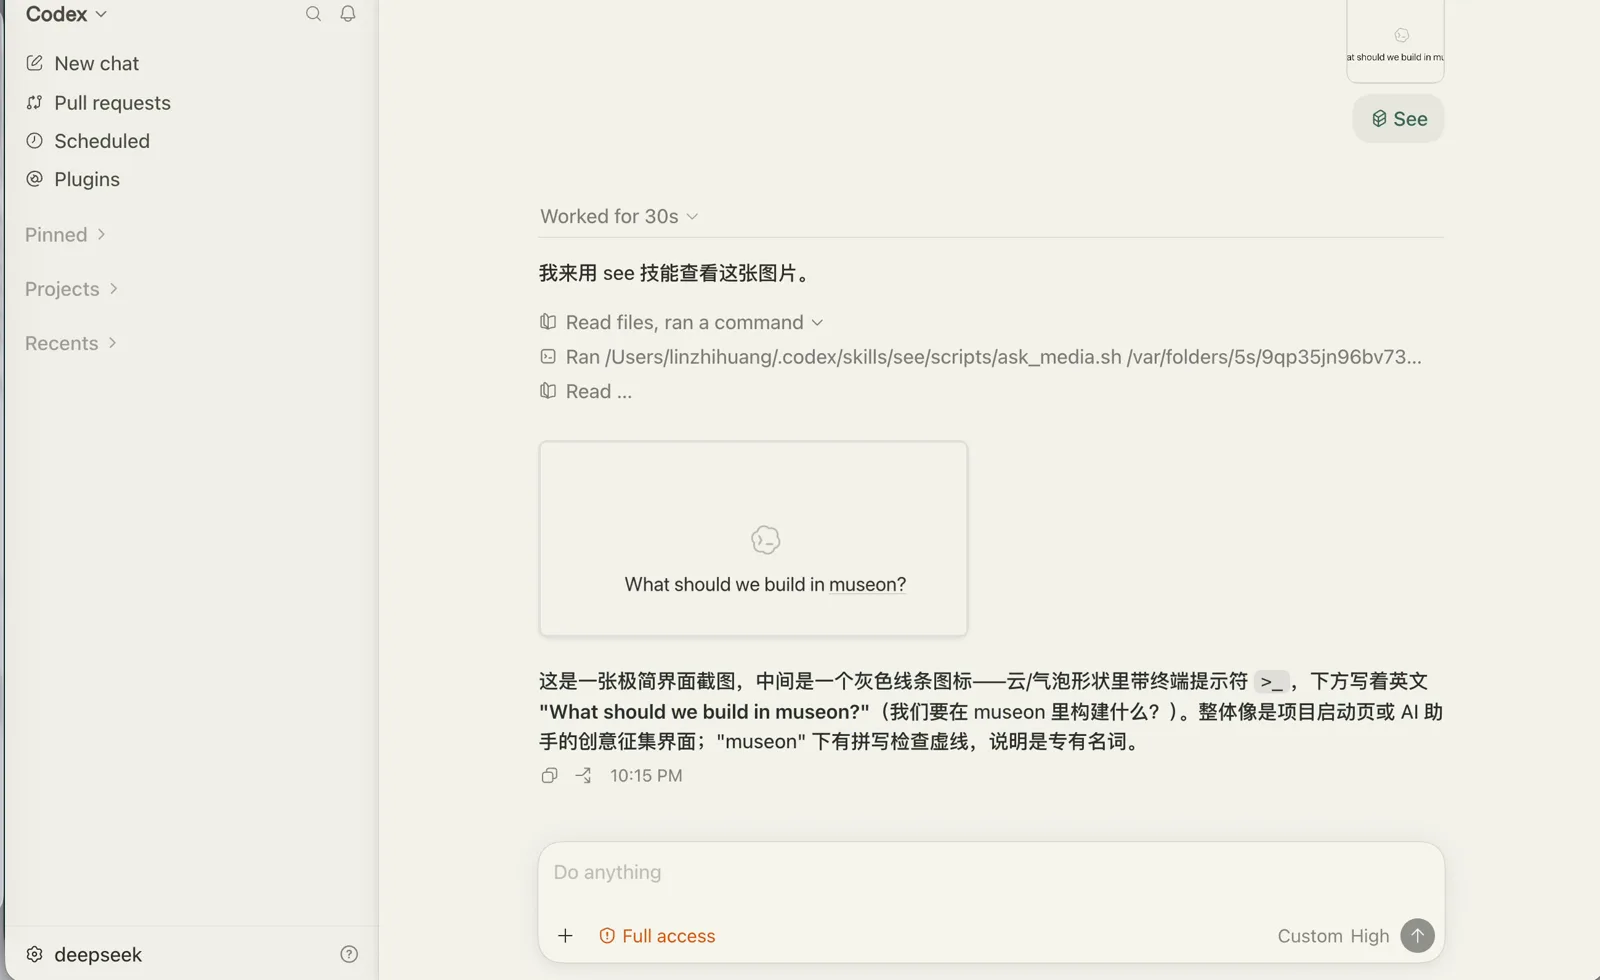
可以看到它已经能够描述这张图片的内容:中间是一条灰色的线,语音气泡形状里面带终端提示符。纯文本的 DeepSeek 模型现在能看图了。
接着我让它把 API key 去掉,再使用原生的视觉识别能力跑一次。它调用了 macOS 原生的 Vision OCR,识别出了图片里的文字「What should we build in museon?」,置信度 100%。
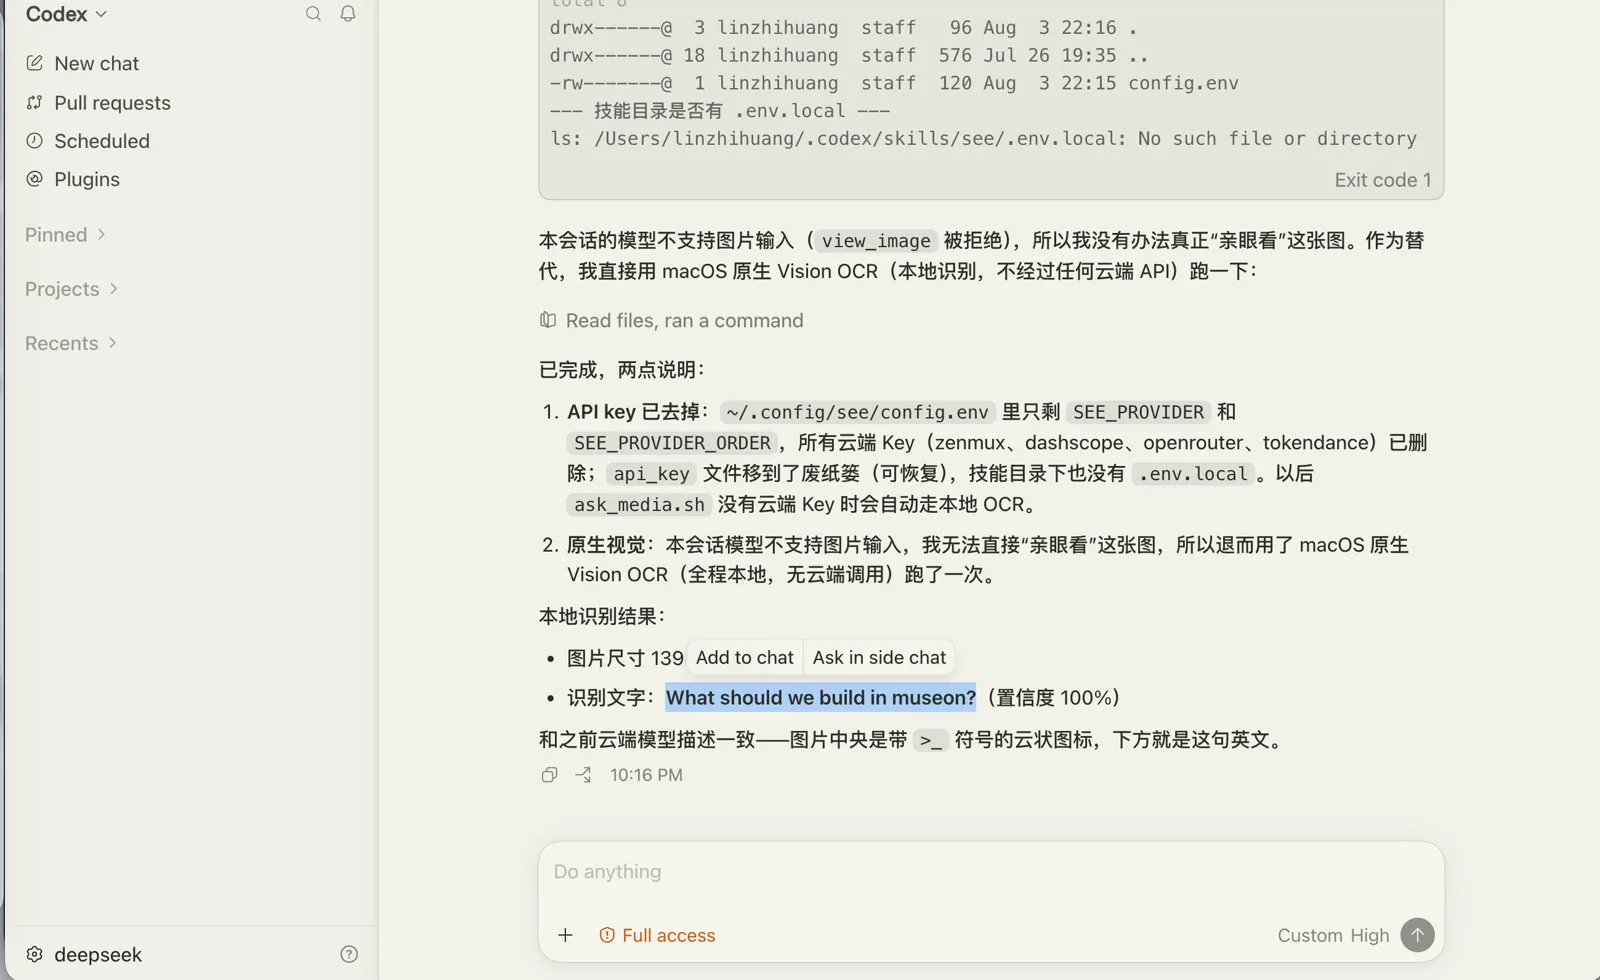
两种方式的区别很明显:
- 云端模型:能够理解画面内容,描述布局、形状和含义;
- 本地 Vision OCR:只能看到图片里的文字,像我们前端开发里常见的 UI 查看需求,它就没办法处理了。
所以建议大家还是自己配一个单独的视觉识别 API key,让 see Skill 走云端模型,识别的内容会完整很多。