我最近做了一个生成视频封面图的 skill。做它的原因很直接:我之前的视频都是直接用视频首帧当封面,效果很不吸引人,前阵子我发现封面的点击率很低,所以决定认真处理一下这件事。
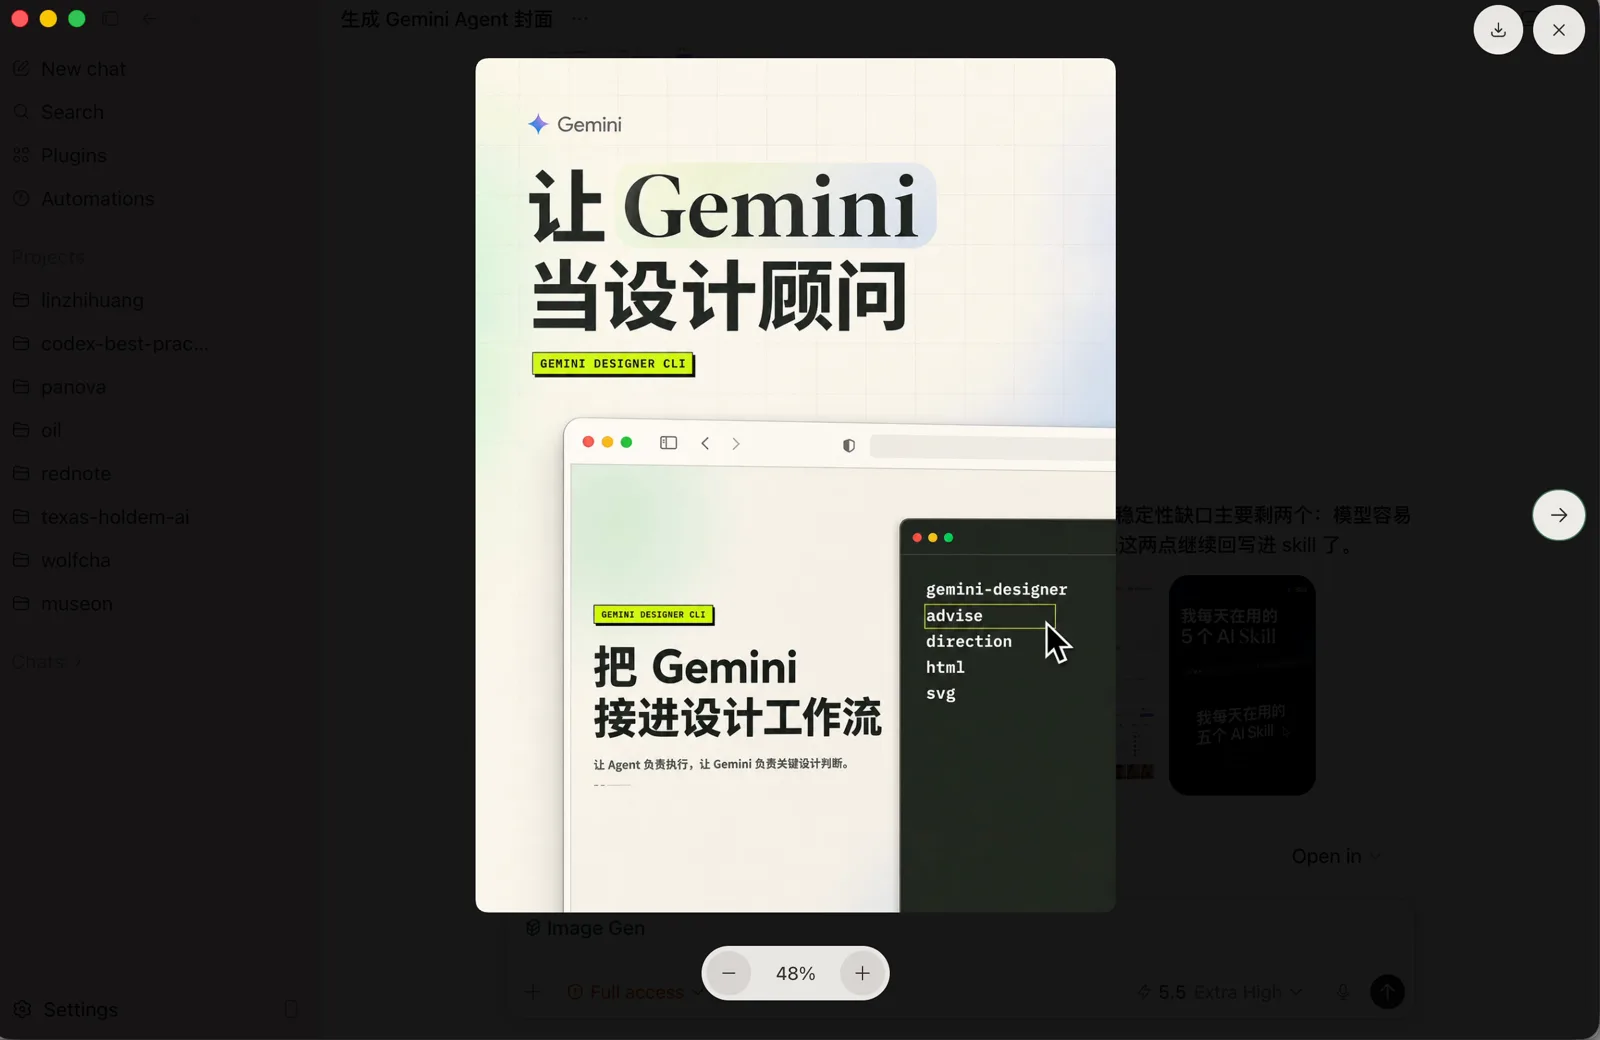
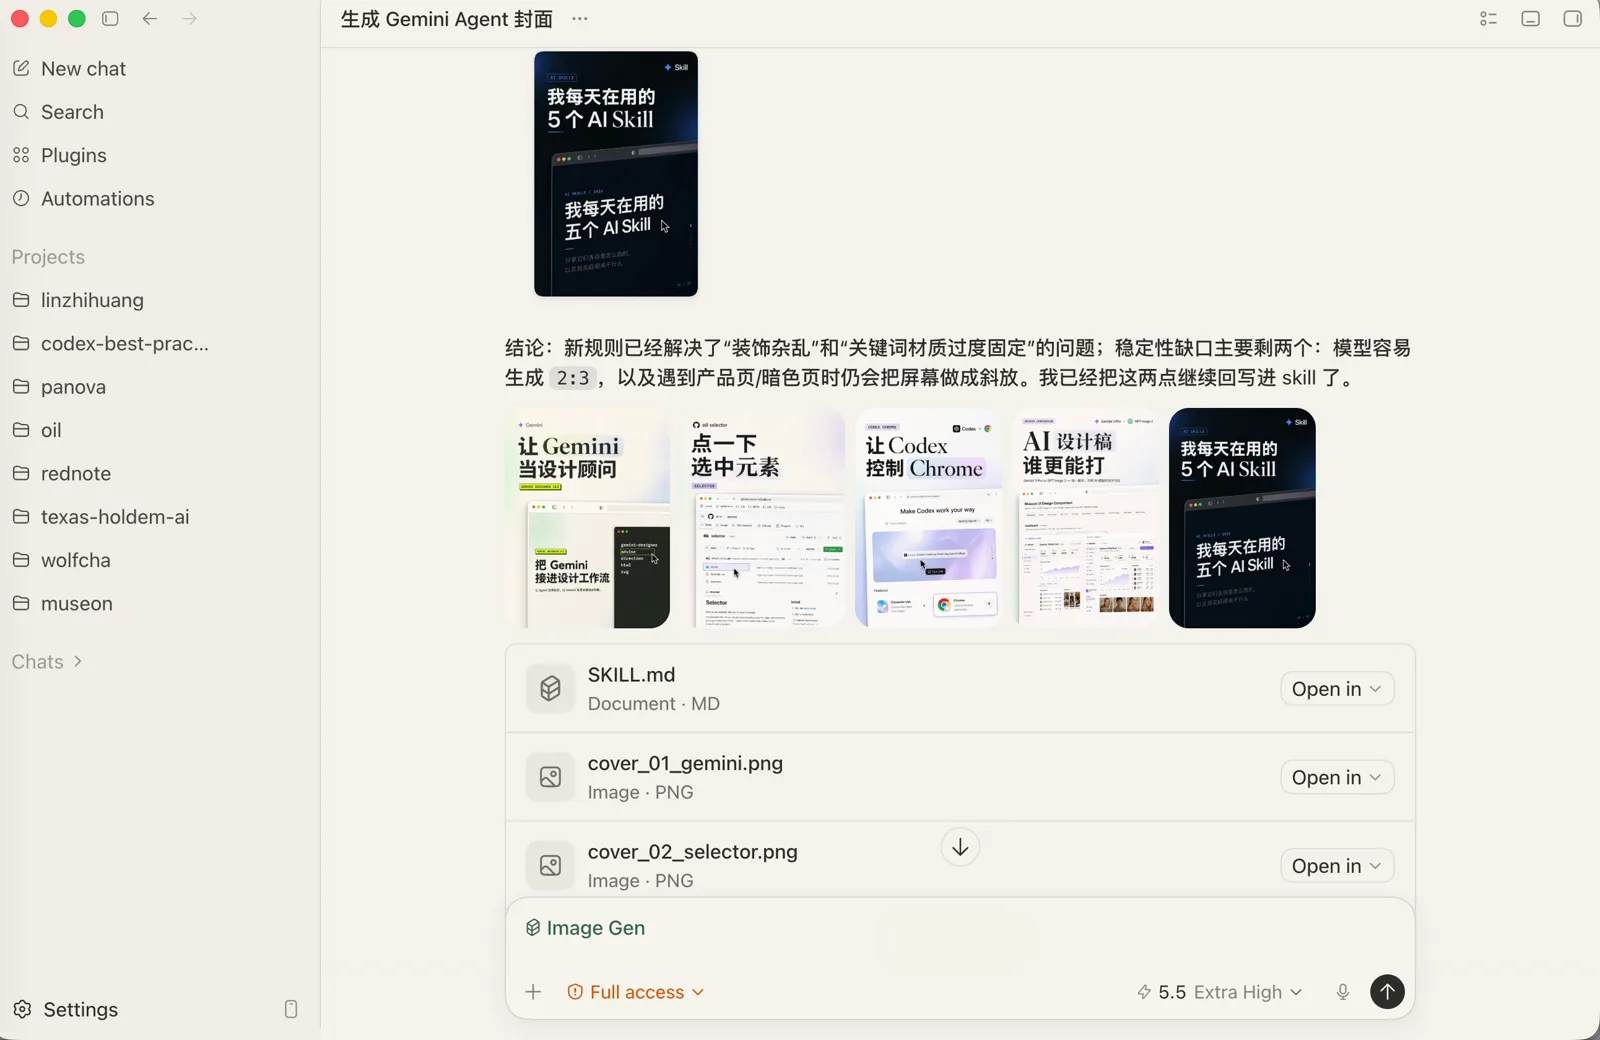
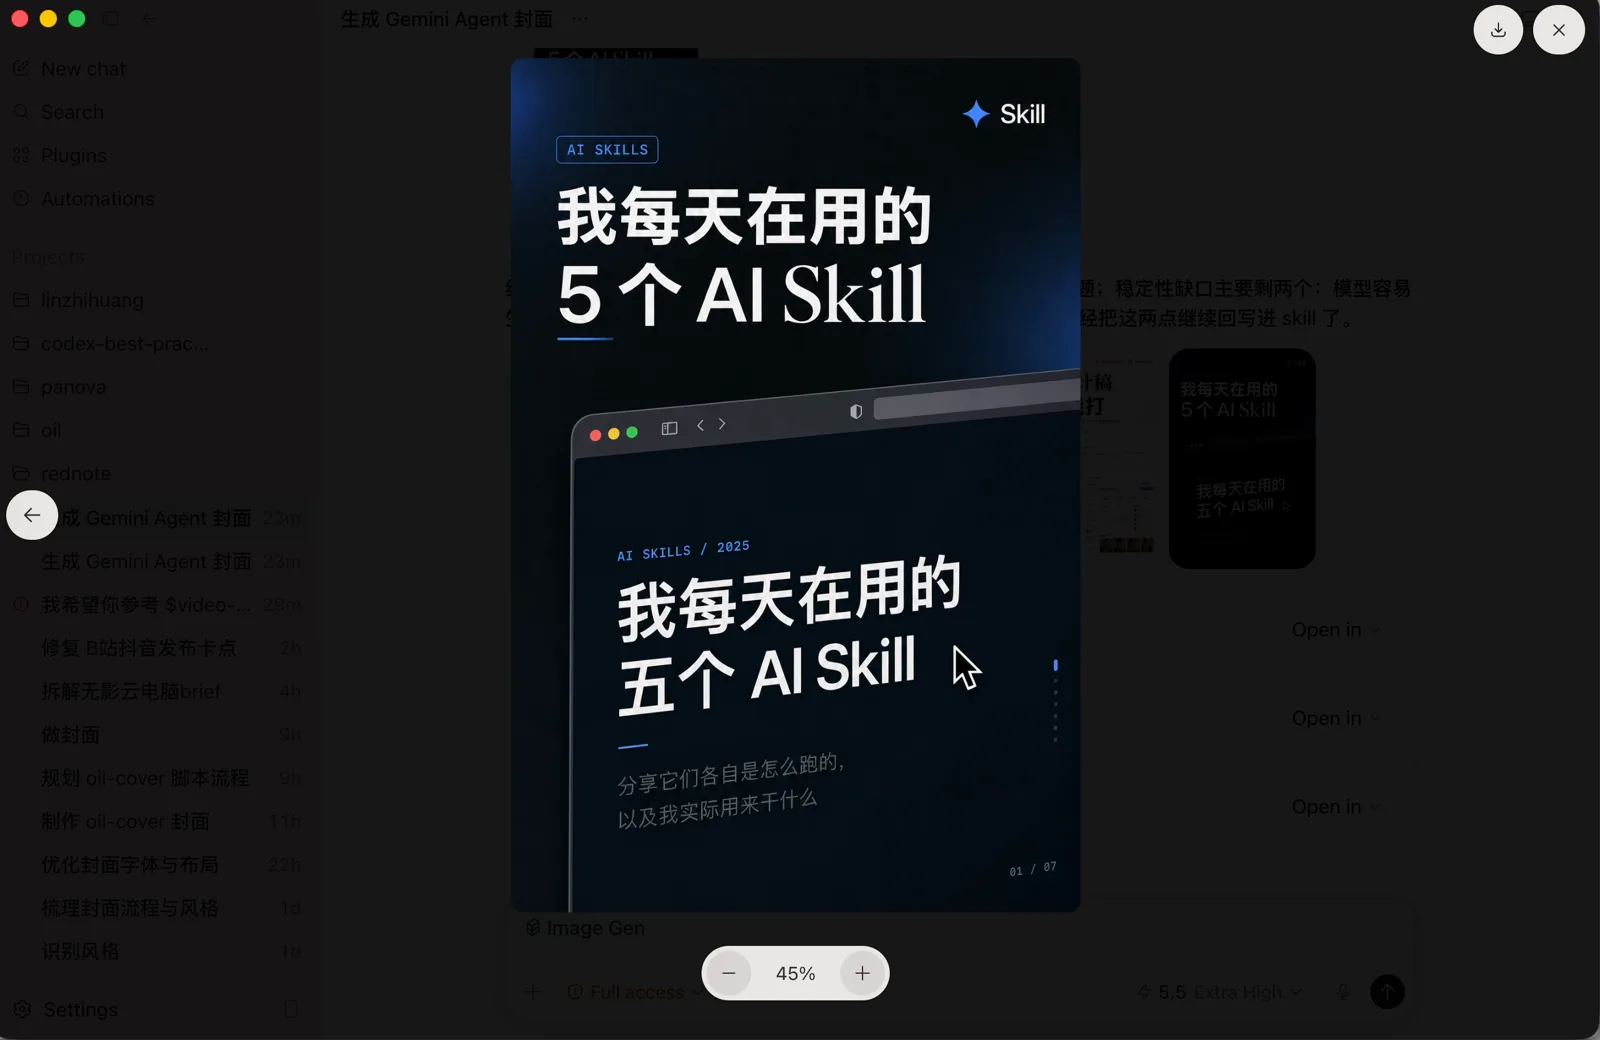
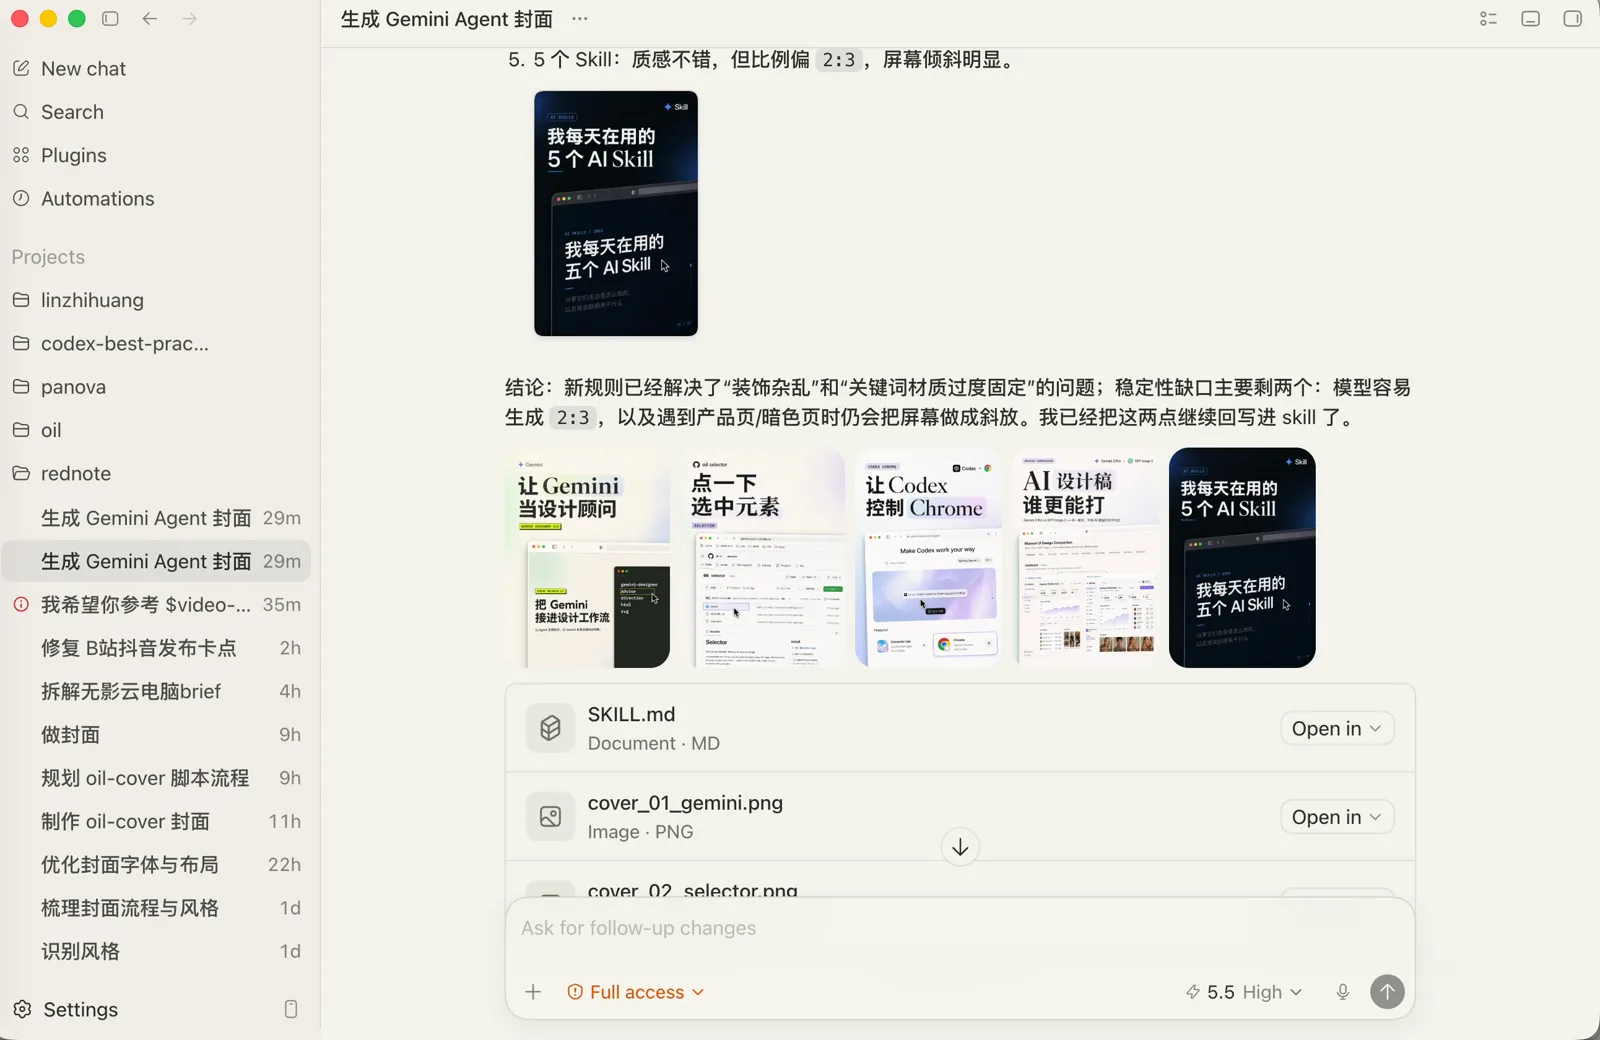
这个 skill 生成的封面是统一的风格:顶上有一个标题,底下是一个类似屏幕截图的效果,屏幕只露出一部分,文字带一些装饰,还会结合视频里讲的厂商 logo 来展示。横版和竖版都能生成,对应不同平台的规范。
生图工具
生图用的是 GPT Image 2。Codex 里内置了一个叫 ImageGen 的 skill,通过斜杠命令触发之后,它会读取一份生图规范,然后调用 Codex 内置的生图工具,背后的模型就是 GPT Image 2。有了这个工具,就可以直接在 Codex 里生图。
封面的构成
一张封面主要分为两个部分:上面的文字和下面的屏幕截图。
文字部分比较简单,给它一个标题,告诉它结合衬线和非衬线字体,再加一点背景装饰元素,它就能做得不错。比较难的是屏幕截图怎么展示得好看。我之前做产品图有一些心得:给屏幕截图套上一个浏览器或者电脑的壳,会比单薄的一张截图好看;屏幕只露出一部分,也比整个屏幕完整露出来更有设计感。所以提示词里我让它把屏幕只露出了一部分。
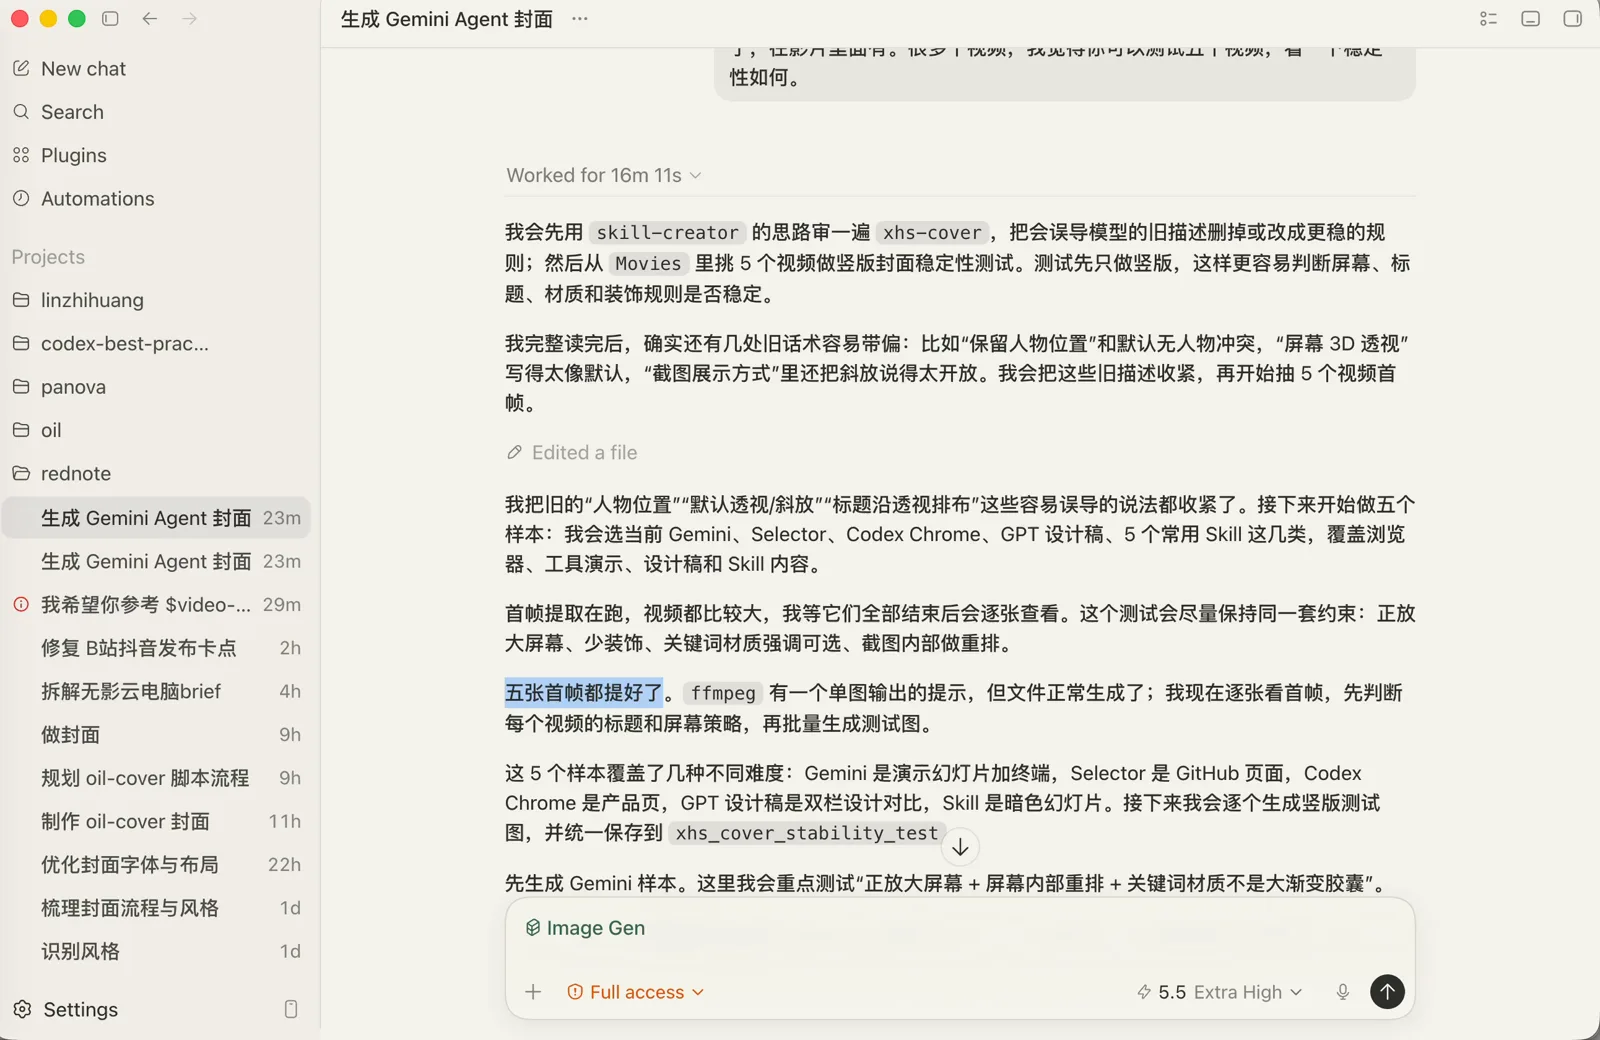
屏幕里放什么图片,是从视频里选的。我现在每个视频都有 Codex 转写出来的字幕,它会基于原始视频抽帧,比如先提取五张首帧,逐张查看;首帧不合适就继续提取视频里的其他帧,再判断哪一张更适合放在封面上做视觉传达。
选好截图之后还会做一层美化。屏幕截图有时候很杂,上面可能还会出现我的人脸,显示完整的话它会先把人脸去掉;另外它会把截图里的一些 UI 放大,加上斜向透视的效果,把重点内容提到左侧来,这样更符合封面的视觉传达。
提示词的打磨
这个过程不是一蹴而就的,中间生成过很多效果不好的图,比如风格比较土的版本。
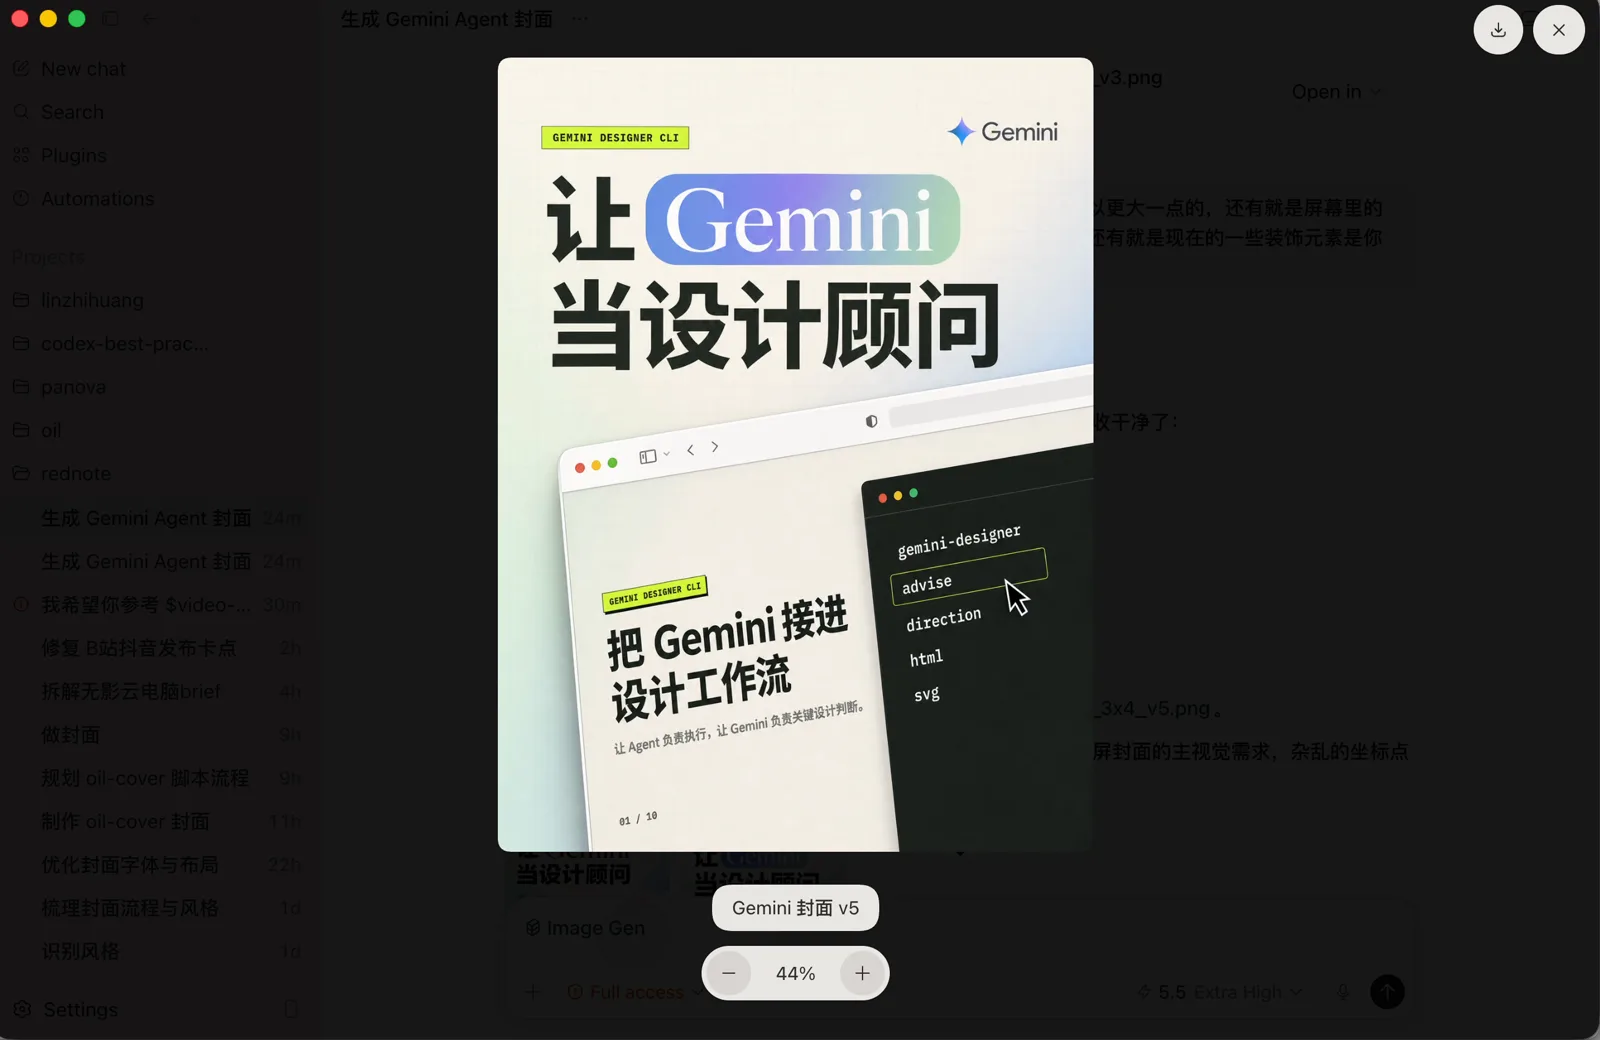
后续生成封面都是在新的对话里进行的,没有之前的历史记录。要让它稳定,就得把流程写清楚,让每一次新开话题都能生成好。我还加了一个做法:把 Gemini、GitHub、Codex 这些常见 AI 工具的图标资产保留下来,生图的时候根据视频主题带上对应的参考图。讲 Codex 就带 Codex 的图标,讲 Gemini 就带 Gemini 的图标,生成的图片整体会更有设计感。
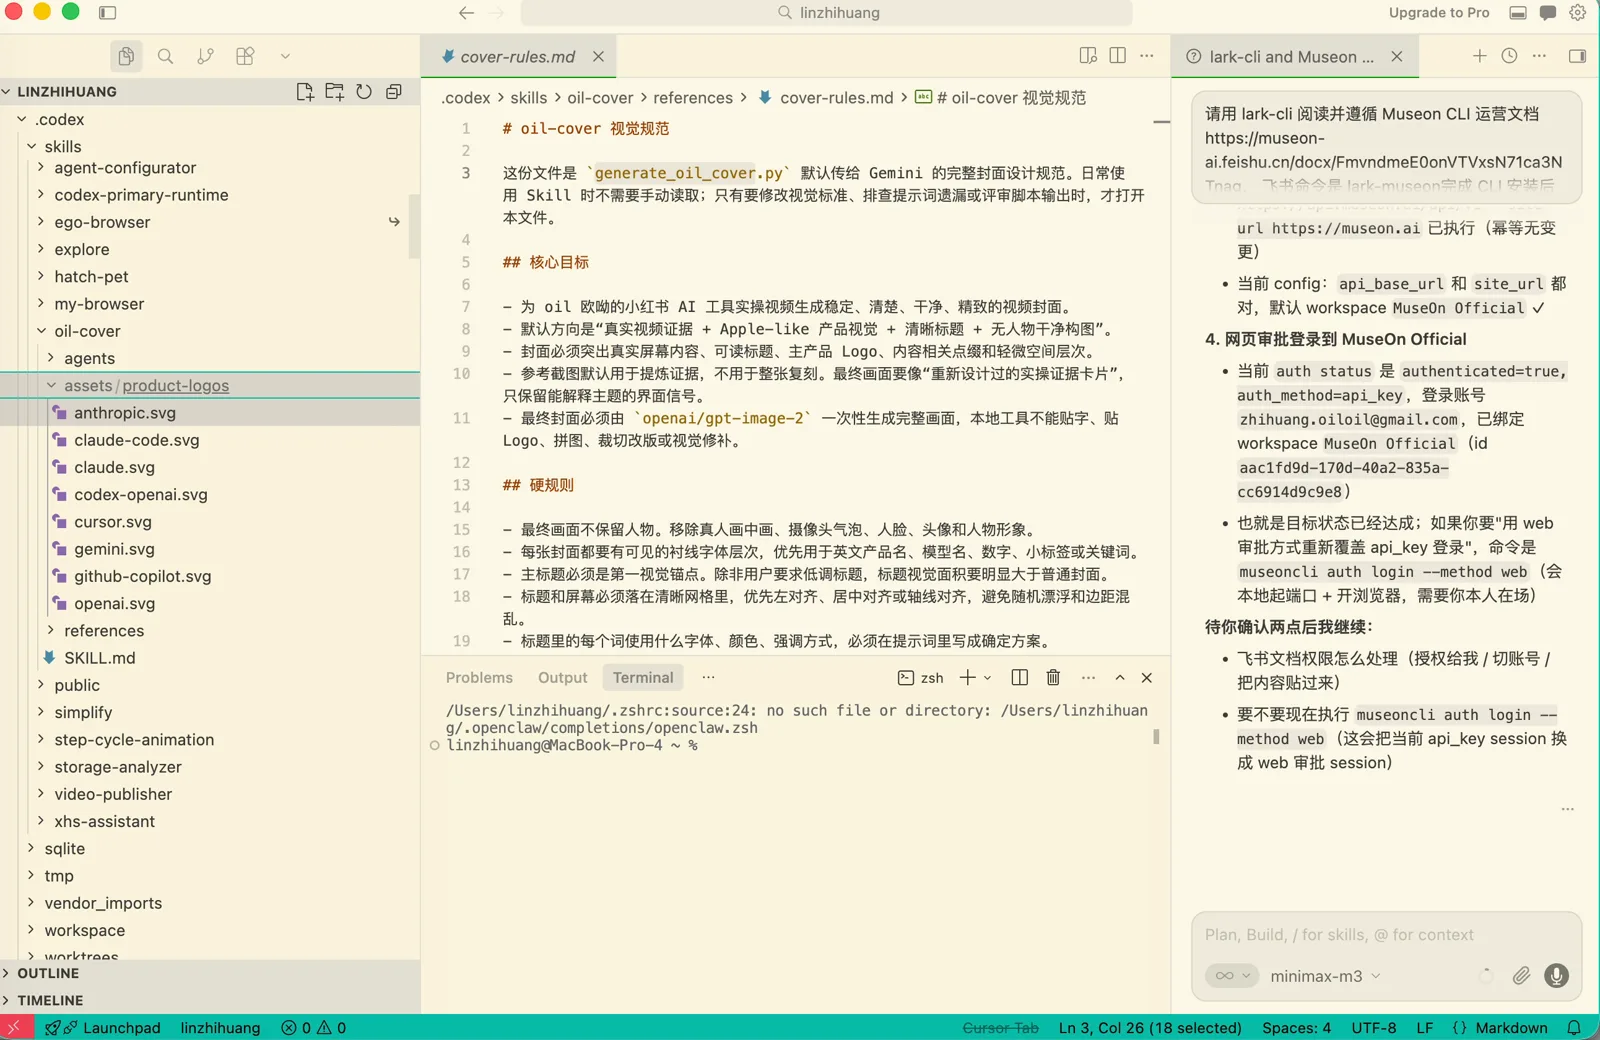
这个 skill 叫 oil-cover,里面有一份给主 Agent 看的硬规则,底下还有一个提示词的骨架。骨架的作用是让每一次生图的结构相对稳定,但稳定的同时又不能完全趋同,要留一些能变的点。比如背景配色会跟随截图来变化:截图里有绿色蓝色的渐变,背景就加绿色蓝色的渐变;截图是粉色系,背景就是紫色的渐变。整体看起来会舒服很多。
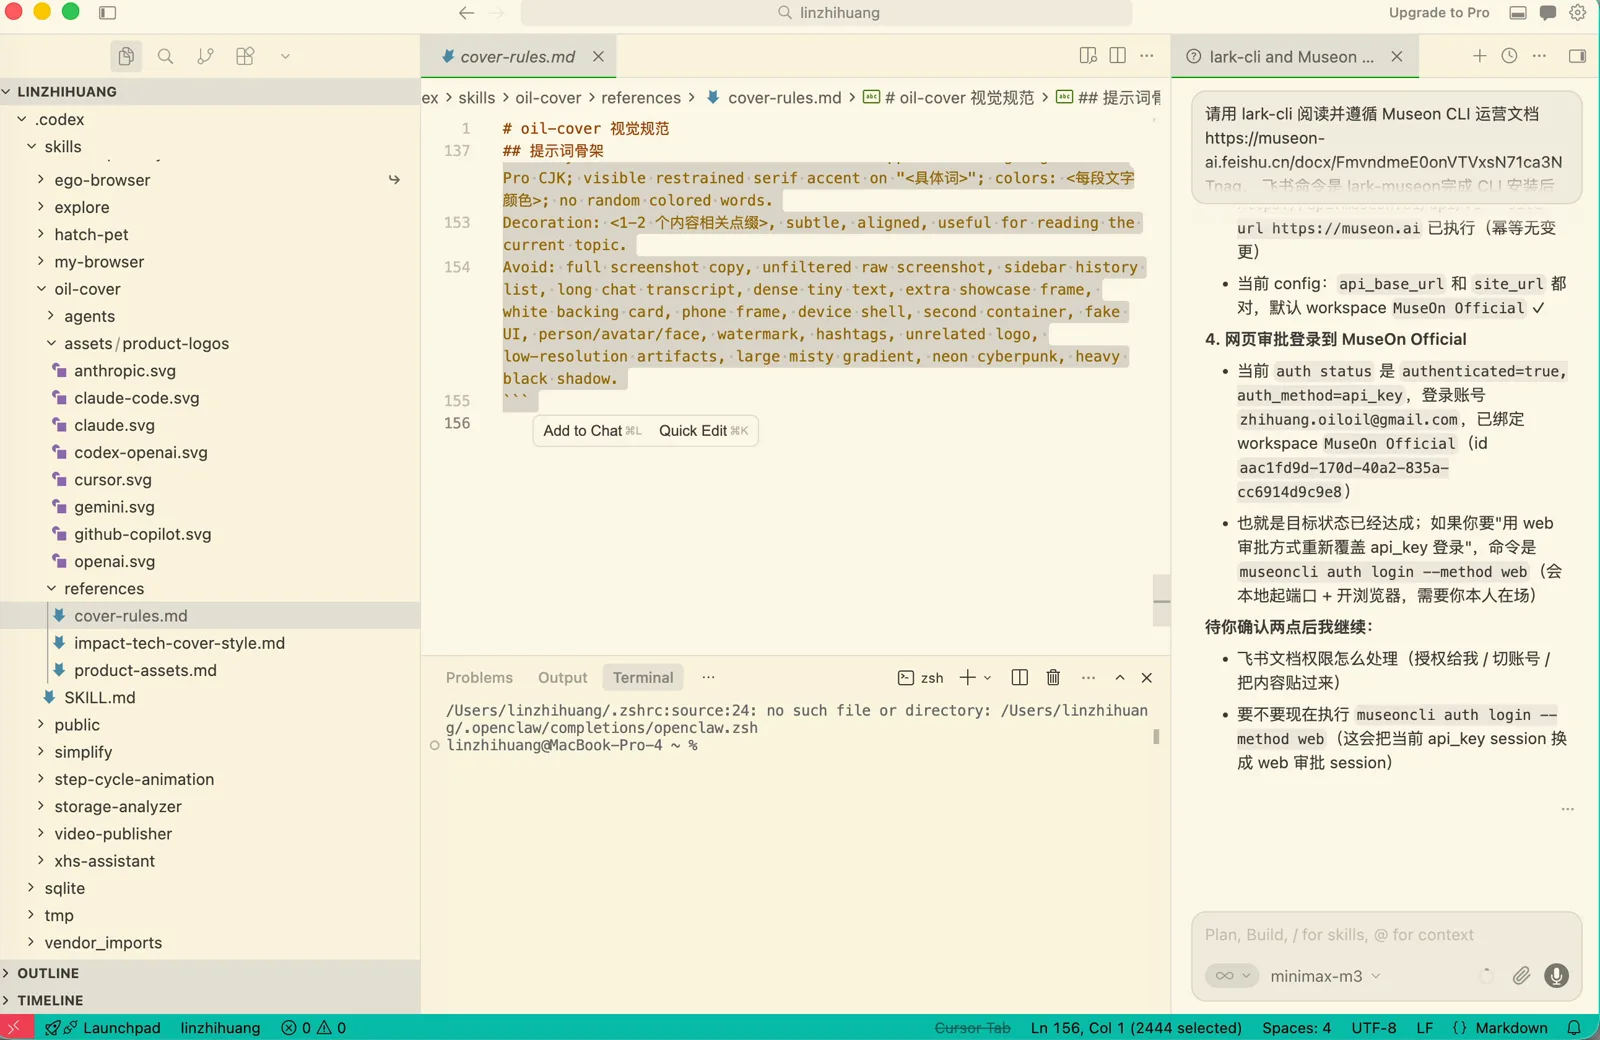
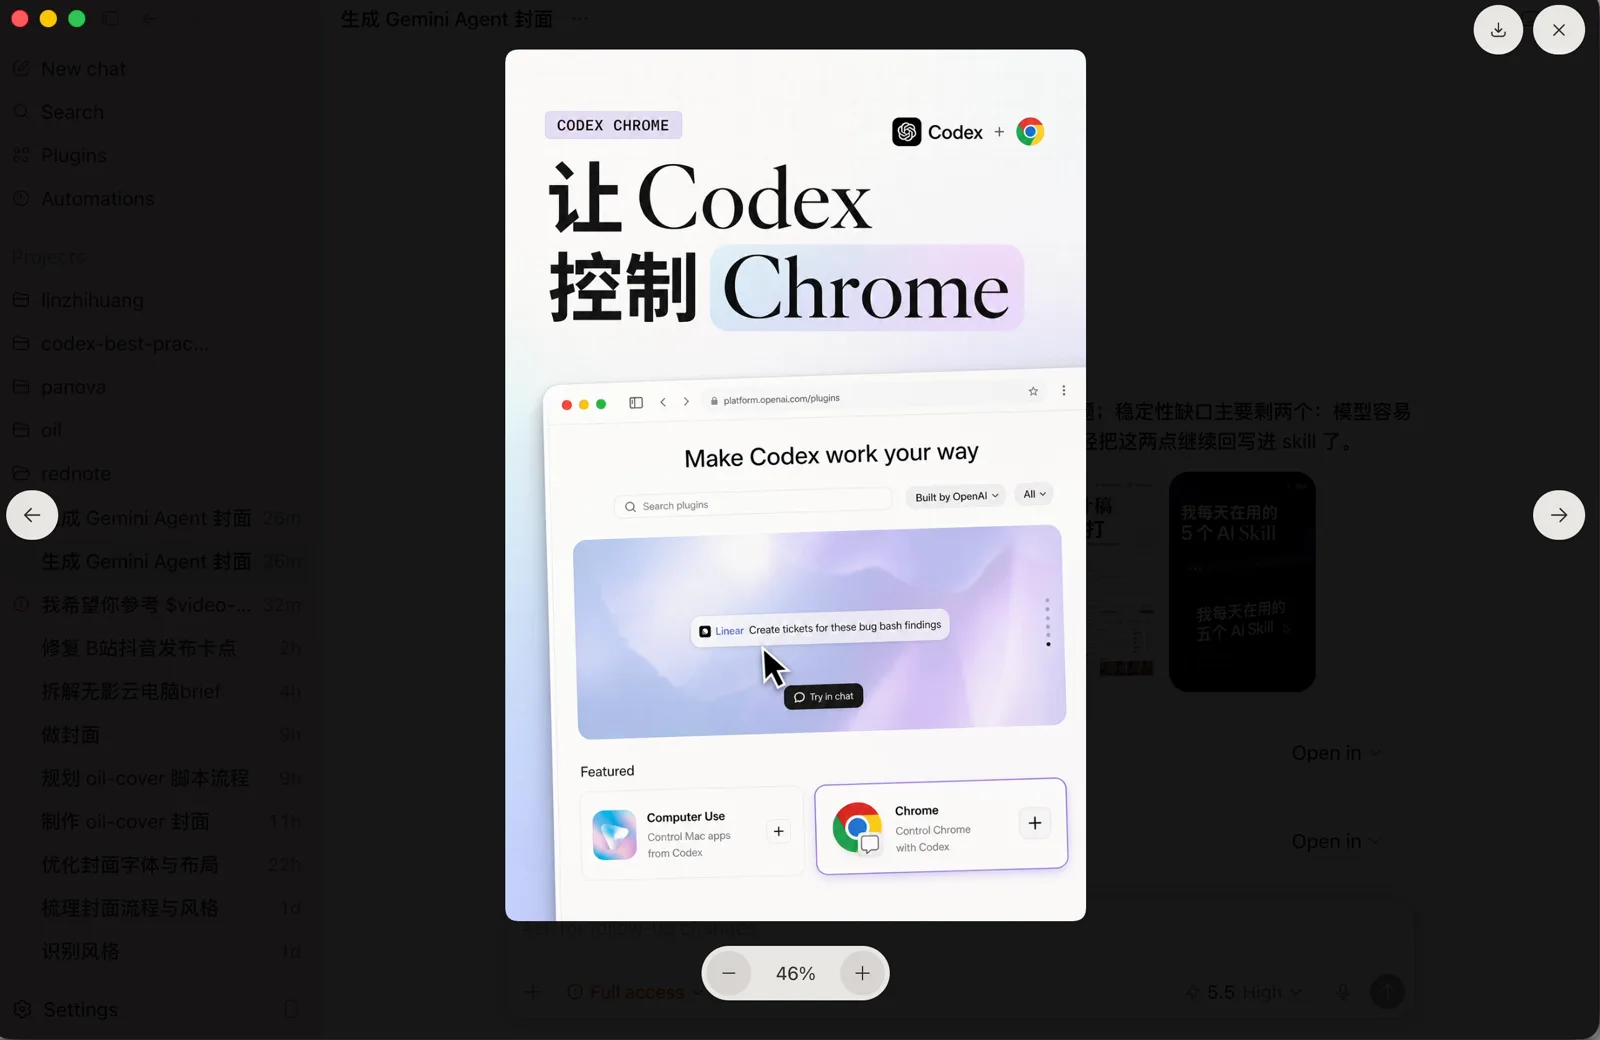
打磨的主要工作就是提示词的写法。Codex 写出来的提示词和生图模型的理解之间有差距,需要人介入,不断调整。比如中途有一些失败的版本,把屏幕里的内容生成得失真了,配色也不好看。这些是 Codex 自己写提示词经常遇到的问题,解决办法就是对提示词做更严格的限制,不断注入人的理解,反复测试,把最好的一版写回 skill 里。
把流程写成脚本
还有一个比较重要的处理。skill 写好之后,我没有把它写成一份文字版的流程指导,让 Codex 每次自己去执行。那样做的话,每次新开话题它都要自己抽帧、再调用 ImageGen 生图,稳定性不够。我经常是在它帮我剪完视频、生成好字幕之后让它生成封面,这时候上下文已经不那么干净了,再让它按流程执行,它有可能注意力不集中,生成结果跑偏。
这个流程非常线性,所以我把它写成了一个脚本:
- 抽帧和视觉识别交给 Gemini 执行。Gemini 没有任何历史上下文,把视频给它,它自己选出其中最好的几帧。
- 选好之后调用外部的 GPT Image 2 生图模型生成封面,整个流程不在 Codex 里面完成。
- Codex 要做的就是调用这个 skill 执行脚本,把视频参数传过去,拿到生成的图片之后,再结合视频发布的 skill 把封面发布出去。
这样做相当于把原本指导 Agent 执行的工作流变成一个固定的工作流,不让主 Agent 的基座模型去执行,而是让一个外部的、无状态的模型去执行,会稳定很多。后续的视频我会逐步把旧封面都换成新生成的版本。