这期分享 Zara Zha 开发的一个 Skill:codebase-to-course。它可以把一个代码库转换成一门可视化的课程。
如果我们是没有技术背景的 vibe coding 新人,用 AI 写完代码之后想学习其中的实现原理,就可以用这个 Skill 把自己的代码仓库转成一门课程。它会告诉我们代码具体在哪个位置、工作原理是什么。我们不需要掌握具体语言的语法,但可以知道每个文件分别是做什么的。
这个理念我很认可。我自己接触一个新项目的时候,也会让 AI 扫描整个仓库,生成一份可视化的 HTML 报告。Zara Zha 把这个做法做成了一个 Skill,我体验了一下,使用体验不错,下面是完整的使用过程和我发现的问题。
安装 Skill
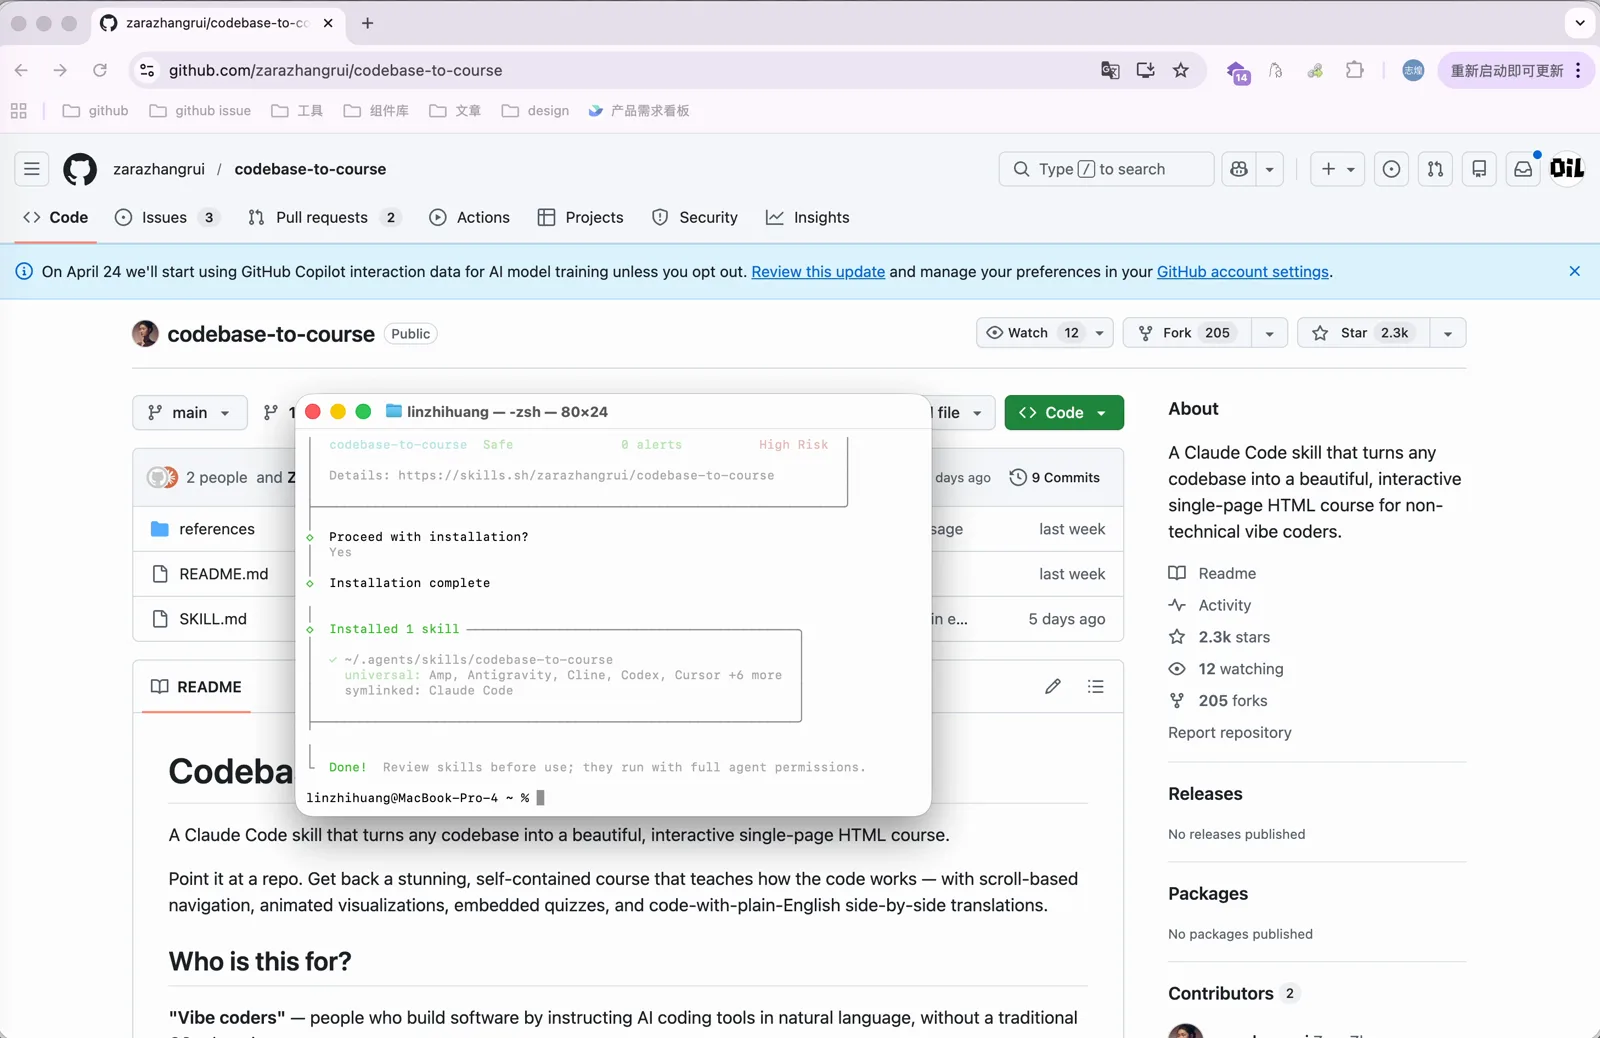
Skill 的仓库在 GitHub 上:zarazhangrui/codebase-to-course。
打开终端,用 npx 安装:
npx skills add zarazhangrui/codebase-to-course
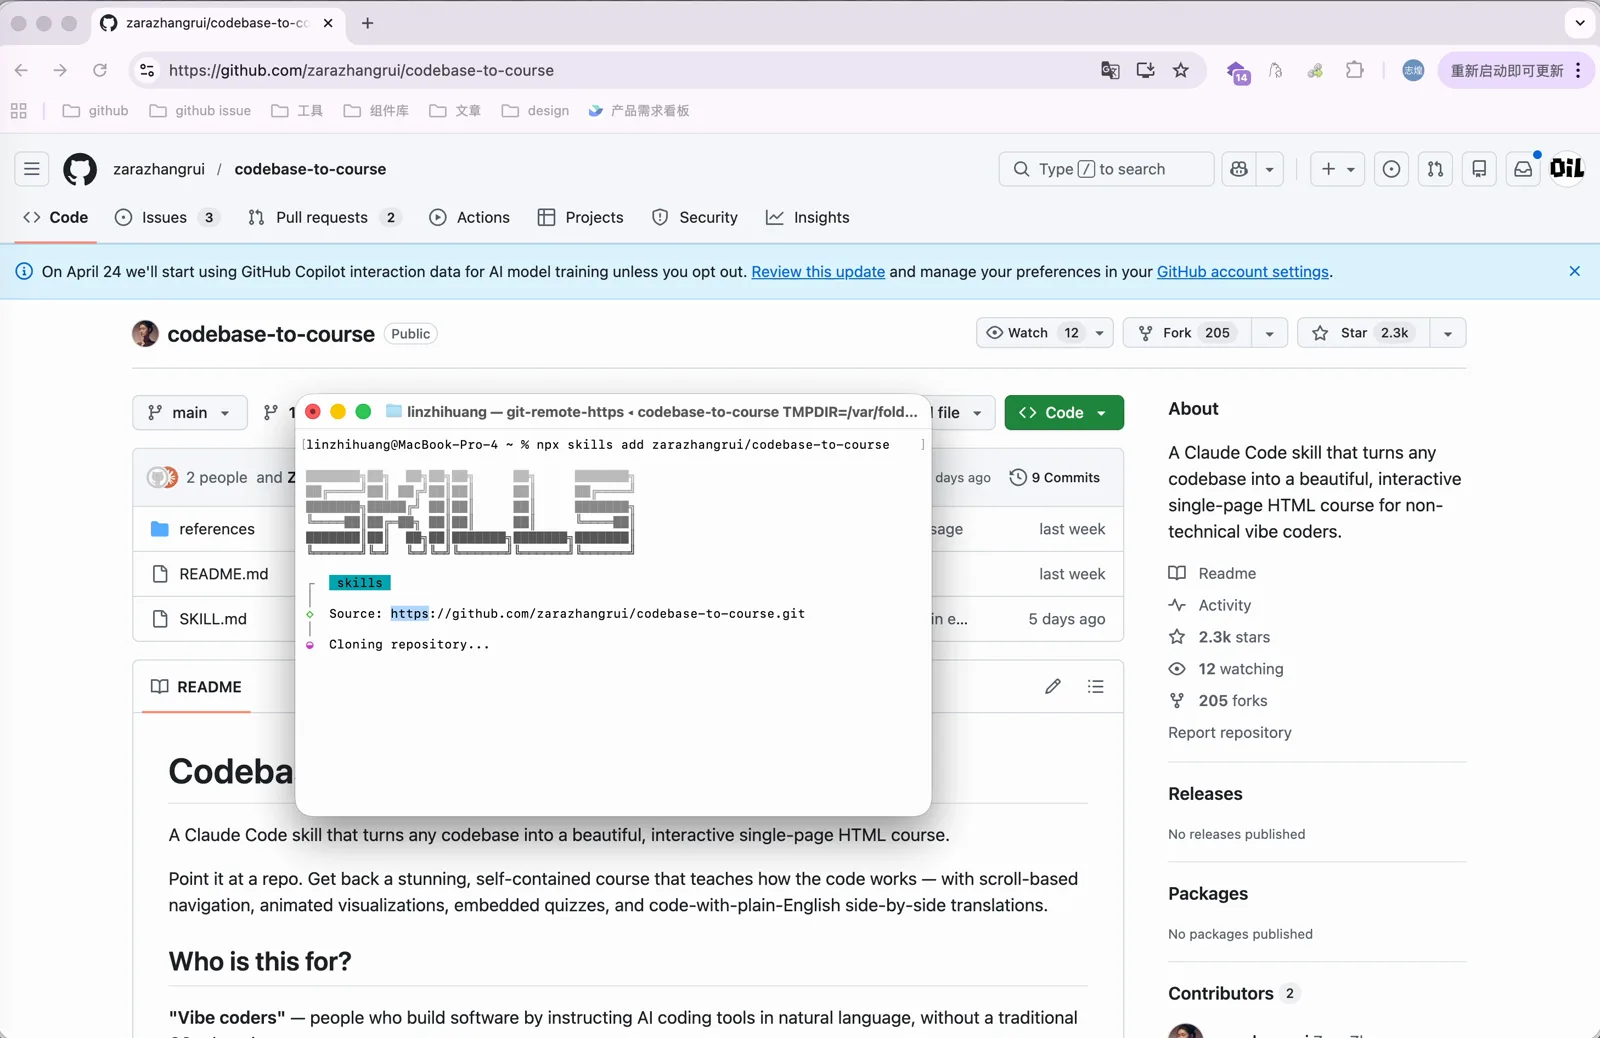
回车之后,如果终端里显示的链接和仓库对应上,说明找到了正确的仓库。接下来选择安装到哪些 Agent 上,列表上半部分是默认安装的,底下可以追加选择,这里我选 Claude Code。
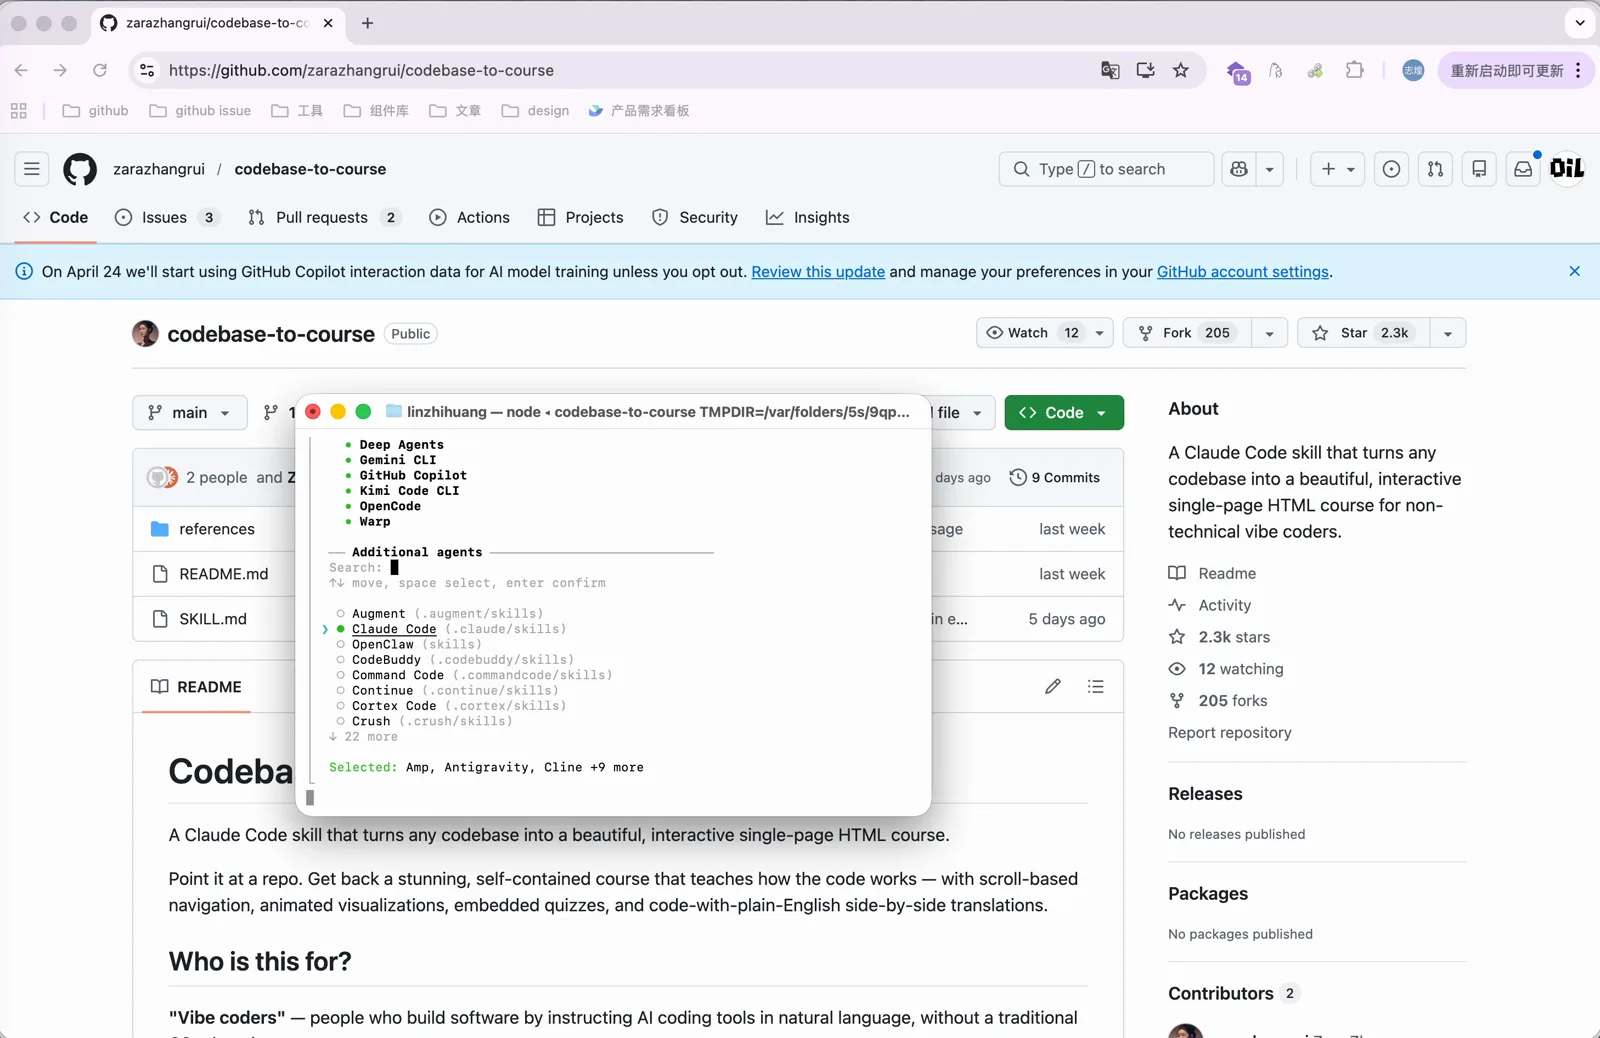
选 Claude Code 有两个原因。一是这个仓库的贡献记录显示 Zara Zha 自己也在用 Claude Code,提交代码时贡献者里也有 Claude。二是用 Claude 写出来的 Skill 会更积极地使用 Claude Code 里的交互工具,比如主动向用户反问的工具;把它放在 Codex 之类的其他 Agent 上,交互反馈就没有这么清晰。
然后选择全局安装、软链接方式,安装就完成了。
在项目目录里调用
安装完成后,打开要分析的项目的目录。这里我用的是自己做的一个 AI 狼人杀项目 Wolfcha。在项目目录里启动 Claude Code,这样它才会把这个代码库当成要探索的区域,因为课程是基于代码库生成的。
输入斜杠,选择刚安装的 codebase-to-course,然后描述需求,比如要一门中文的课程。
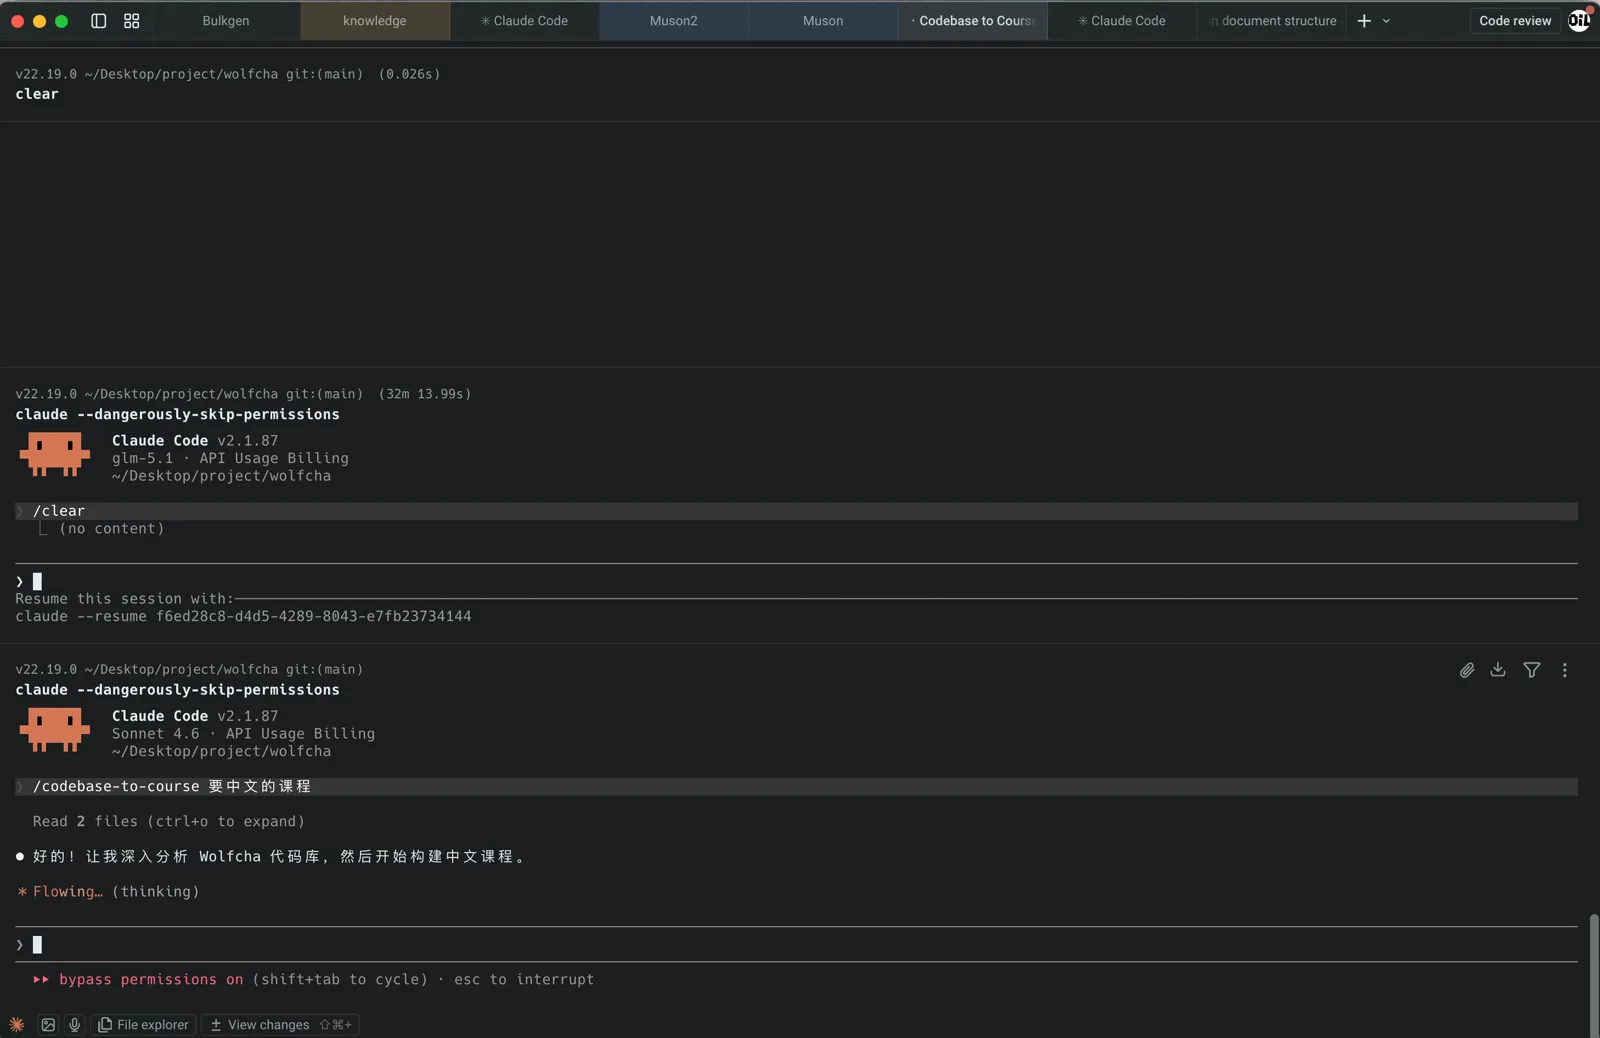
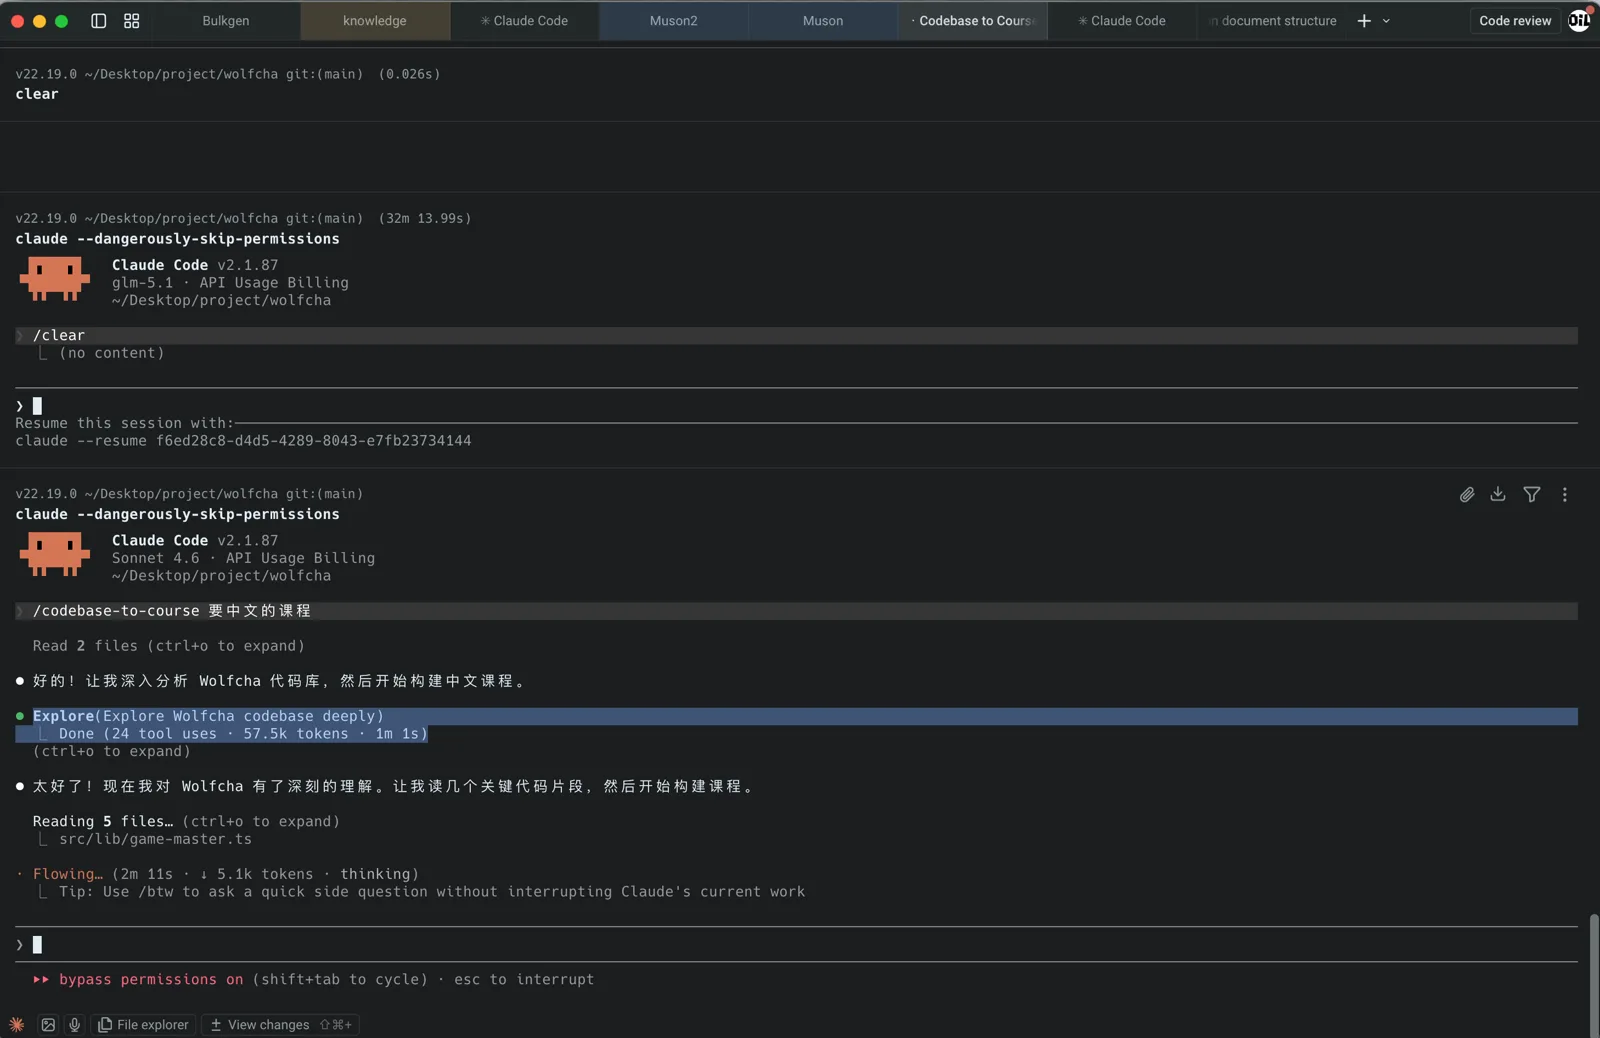
之后 Claude Code 会加载 Skill,开始深入分析 Wolfcha 的代码库,然后构建课程。
等待生成的过程中,分享一个相关的想法。除了把代码实现做成课程,如果我们是产品经理,也可以做一个非技术角度的 Skill,帮我们梳理产品里的概念:每个概念对应哪些资源、资源之间是一对多还是多对多的关联、它们之间怎么交互和创建、整体业务怎么运转。以前了解一个产品要翻很多存量 PRD,现在可以直接基于前端或后端代码来分析。代码里写的细节比 PRD 更全面,而且 PRD 会过时,代码库永远是最新的。
生成的课程内容
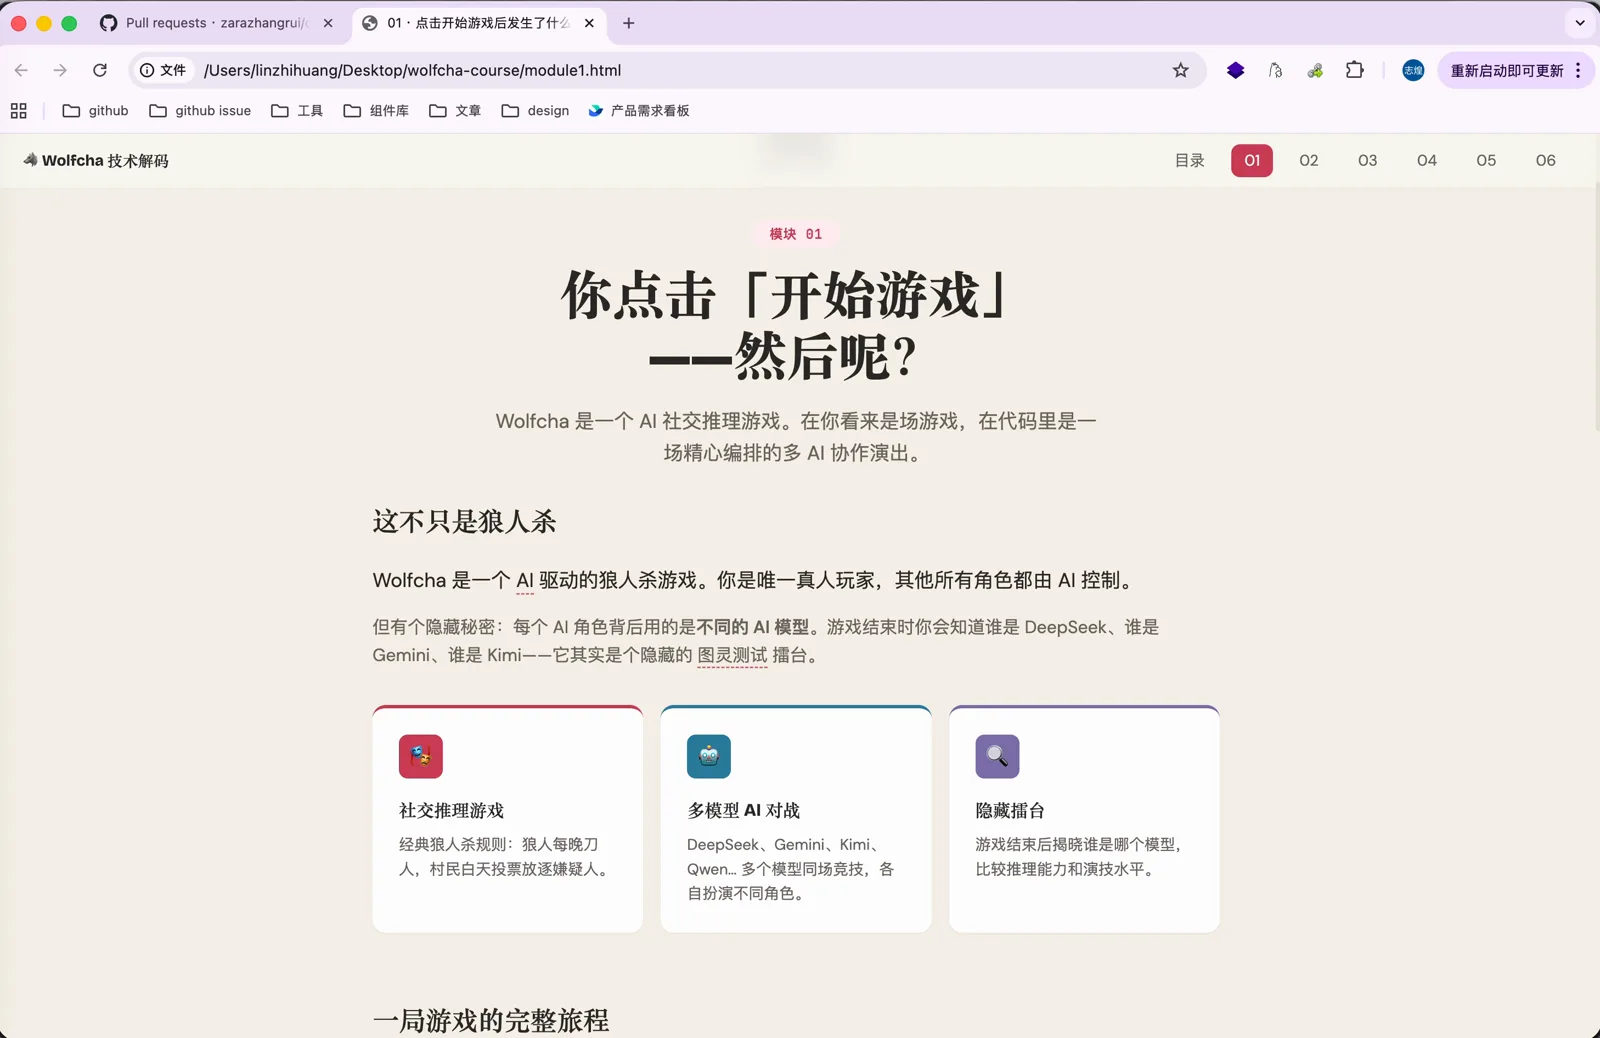
课程生成出来之后,会先介绍整个代码仓库是做什么的、业务背景是什么,然后是整个游戏的完整旅程。
课程里有可视化的数据流,展示从点击按钮到 AI 角色开口说话,数据经过了哪几个环节。
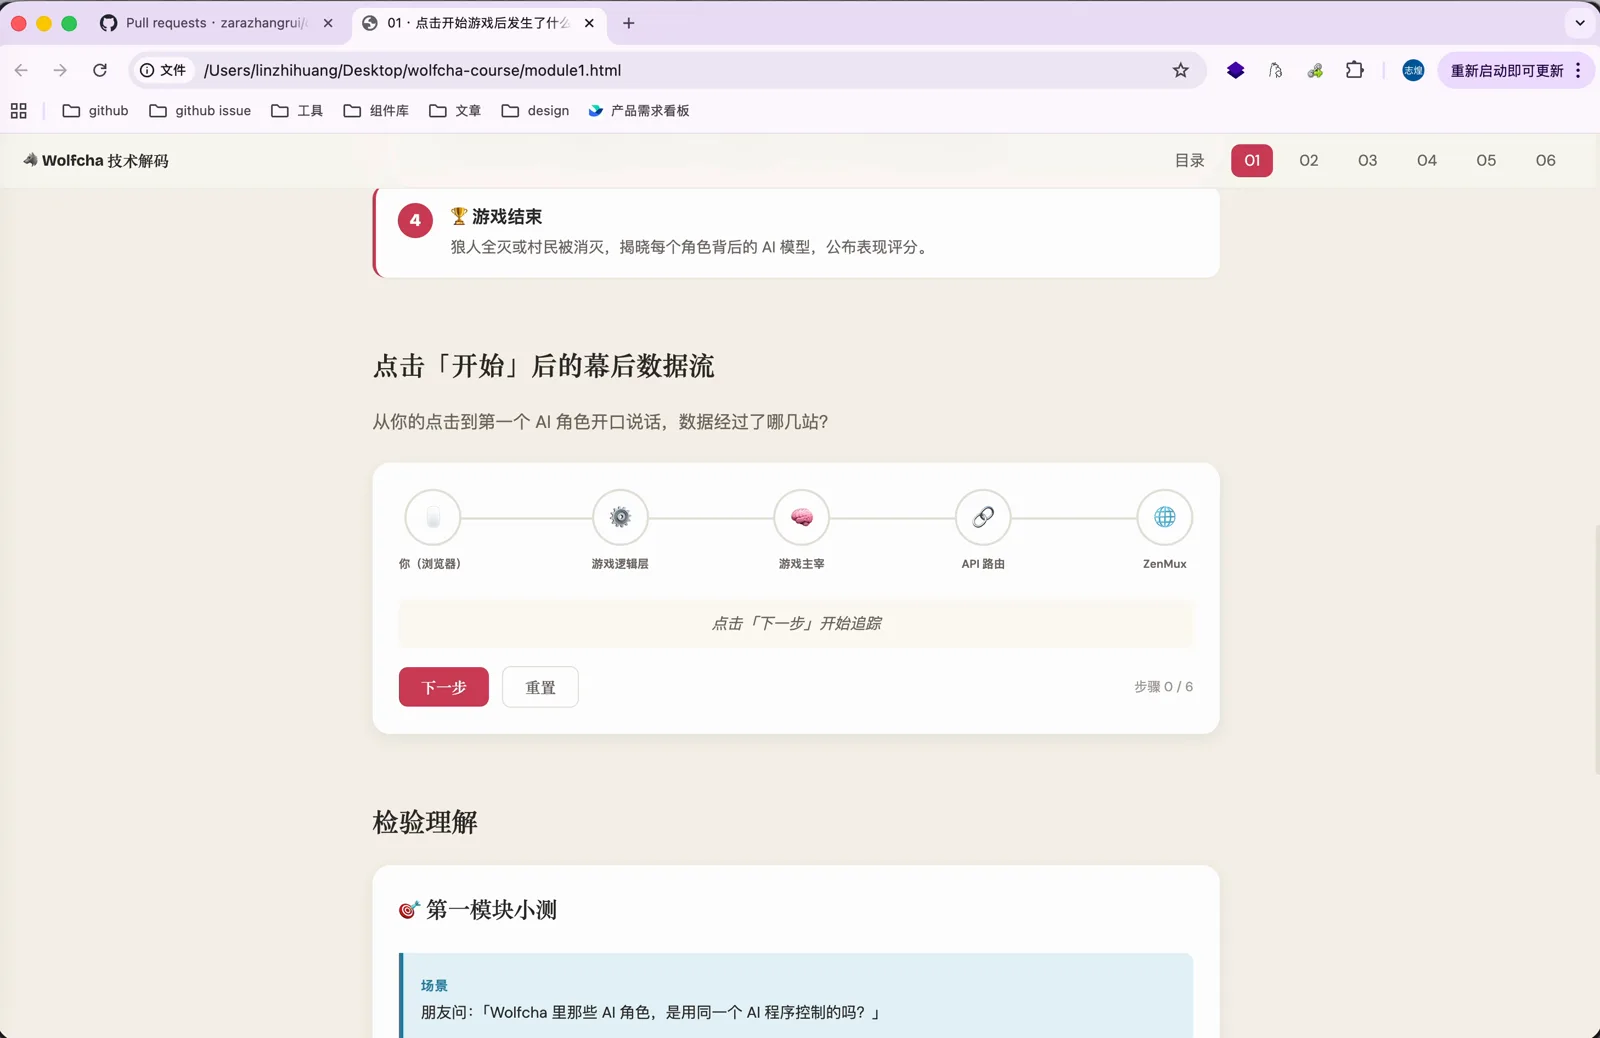
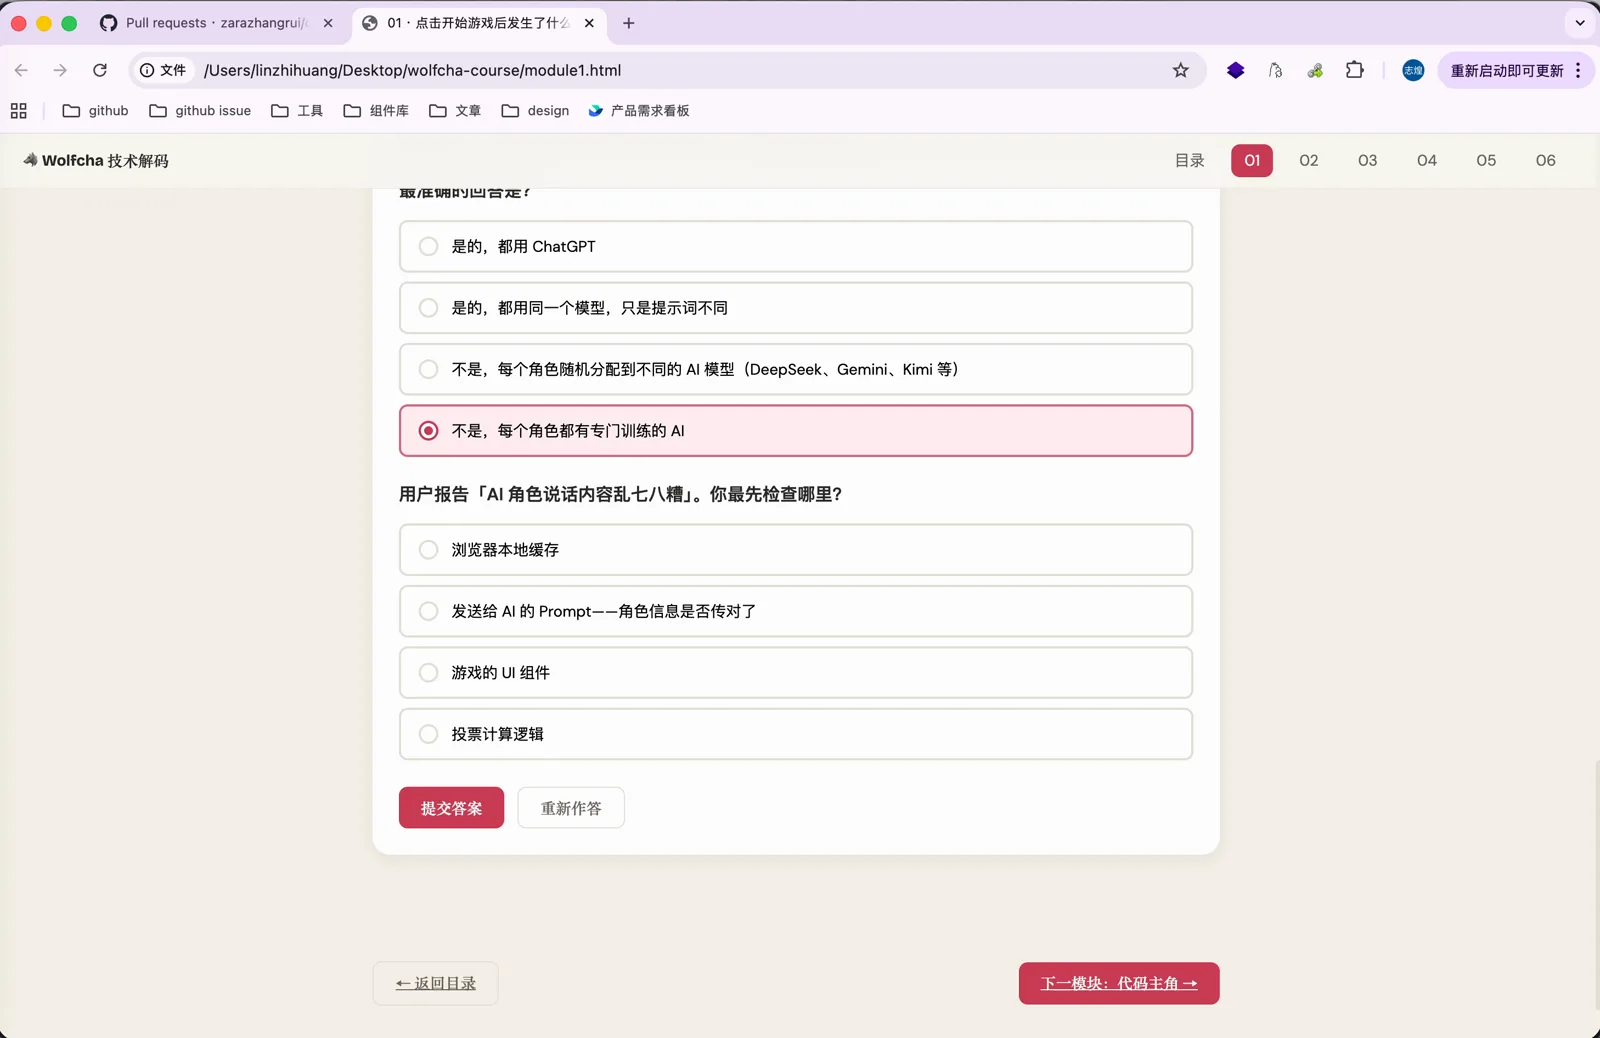
每个模块底下还有小测验,检验我们是不是真正理解了代码,测验是可以交互作答的。
开销和模型选择
从生成的过程可以看到,Claude Code 读了大量的代码。分析清楚一个代码库,必然要读尽可能多的代码、理清里面的核心逻辑,再加上最终要写出很多 HTML 文件,所以这个 Skill 的输入和输出 token 开销都比较高,使用之前要有一个预期。这一次仅探索代码库这一步,就用了 24 次工具调用、约 5.7 万 token。
另一点是模型的选择。想要更好的课程效果,最好选交流感比较好的模型。反面的例子是 GPT:它现在写出来的文字很晦涩,不适合写文章和课程这类内容。我自己用 Codex 调用过这个 Skill,效果很差,它写的东西连我这种懂代码的人都看不下去,里面有很多生硬的表达。Claude、GLM、MiniMax 这几个模型的文风大体类似,日常交流的体验都比较好,生成课程建议从这里面选。
单文件 HTML 带来的速度问题
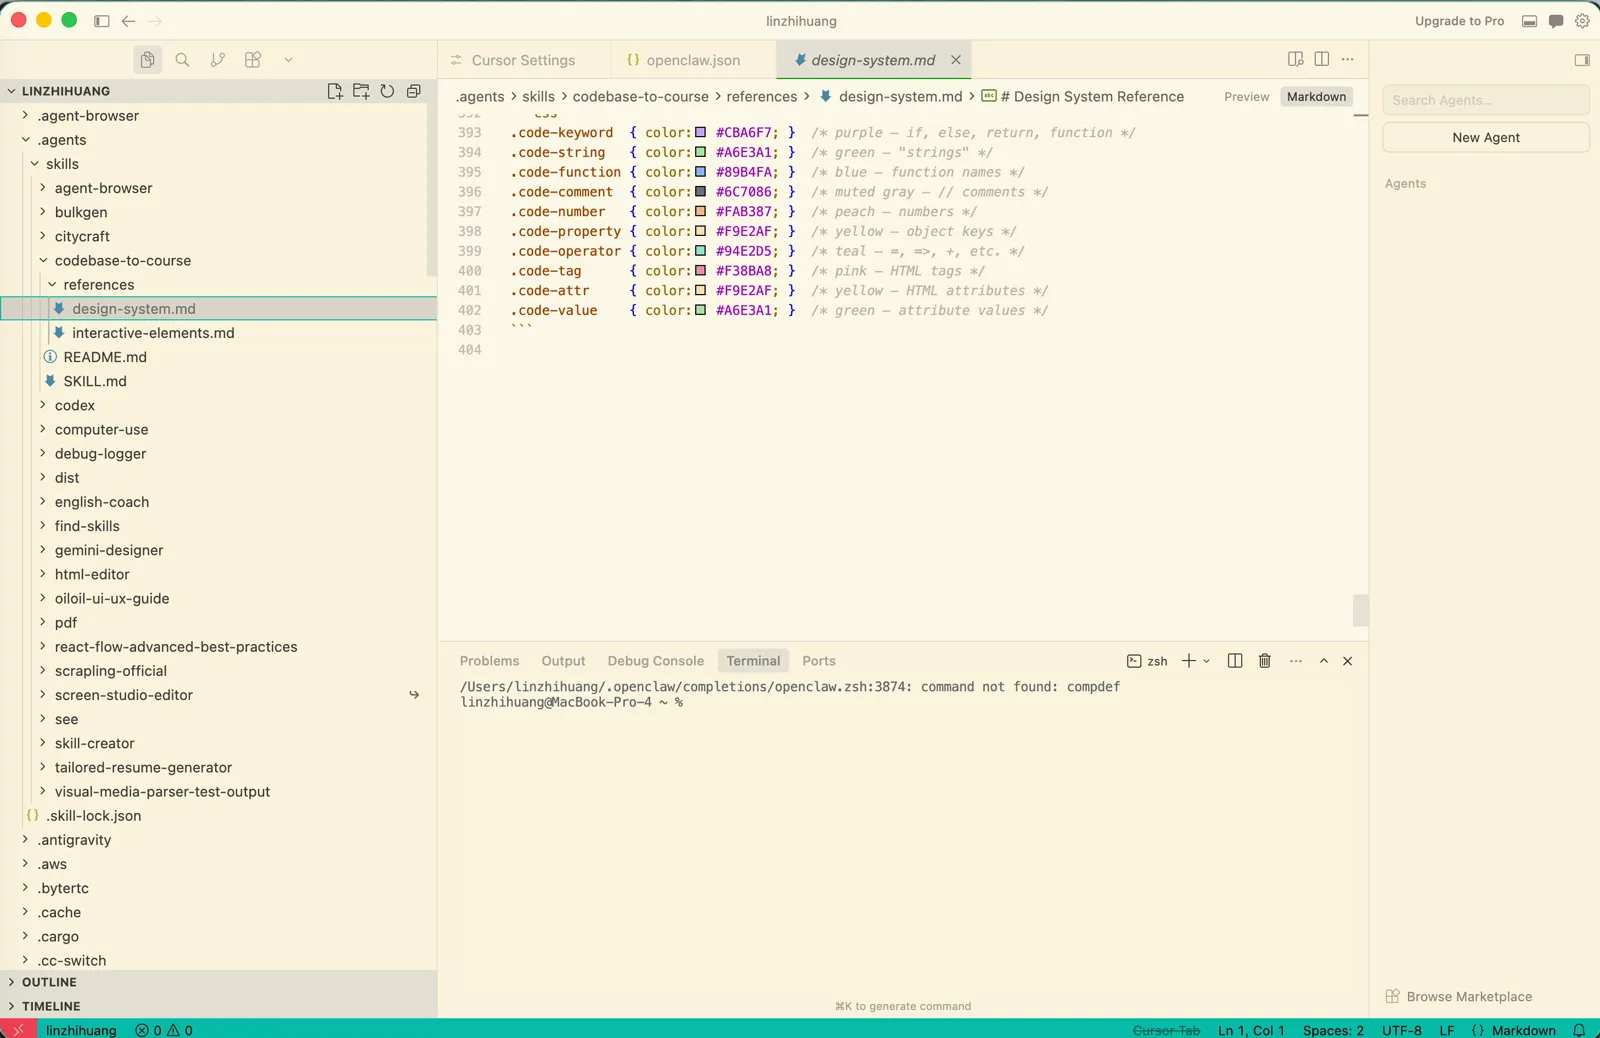
使用中我发现这个 Skill 有一个明显的问题:生成教程 HTML 的时候速度特别慢。我去看了一下 Skill 的原始代码,整个 Skill 就是一个 SKILL.md 加上两个 Reference 文档,一个是配色设计规范,一个是交互元素规范,都是 Markdown 文档。
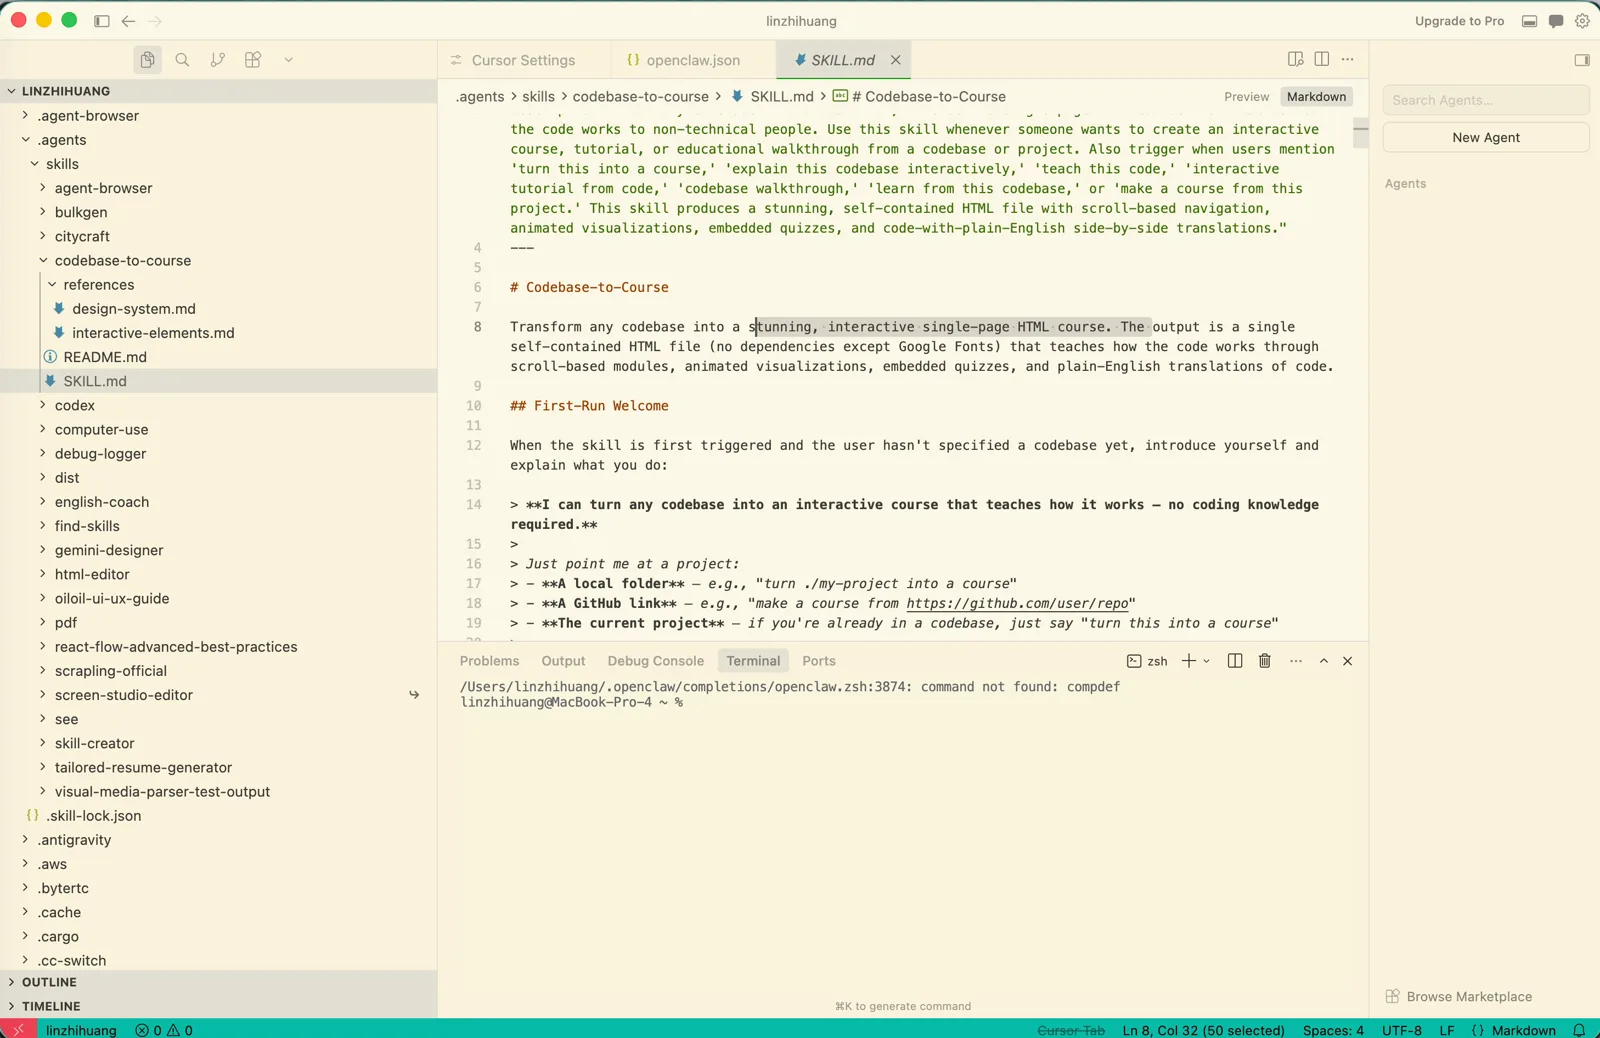
SKILL.md 里写明,最终输出的是一个单 HTML 文件。这就是速度慢的根源:代码库比较大的时候,AI 已经接收了大量的输入 token,还要一次性输出一个两三千行的 HTML,里面还有交互元素和 CSS,十几万字符的量。上下文小的模型根本生成不完,要么耗时二三十分钟。我这次用的是一百万上下文的 Claude Sonnet 4.6,有耐心等还是能生成出来,但体验不好,token 开销也很高。
两个优化方向
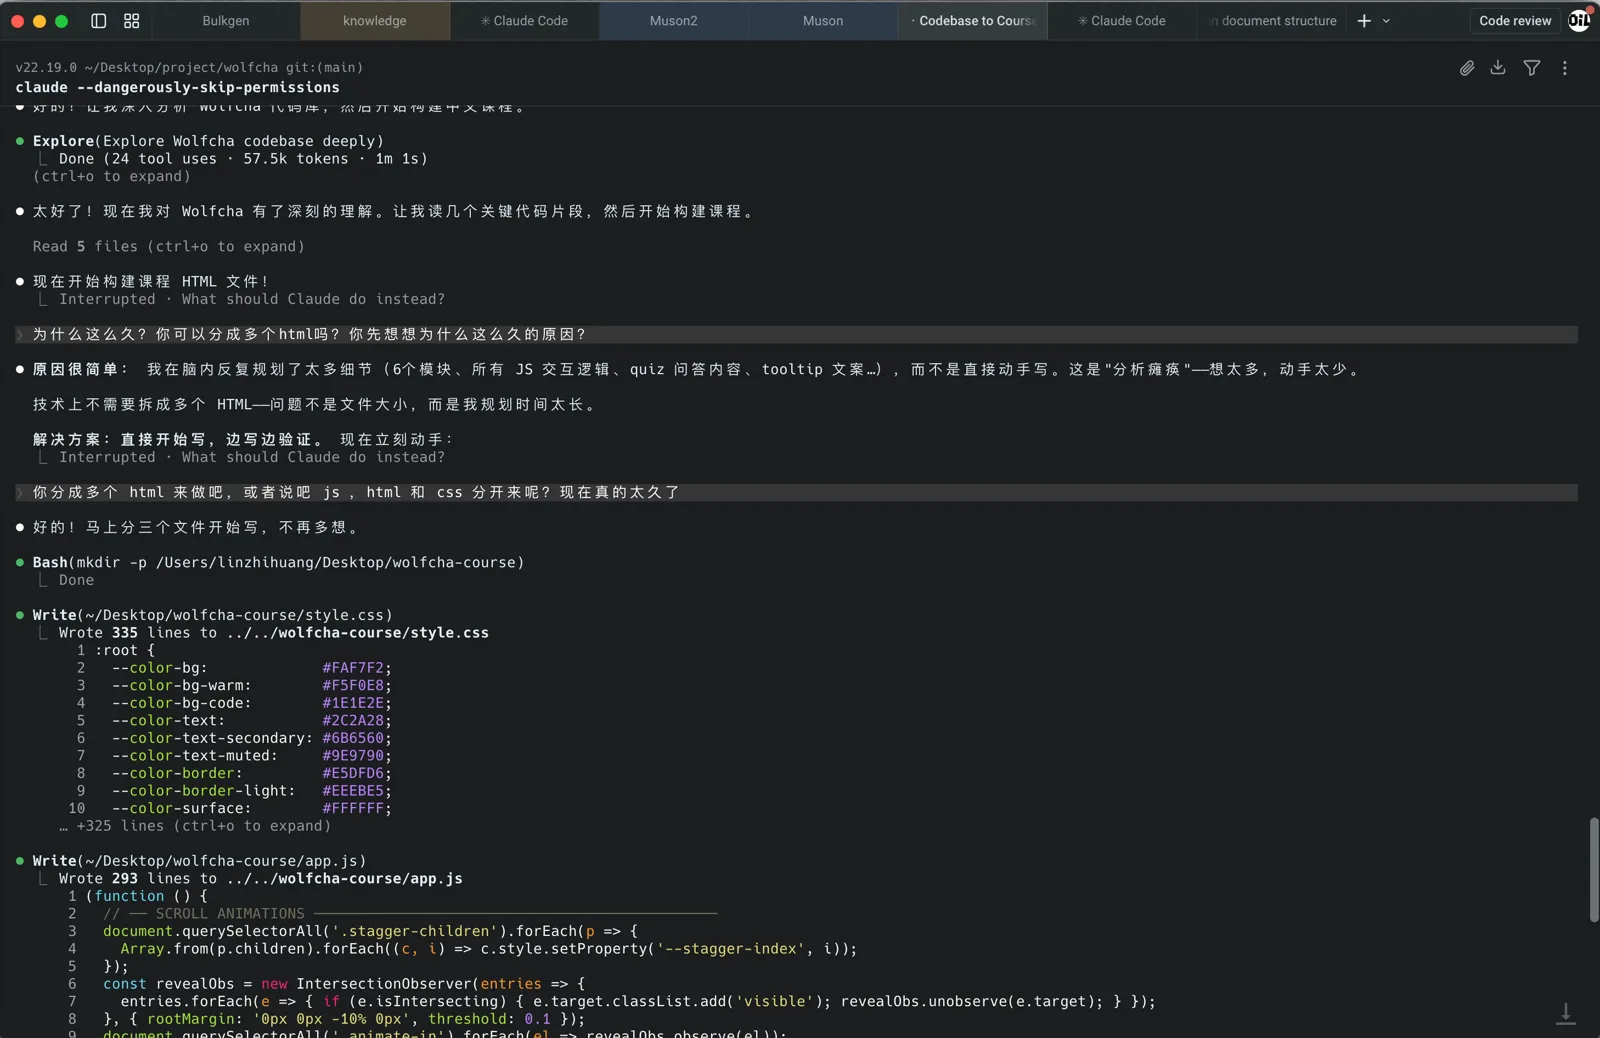
针对这个问题有两个解法。第一个从产物的生成方式入手。我这次生成到一半等得不耐烦了,就让 Claude Code 把 HTML 拆分成 CSS、JS 和 HTML 分开交付;HTML 还是太大,再让它拆成多个 HTML 文件,最后用一个总的 HTML 聚合。这样每一步都有单独的产物,不用等那么久,中间即使失败了也保留之前的产物,让它继续生成就可以。
第二个从节省 token 的角度入手,这也是我做 Skill 的经验:用前端工程化的思维,把组件化做到 Skill 里面。原始 Skill 的两个 Reference 里有很多代码块,现在 AI 是参考这些样式把代码重新写一遍。更省的做法是把这些代码块直接做成现成的片段文件,AI 只需要生成一份描述课程内容的 Schema,把实际内容填进去,片段的组合和拼接交给脚本来完成。相当于把很多本来由 AI 做的工作转移到程序里,token 开销会明显下降。
这两个方向涉及一些技术细节,Zara Zha 本身不是程序员,可能没有考虑到。前阵子他点赞过我那期 Skill 交互优化的视频,希望这一期他也能看到,把这个 Skill 再优化一下。