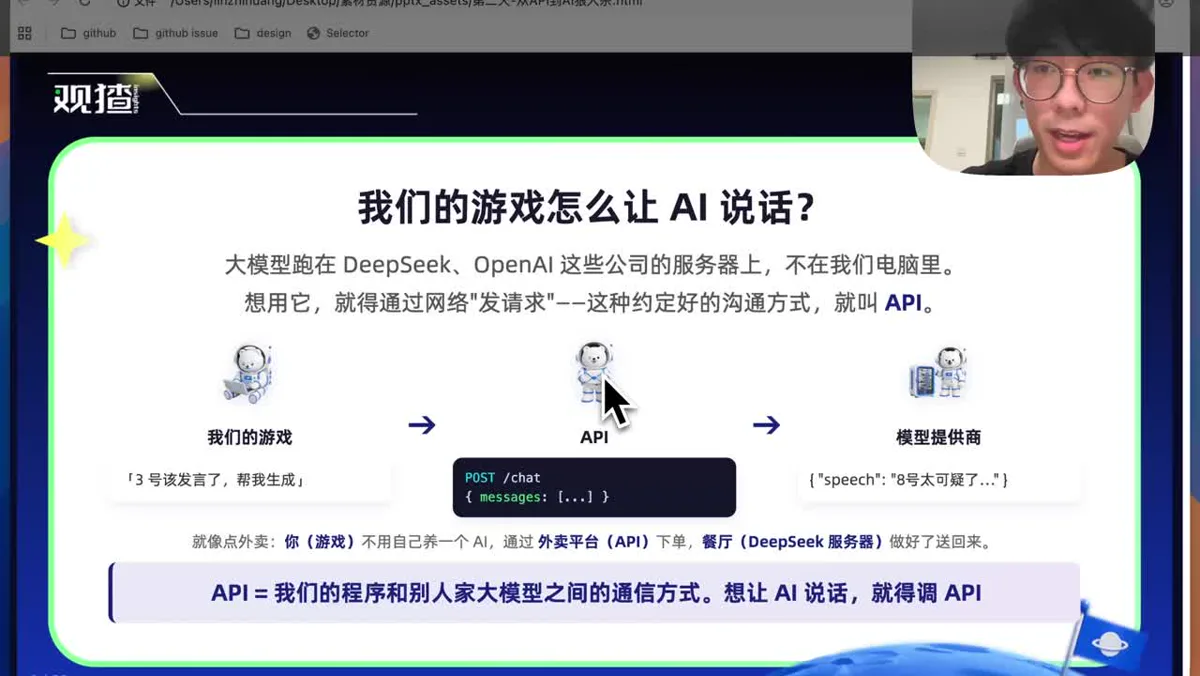
如果我们想要开发一个 AI 应用,需要先了解一些基础知识:什么是 API、什么是上下文、什么是多模态,以及怎么在一个 API 平台上挑选想要的模型、怎么把它接入自己的服务。这篇文章用一个 AI 狼人杀游戏的例子,把这些概念逐个讲清楚。
通过 API 调用大模型
调用外部大模型服务,用的是 API 这种形式。API 是程序和程序之间沟通的桥梁,是一种约定好的协议。
之所以要调用模型厂商的服务,是因为大模型本身很重,需要很强的算力才能运行,我们只是使用它们服务的一小部分。我们把请求信息发送给模型厂商,它根据我们的信息返回对应的响应,这个过程叫做发送请求。发请求通过代码实现,不过现在已经很少手写代码了,直接跟 AI 说明要怎样请求对应模型厂商的 API 就可以。
请求时还需要带上 API Key。比如想要使用 DeepSeek、Claude、GPT、Kimi 的服务,就要先在对应的平台上创建一个 API Key。API Key 用来认证身份:模型厂商看到 API Key,才知道请求来自哪个用户、账号里有多少额度,之后每次请求都从这个账号里扣取额度。
多模态
模态是 AI 能够处理的信息类型,一般有文本、图片、音频、视频几种,还分输入模态和输出模态。
大多数模型是文本模型:发送文本给它,它响应文本。有一些模型是多模态的,支持图片识别,比如 Claude、GPT,把一张 PPT 发送给它,它就能说出上面写了哪些文字、有什么图案。再进一步支持音频和视频的模型,可以分析音频的节奏、理解视频里讲了什么。输出侧的例子是 AI 生图和生成视频:输入文本提示词或者参考图,模型生成新的图片或视频。
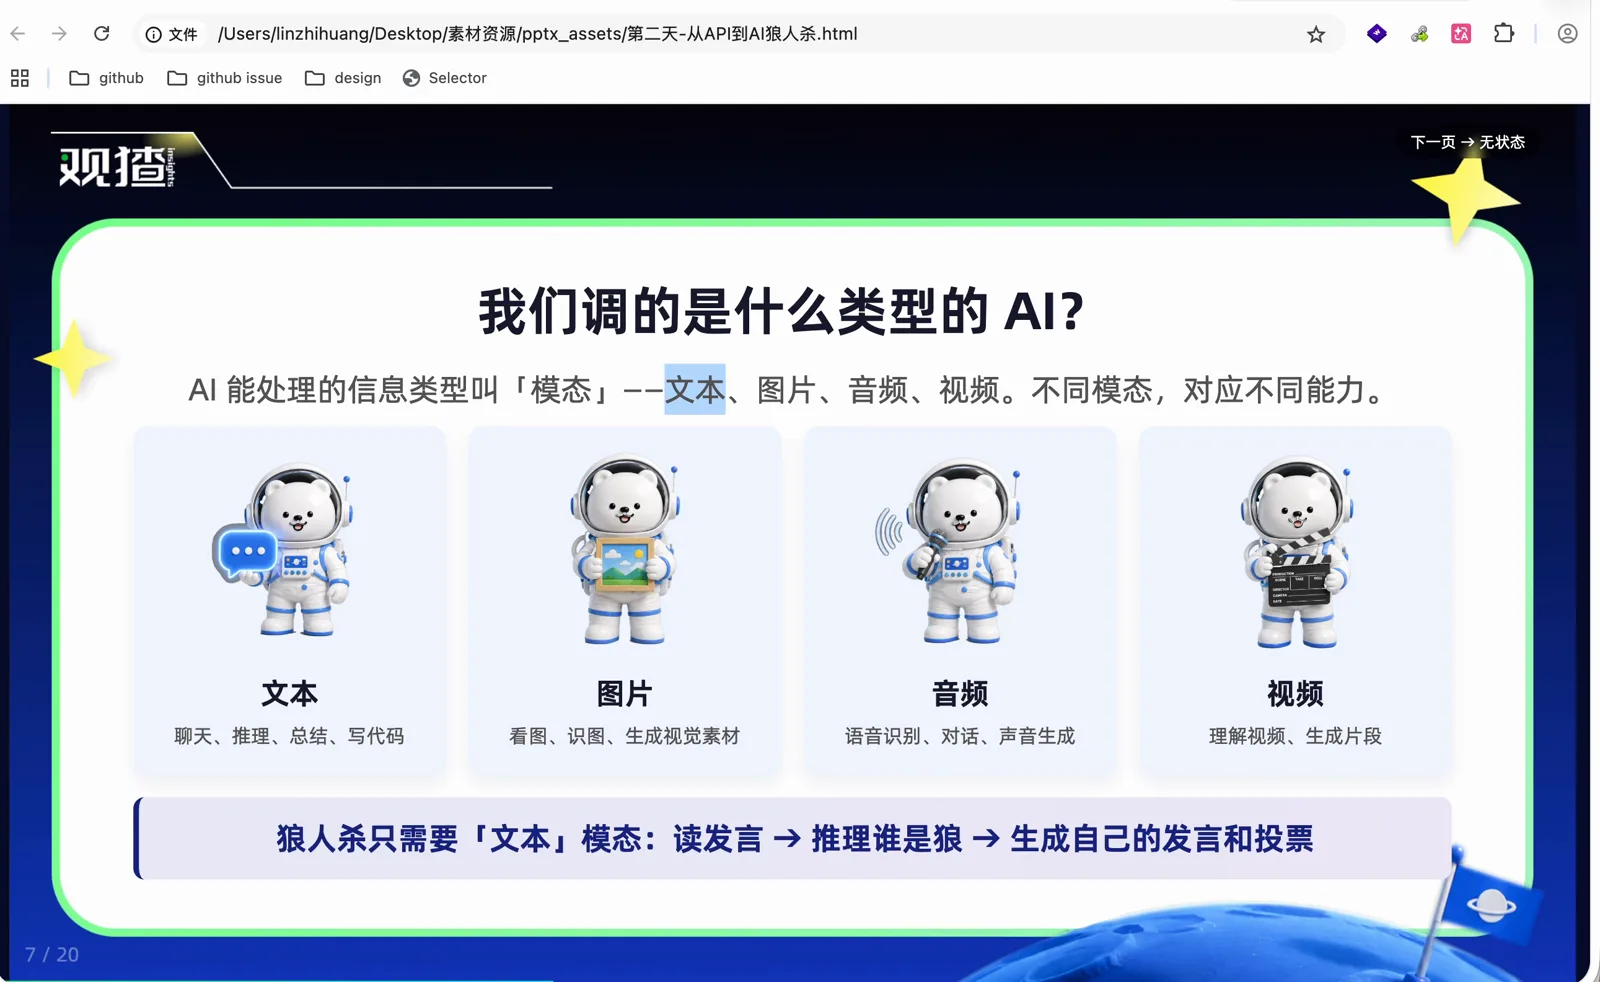
假设要做一个狼人杀语言游戏,只需要文本模态:文本输入、文本输出。想要更高阶一点,可以尝试音频输入,用对话的方式交互,再使用音频合成模型输出音频。
模型是无状态的
模型是无状态的,这是一个很重要的概念。平时跟 AI 对话,会发现它记得之前说过的信息,但从原理上讲,每一次发送请求,都要带上过往的所有历史信息。
我在 Codex 里做了一个演示:先发送「你好」,它响应「你好,有什么想一起处理的吗」;再告诉它「我叫 oil」,它说「你好 oil,很高兴认识你」;最后问它「我叫什么」,它能答出来。
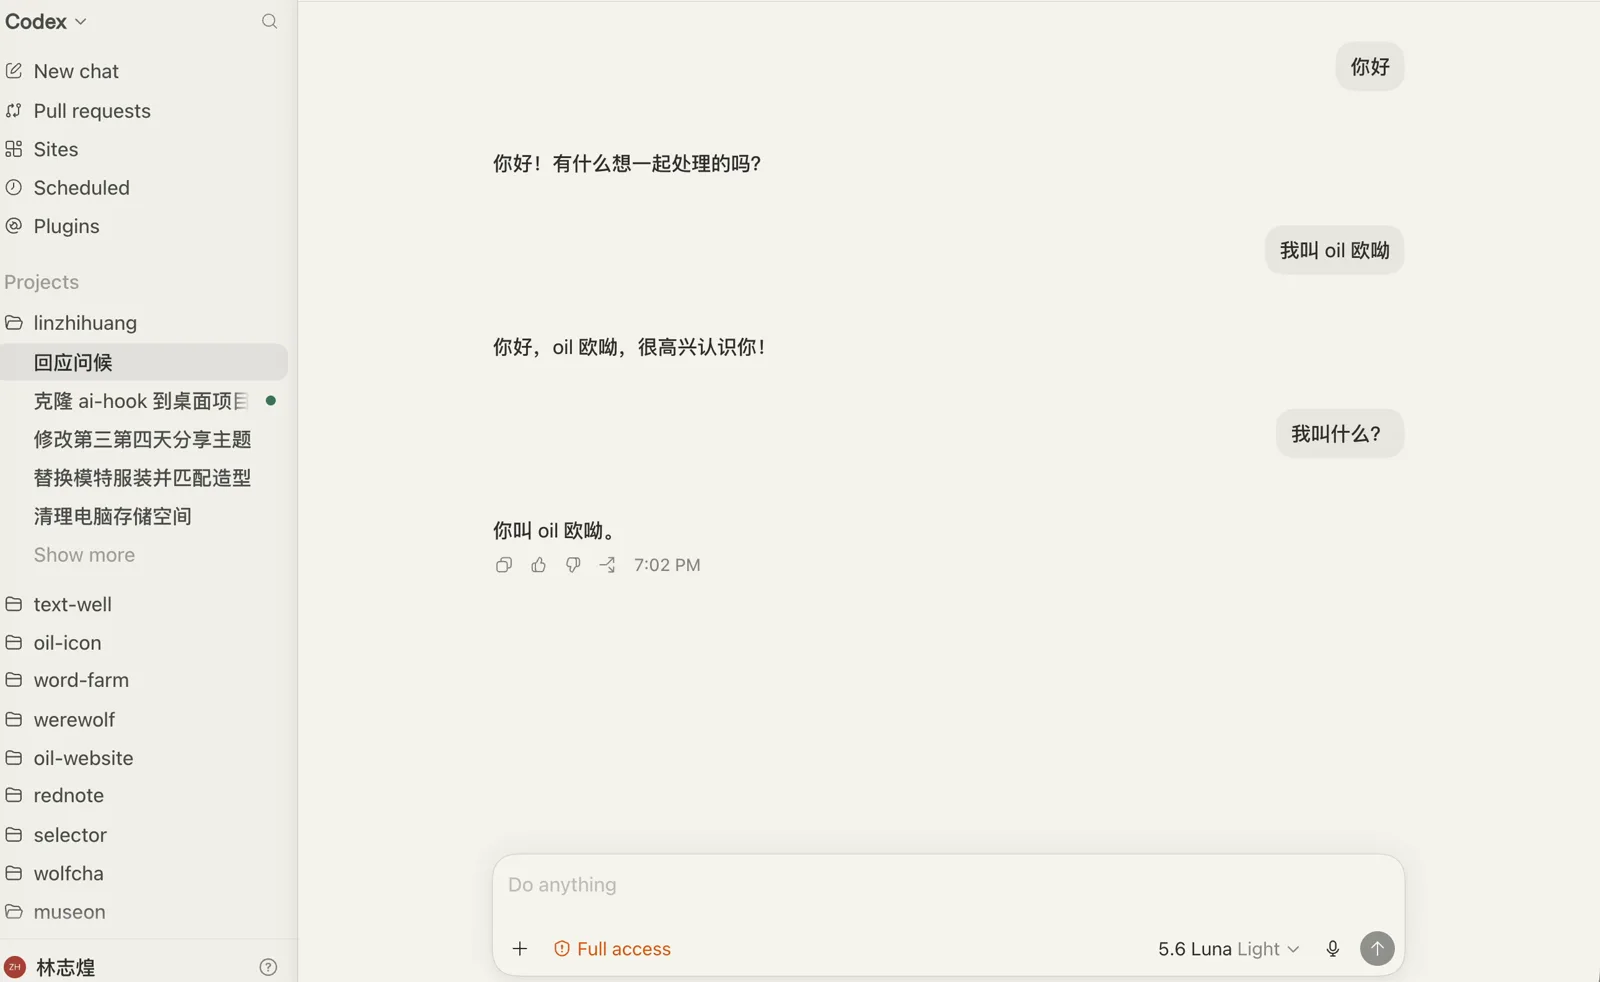
它记得名字,是因为这里实际发了三次请求,每一次请求都会带上前面的历史信息。问「我叫什么」的时候,如果不带上前面的历史信息直接问大模型,它并不知道我叫什么。把历史信息都带上,它才能基于前面所有的内容推理出答案。这就是上下文的意思。
所以实现一个 AI 应用的时候,这些状态是我们自己维护的,模型厂商不会帮我们存这些信息。比如实现狼人杀游戏,每一轮的发言要自己存在程序里;想让 AI 分析之前玩家的发言,就要把所有历史信息加上当前玩家的人设一起发送给模型,它才能推理出这一轮要说什么。
上下文和上下文工程
每次发送给 AI 的所有信息,总的来说叫做上下文。上下文包含很多东西,比如系统提示词、游戏规则、当前局势和过往的历史发言。AI 基于这些信息推理出这一轮的发言。
这里有一个点:上下文不是越多越好,而是越少越精简,AI 的推理越准确,这就是所谓的上下文工程。可以拿查字典来类比:给你一页只有三个字的纸,想找一个字一眼就能看到;给你一本厚厚的字典,在里面找到同一个字就难很多。这对应模型的注意力机制——上下文越精简、越垂直、越准确,模型推理出好结果就越简单。
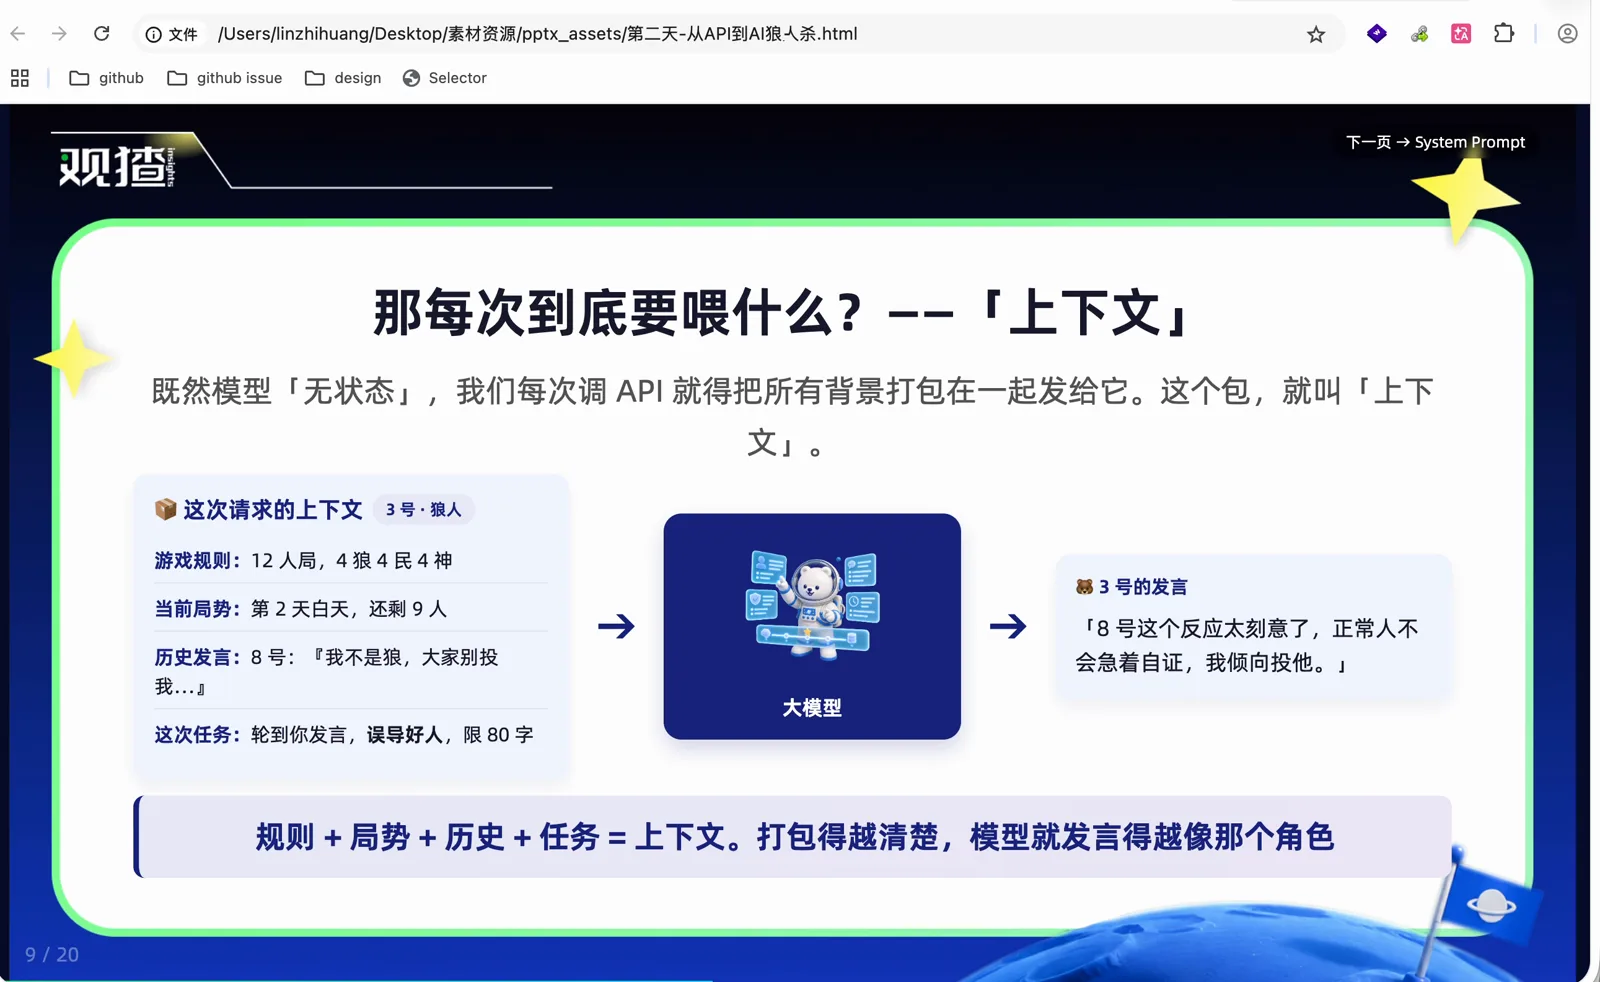
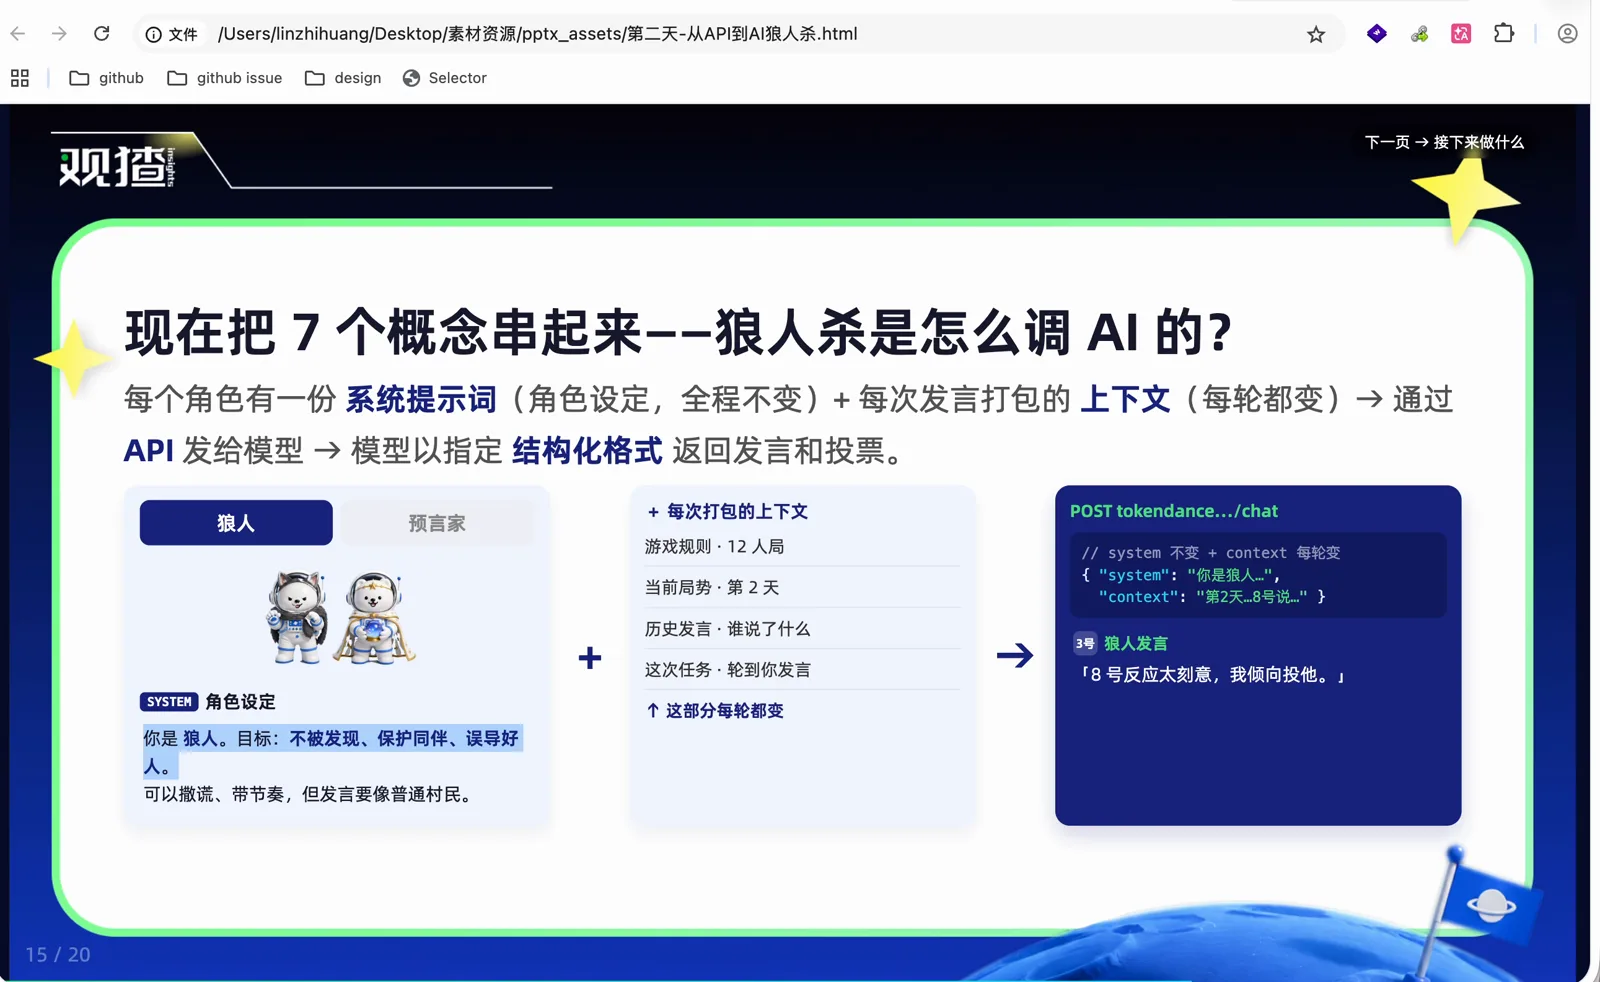
上下文里有一个很特殊的区域叫做 system prompt,也就是系统提示词。系统提示词定义模型的角色、规则和边界,一般放在提示词的最顶部。玩狼人杀的话,系统提示词就是:你是几号玩家、身份是什么、目标是什么、响应格式是什么。
上下文不是无限大的,不同的模型有各自的上下文窗口上限,达到上限之后没办法再追加信息。比如 ChatGPT 在 Codex 里的上下文是 25 万左右。我们发送的消息和它响应的消息都会计入历史,一旦超过这个上限,就会触发上下文压缩:把之前的对话信息做一个总结,比如把 25 万字摘要成 2 万字,大致描述之前做了哪些事情。一些重要的信息不会被压缩,比如明确的数字、ID,压缩之后会失真,对后续对话影响很大。
还是以狼人杀为例:游戏刚开始时只有规则和一两句发言,模型推理很轻松;玩到后面很多人发言、上下文塞满了,有两种处理方式。一种是刚才说的上下文总结;另一种是窗口滚动,把最早的、参考性不强的信息从窗口里裁掉,只发送后面的信息。用裁剪或者总结的方式,可以让上下文窗口永远能输入内容。不同模型的上下文窗口不一样,目前很多模型已经达到 100 万。
模型的输出速度 TPS
还有一个重要指标是模型吐字的速度,叫做 TPS,也就是 Tokens Per Second,一秒钟模型能输出多少个字。有的模型噼里啪啦输出得很快,有的模型一个字一个字往外蹦,这就是 TPS 不同。
TPS 并不是能力越强的模型就越高,反而是一些相对便宜、专注速度提升的模型 TPS 更高。大多数模型的 TPS 在 40 到 60 之间,超过 60 算是比较快的,GPT 和字节的一些 Flash 模型可以达到 80 到 100,响应速度相比低 TPS 的模型有一倍的提升。
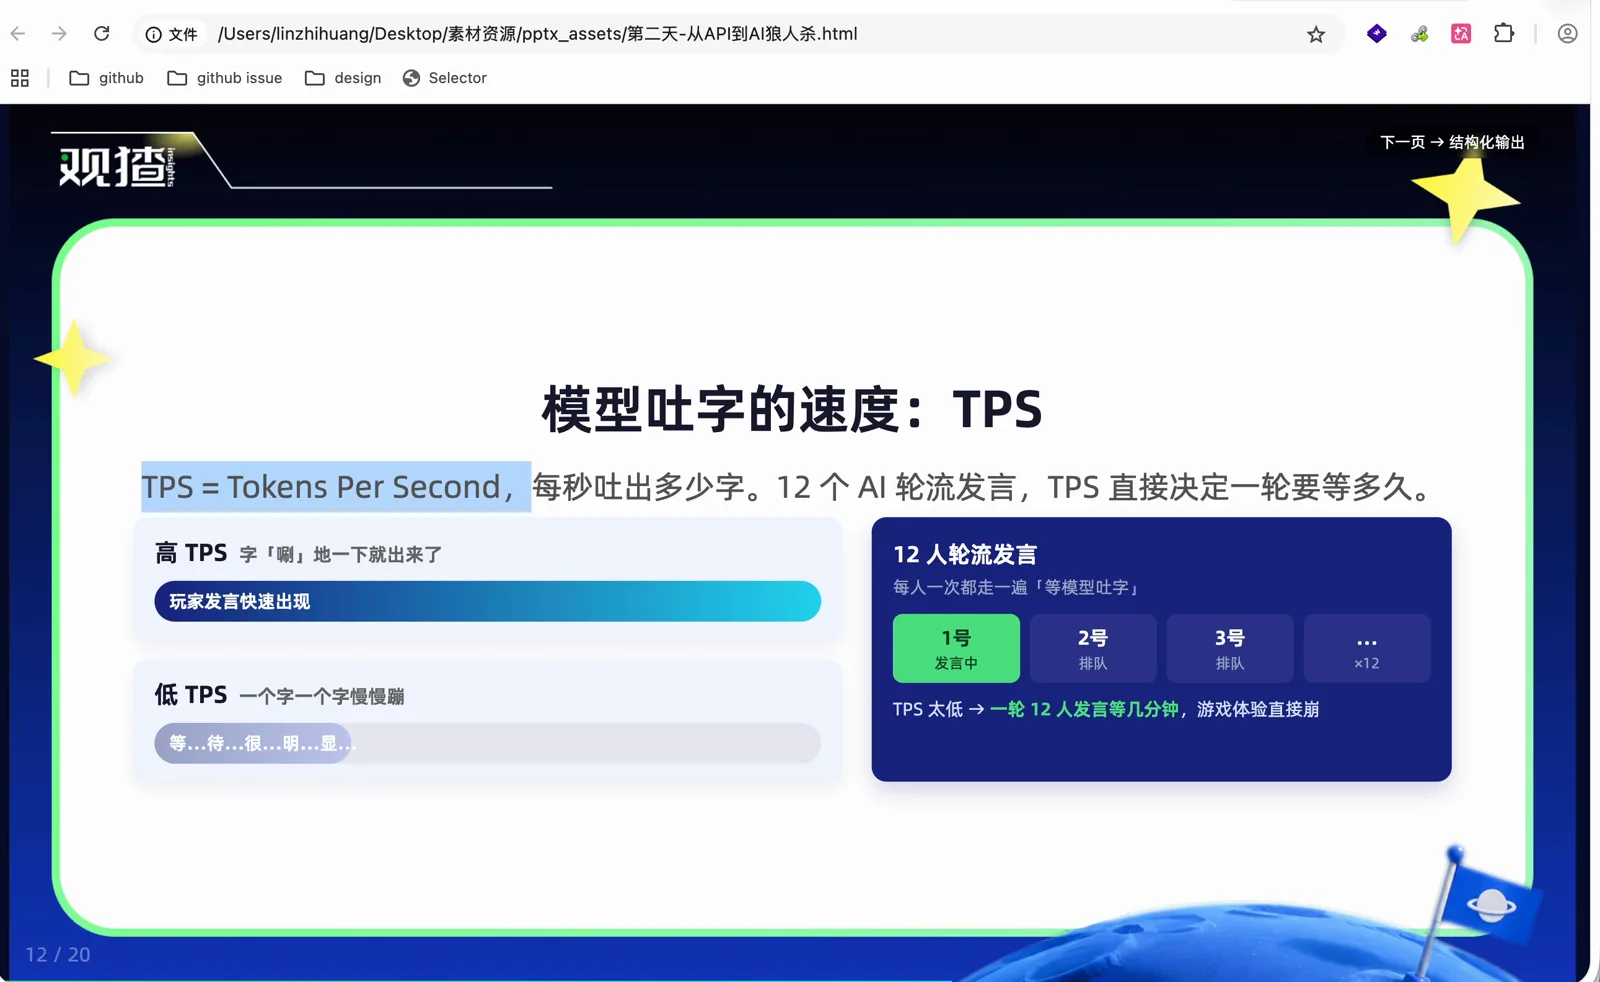
TPS 对 AI 应用的体验影响很大。玩狼人杀的时候,如果选的模型输出特别慢,等它说完一句完整的话要等一分钟;换一个模型 10 秒钟就把话说完了,页面可以很快渲染出来,用户的使用体验就会好很多。
让模型输出结构化数据
程序想要把 AI 响应的信息渲染到页面上,需要结构化的数据。正常对话时 AI 返回的是纯字符串,比如「你好 oil,很高兴认识你」,如果想把它渲染成标题加描述的样式,就需要让模型按规范的格式输出,也就是 JSON 格式。
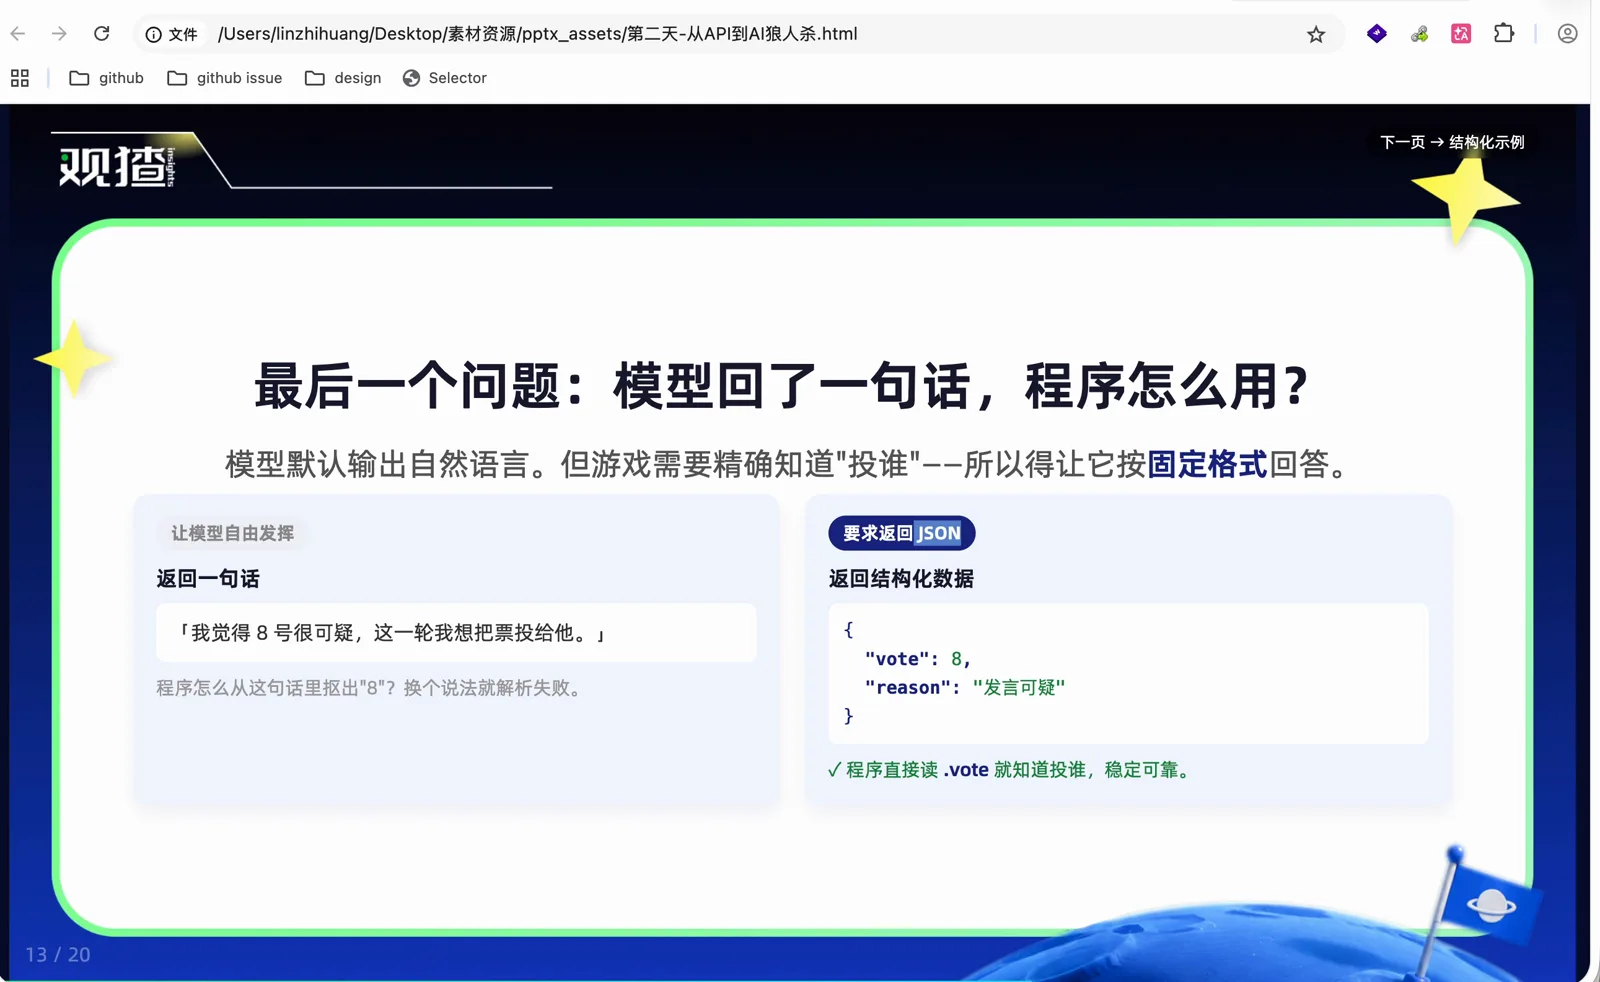
目前大多数模型厂商都支持传递一个参数,指定返回结构化的数据。只要在请求里写清楚要什么样的数据,它就能响应正确的格式。一两年前,很多模型连准确返回 JSON 都很难做到,现在模型能力强了,可以准确响应。程序拿到结构化数据之后,比如投票结果是 8 号、原因是发言可疑,就可以很方便地渲染到页面上。
看一下代码里一个请求的实际样子:开头是 system prompt,写角色的人设和响应规则;然后是上下文,用 messages 数组表示,里面的 role 区分这条消息是用户说的话还是系统说的话,用户的发言一轮一轮追加,每轮都在变化;最后是格式约束,传一个 response_format,类型指定为 JSON,模型就会返回 JSON。
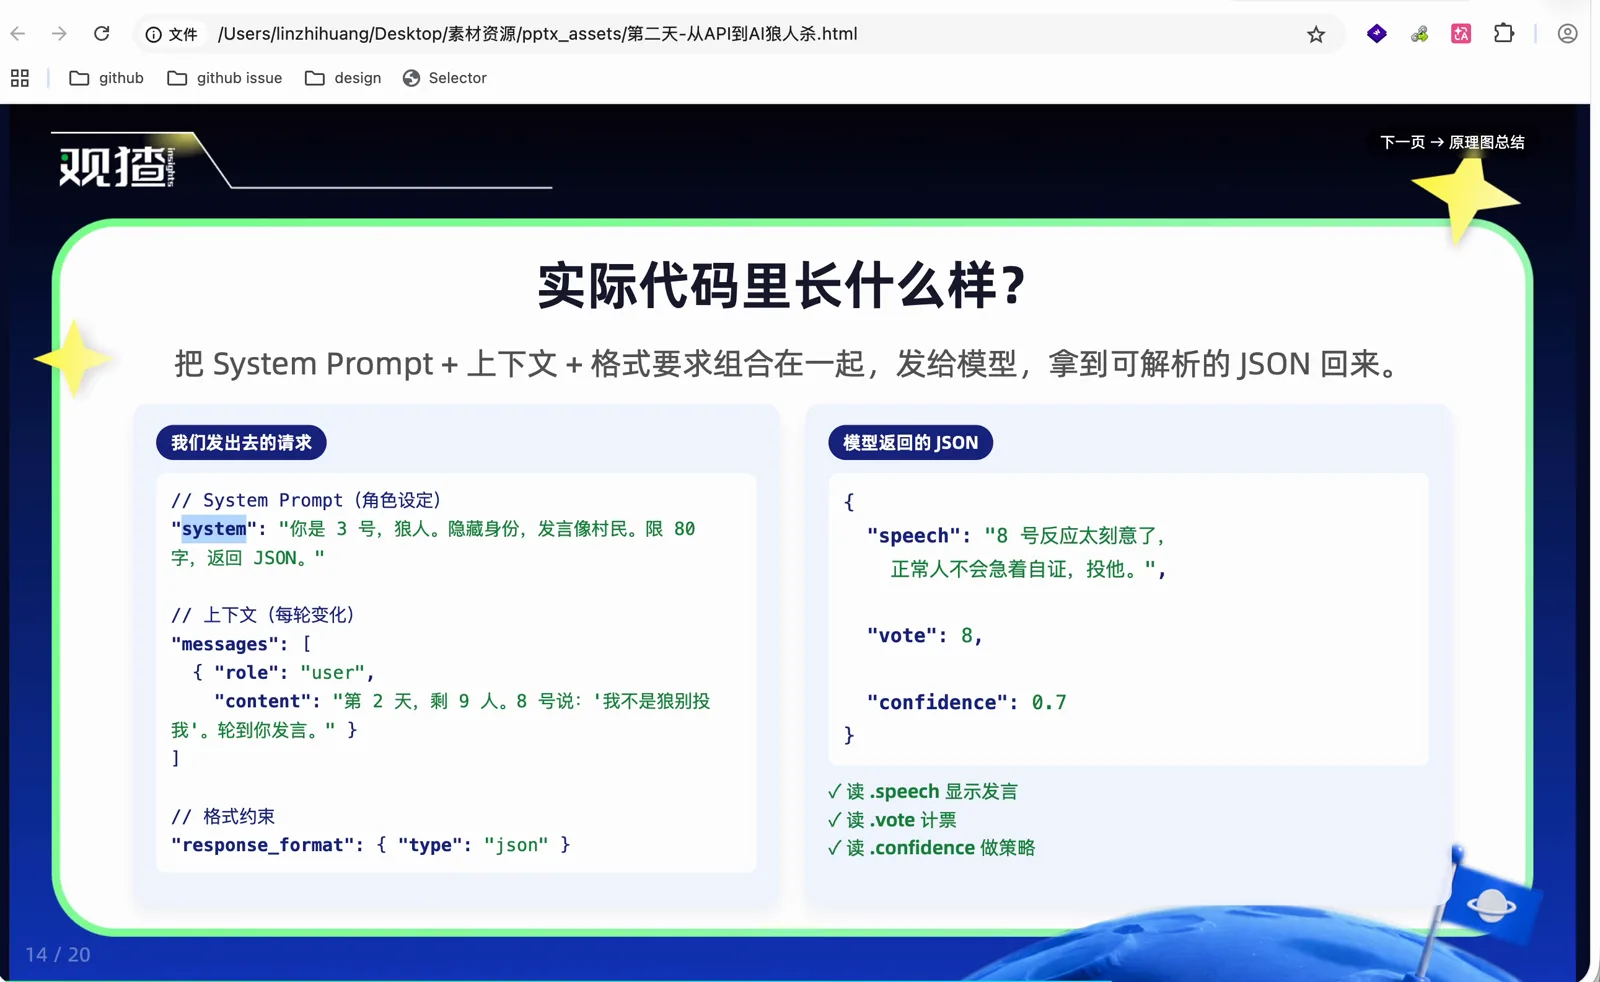
再用狼人杀的角色举一个直观的例子。狼人的系统提示词是「你是狼人,你的目标是不要被别人发现,你要保护好你的同伴」,历史信息是所有玩家共享的。模型基于人设加历史信息,推理出这一轮的发言,狼人需要伪装自己。如果换成预言家,角色设定不一样,基于一样的历史信息,推理出来的内容也完全不同。
在 API 平台上选模型
接下来进入一个 AI API 平台,看看实际怎么选模型。我用的是词元跳动 TokenDance,国内的一个 AI API 聚合厂商。
模型厂商一般有两种。第一种是第一方厂商,比如 DeepSeek、OpenAI、Gemini、Claude,它们只有自己家的模型。做 AI 应用的时候,通常不是用一家的模型就能解决所有问题:有的场景要便宜的模型,有的要速度快的,有的要支持别的模态,比如 Claude 就没有生成图片的功能,只接 Claude 的话灵活性很差。所以有很多聚合不同厂商的 API 平台来提供服务。
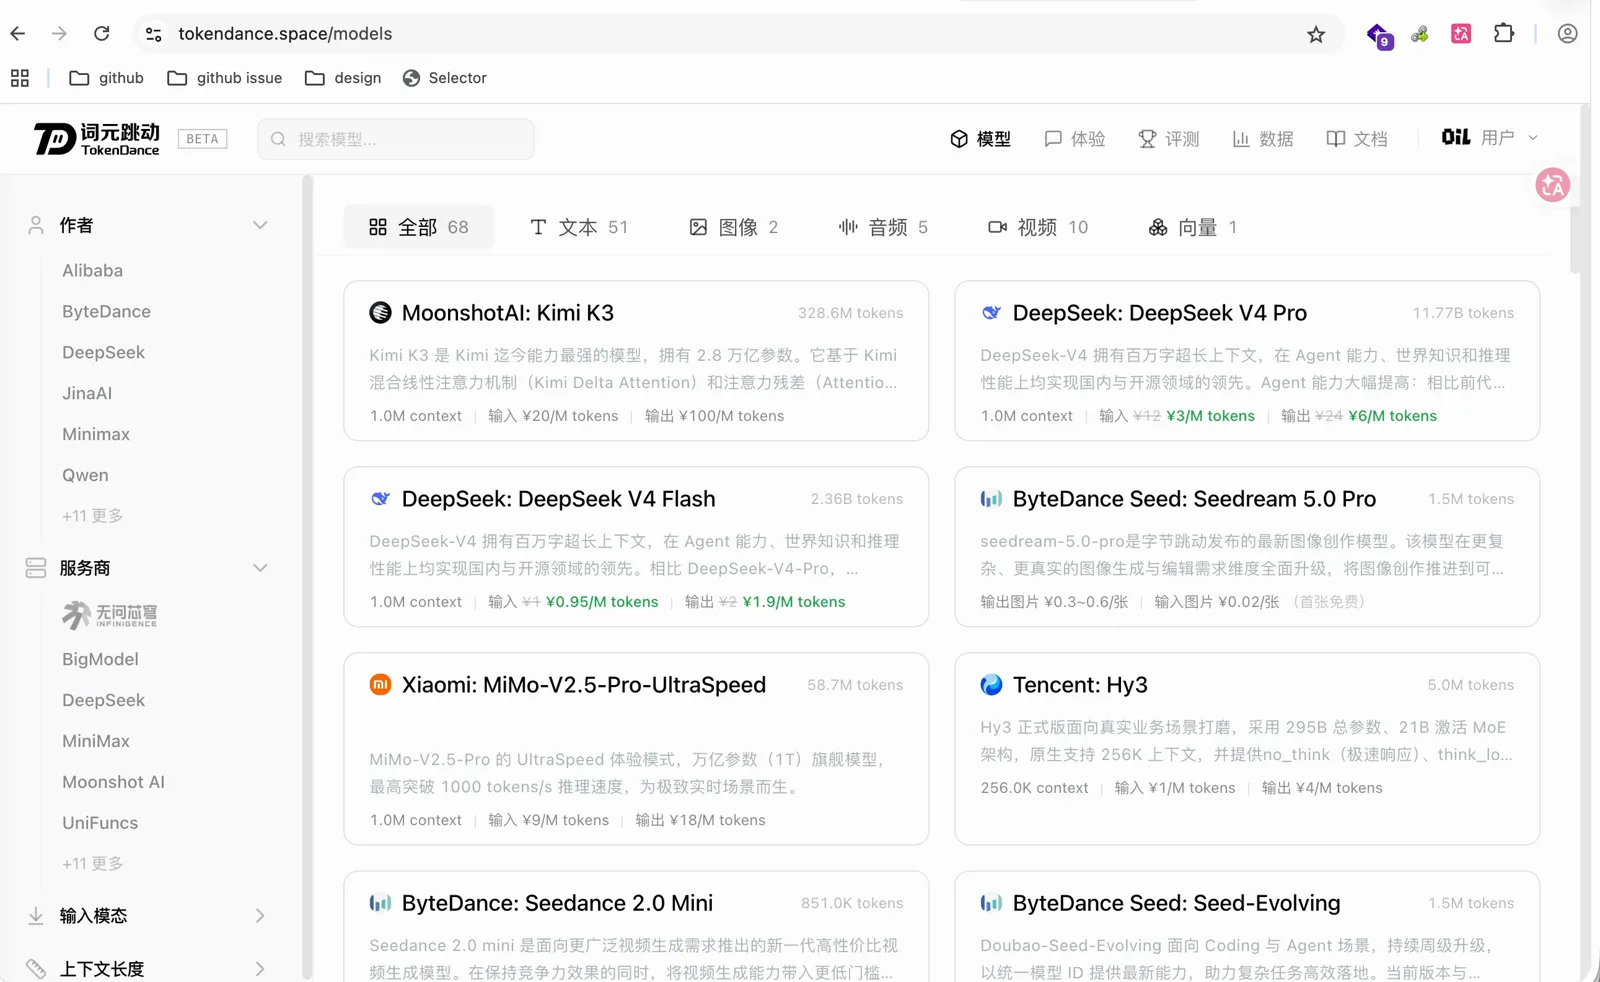
进入平台之后,左边是不同的 AI 厂商,比如阿里巴巴、字节跳动、DeepSeek;顶部是不同的模态,文本、图像、音频、视频,对应模型的输出类型。
以一个文本模型为例,比如最新出的 Kimi K3。点进详情页,最上面有个带复制按钮的标识,这是模型的 ID。平台提供了很多 AI 的 API,想要准确调用某个模型,就用这个唯一标识。下面可以看到上下文窗口是 100 万,支持的输入模态是文本、图像、视频,输出只能是文本,可以用它来解析图片内容、分析视频内容。
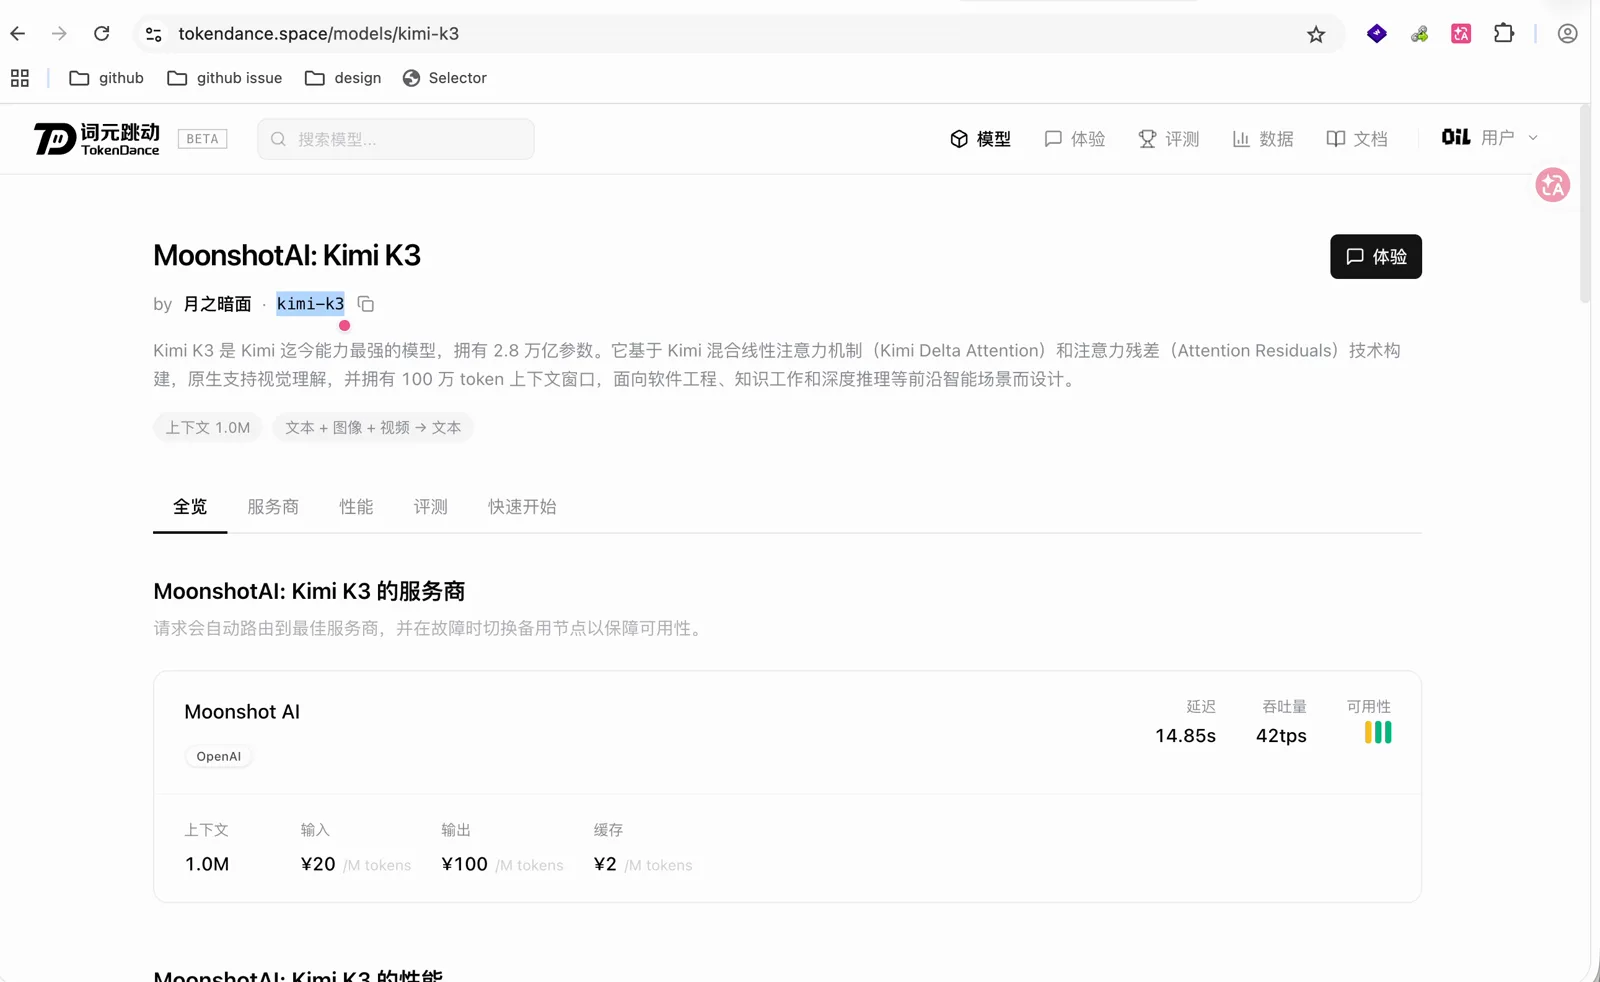
Kimi K3 的 TPS 是 42,属于平均水准。再看价格:100 万 tokens 输入 20 元、输出 100 元,这是旗舰模型的水准,海外模型大多差不多这个价格,顶尖的会更贵一点,Kimi K3 相对海外顶尖模型已经便宜一些。
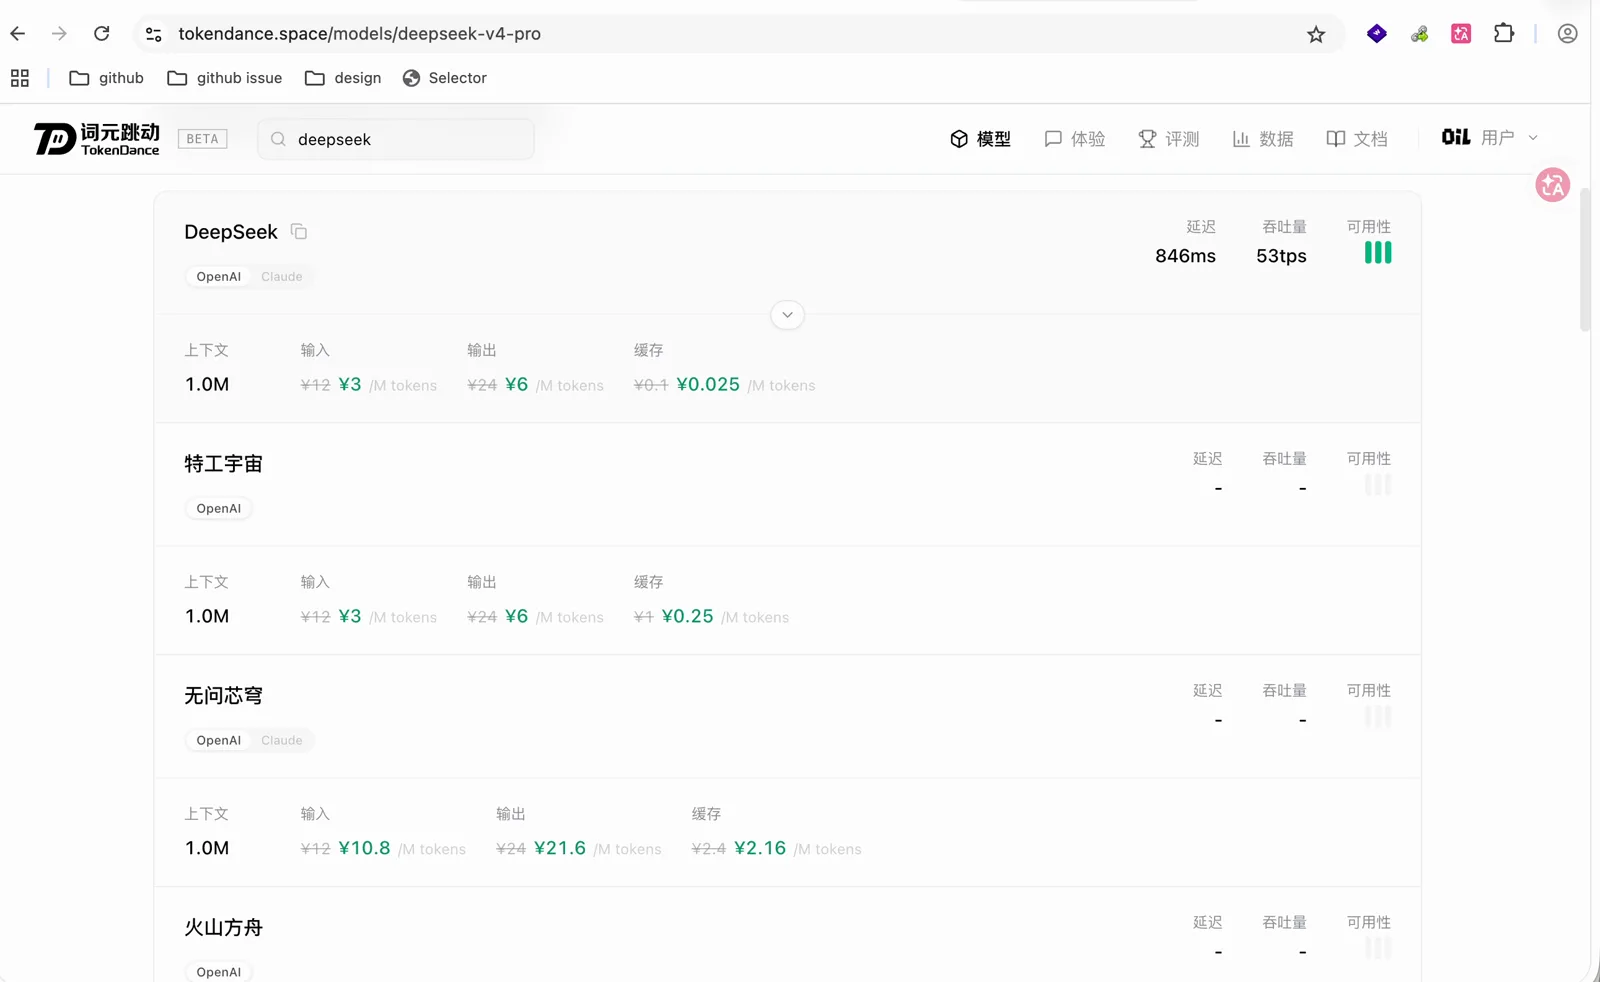
再看 DeepSeek V4 Pro。DeepSeek 是性价比非常高的模型,同样支持 100 万上下文,但不支持图片和视频识别。它的价格是 100 万 tokens 输入 3 元、输出 6 元,比 Kimi K3 便宜了十几倍。DeepSeek 还有上下文缓存:如果每一轮发送的系统提示词固定不变,比如狼人杀里一个玩家的身份设定,两次请求间隔比较短、过往的信息又一模一样,就会走上下文缓存,价格更加便宜。
查看文档并接入应用
每个模型厂商的文档里都有自己的请求路径。想要给平台发送请求,就要请求这个路径。文档里的请求示例包含三部分:请求路径本身、API Key(在平台里创建一个新密钥然后传进去)、模型 ID,以及传递上下文的 messages。
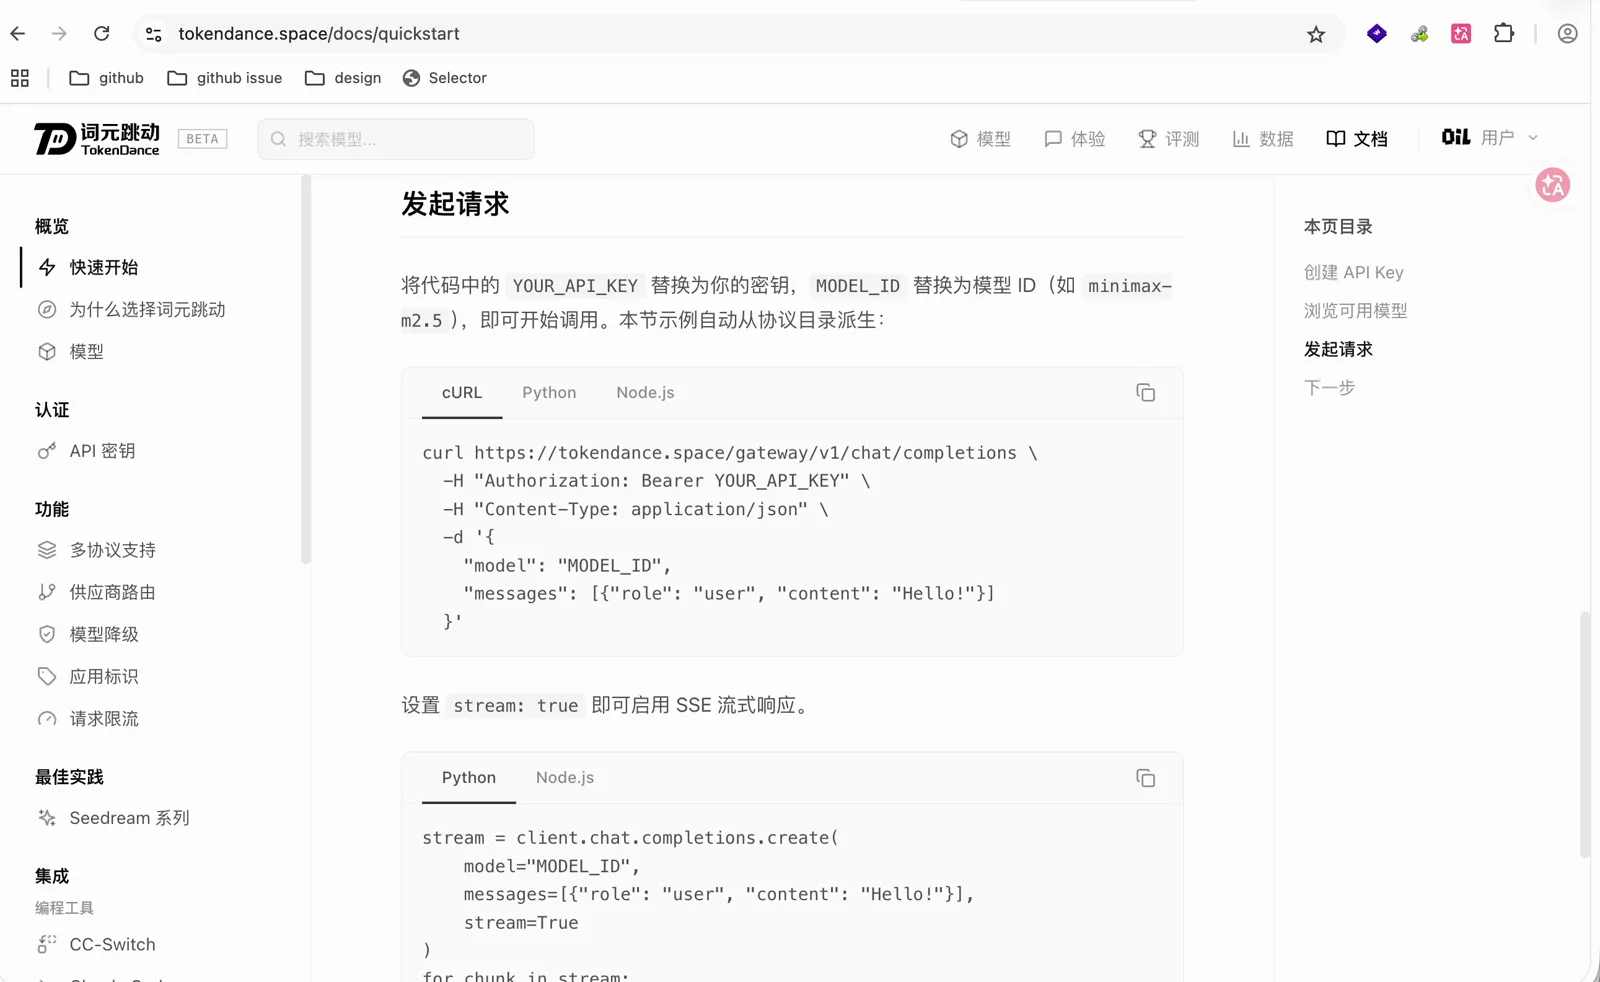
词元跳动的请求示例是:
curl https://tokendance.space/gateway/v1/chat/completions \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "MODEL_ID",
    "messages": [{"role": "user", "content": "Hello!"}]
  }'
不过现在我们不需要自己写这些代码。把请求路径和示例复制给 AI Agent,告诉它要请求的模型是什么,它会自己测试,能够正确响应就说明请求通了;再告诉它要应用在 AI 应用的哪个位置,它就可以把功能接上。
最后一个是流式响应。文档里设置 stream: true 即可启用 SSE 流式响应。开启之后,AI 每推理出一个字就响应一个字,就像 Codex 里字一个一个蹦出来的效果;不开启的话,要等全部内容生成完再一次性返回。流式响应能缓解用户的等待焦虑,但有一个缺点:如果返回的是 JSON 结构,最开始收到的结构是不完整的,要等到结构完整才能渲染到 UI 上。除非自己做一些优化,每吐出几个字就不断解析、补全格式再渲染,否则需要结构化输出的场景不适合直接开启流式响应。